Claudeから構造化データを取得する必要がある場合、主に2つのアプローチがあります。メッセージのプリフィルとストップシーケンスを使用するプロンプトベースの手法か、より堅牢な方法であるツールを使用する手法です。プロンプトベースのアプローチはセットアップが簡単ですが、ツールは追加の複雑さと引き換えに、より信頼性の高い出力を提供します。
構造化データのためのツール
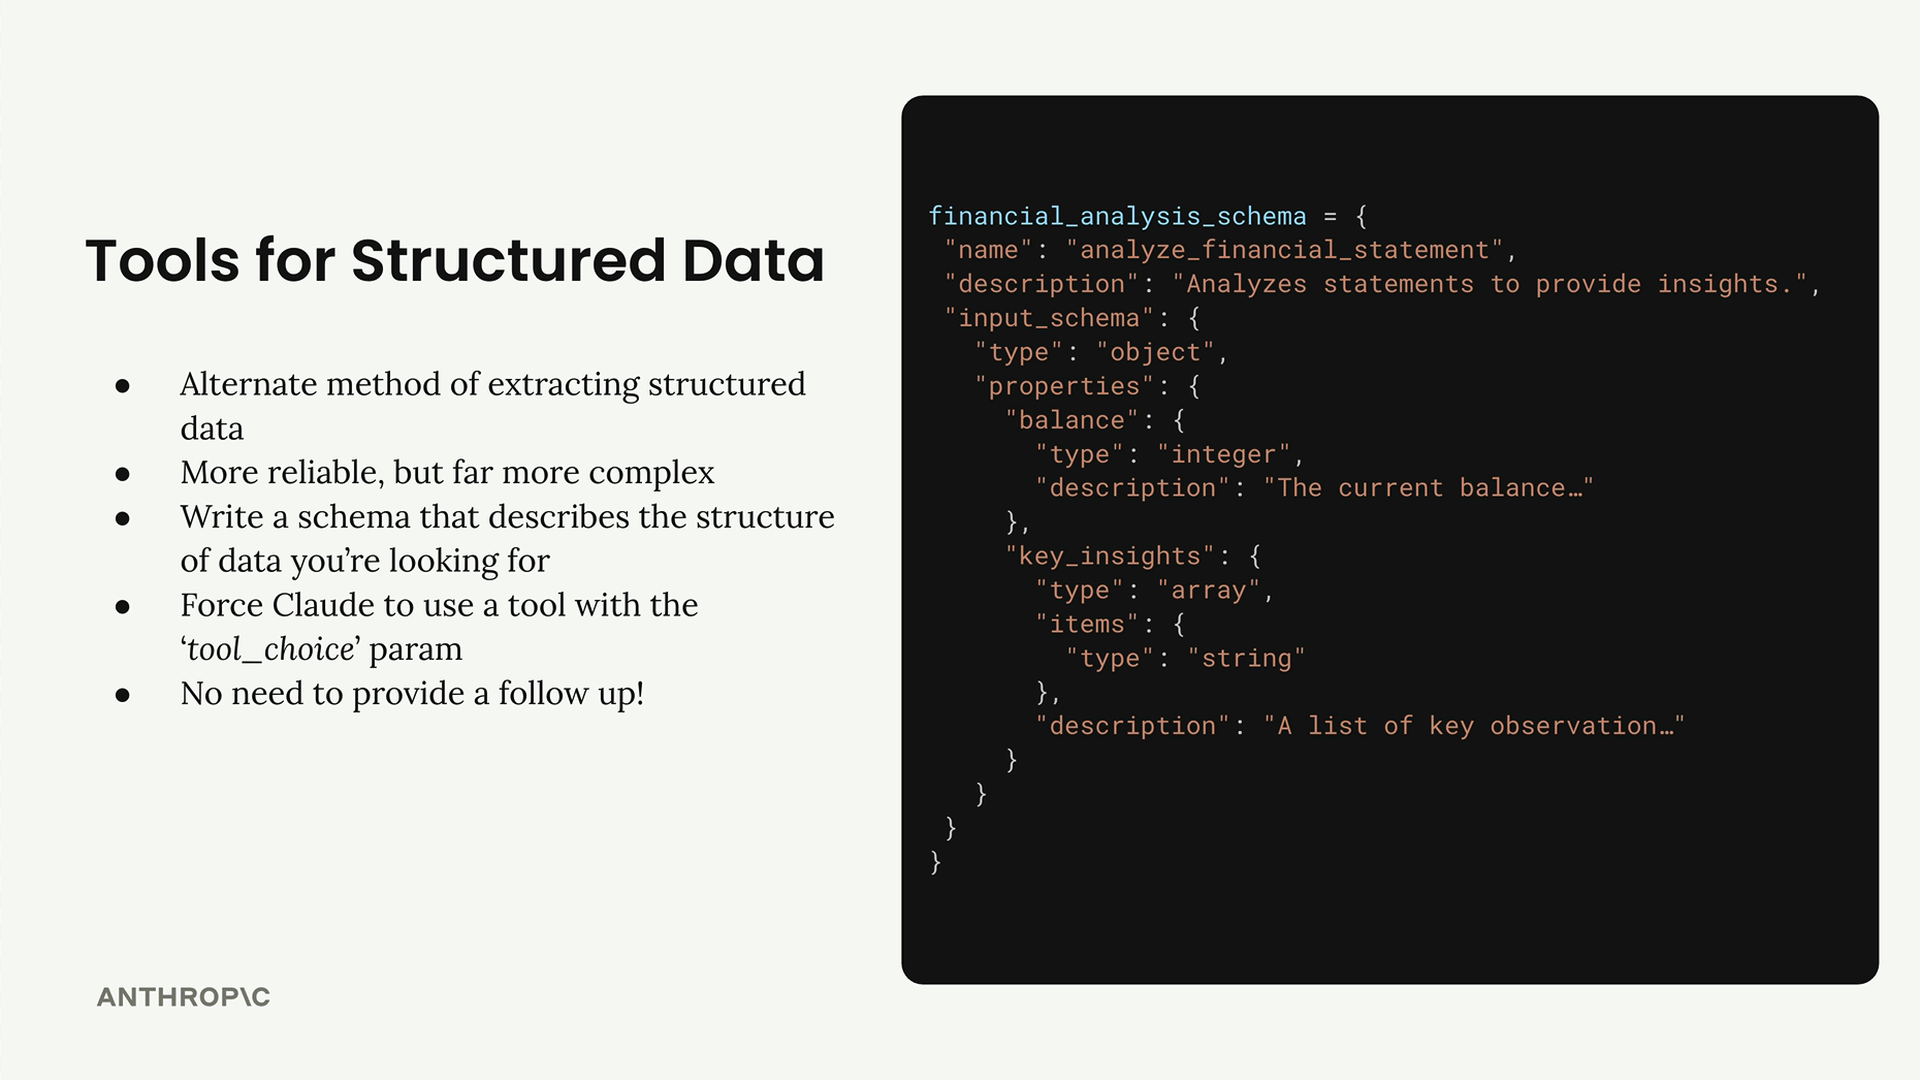
ツールベースのアプローチは、抽出したいデータの正確な構造を定義するJSONスキーマを作成することで機能します。Claudeが応答を正しくフォーマットしてくれることを期待する代わりに、実質的にはClaudeに、望む出力構造に一致する特定のパラメータを持つ関数を呼び出させることになります。
プロセスの流れは次のとおりです。
- 求めているデータの構造を記述するスキーマを作成する
tool_choiceパラメータを使用して、Claudeにツールの使用を強制する- ツール使用の応答から構造化データを抽出する
- フォローアップの応答を提供する必要はありません。データを取得した時点で完了です
たとえば、財務諸表から残高と主要なインサイトを抽出したい場合、スキーマではそれぞれを整数と文字列の配列として定義します。
ツール使用の制御
この手法の重要な部分は、Claudeが実際にあなたのツールを呼び出すようにすることです。この動作は tool_choice パラメータを使用して制御できます。
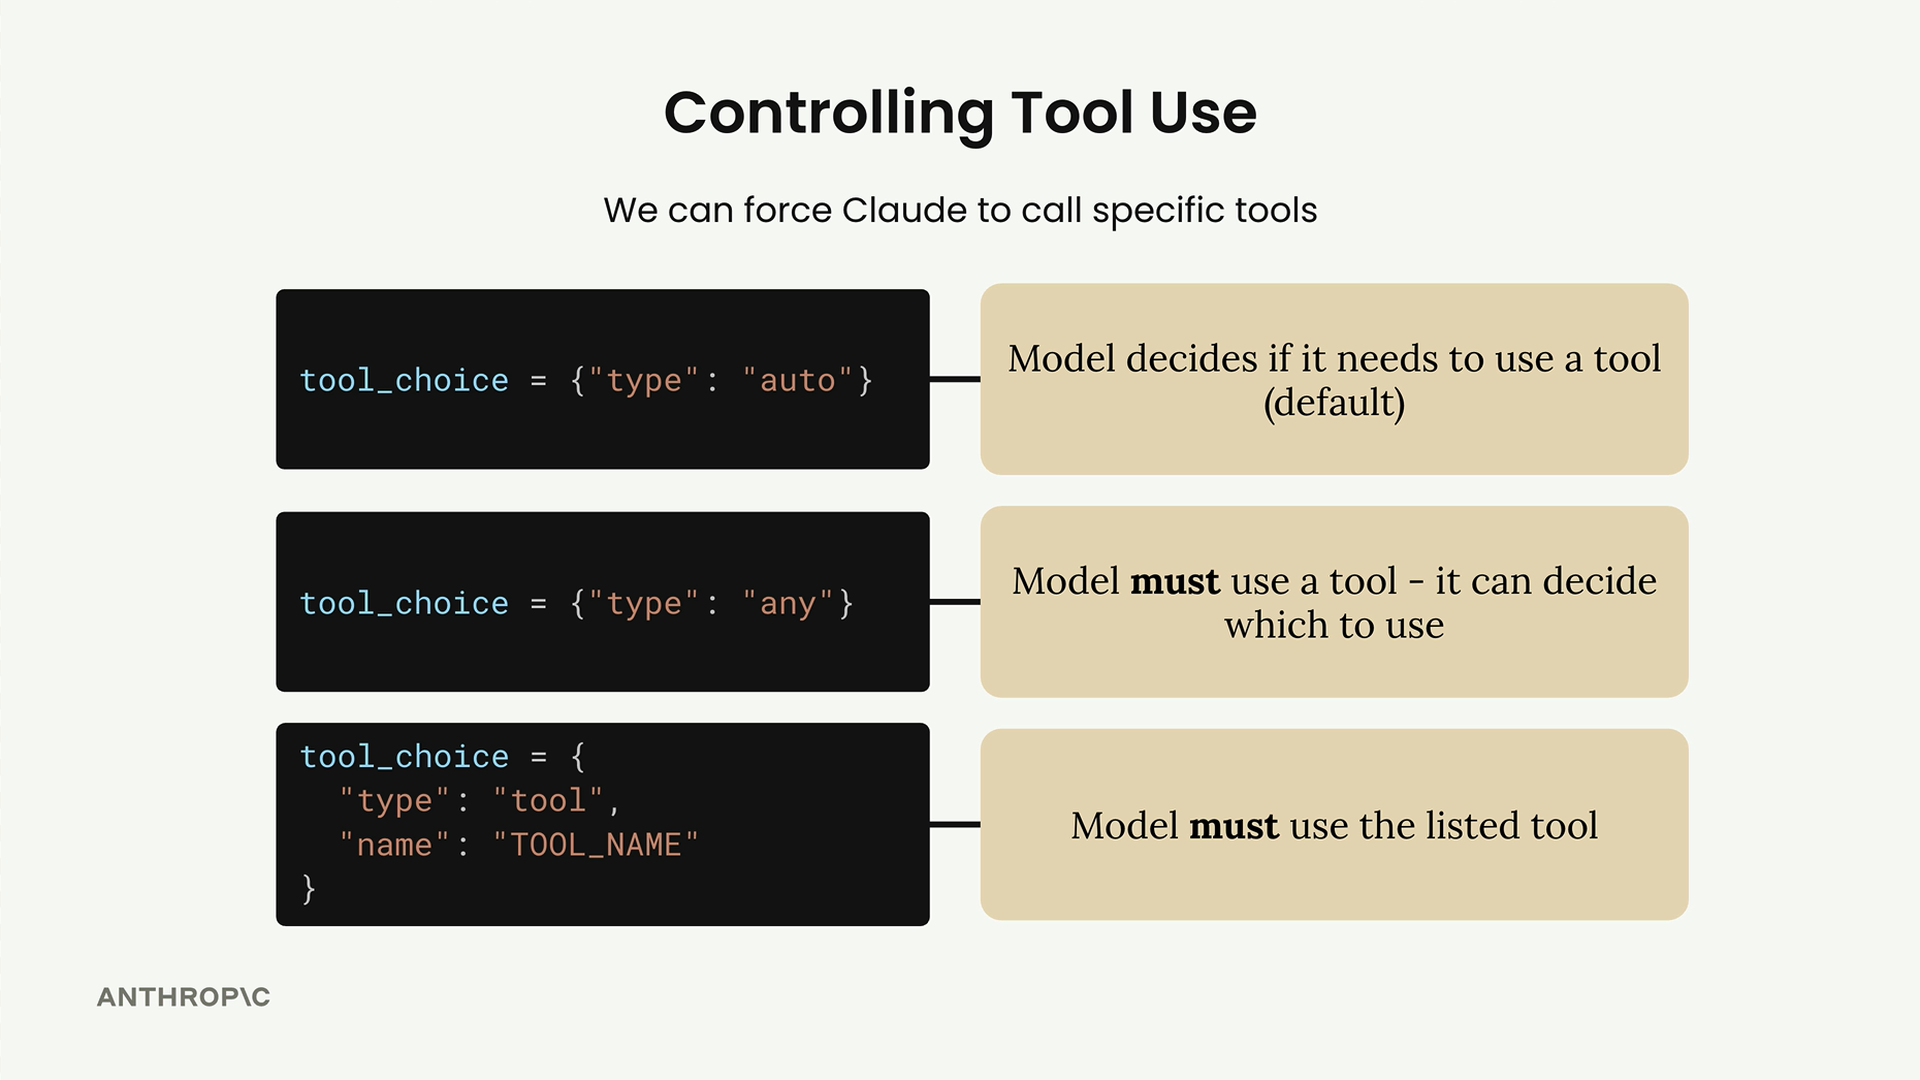
{"type": "auto"}- モデルがツールを使用する必要があるかどうかを判断する(デフォルト){"type": "any"}- モデルはツールを使用する必要があるが、どのツールを使うかは選択できる{"type": "tool", "name": "TOOL_NAME"}- モデルは指定されたツールを使用する必要がある
構造化データ抽出の場合、通常はClaudeに特定のスキーマツールを確実に呼び出させるために3番目のオプションを使用したいはずです。
実装例
記事からタイトル、著者、主要なインサイトを抽出したいとします。まず、ツールスキーマを作成します。
article_summary_schema = {
    "name": "article_summary",
    "description": "Extracts structured data from articles",
    "input_schema": {
        "type": "object",
        "properties": {
            "title": {"type": "string"},
            "author": {"type": "string"},
            "key_insights": {
                "type": "array",
                "items": {"type": "string"}
            }
        }
    }
}
次に、そのツールを指定してClaudeを呼び出し、使用を強制します。
response = chat(
    messages,
    tools=[article_summary_schema],
    tool_choice={"type": "tool", "name": "article_summary"}
)応答には、input フィールドに構造化データを含むツール使用ブロックが含まれます。これには直接アクセスできます。
structured_data = response.content[0].inputどちらのアプローチを使うべきか
素早く簡単なものが必要な場合は、プロンプトベースの構造化出力を選びましょう。確実な信頼性が必要で、追加のセットアップの複雑さにも対応できる場合はツールを使用しましょう。どちらの手法も、具体的なユースケースと要件に応じて価値があります。