多くのコンテンツを含むプロンプトを作成する際、Claudeはどのテキスト部分がひとまとまりであるべきか、あるいは各セクションが何を表しているのかを理解するのに苦労することがあります。XMLタグは、特に大量のデータを挿入する場合に、プロンプトに構造と明確さを簡単に加える方法を提供します。
構造が重要な理由
20ページ分の売上記録を分析する必要があるプロンプトを考えてみましょう。明確な境界がないと、Claudeはあなたの指示と、分析してほしい実際のデータを区別するのに苦労するかもしれません。
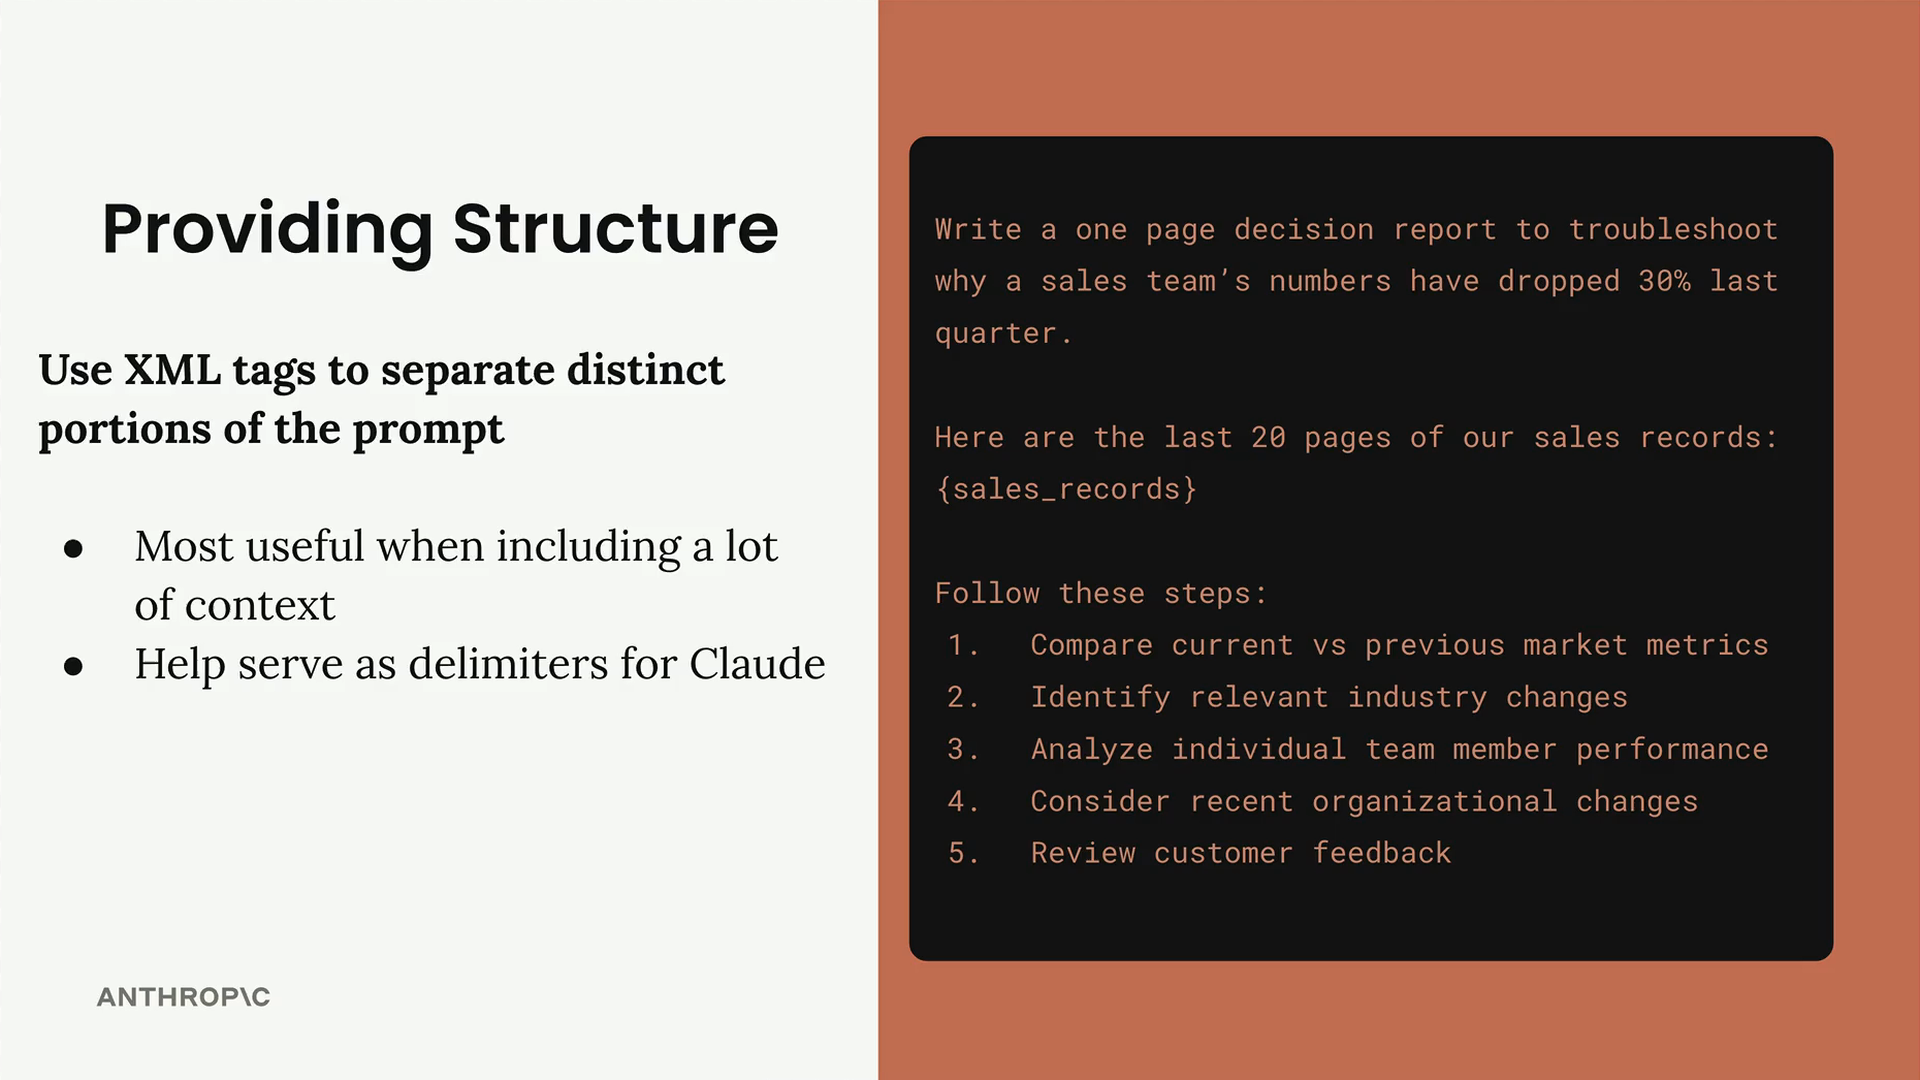
上の例は、境界が不明確だとClaudeがあなたの意図を解析しにくくなることを示しています。異なるコンテンツセクションをXMLタグで囲むことで、Claudeがプロンプトの構造を理解するのに役立つ明確な区切りを作ることができます。
明確さのためにXMLタグを使用する
XMLタグは、プロンプトの異なる部分を分離するコンテナとして機能します。含まれるコンテンツを説明するカスタムタグ名を作成できます。
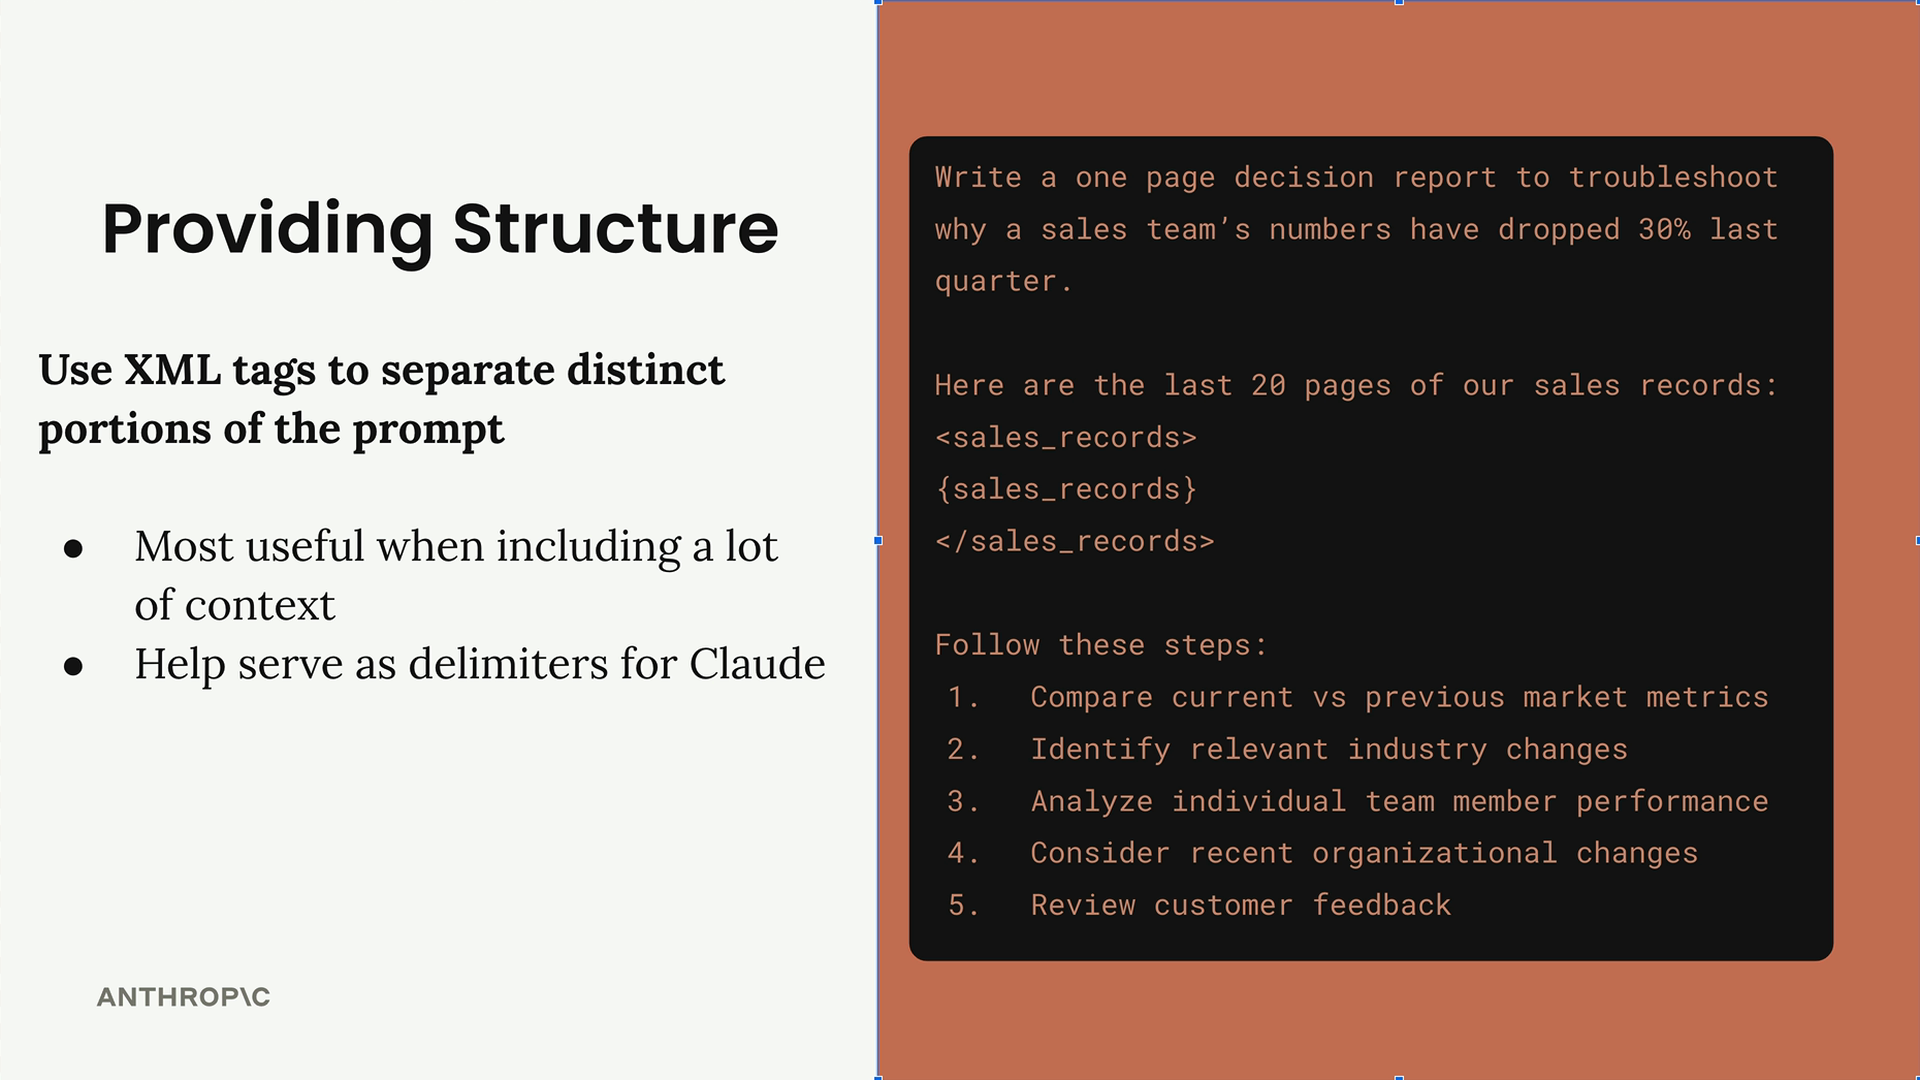
この場合、売上データを<sales_records>タグで囲むことで、そのコンテンツが何を表しているかが即座に明確になります。タグ名自体が、データの種類に関する文脈を提供します。
実践的な例
構造がなぜ重要なのかを示す、より劇的な例を見てみましょう。左側には、コードとドキュメントが混在したデバッグ依頼があります。
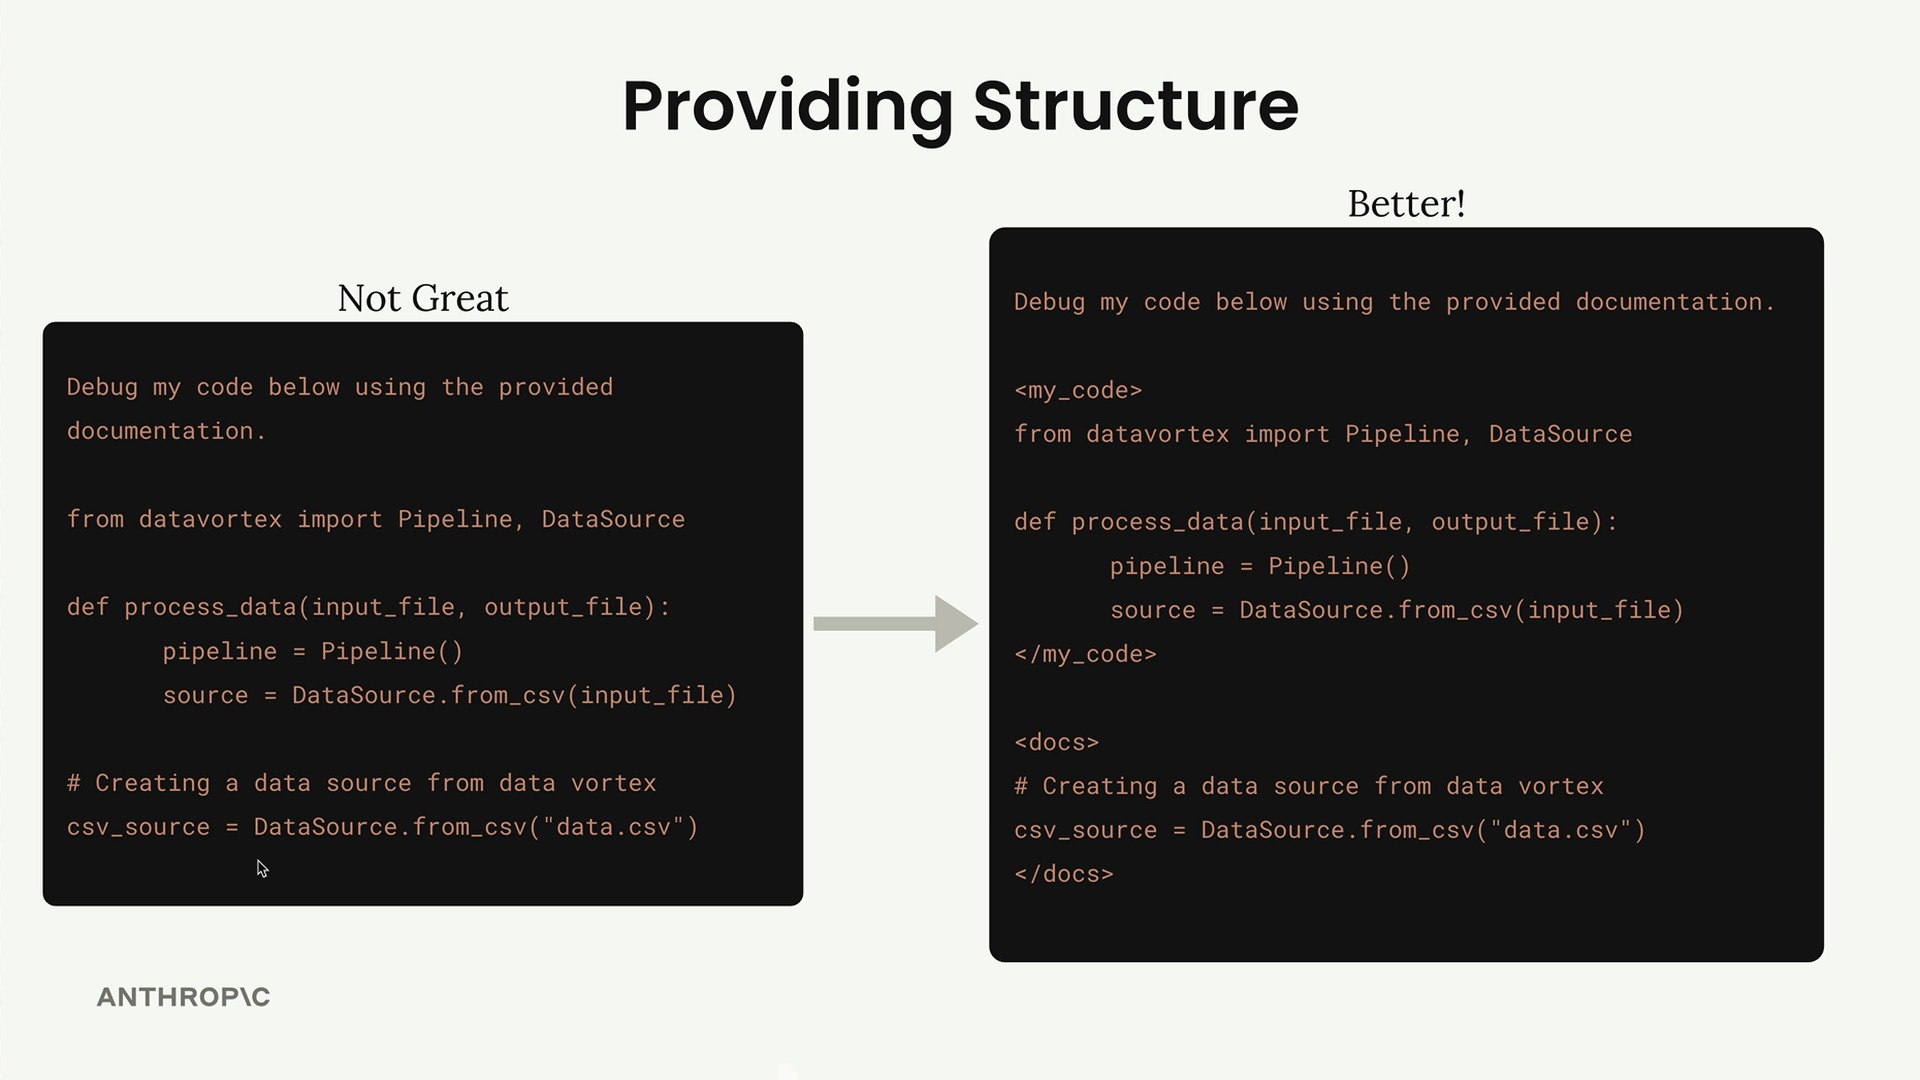
明確な境界がなければ、Claudeはどの部分がバグのあるコードで、どの部分がドキュメントなのかを推測するしかありません。右側の改善版では、XMLタグを使ってこれらを分離しています。
<my_code>
from datavortex import Pipeline, DataSource

def process_data(input_file, output_file):
    pipeline = Pipeline()
    source = DataSource.from_csv(input_file)
</my_code>

<docs>
# Creating a data source from data vortex
csv_source = DataSource.from_csv("data.csv")
</docs>これでClaudeは、デバッグが必要な対象と参考資料として機能する部分を簡単に識別できます。
プロンプトへの構造の適用
挿入するコンテンツが大量ではない場合でも、XMLタグによって明確さが向上することがあります。例えば、食事プランを生成する際、アスリートの情報をまとめてグループ化することができます。
<athlete_information>
- Height: {prompt_inputs["height"]}
- Weight: {prompt_inputs["weight"]}
- Goal: {prompt_inputs["goal"]}
- Dietary restrictions: {prompt_inputs["restrictions"]}
</athlete_information>これにより、これらの値が指示の一部ではなく、アスリートに関する外部入力を表していることが明確になります。
主な利点
- 大量のコンテキストやデータを含める際に最も役立ちます
- Claudeが異なる種類のコンテンツを解析するための明確な区切りとして機能します
- プロンプトのさまざまな部分同士の関係をClaudeが理解する能力を向上させます
- プロンプトの保守性を高め、デバッグしやすくします
XMLタグは、指示、データ、例、その他のコンテンツタイプが混在する複雑なプロンプトを扱う際に特に価値があります。構造を明確にすればするほど、Claudeはあなたの具体的なニーズをより良く理解し、応答できるようになります。