RAGフローを概念的に理解したところで、実践的な例を使ってステップバイステップで実装していきましょう。テキストのチャンク化からユーザークエリに関連するドキュメントの検索まで、RAGプロセスの5つの段階すべてを順に進めていきます。
ベクトルデータベースのセットアップ
この実装では、埋め込みの保存と検索に必要な基本機能を提供するカスタムのVectorIndexクラスを使用します。このクラスは、ベクトルの保存、距離計算(コサイン類似度を使用)、およびドキュメントの取得を処理します。
5ステップのRAG実装
RAGプロセスの各ステップを順に見ていきましょう。
ステップ1: セクションごとにテキストをチャンク化する
まず、元のドキュメントを扱いやすいチャンクに分割する必要があります。先ほどと同じセクションベースのチャンク化アプローチを使用します。
chunks = chunk_by_section(text)これにより、report.mdファイルが個別に処理できる論理的なセクションに分割されます。
ステップ2: 各チャンクの埋め込みを生成する
次に、各テキストチャンクをその意味的な意味を捉えた数値埋め込みに変換します。
embeddings = generate_embedding(chunks)これらの埋め込みにより、異なるテキスト片同士の数学的な比較が可能になります。
ステップ3: 埋め込みをベクトルデータベースに保存する
次に、ベクトルストアを作成し、埋め込みとそれに関連付けられたテキストを格納します。
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
埋め込みと元のテキストコンテンツの両方を保存していることに注目してください。これは重要です。なぜなら、後で類似した埋め込みを取得する際には、数値ベクトルだけでなく実際のテキストへのアクセスが必要になるからです。埋め込みそのものは、開発者である私たちにとっては有用ではありません。それが表す人間が読める内容が必要なのです。
ステップ4: ユーザークエリの埋め込みを生成する
ユーザーが質問をするとき、そのクエリを保存済みドキュメントと同じ埋め込み空間に変換する必要があります。
user_embedding = generate_embedding("What did the software engineering dept do last year?")ステップ5: 関連するドキュメントを検索する
最後に、最も関連性の高いチャンクを見つけるためにベクトルストアを検索します。
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
これにより、コサイン距離スコアとともに最も類似した2つのチャンクが返されます。
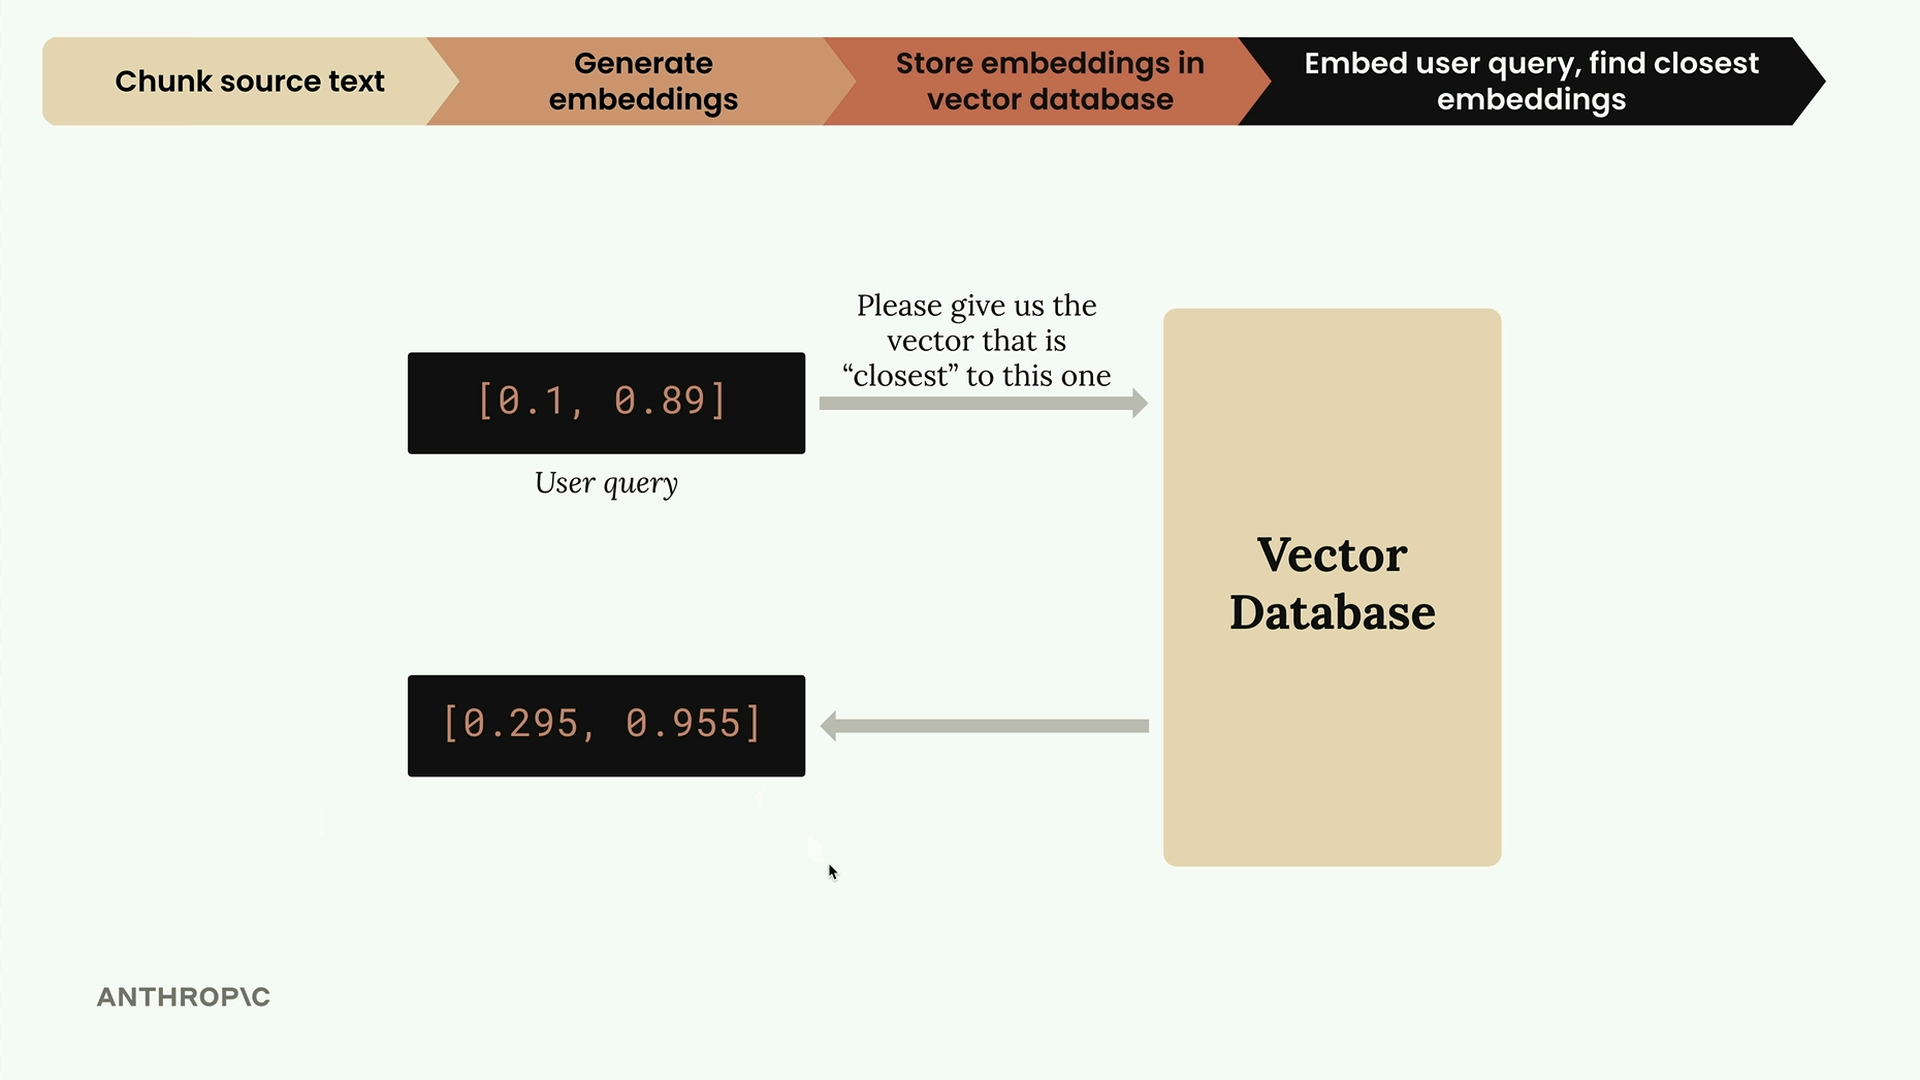
上の図は、ベクトルデータベースがユーザークエリをどのように処理するかを示しています。質問をすると、それは埋め込みベクトルに変換され、データベースは高次元空間内でそれに「最も近い」保存済みベクトルを見つけます。
結果を理解する
ソフトウェアエンジニアリング部門に関するクエリでこの例を実行すると、2つの関連するセクションが返されます。
- セクション2: ソフトウェアエンジニアリング - Project Phoenix 安定性向上(距離: 0.71)
- 方法論セクション(距離: 0.72)
距離スコアが低いほど、内容はクエリに類似しています。どちらの結果も、ソフトウェアエンジニアリング部門が達成したことに関する質問に関連しています。
なぜ埋め込みとともにコンテンツを保存するのか
なぜ各埋め込みと一緒に元のテキストを保存するのか、疑問に思うかもしれません。その理由は実用的なものです。埋め込みは単なる数値の配列であり、人間にとって直接的な意味を持ちません。検索が最も類似した埋め込みを返したとき、見つかったものを理解し、応答生成に使用するためには、実際のテキストコンテンツが必要になります。
実装によっては、元のテキストを指し示すIDだけを保存する場合もありますが、ここではシンプルにするために、各ベクトルとともにコンテンツを直接保存しています。
次のステップ
この実装はRAGワークフローの中核をカバーしていますが、まだ改善できる点があります。実際のアプリケーションでは、この基本的なアプローチが期待どおりに機能しないシナリオに遭遇することがあるため、今後のセクションではそれらの改善点を探っていきます。