テキストチャンキングは、RAG(Retrieval Augmented Generation)パイプラインを構築する上で最も重要なステップの1つです。ドキュメントをどのように分割するかは、システム全体の品質に直接影響します。チャンキング戦略が不適切だと、無関係なコンテキストがプロンプトに挿入され、AIがまったく誤った回答をしてしまう原因となります。
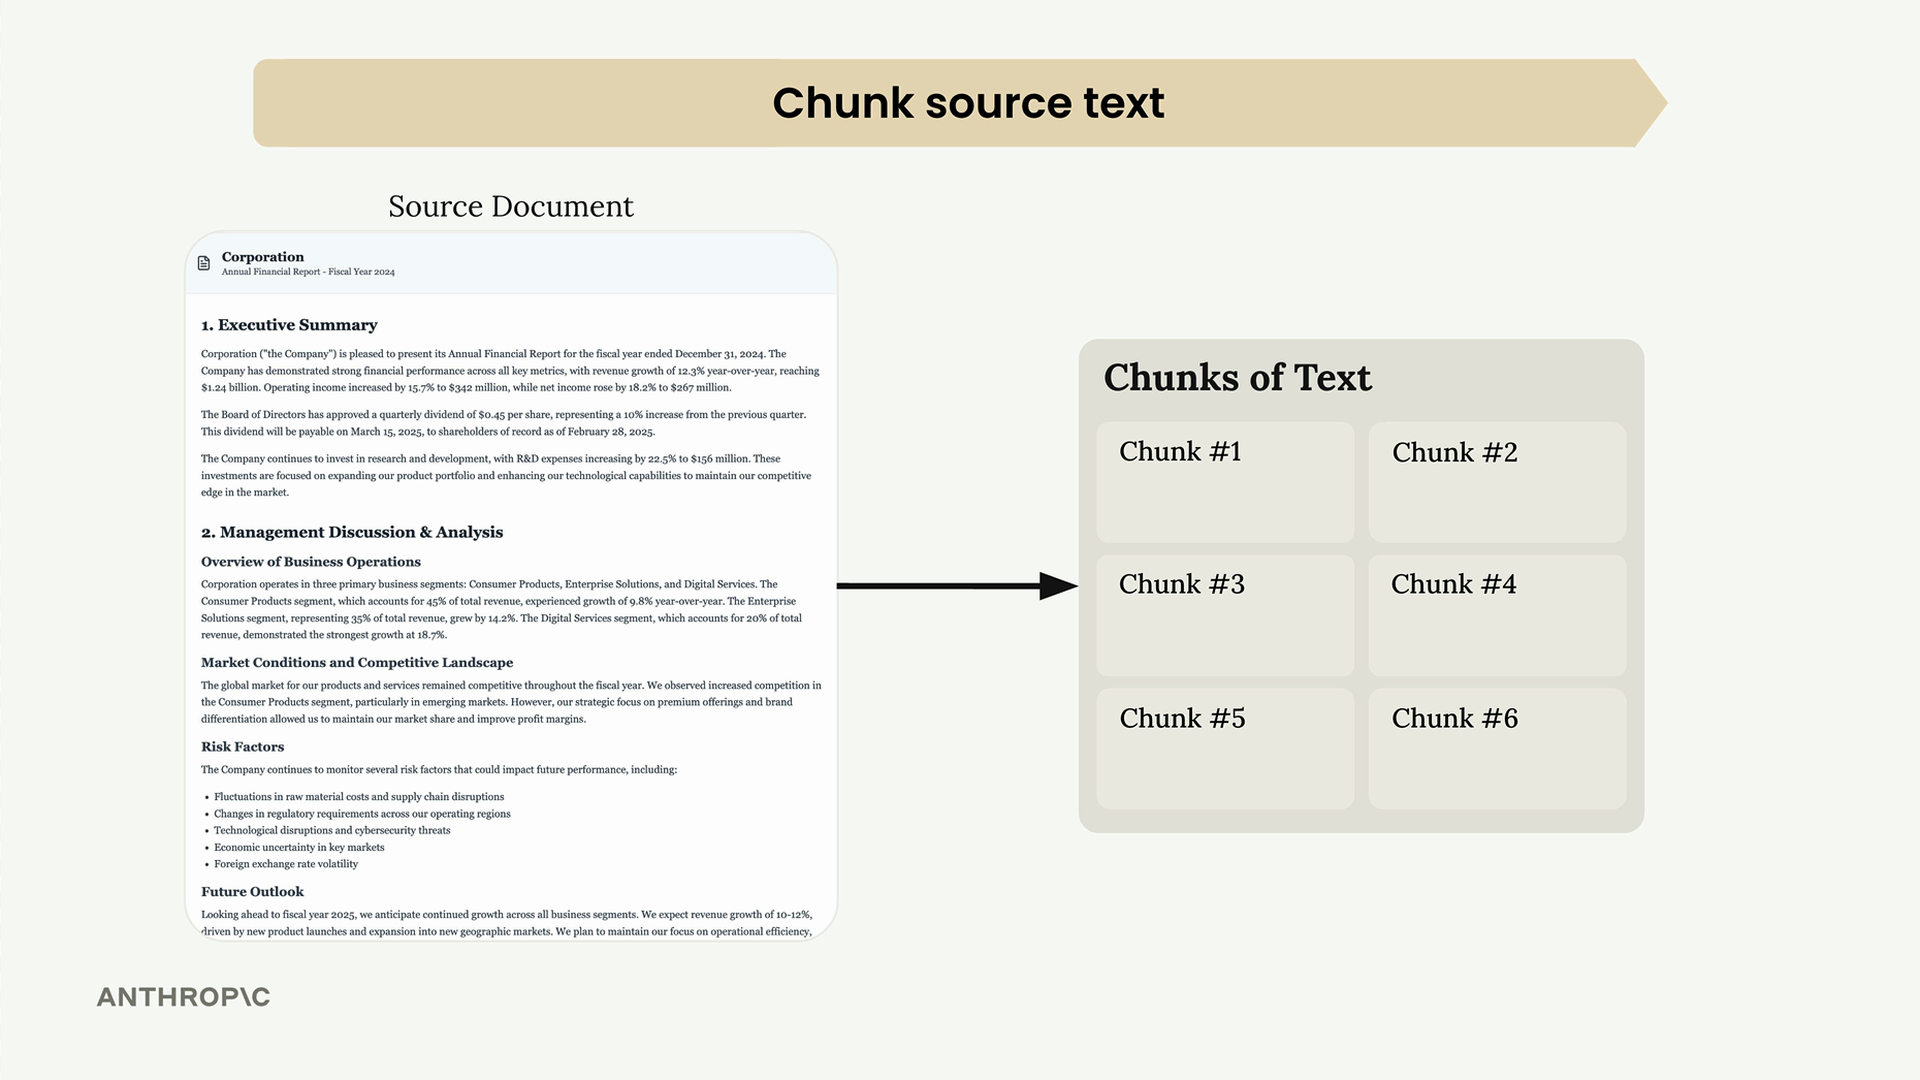
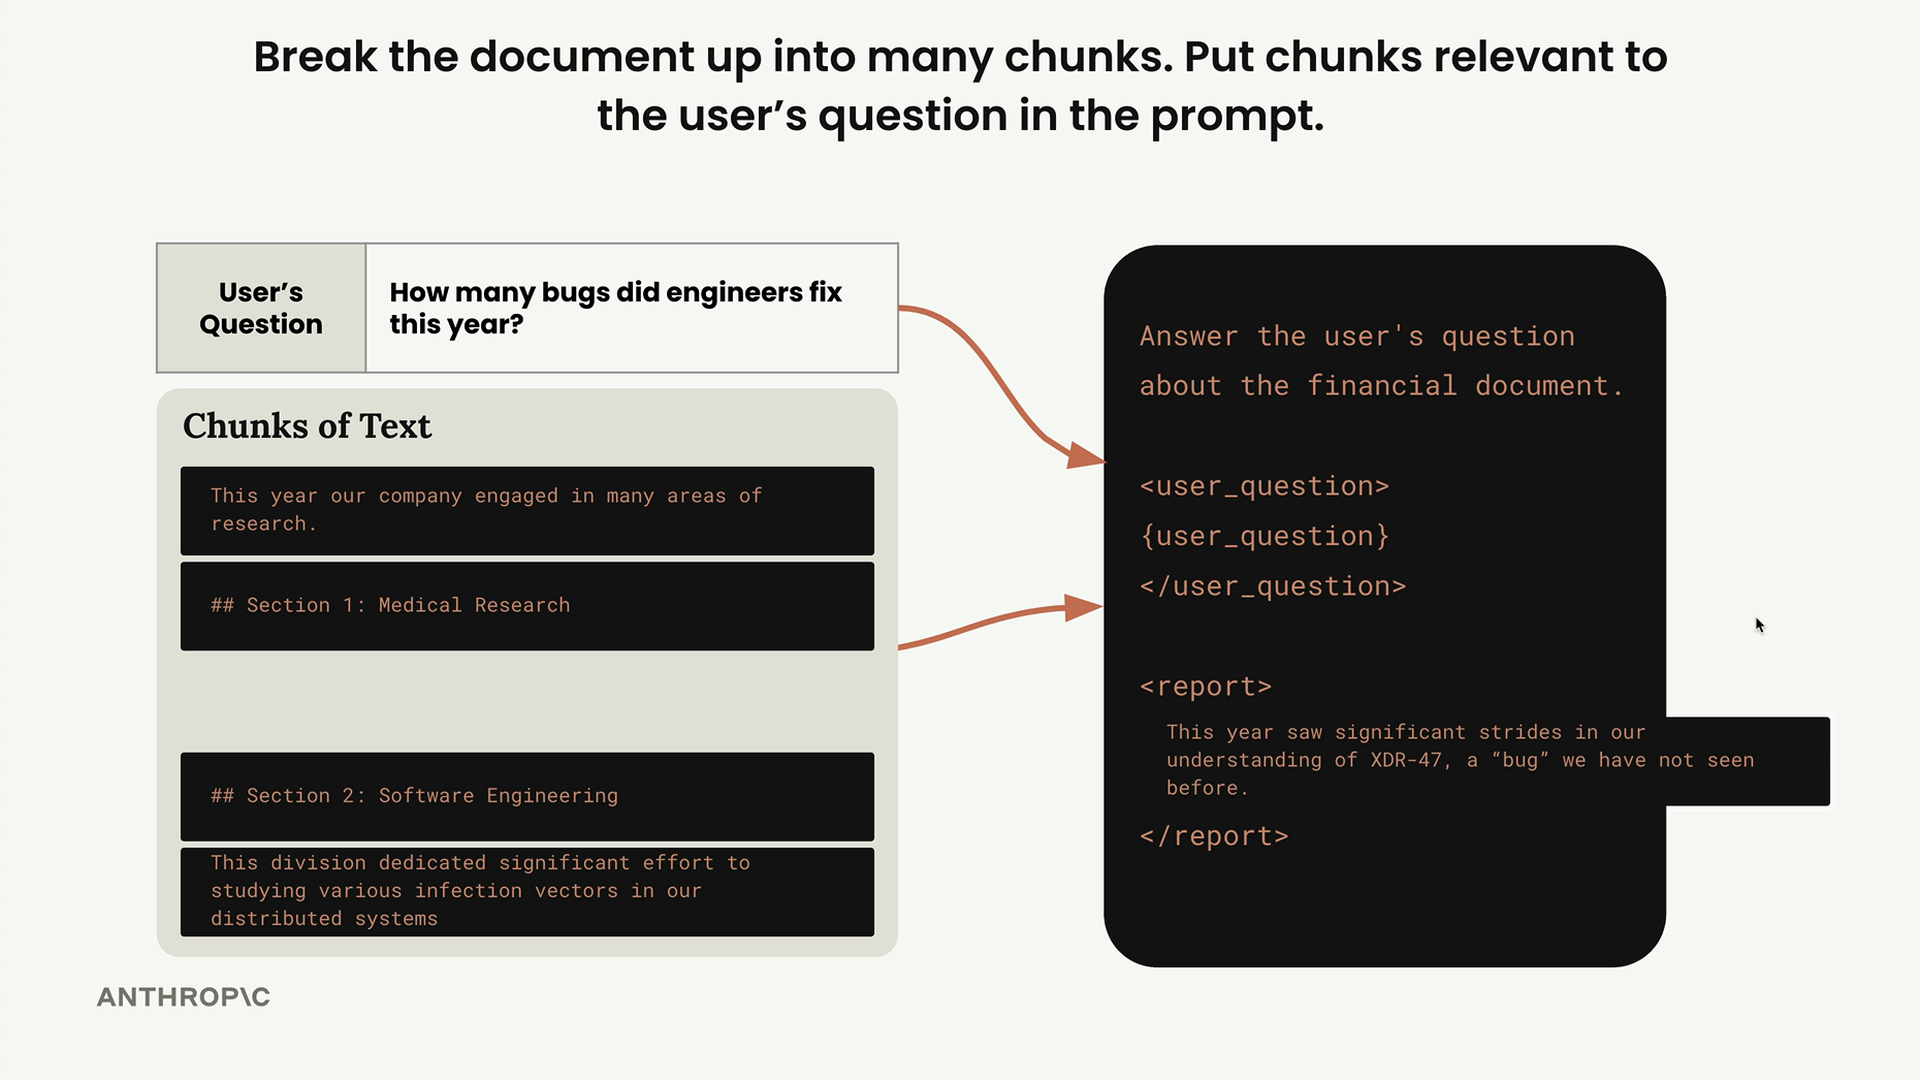
次の例を考えてみましょう。医療研究とソフトウェアエンジニアリングに関するセクションを含むドキュメントがあるとします。チャンキングが不適切だと、「今年エンジニアは何件のバグを修正しましたか?」と尋ねたユーザーが、医療研究に関する情報を得てしまうかもしれません。これは単に、医療セクションにたまたま別の文脈で「bug」という単語が含まれていたためです。
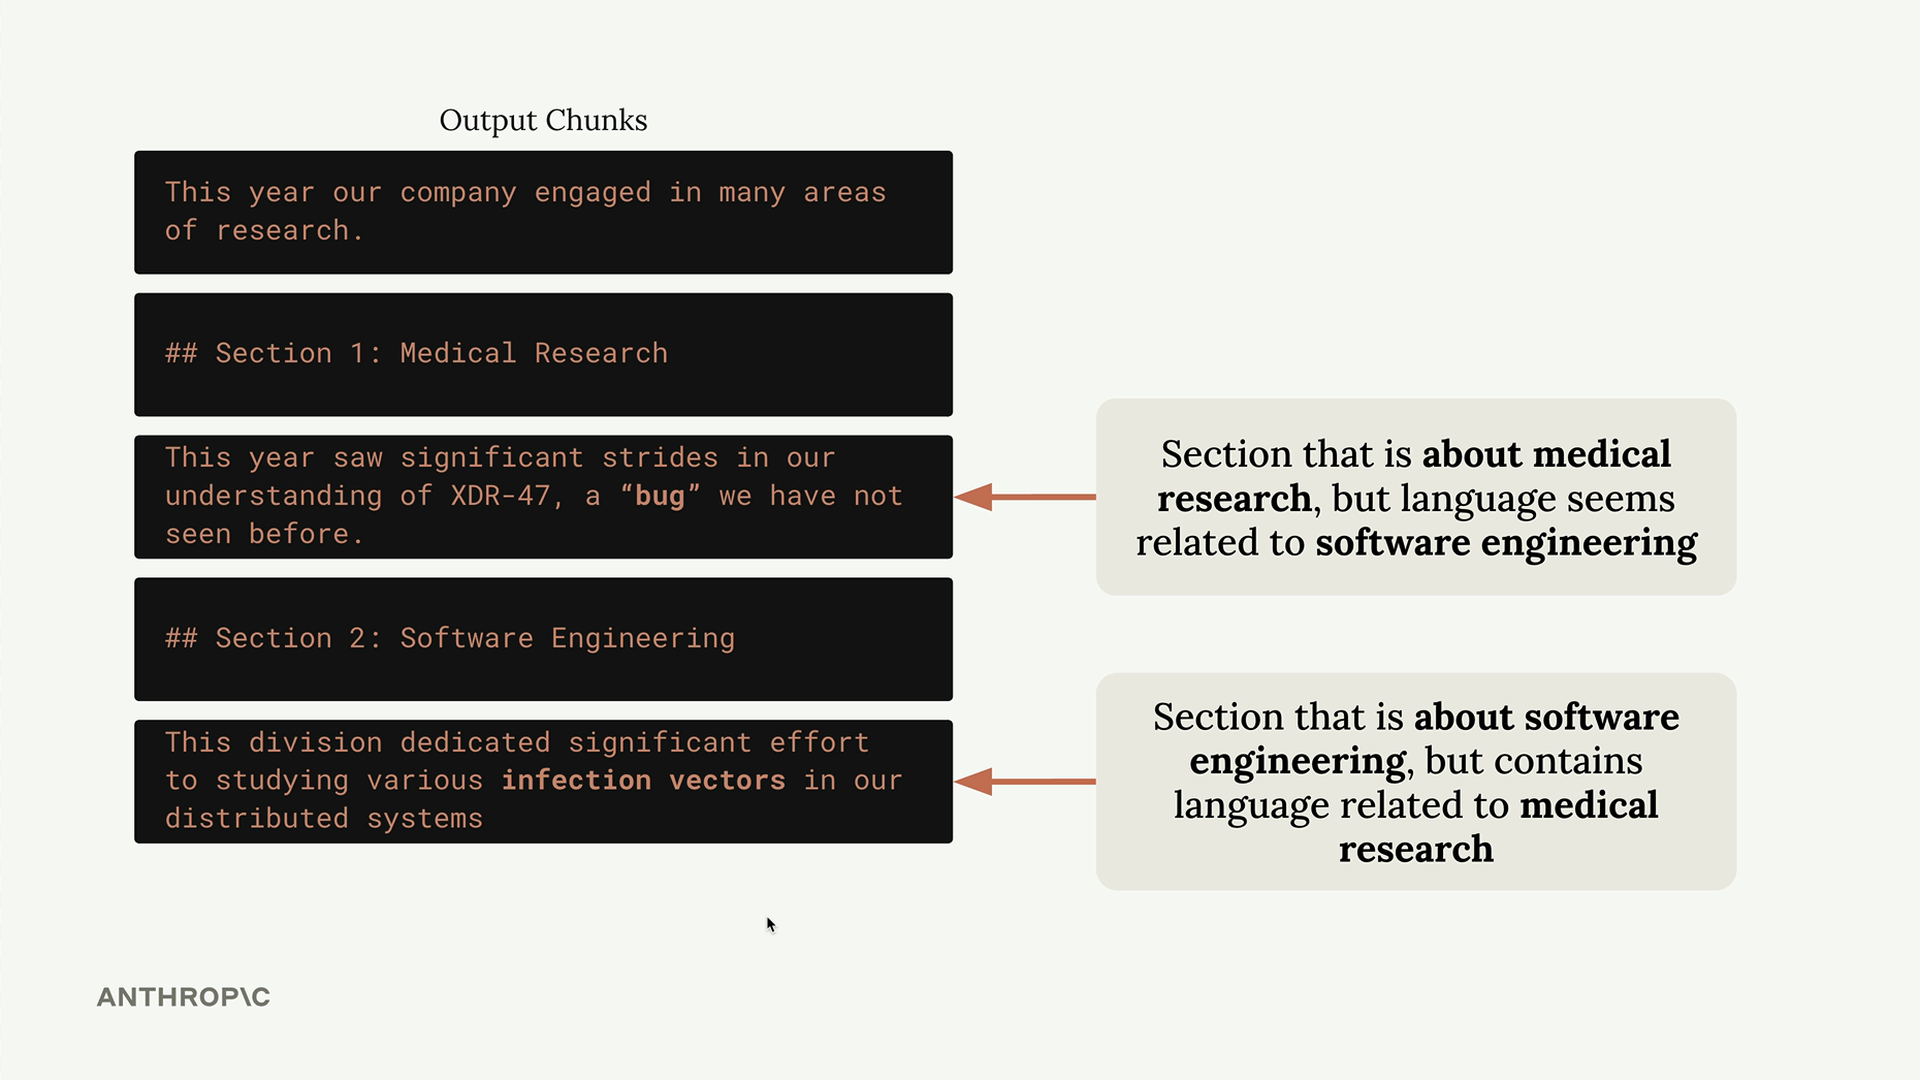
これは、チャンキング戦略がいかに重要であるかを示しています。目標は、意味的な一貫性を保ち、取得時に意味のあるコンテキストを提供するチャンクを作成することです。
3つの主要なチャンキング戦略
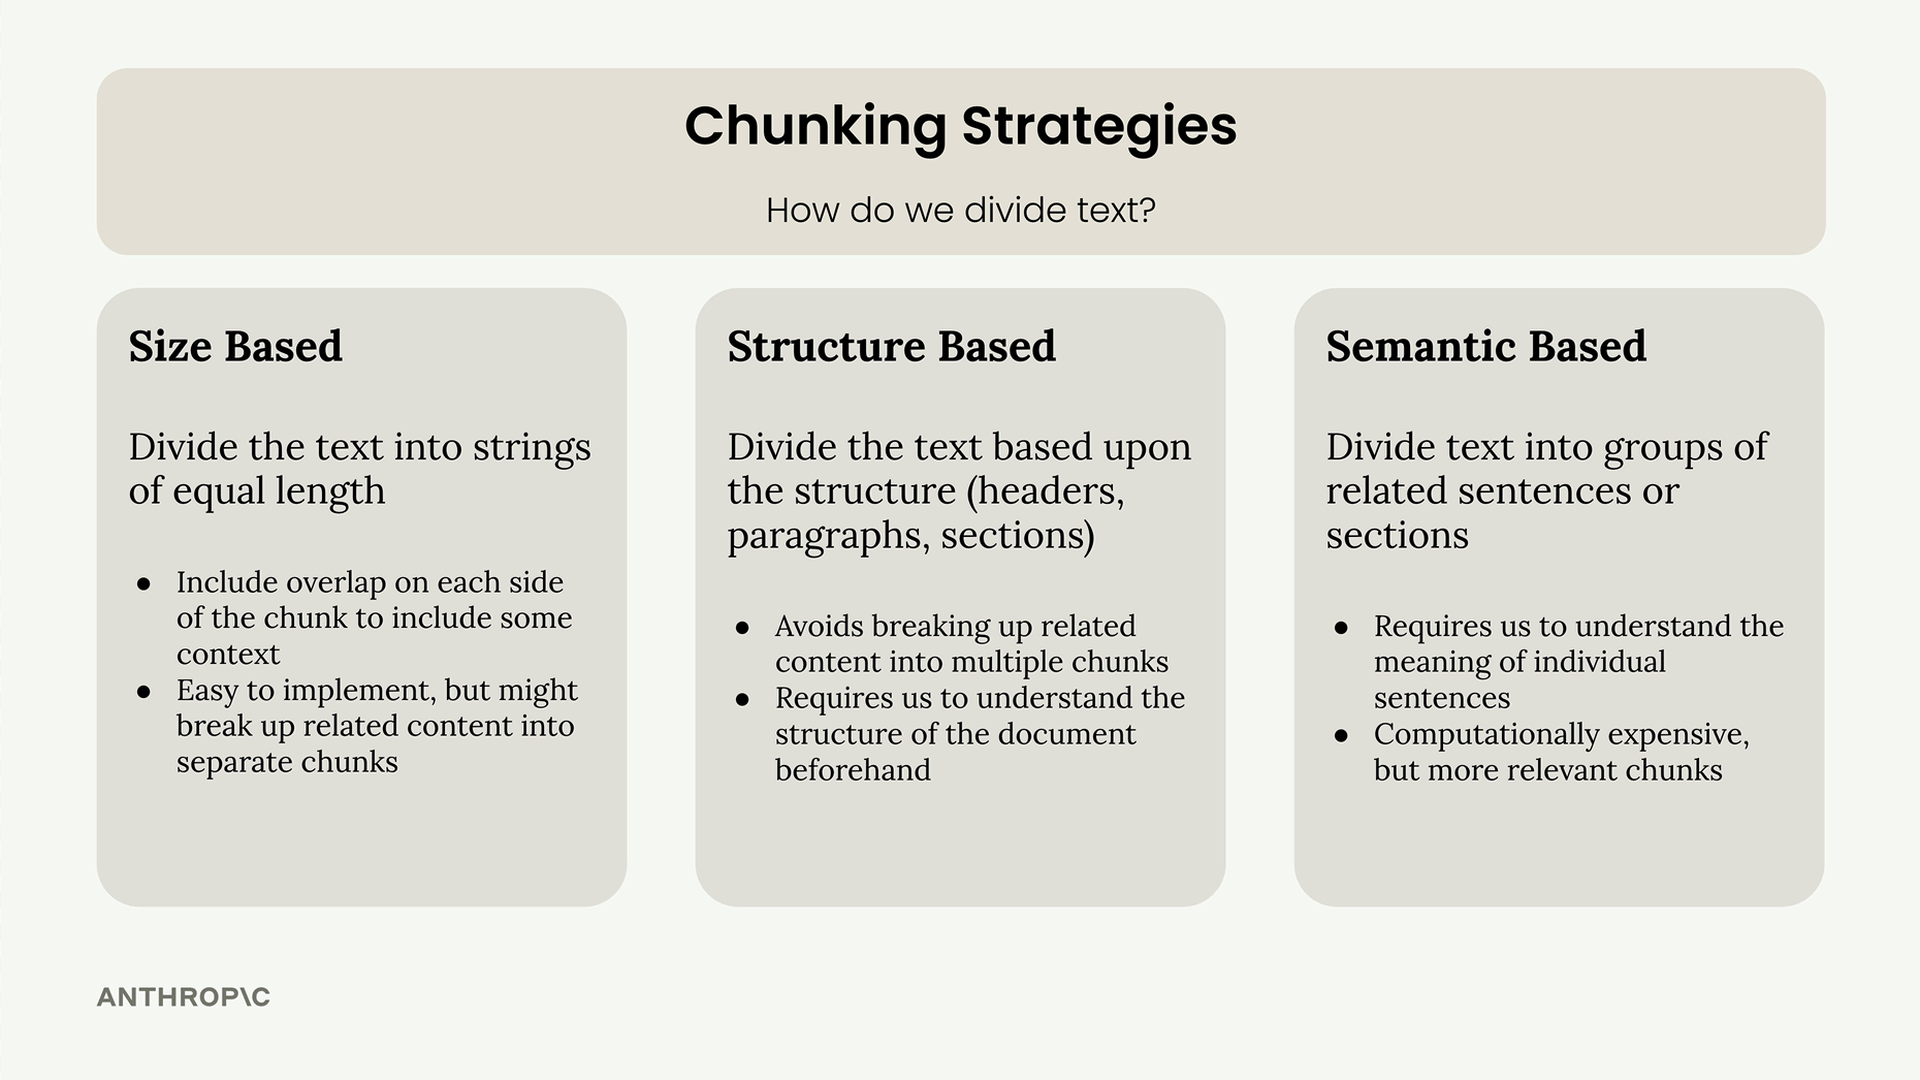
テキストのチャンキングには3つの主要なアプローチがあり、それぞれに明確な利点とトレードオフがあります。
- サイズベース: テキストを等しい長さの文字列に分割する
- 構造ベース: ドキュメントの構造(見出し、段落、セクション)に基づいて分割する
- 意味ベース: NLP技術を使って関連する文や section をグループ化する
サイズベースのチャンキング
サイズベースのチャンキングは最もシンプルなアプローチです。ドキュメントをほぼ等しい文字数または単語数のチャンクに単純に分割します。実装が容易で、さまざまなドキュメントタイプに対して確実に機能します。
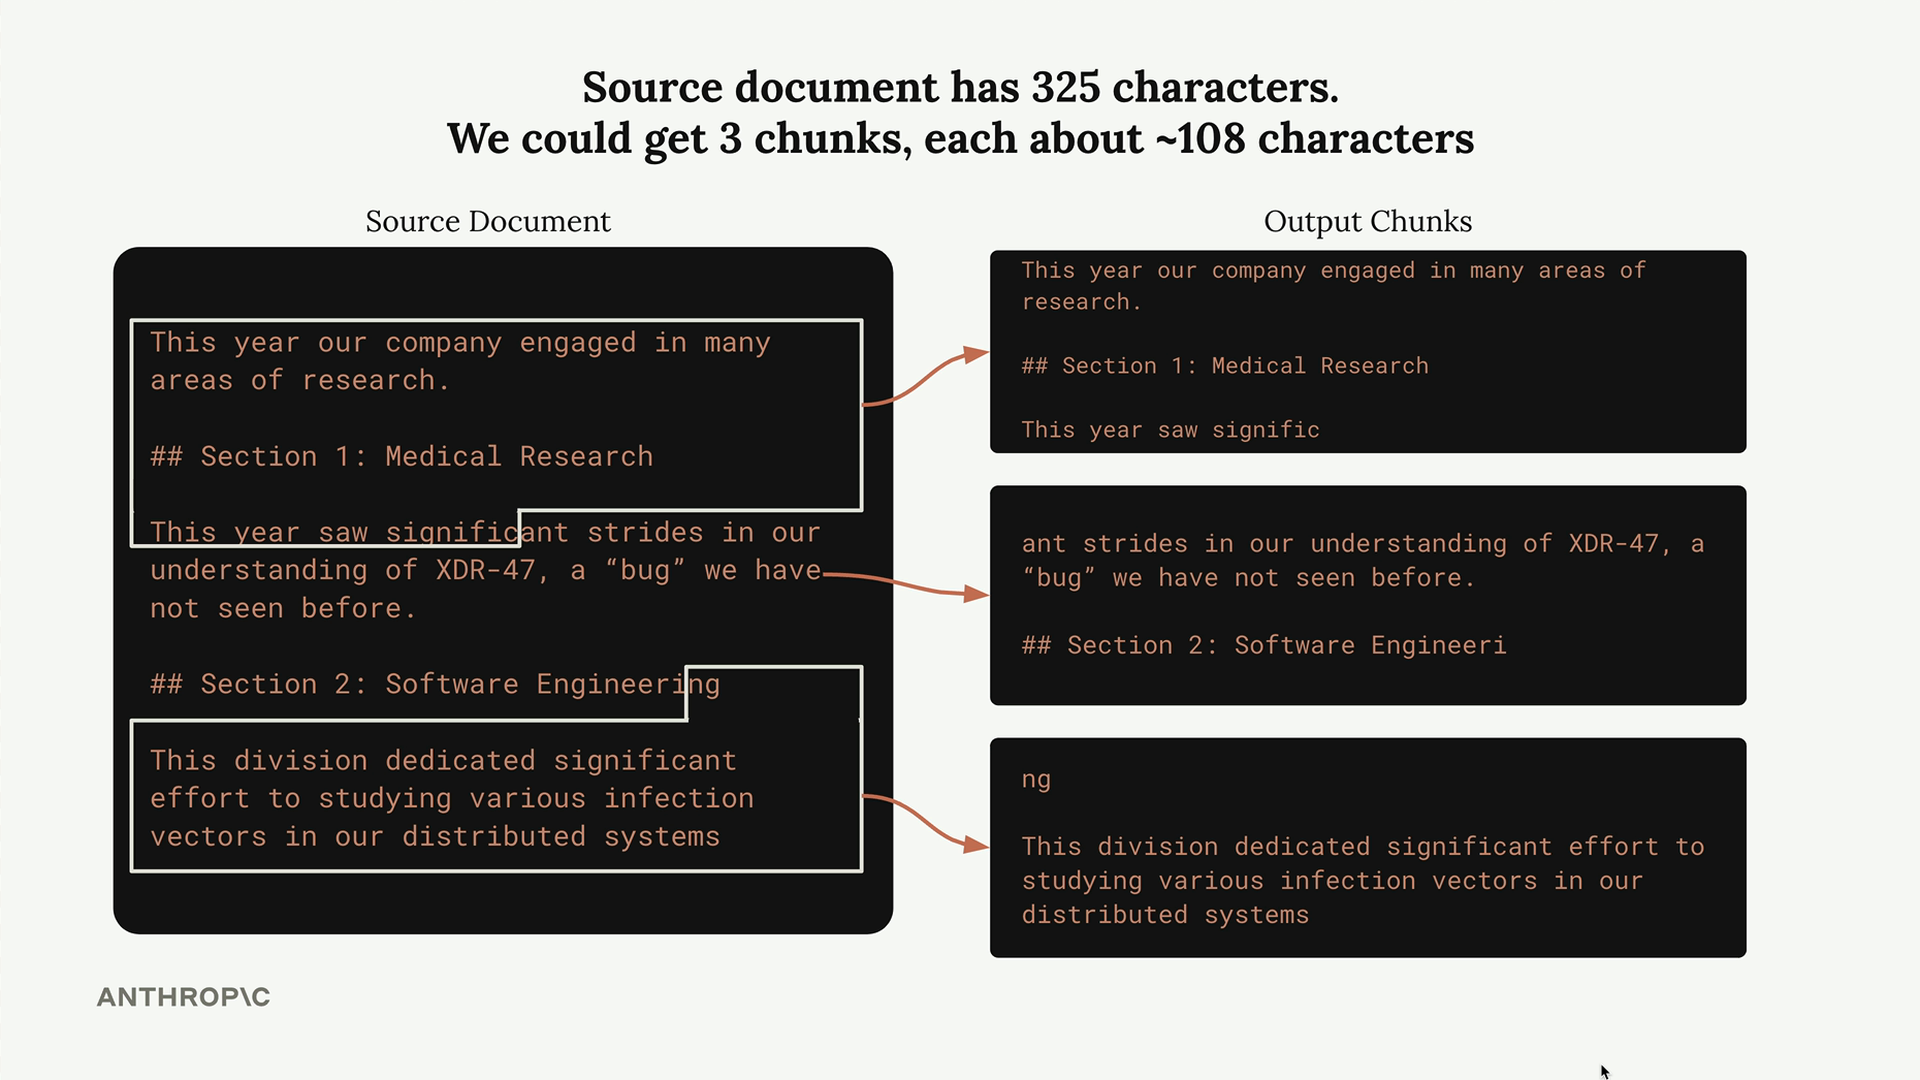
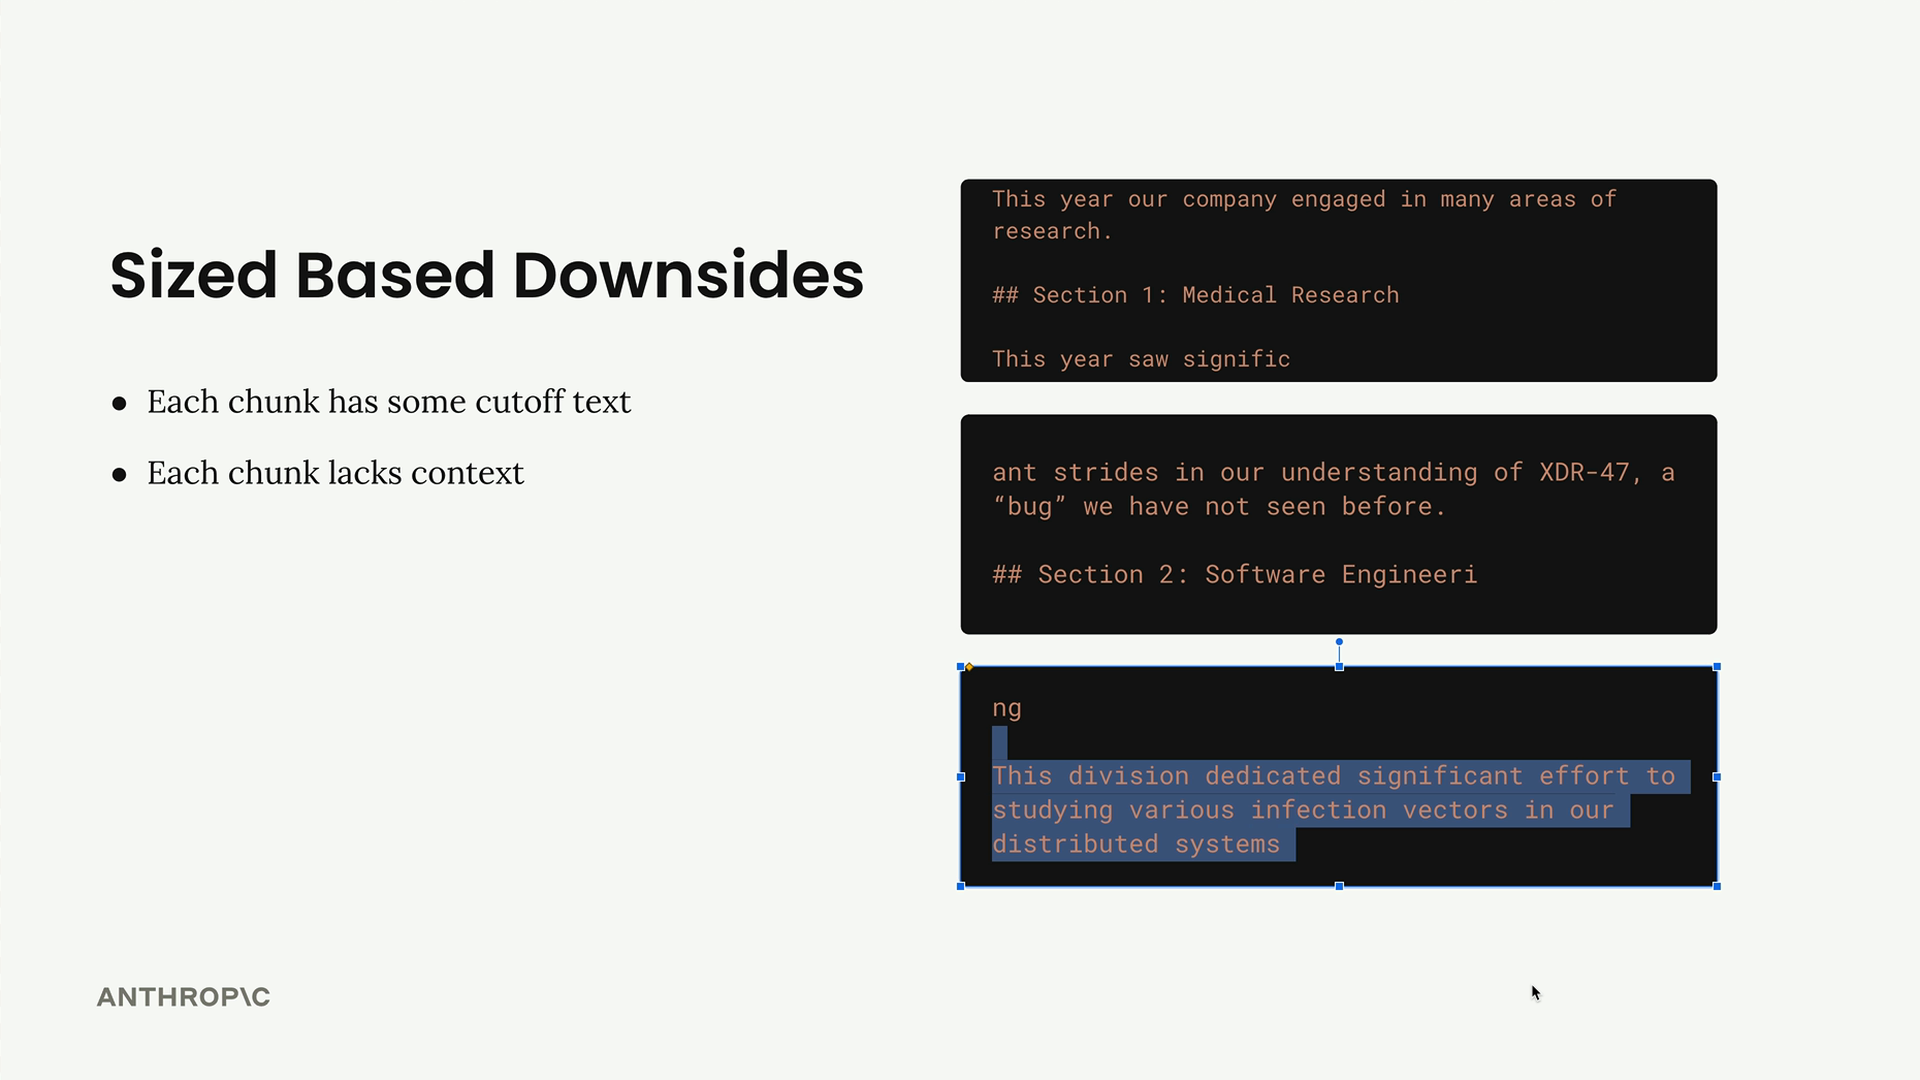
しかし、このアプローチには明確な欠点があります。単語が文の途中で切れてしまい、チャンクが重要なコンテキストを失ってしまいます。例えば、あるチャンクには、その内容が実際には何について書かれているのかを説明するセクション見出しが含まれていないことがあります。
この解決策は、チャンク間にオーバーラップを追加することです。各チャンクは隣接するチャンクからいくつかの文字を含むため、コンテキストの保持が向上し、急な切れ目を避けることができます。
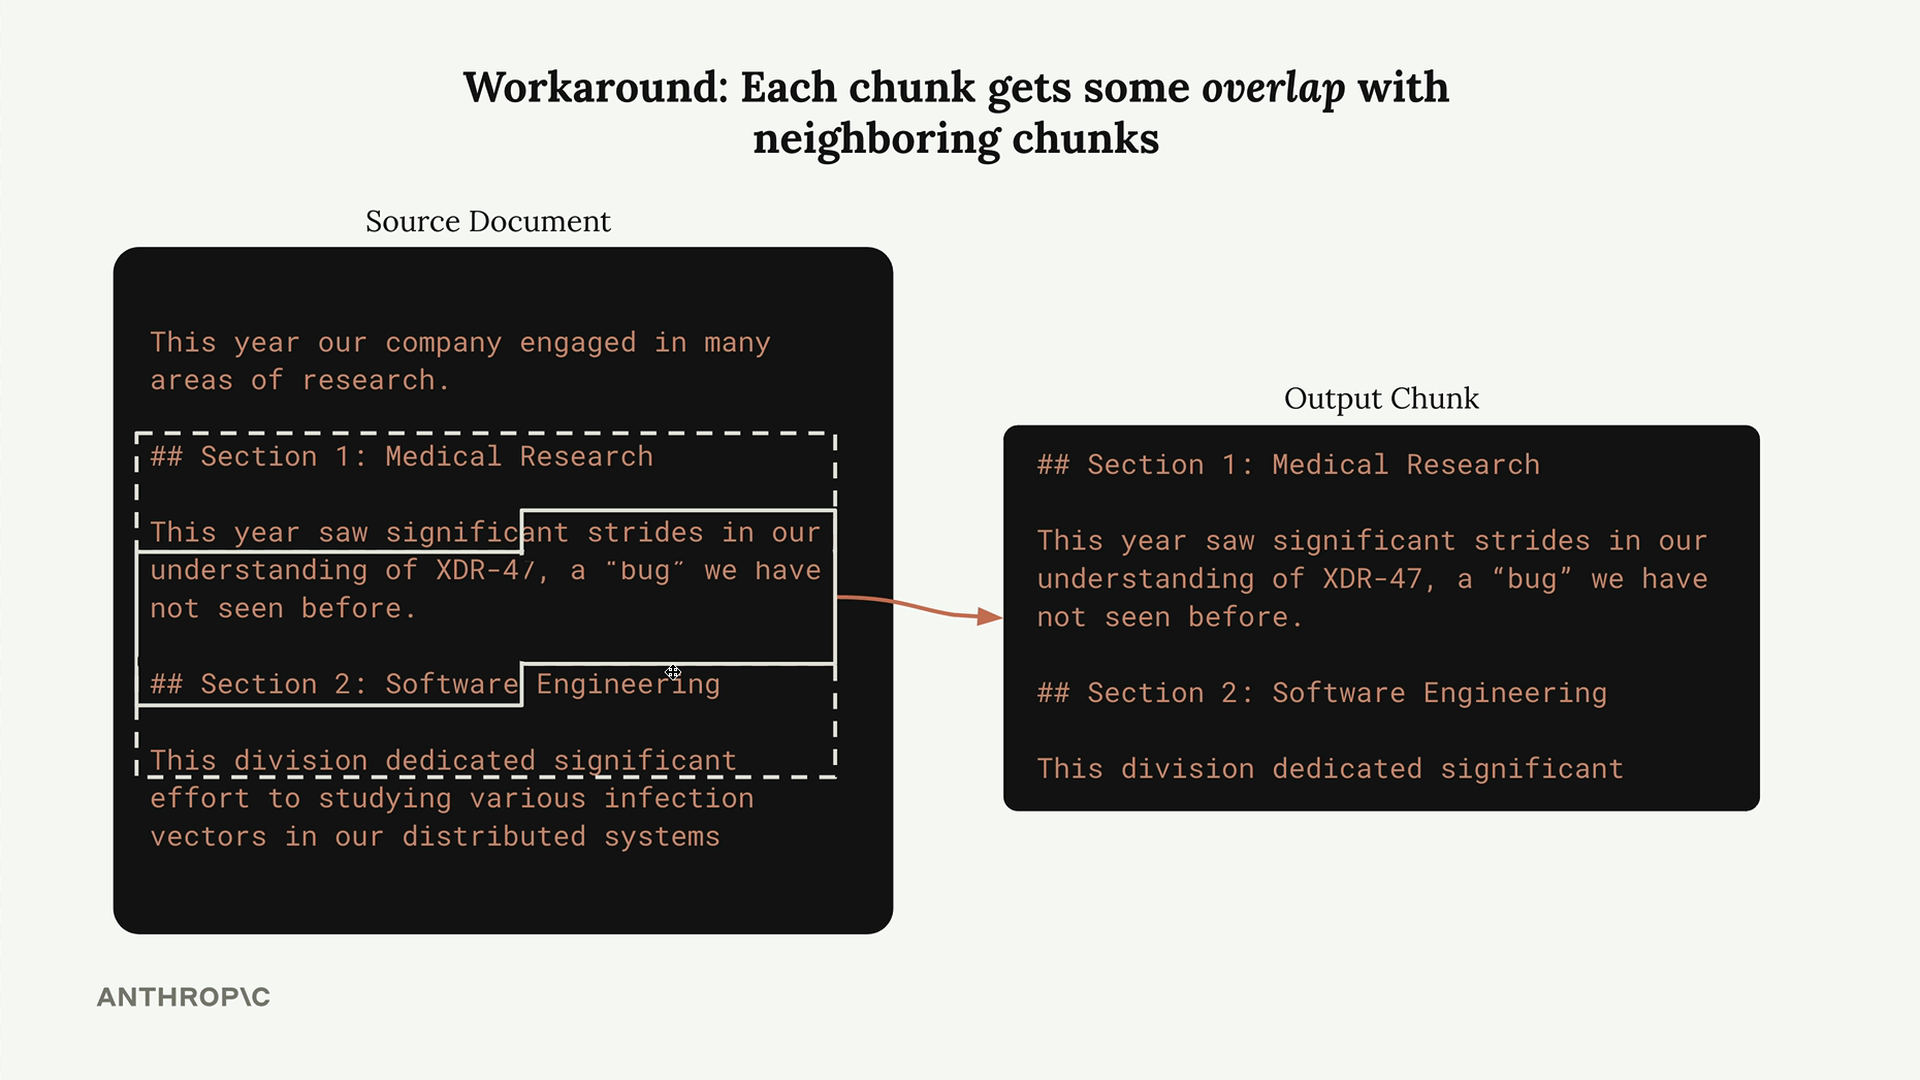
以下は、オーバーラップを用いた文字ベースのチャンキングの基本的な実装です。
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
構造ベースのチャンキング
構造ベースのチャンキングは、ドキュメントの自然な構成を活用します。マークダウンファイルを扱っている場合は、見出しで分割できます。他の形式の場合は、段落やその他の構造要素で分割することになるでしょう。
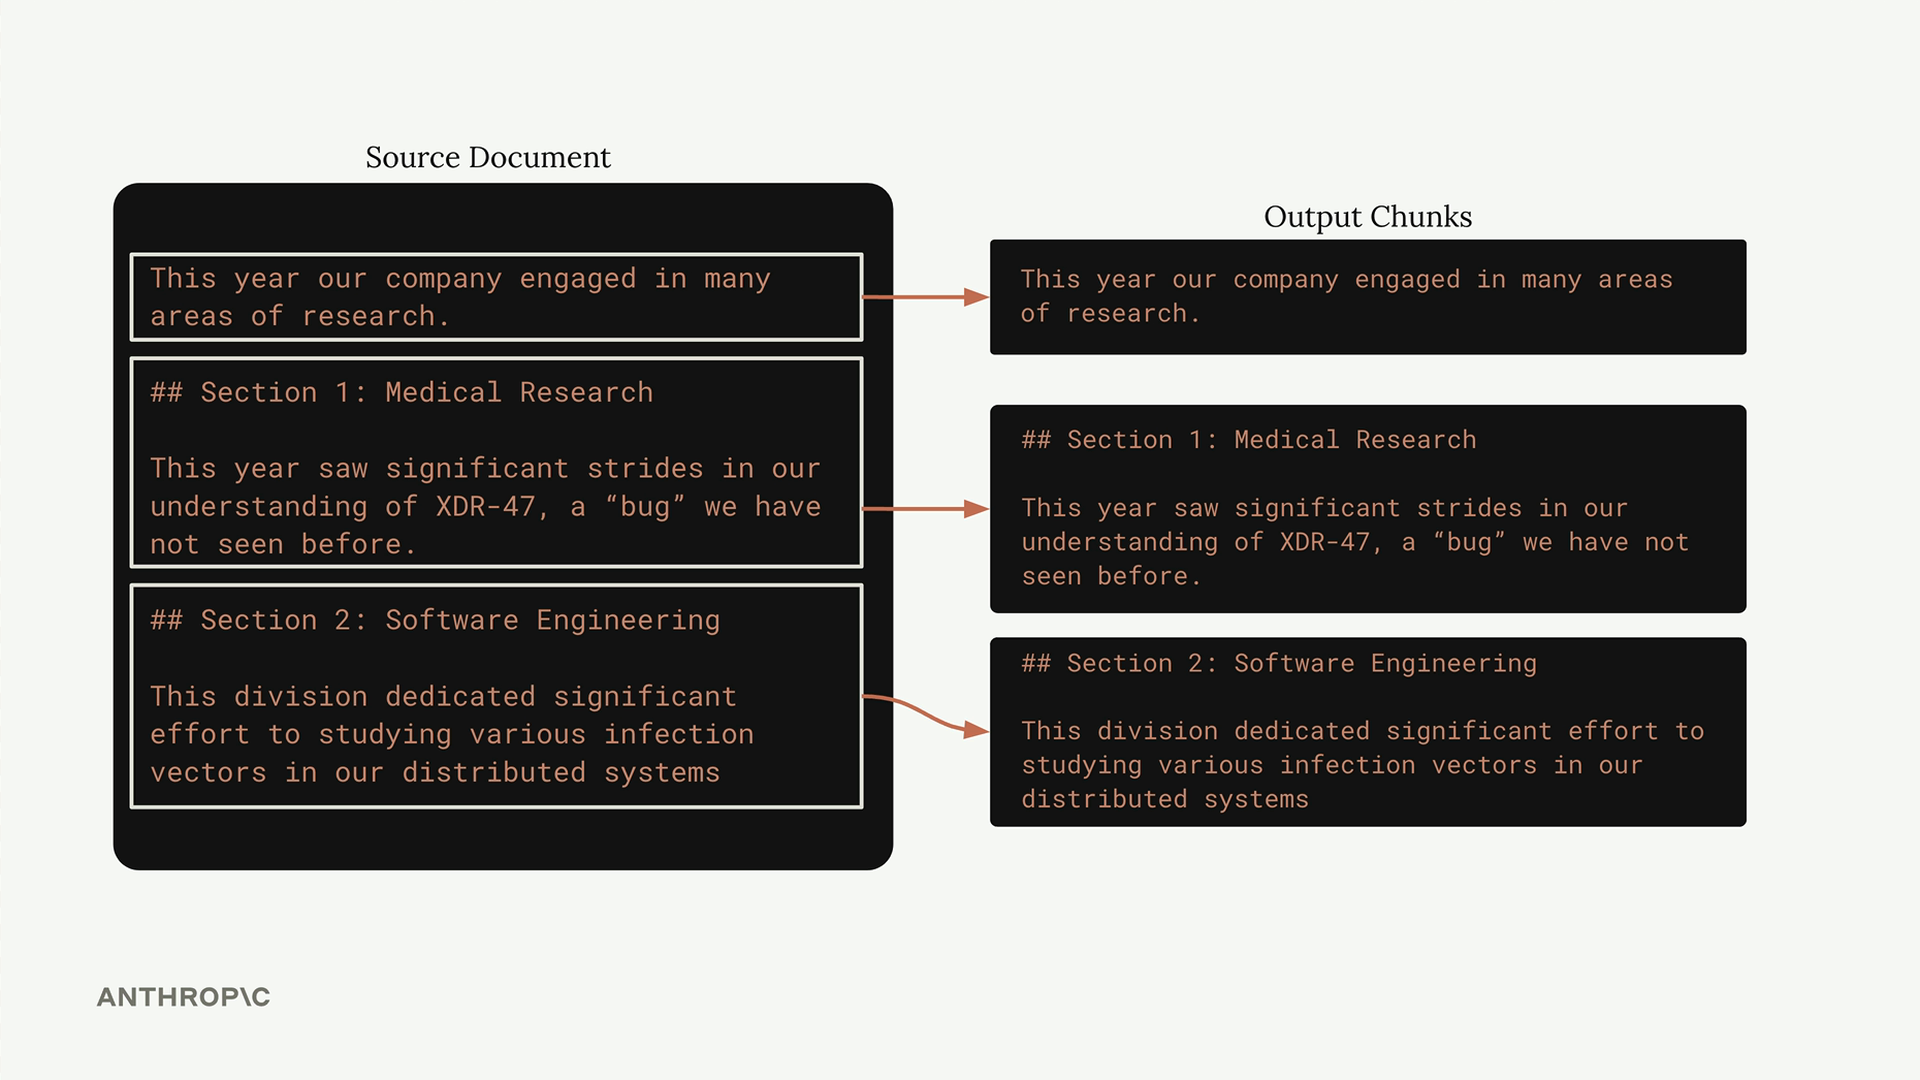
このアプローチは、ドキュメント構造について保証がある場合に非常にうまく機能します。マークダウンドキュメントの場合、セクション見出しで分割できます。
import re

def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
主な限界は、多くのドキュメントには一貫した構造がないことです。プレーンテキストファイル、PDF、またはユーザーがアップロードしたドキュメントには、分割の拠り所となる明確な構造マーカーがない場合があります。
意味ベースのチャンキング
意味ベースのチャンキングは最も高度なアプローチです。文同士の意味と関係を分析して、関連するコンテンツをグループ化します。これには通常以下が含まれます。
- テキストを文に分割する
- NLP技術を使って意味的な類似性を測定する
- 関連する文を一貫性のあるチャンクにグループ化する
これは最高品質のチャンクを生み出すことができますが、計算コストが高く、実装がより複雑です。ほとんどのアプリケーションでは、よりシンプルなアプローチで十分です。
実践的な実装
以下は、良い中間点となる文ベースのチャンキング関数です。
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
適切な戦略の選択
チャンキング戦略の選択は、あなたの具体的なユースケースに完全に依存します。
- 一貫したドキュメント構造: 最もクリーンな結果を得るには構造ベースのチャンキングを使用する
- 混在するドキュメントタイプ: 文ベースのチャンキングがよく機能することが多い
- コードや技術コンテンツ: 文字ベースのチャンキングが最も信頼性が高い
- 不明なドキュメント形式: 文字ベースのチャンキングが最も安全な選択
チャンキングはしばしば反復的なプロセスであることを覚えておいてください。まずはシンプルなアプローチから始め、あなたの具体的なドキュメントやユースケースでテストし、その結果に基づいて改善していきます。「最良の」チャンキング戦略とは、あなたの特定のデータと要件に対して確実に機能するものです。