セマンティック検索(ベクトル埋め込み)とレキシカル検索(BM25)の両方が独立して動作するようになったら、次のステップはそれらを統合検索パイプラインに組み合わせることです。このハイブリッドアプローチは両方の手法の強みを活かし、より正確な結果を提供します。
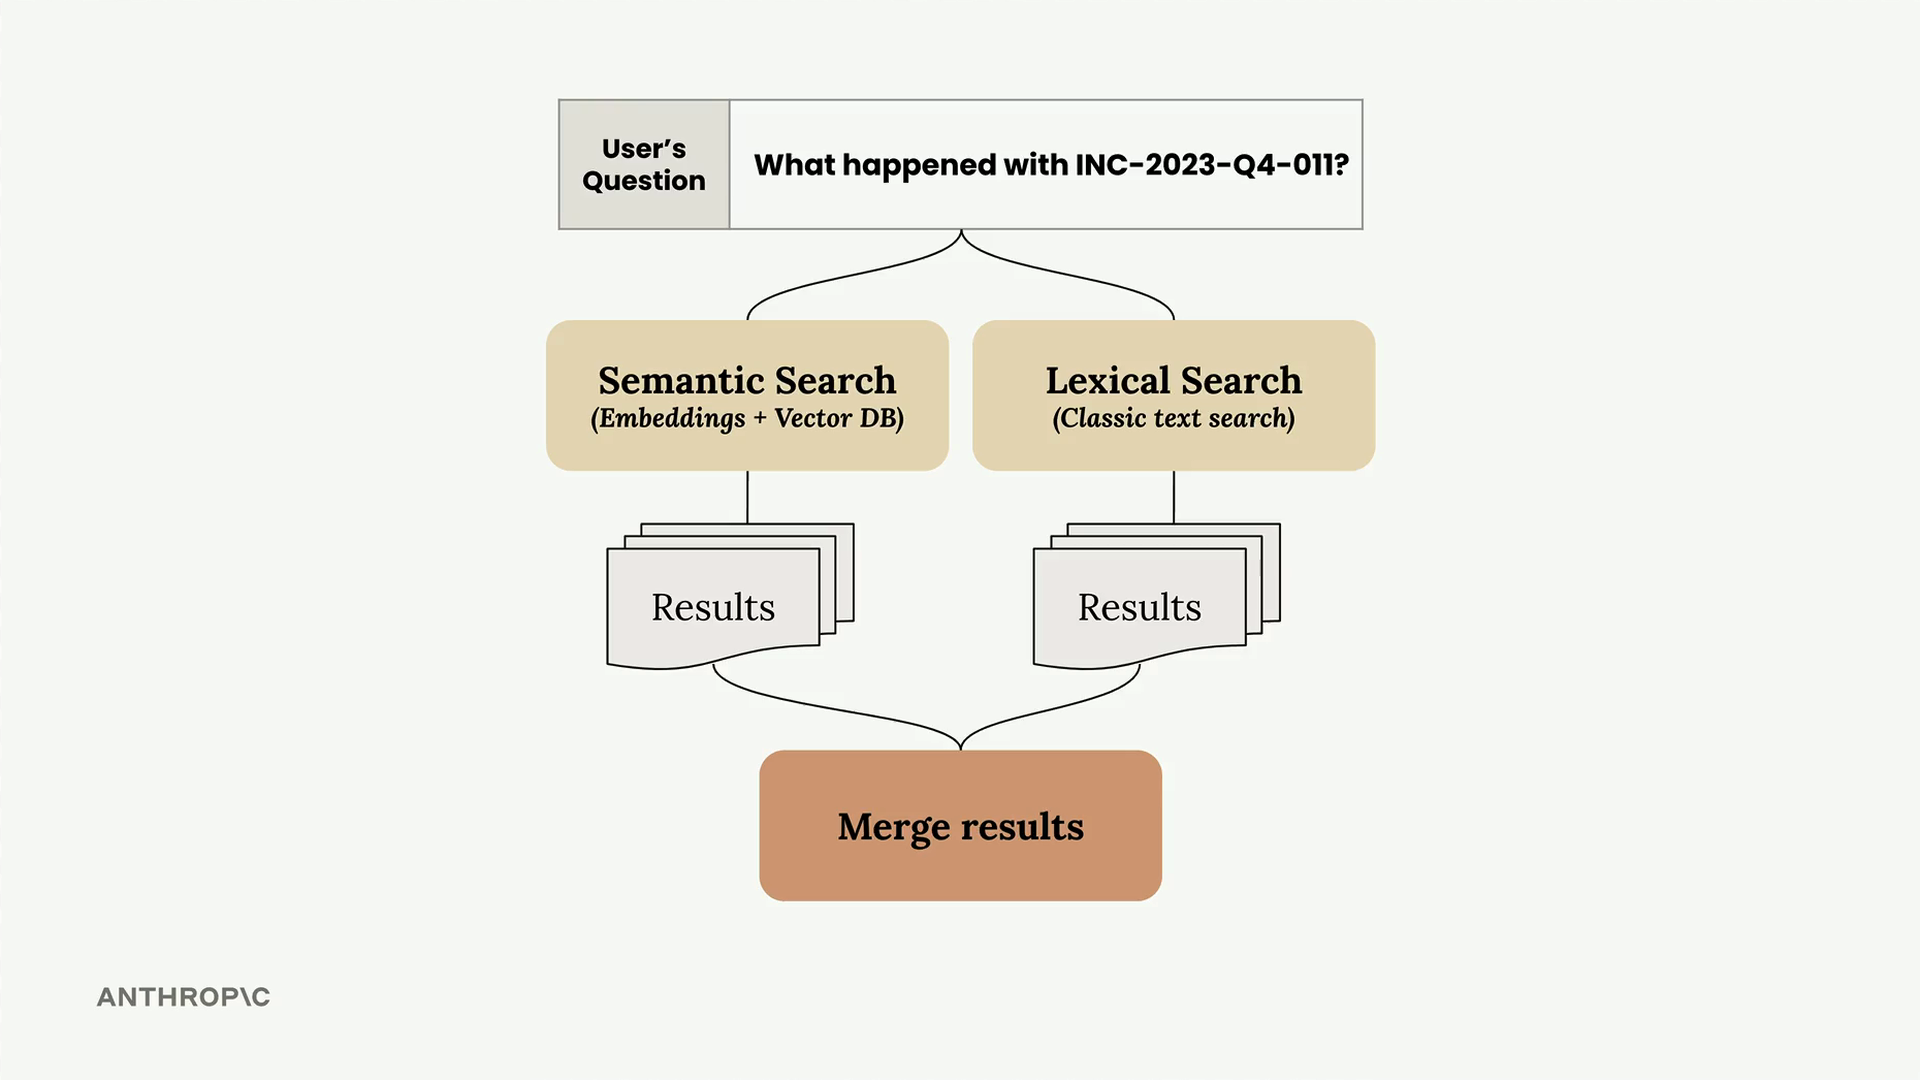
統一インターフェースの作成
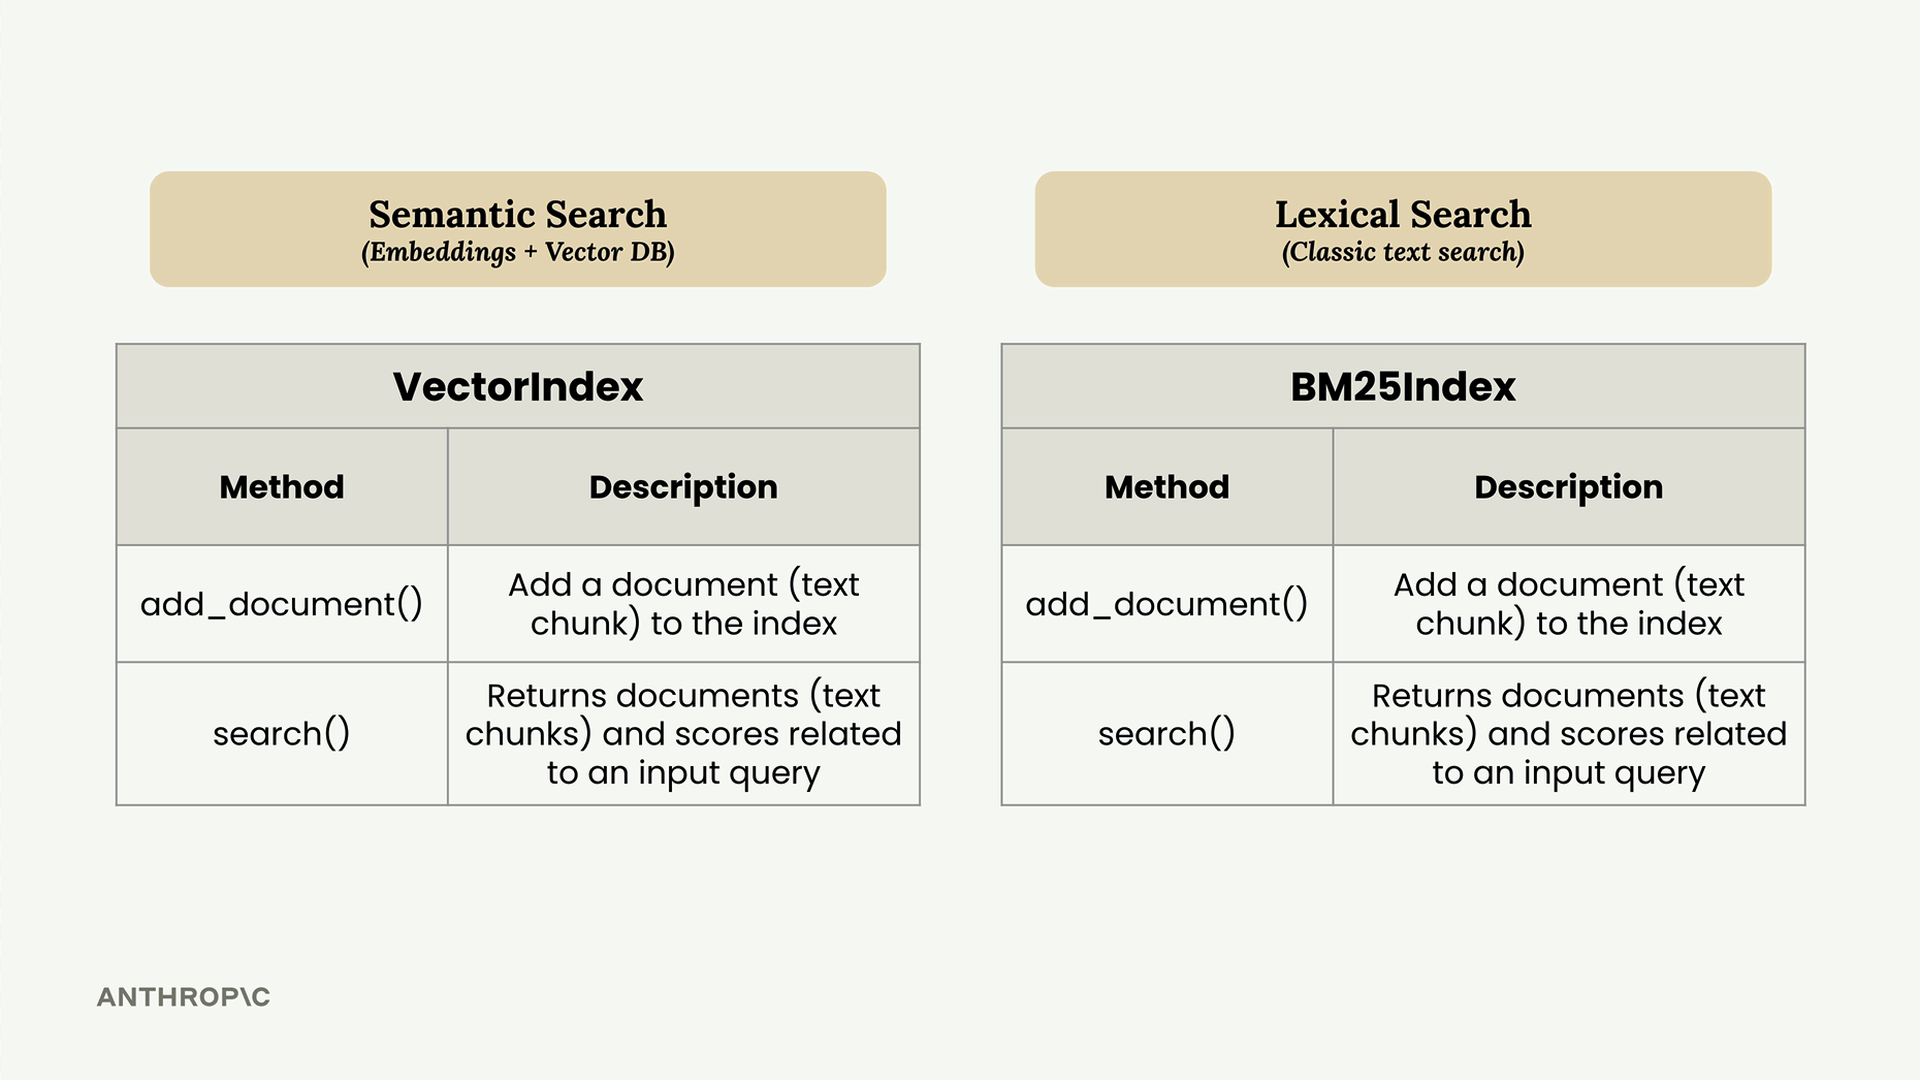
両方の検索実装はほぼ同一のAPIを共有しています。どちらも同じように動作するadd_document()とsearch()メソッドを持っています。この一貫性により、単一のRetrieverクラスにそれらをラップすることが簡単になります。
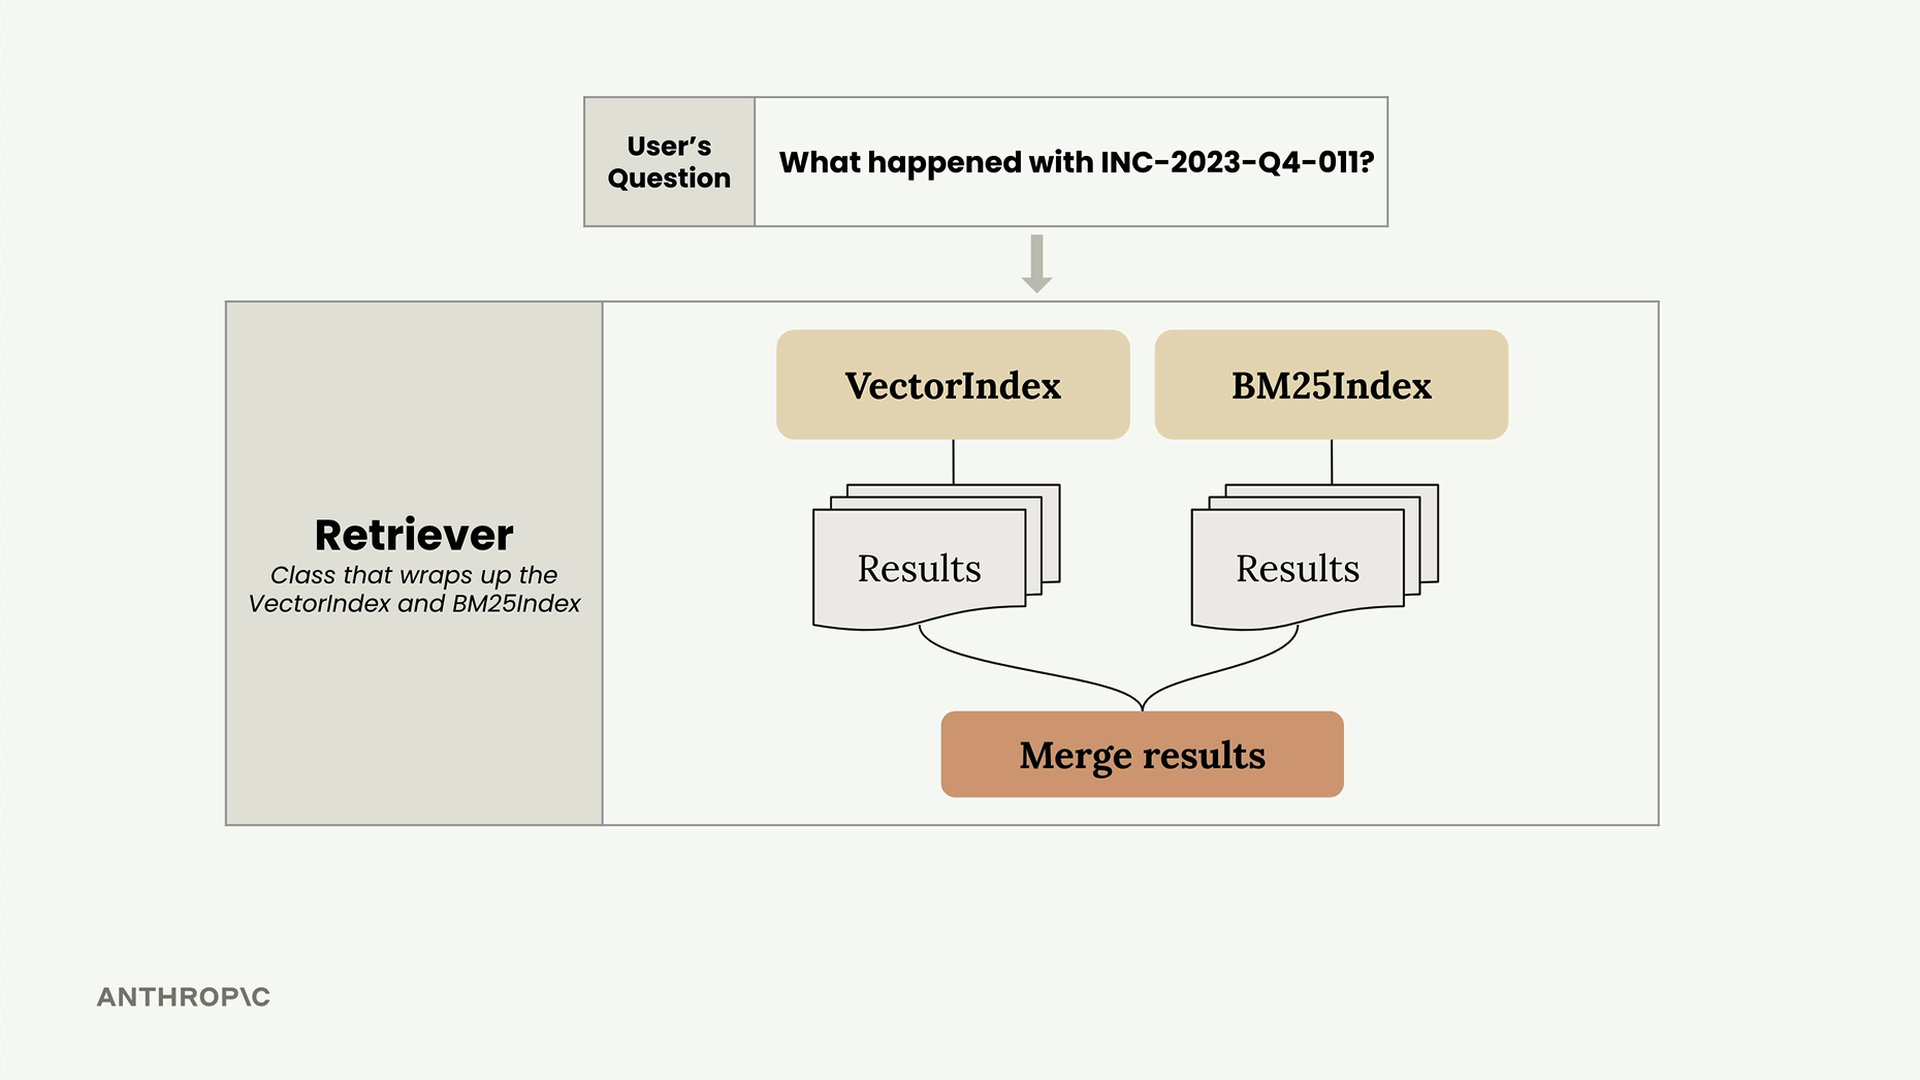
Retrieverは、ユーザーのクエリを両方のインデックスに転送し、それらの結果を収集し、単一のランク付けされたリストにマージするコーディネーターとして機能します。
Reciprocal Rank Fusion
課題は、異なるスコアリングシステムを使用する異なる検索手法の結果をマージすることです。ベクトル検索はコサイン類似度スコアを返し、BM25は関連性スコアを返します。これらの数値を単純に直接組み合わせることはできません。
そこで、Reciprocal Rank Fusion(RRF)と呼ばれる手法を使用します。この方法は、生のスコアではなく結果のランク位置に焦点を当てます。
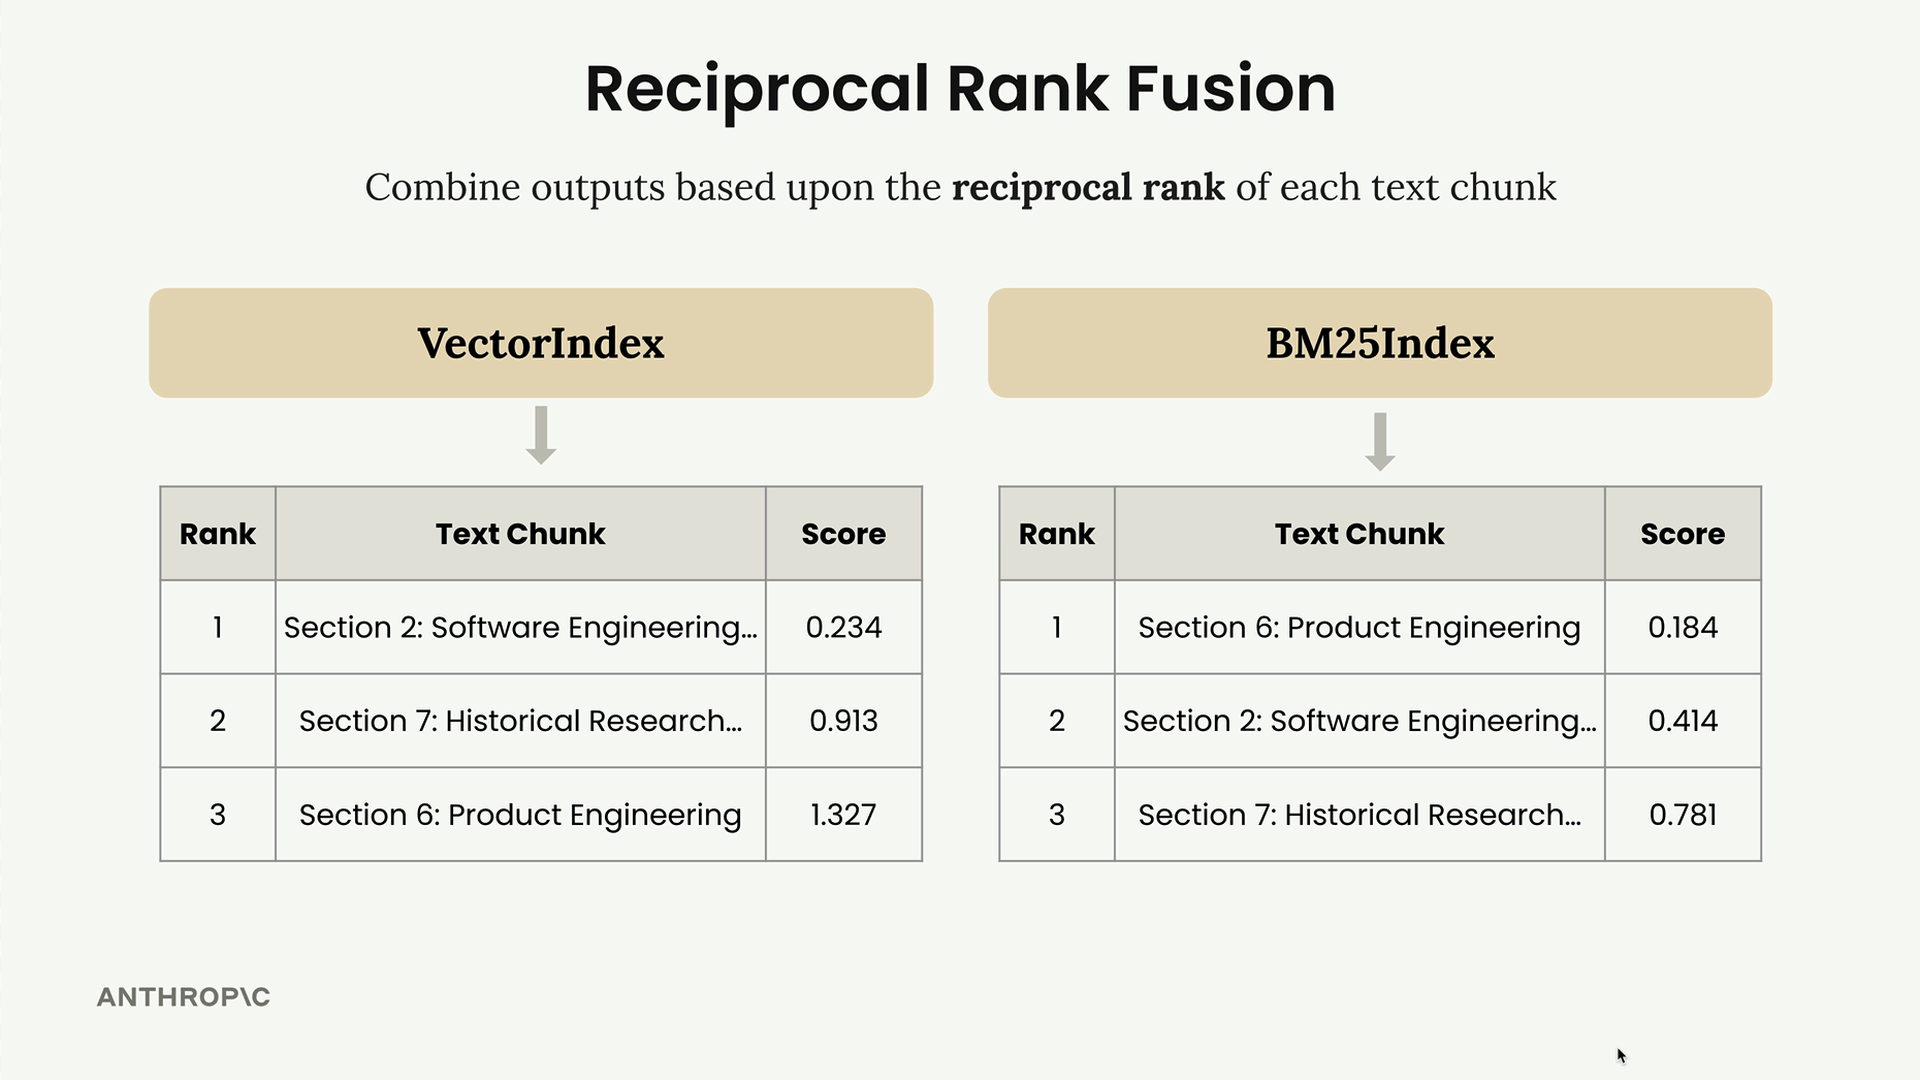
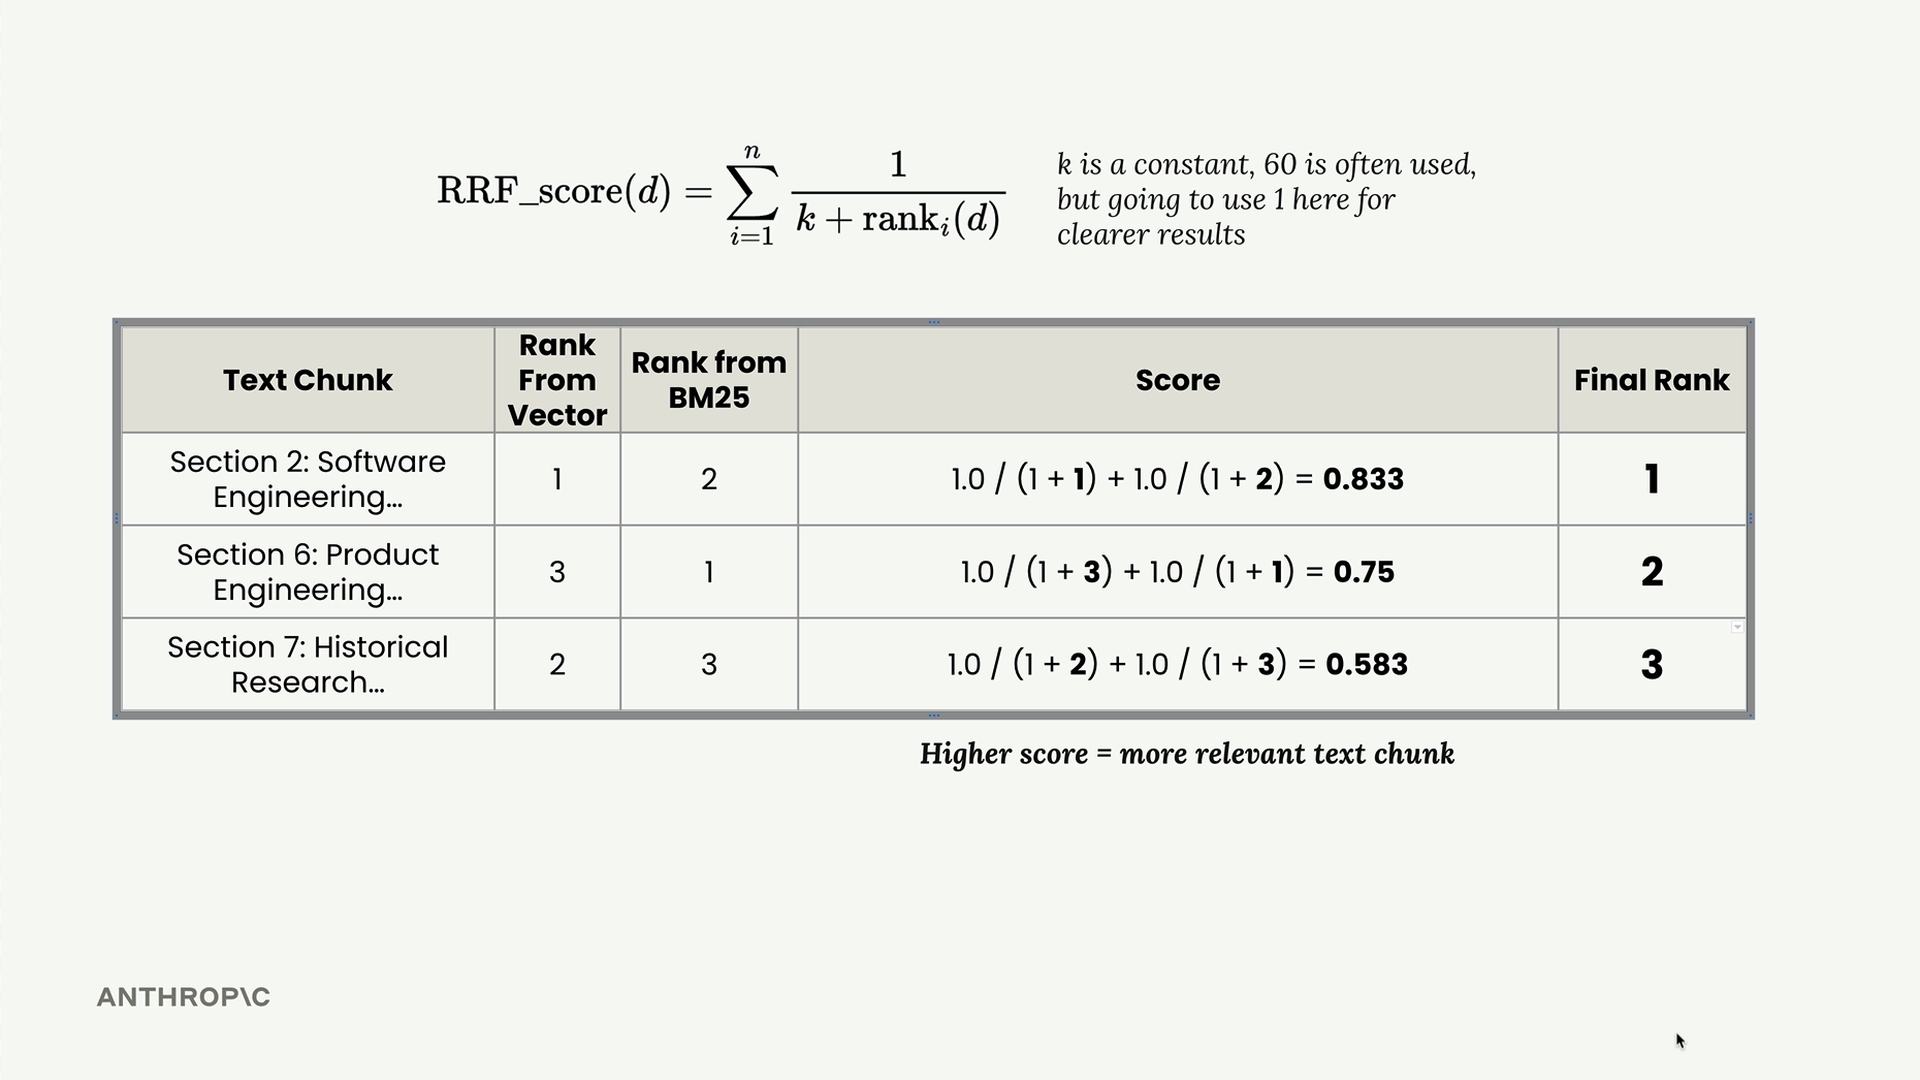
例でどのように機能するか見てみましょう。ベクトル検索がセクション2、7、6の順で結果を返し、BM25がセクション6、2、7を返すとします。これらをマージするには:
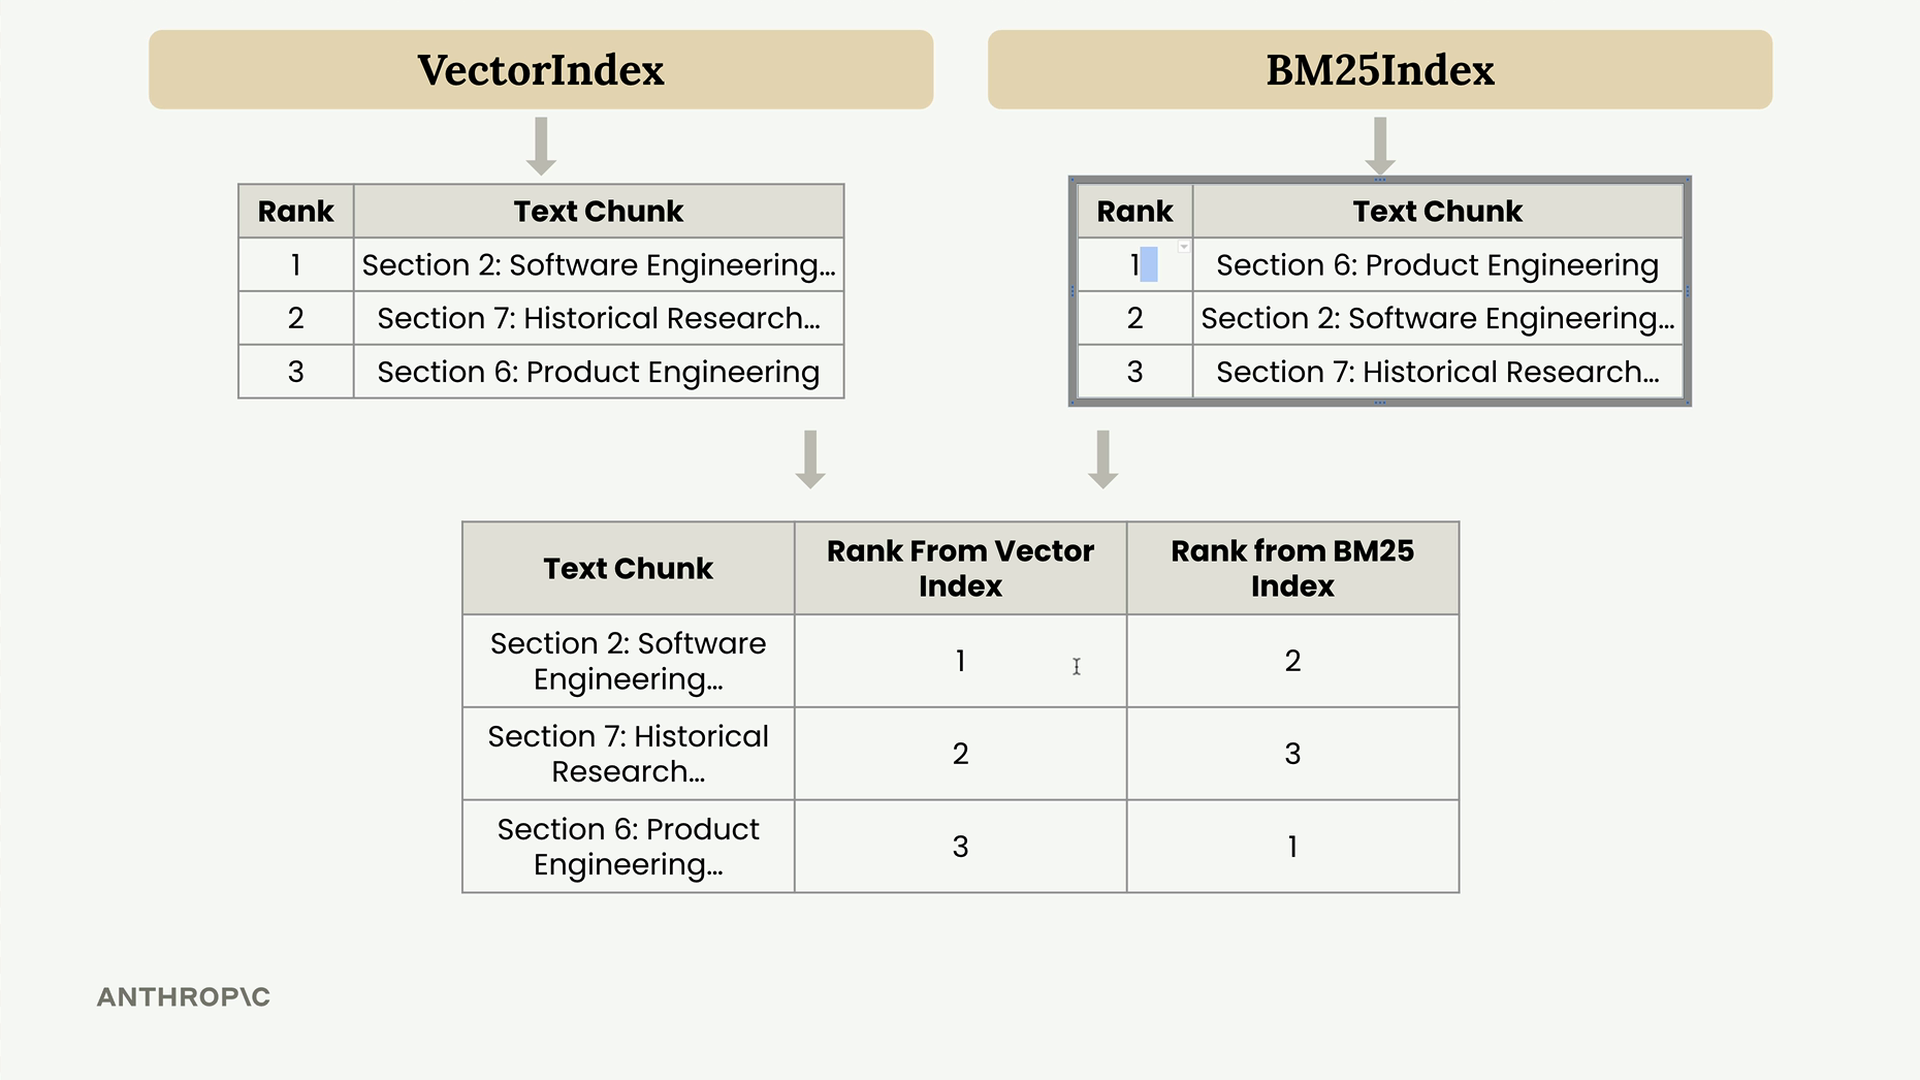
まず、各テキストチャンクとその両方の検索方法からのランクを示すテーブルを作成します:
- セクション2: ベクトルからランク1、BM25からランク2
- セクション7: ベクトルからランク2、BM25からランク3
- セクション6: ベクトルからランク3、BM25からランク1
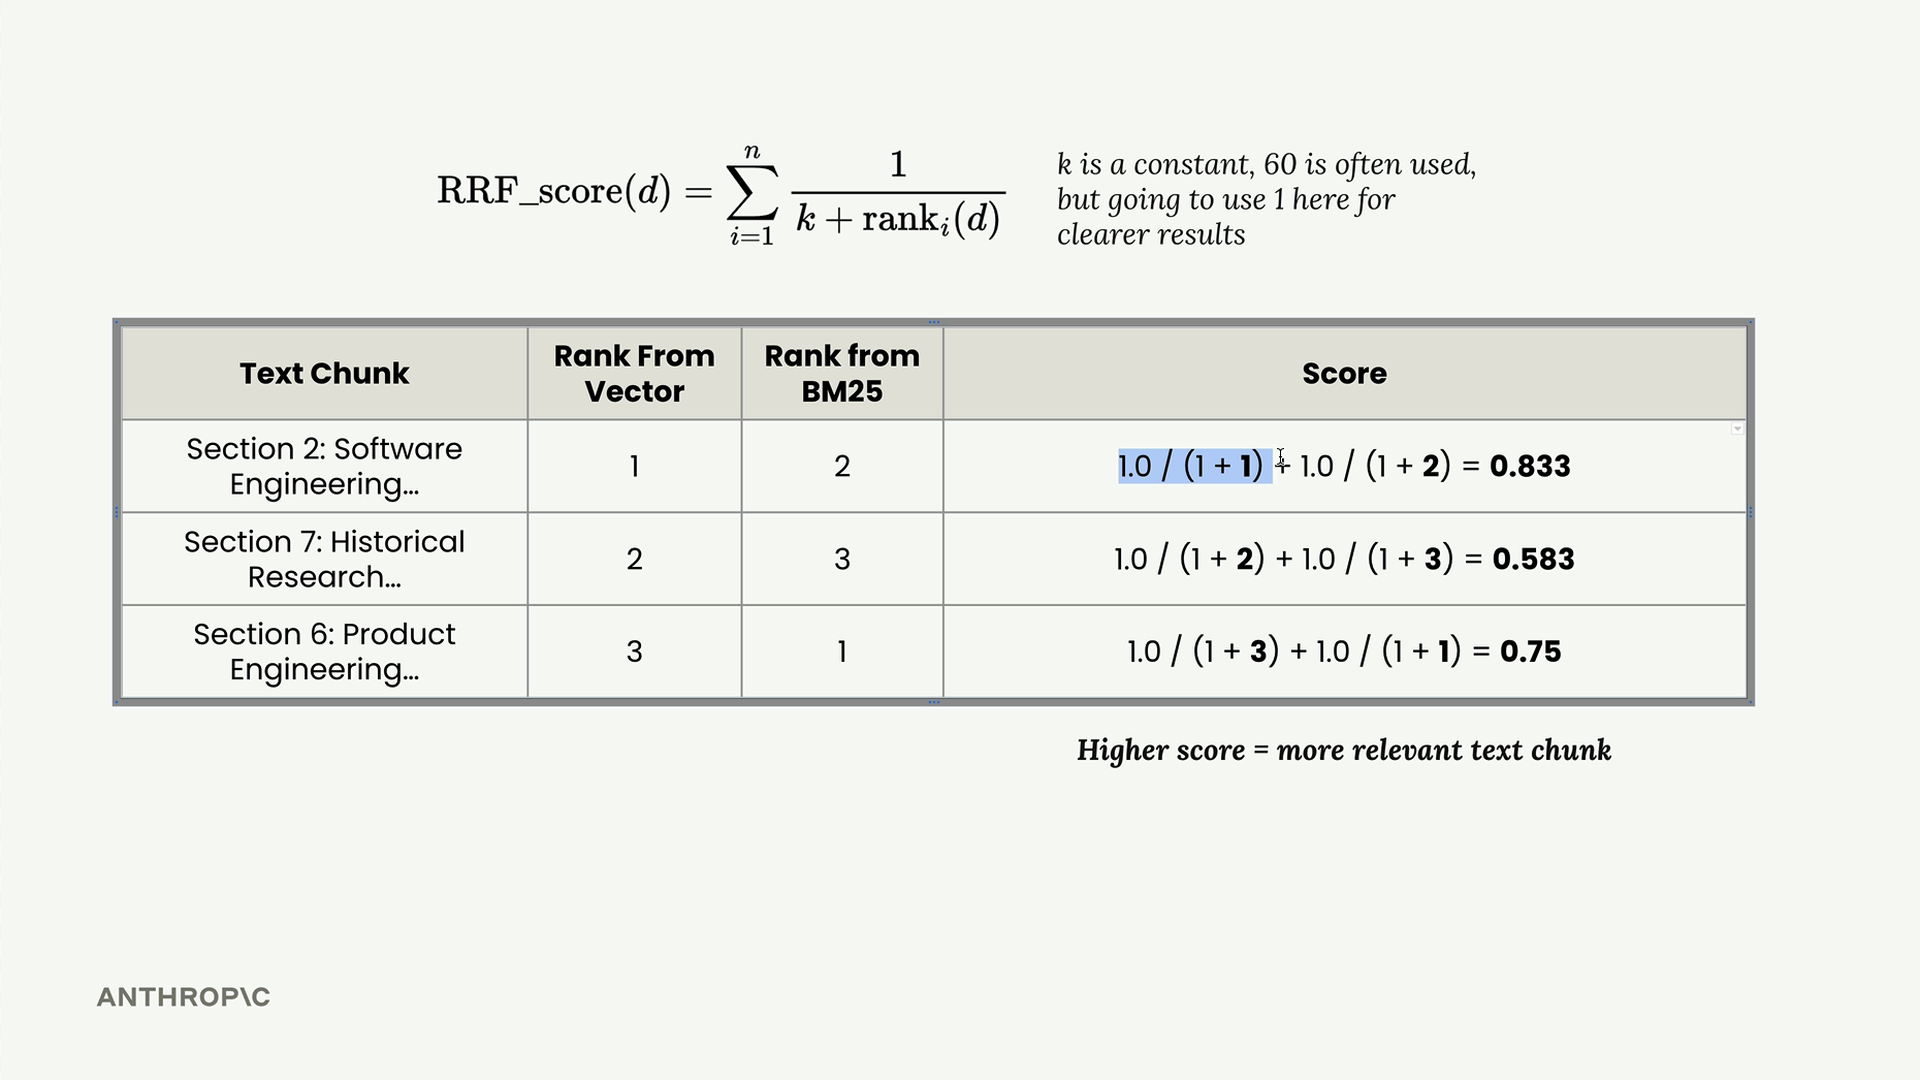
次に、RRFの数式を適用して各チャンクの結合スコアを計算します:
RRF_score(d) = Σ(1 / (k + rank_i(d)))ここでkは定数です(通常は60ですが、より分かりやすい結果のために1を使用します)。またrank_i(d)は、i番目の検索結果におけるドキュメントdのランクです。
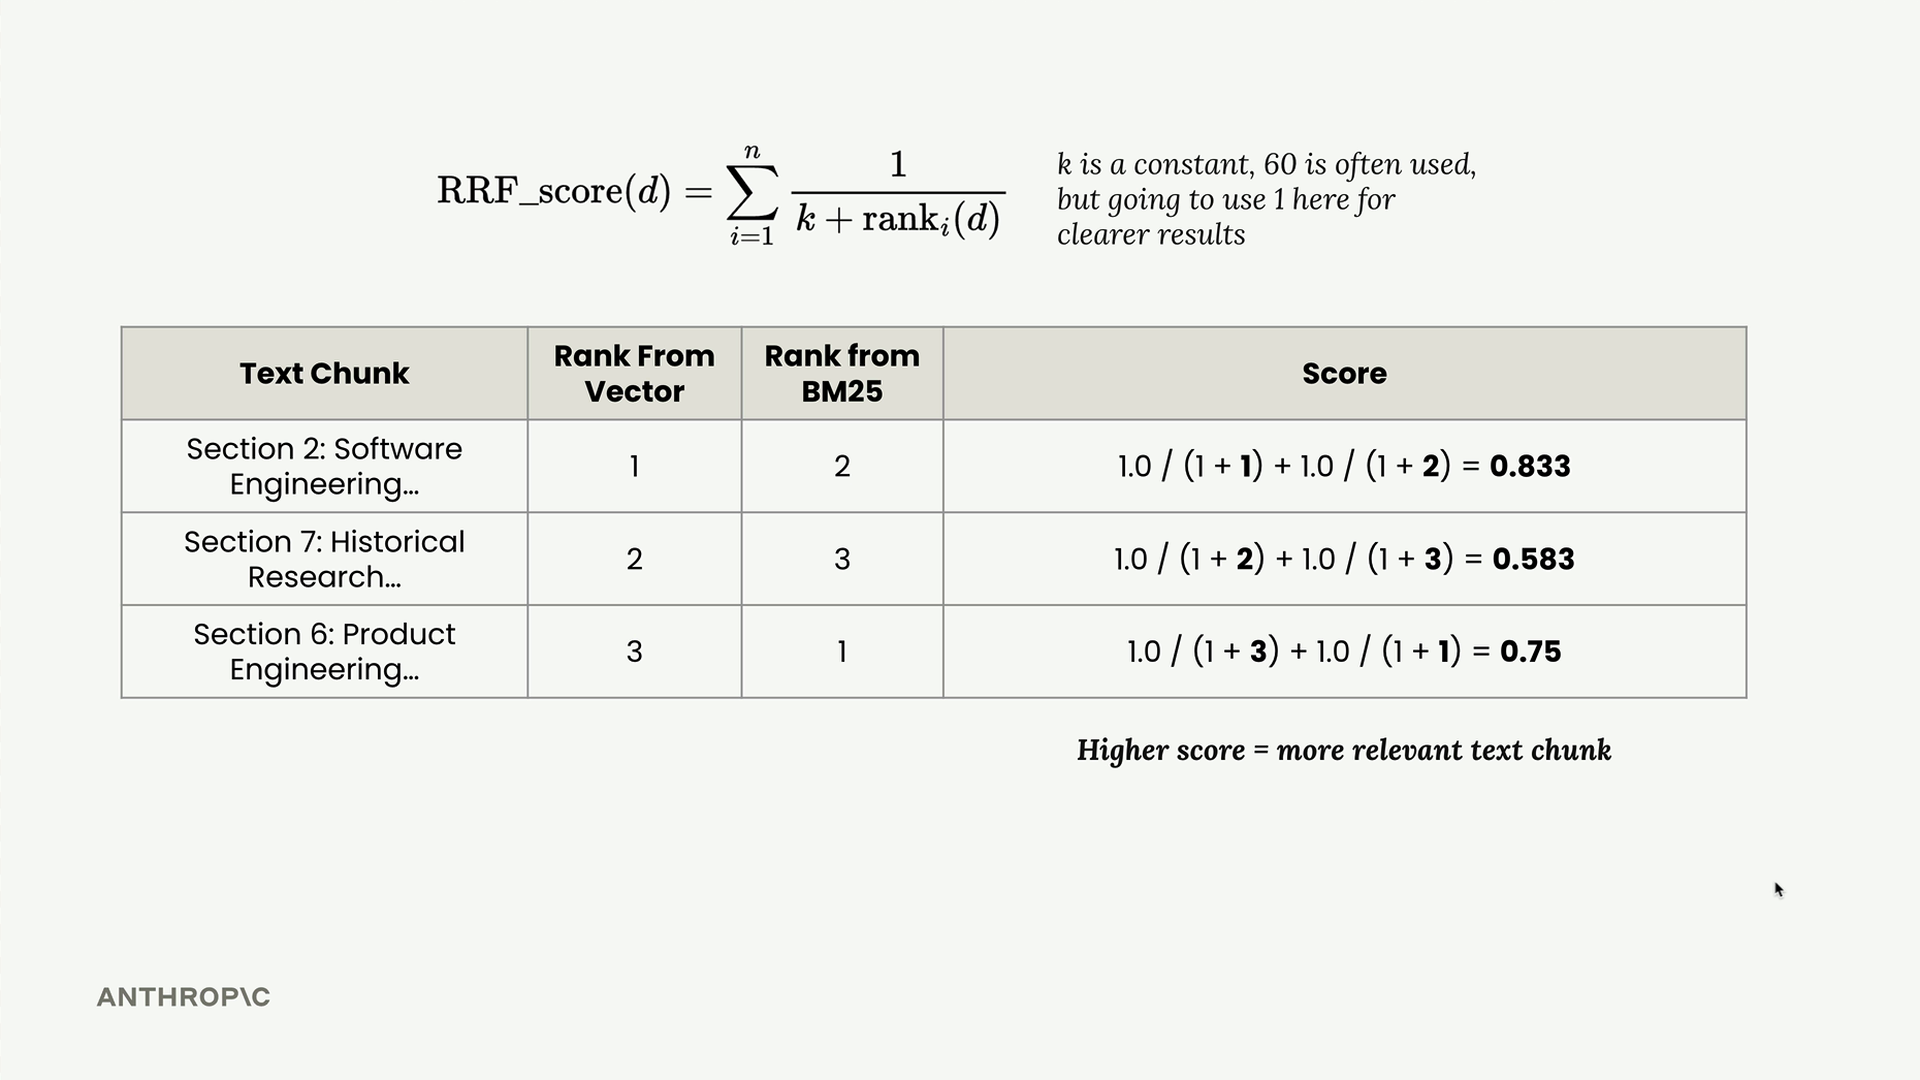
この例の場合:
- セクション2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- セクション7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- セクション6: 1.0/(1+3) + 1.0/(1+1) = 0.75
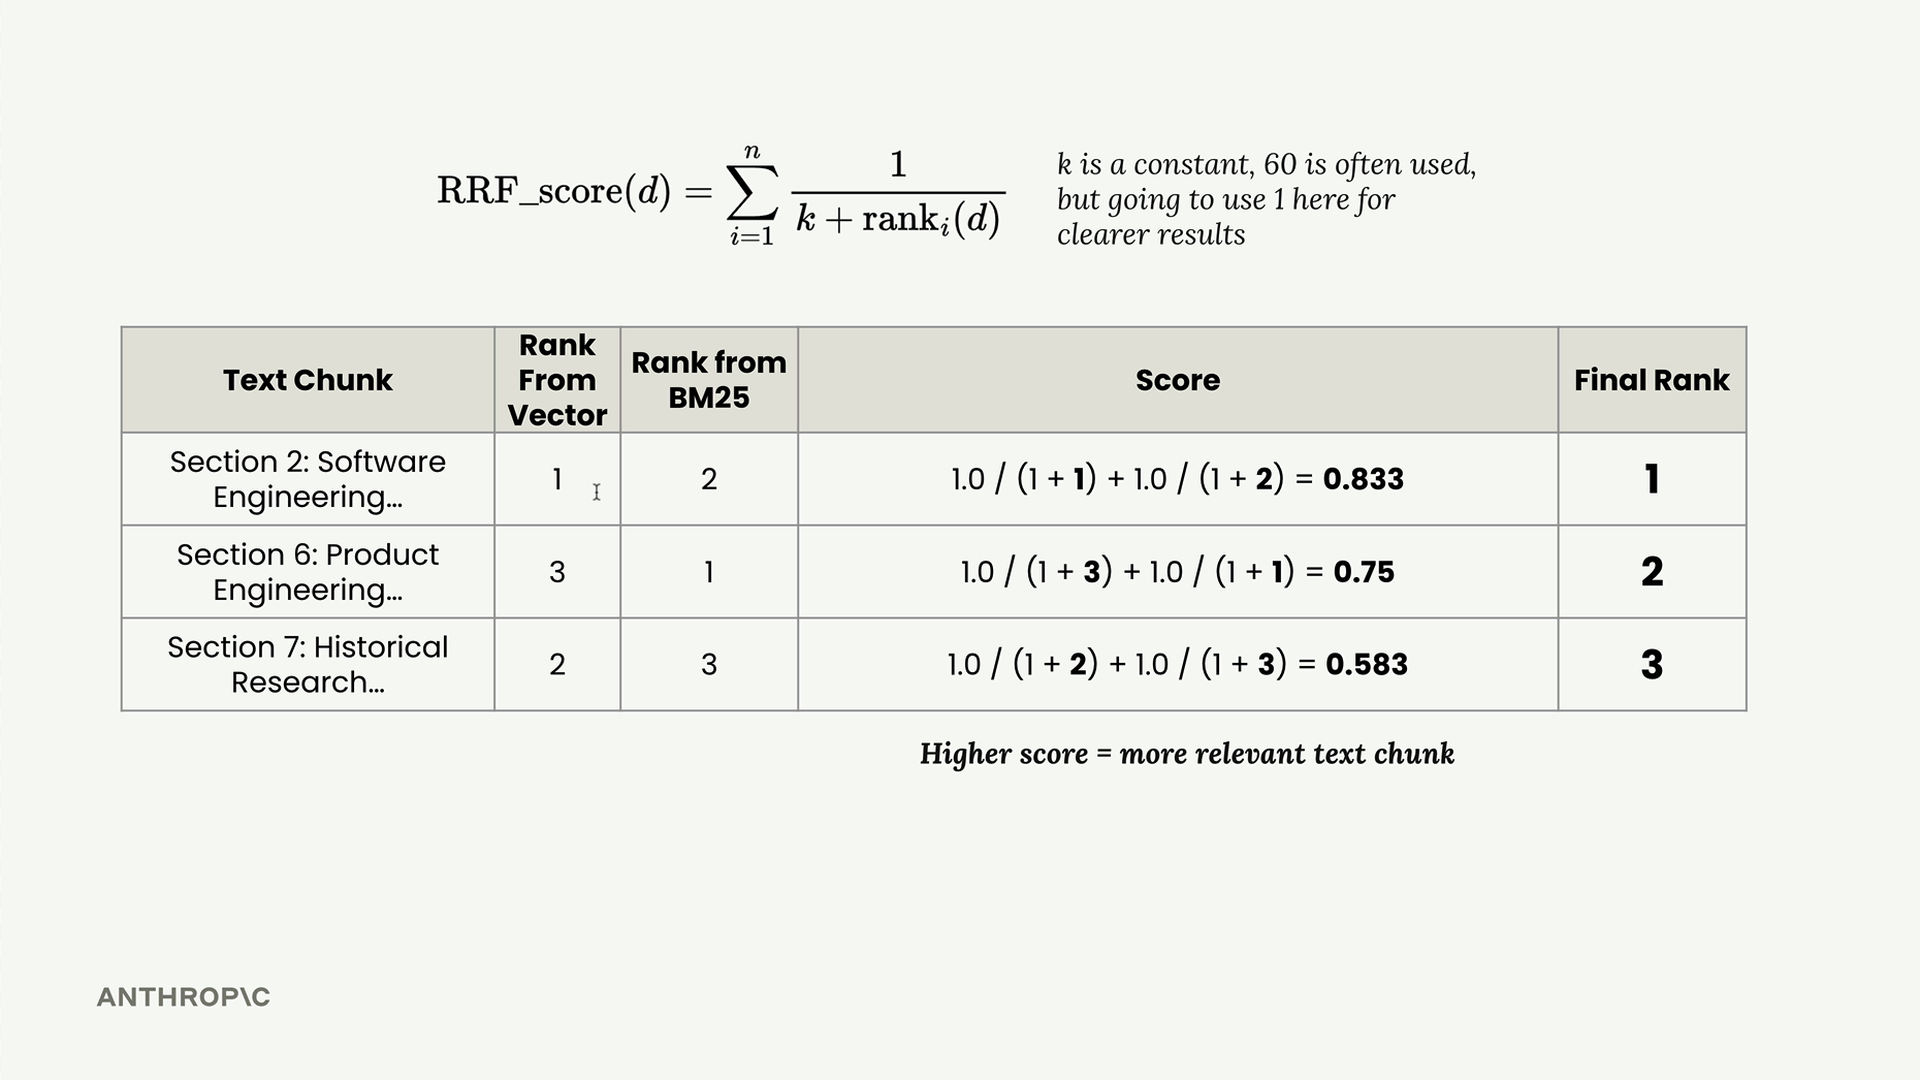
最終的なランキングは次のようになります: セクション2(0.833)、セクション6(0.75)、セクション7(0.583)。これは直感的に理にかなっています。セクション2は両方の検索で良いパフォーマンスを示し、セクション6は混在した結果となり、セクション7は全体として低いランクとなりました。
実装
Retrieverクラスの実装は単純明快です:
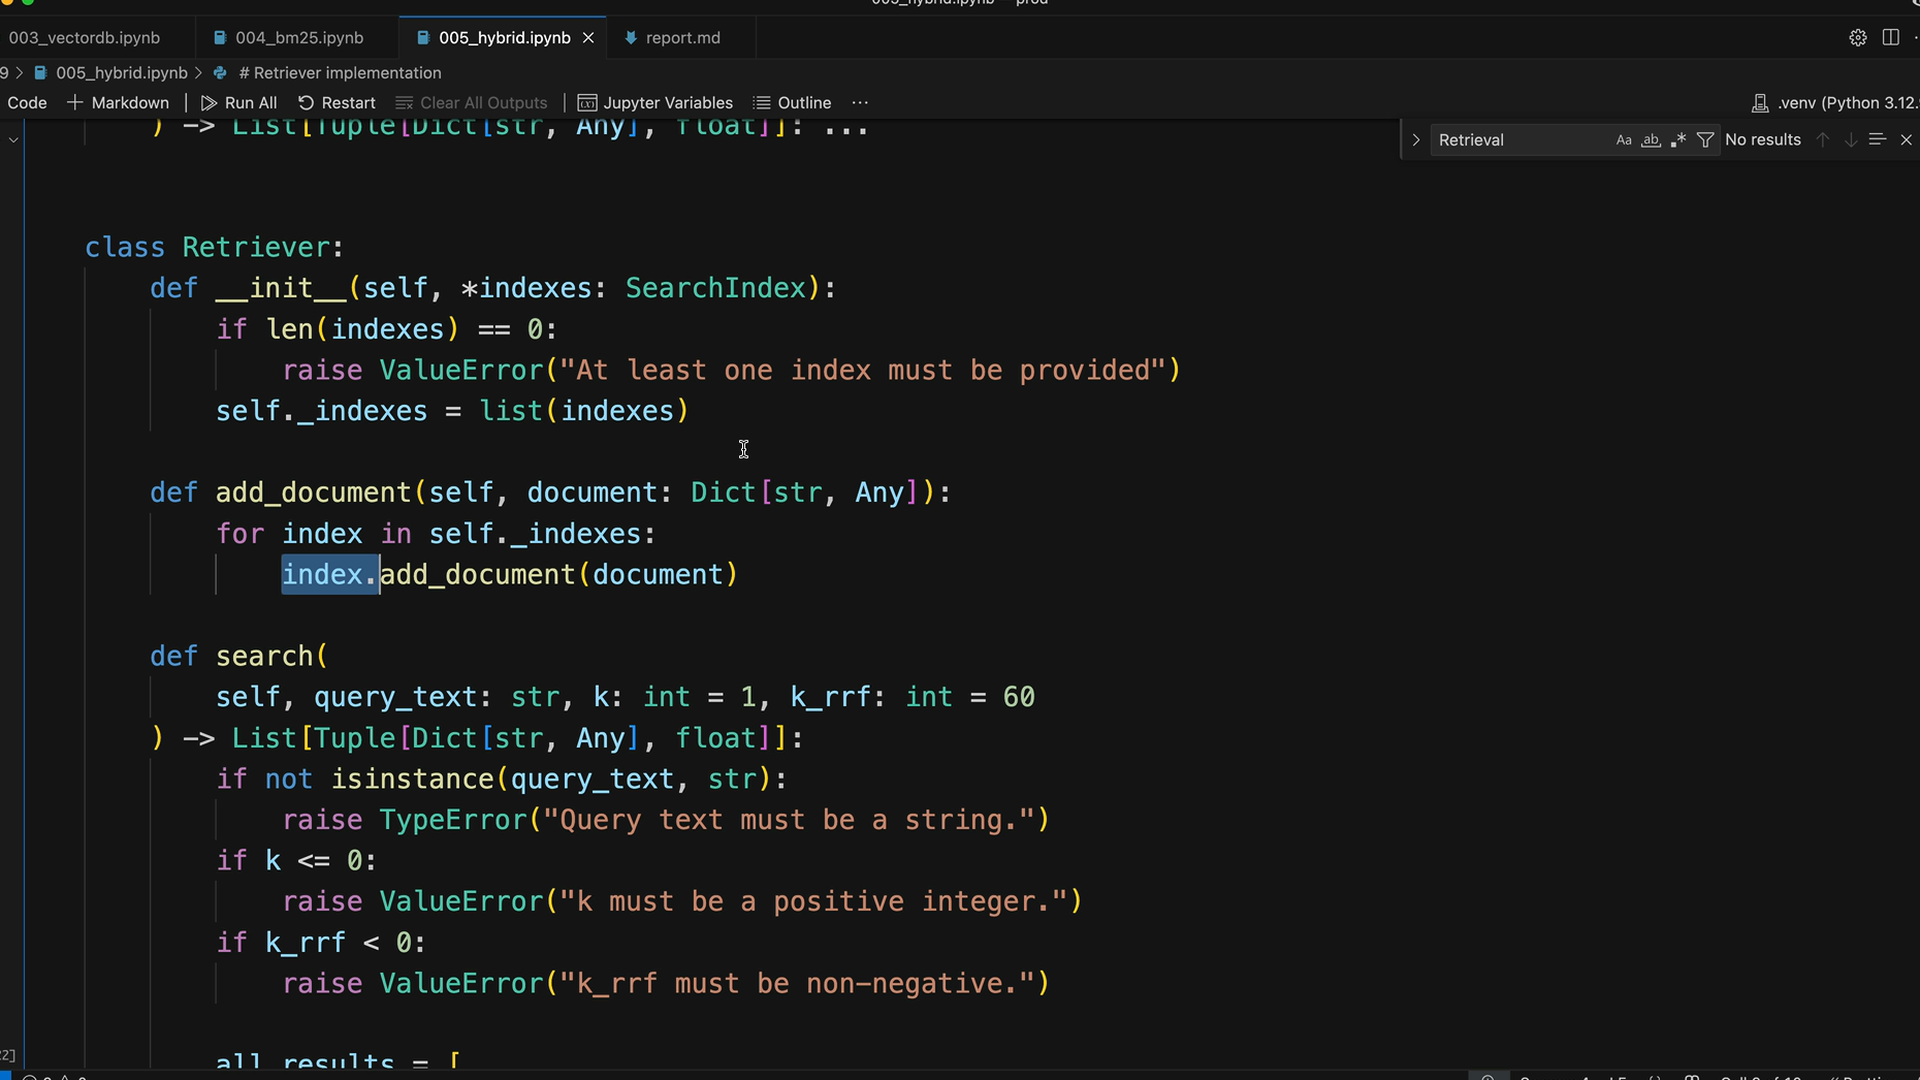
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # すべてのインデックスから結果を取得
        all_results = [index.search(query_text, k) for index in self._indexes]

        # reciprocal rank fusionを適用
        # ...ここにマージ処理...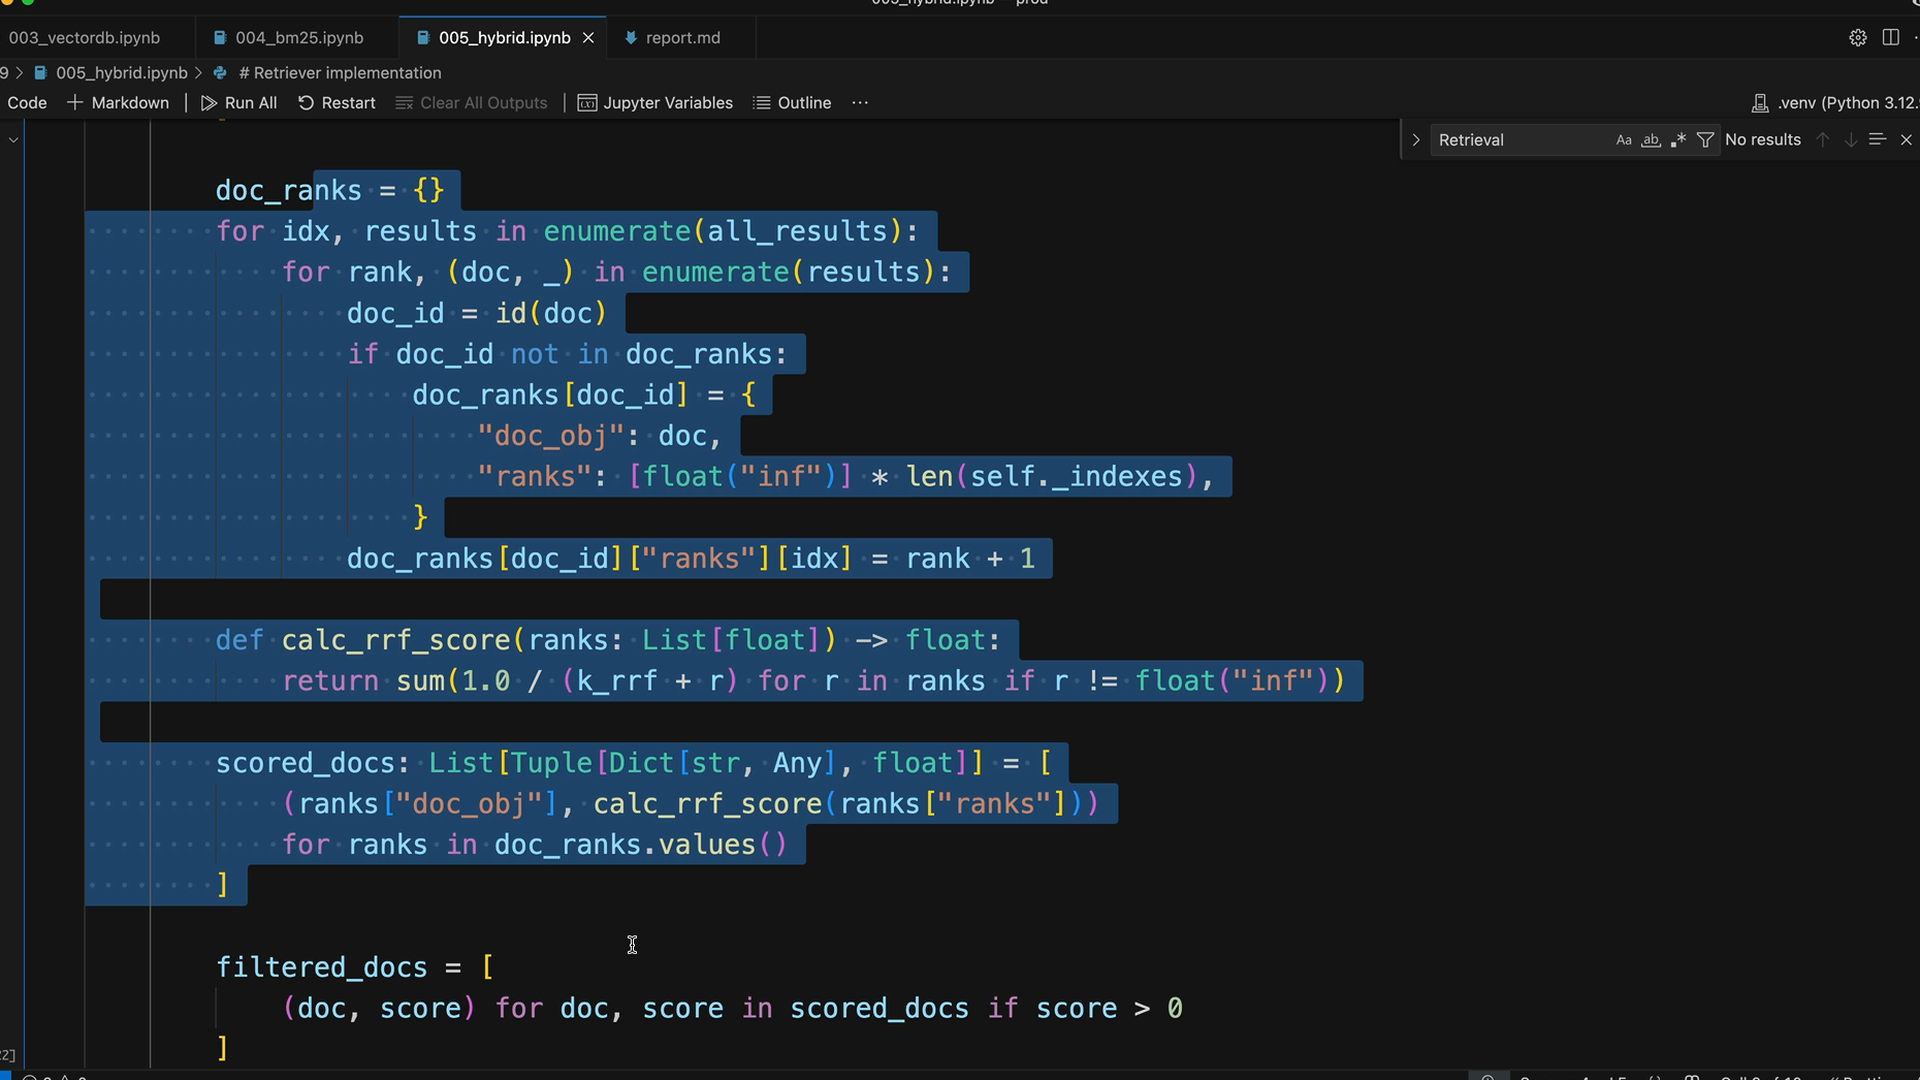
マージロジックは、すべての検索結果にわたるドキュメントのランクを追跡し、RRFスコアを計算し、結合スコアでソートされた上位k件のドキュメントを返します。
ハイブリッドアプローチのテスト
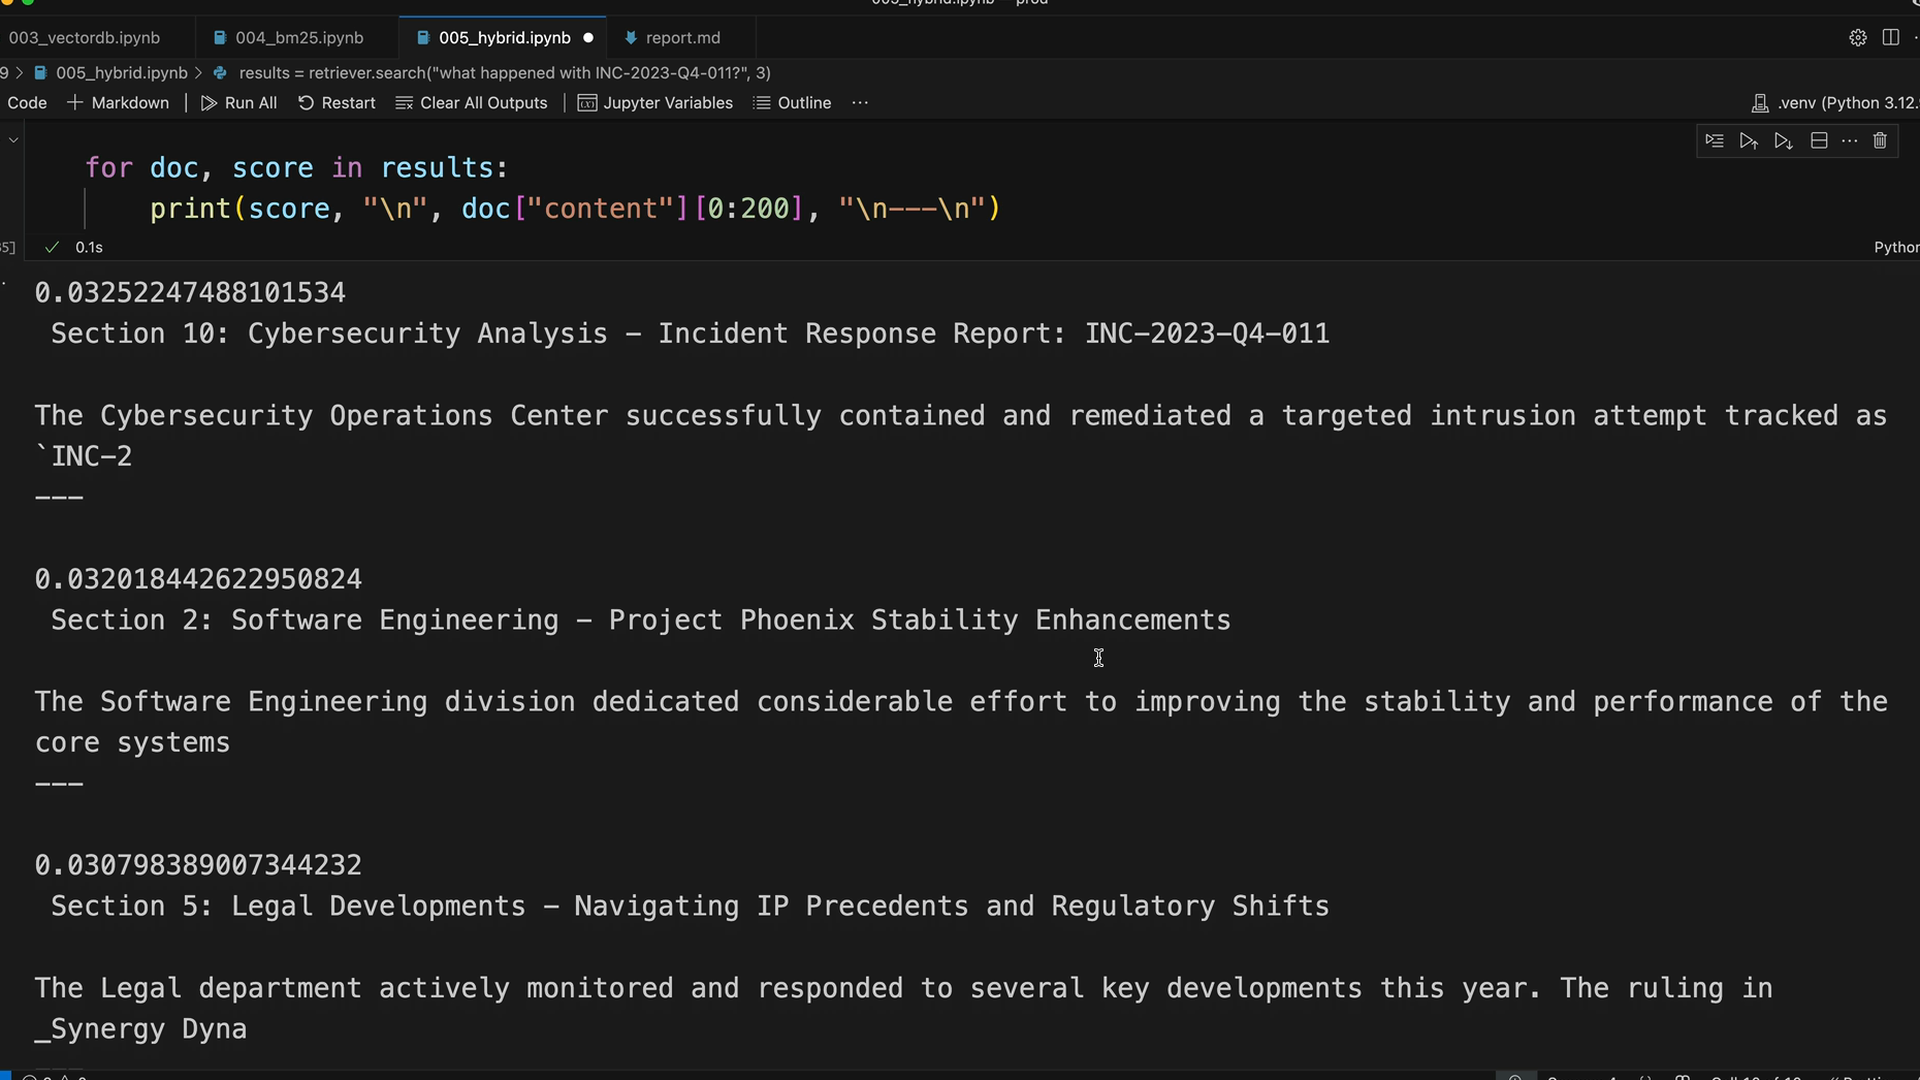
「what happened with INC-2023-Q4-011?」というクエリでテストすると、ハイブリッドアプローチはベクトル検索単独よりもはるかに優れた結果を提供します:
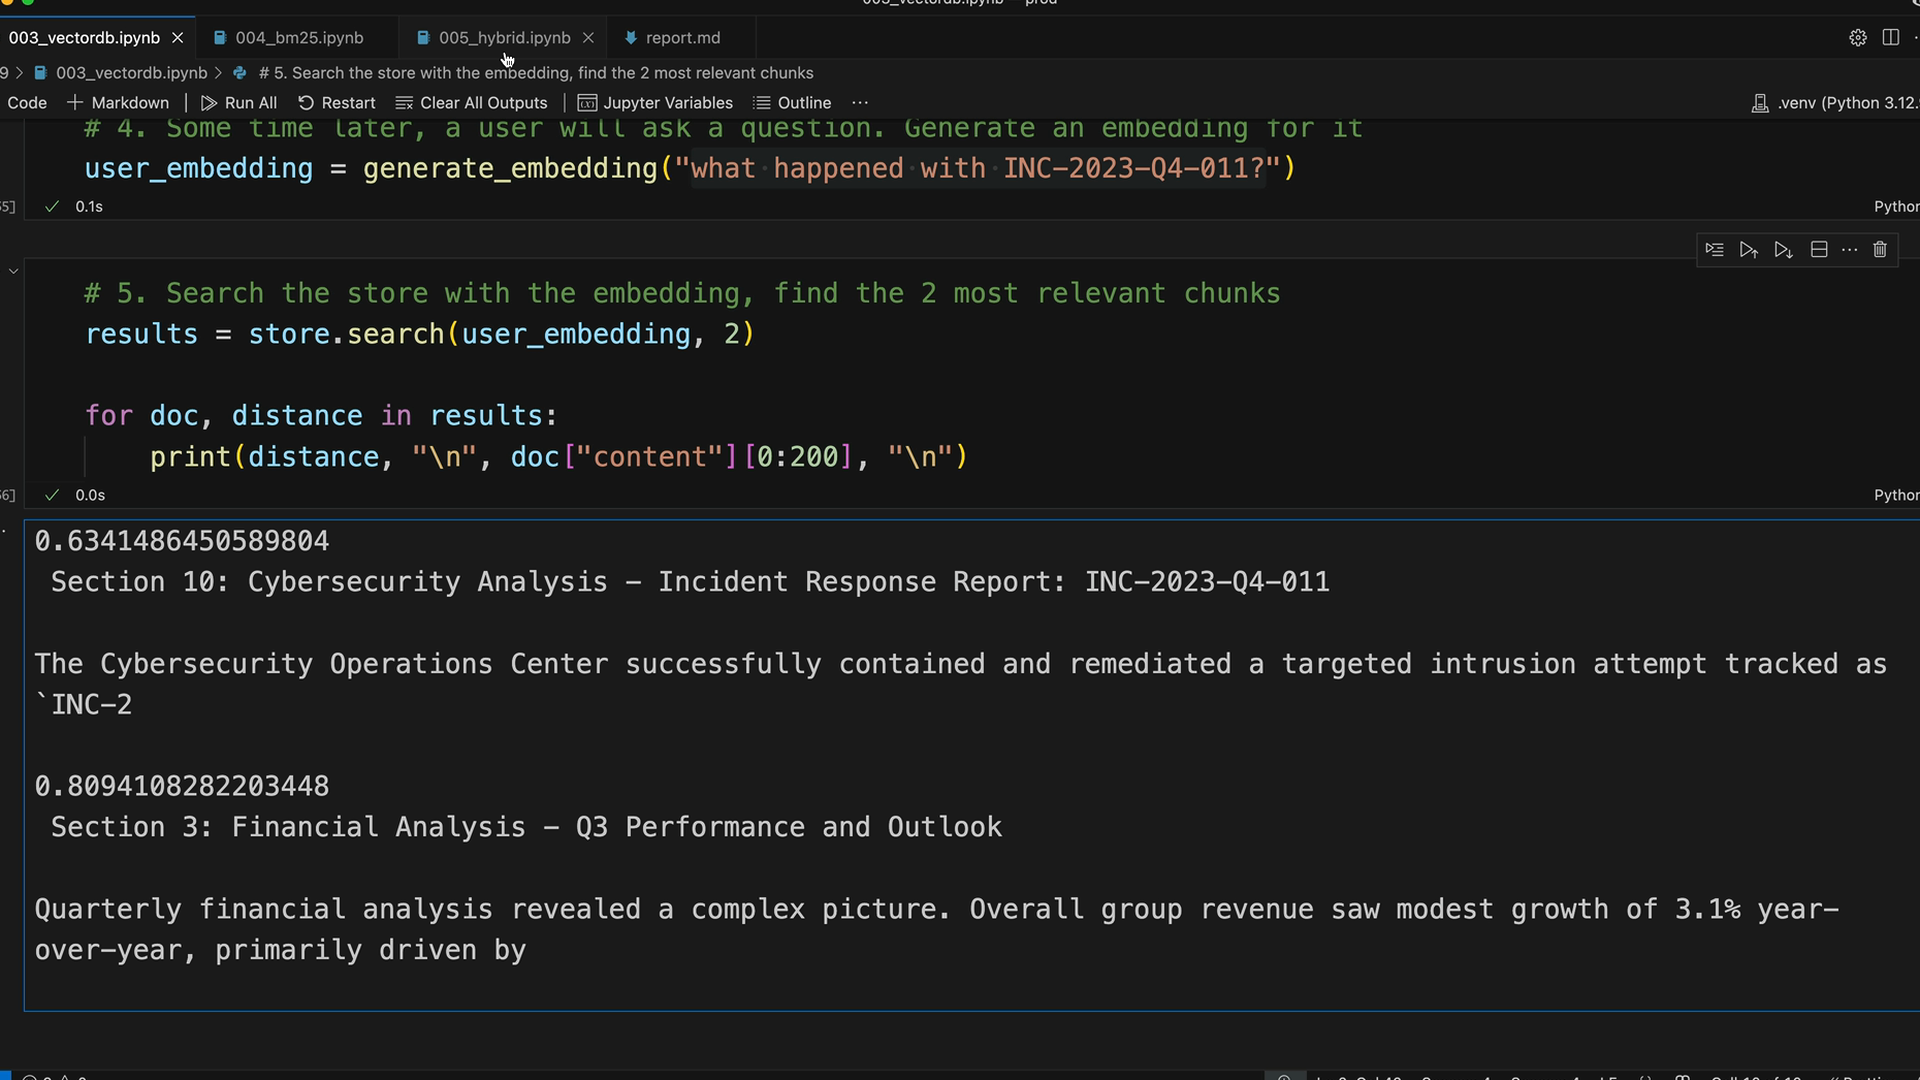
結果は今や正しく以下を優先しています:
- Section 10: Cybersecurity Analysis(実際のインシデントレポート)
- Section 2: Software Engineering(関連する文脈)
- Section 5: Legal Developments(関連性は低いがそれでも関連している)
ハイブリッドアーキテクチャの利点
この設計にはいくつかの利点があります:
- モジュール式の設計: 各検索インデックスは同じAPIで独立して実装される
- 容易な拡張性: 同じ
search()とadd_document()インターフェースを実装することで新しい検索方法を追加できる - より高い精度: セマンティックな理解と正確なキーワードマッチングを組み合わせる
- 柔軟な融合: RRFアルゴリズムは、いくつの検索インデックスを組み合わせても機能する
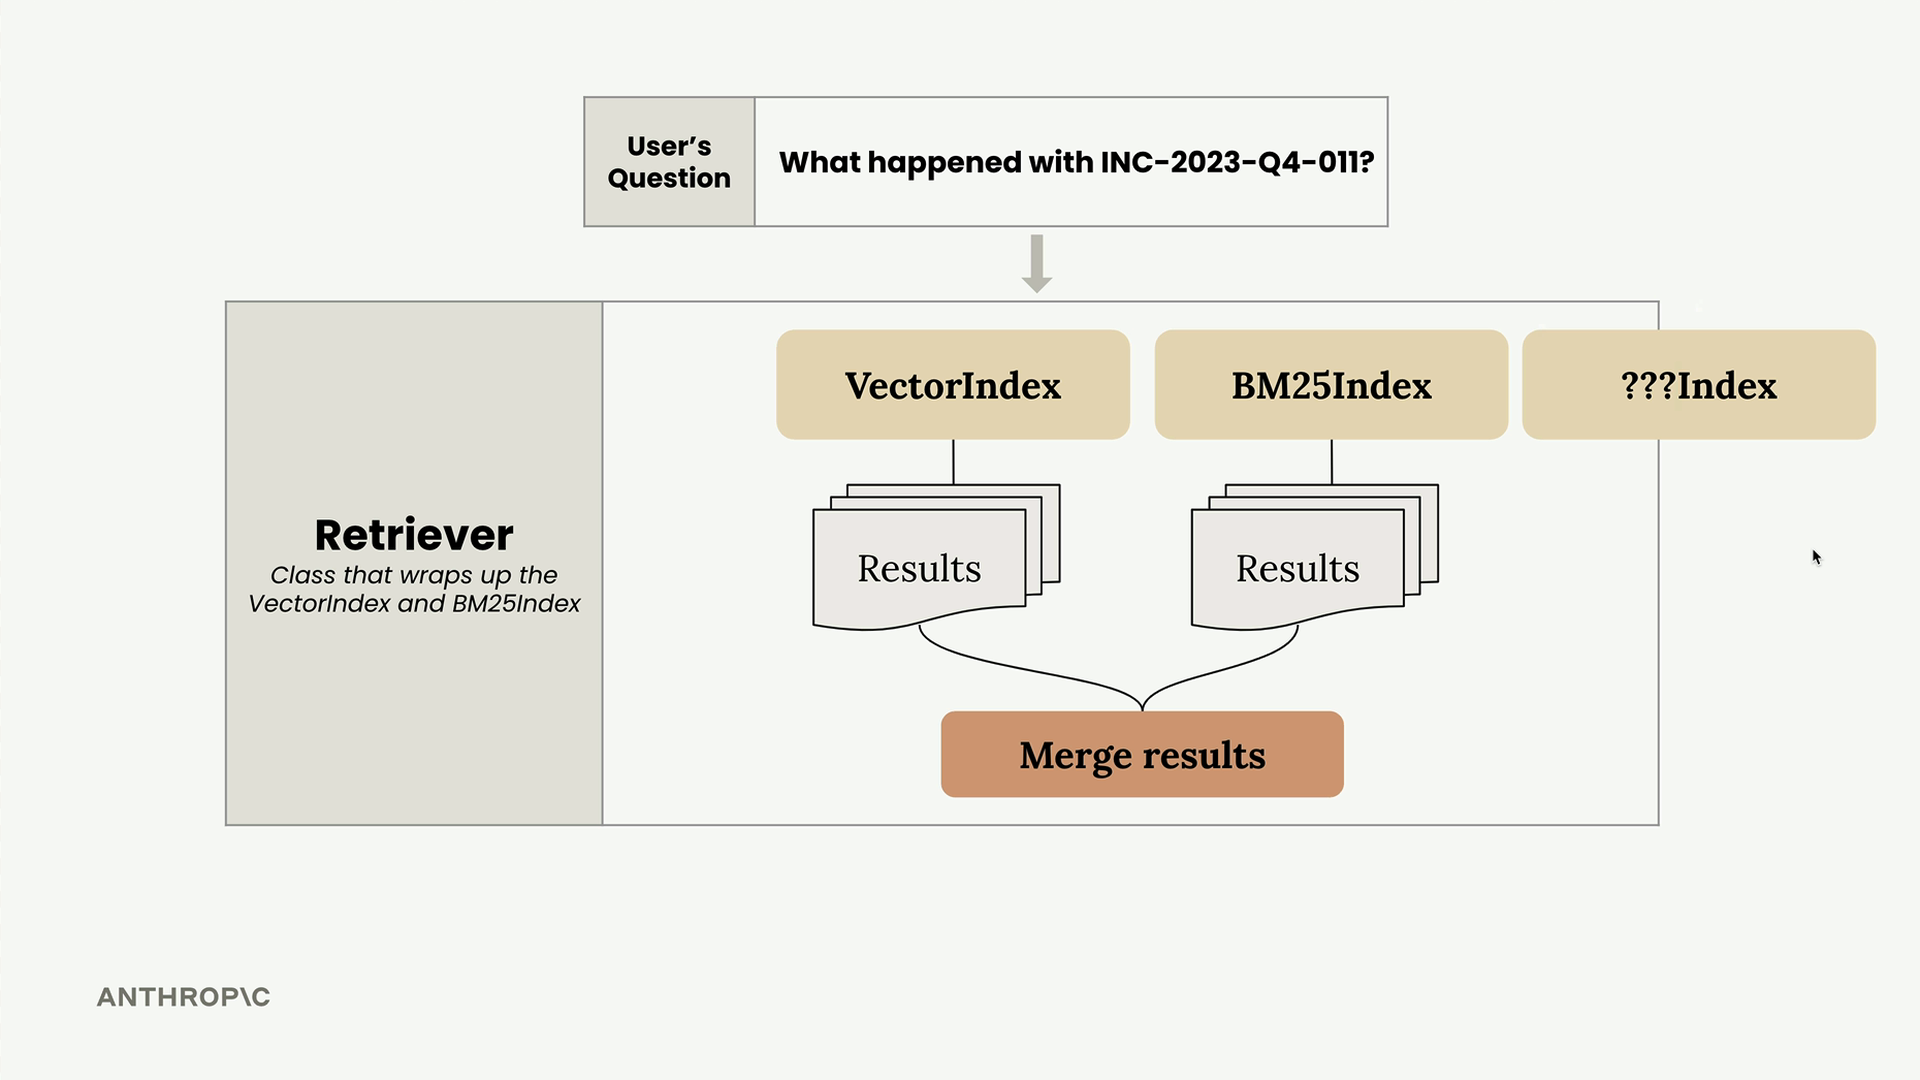
一貫したAPIにより、3つ目の検索インデックス(固有表現認識に特化したものや特定のドキュメントタイプを扱うものなど)を簡単に追加できます。そしてRetrieverは自動的にその結果を最終的なランキングに組み込みます。
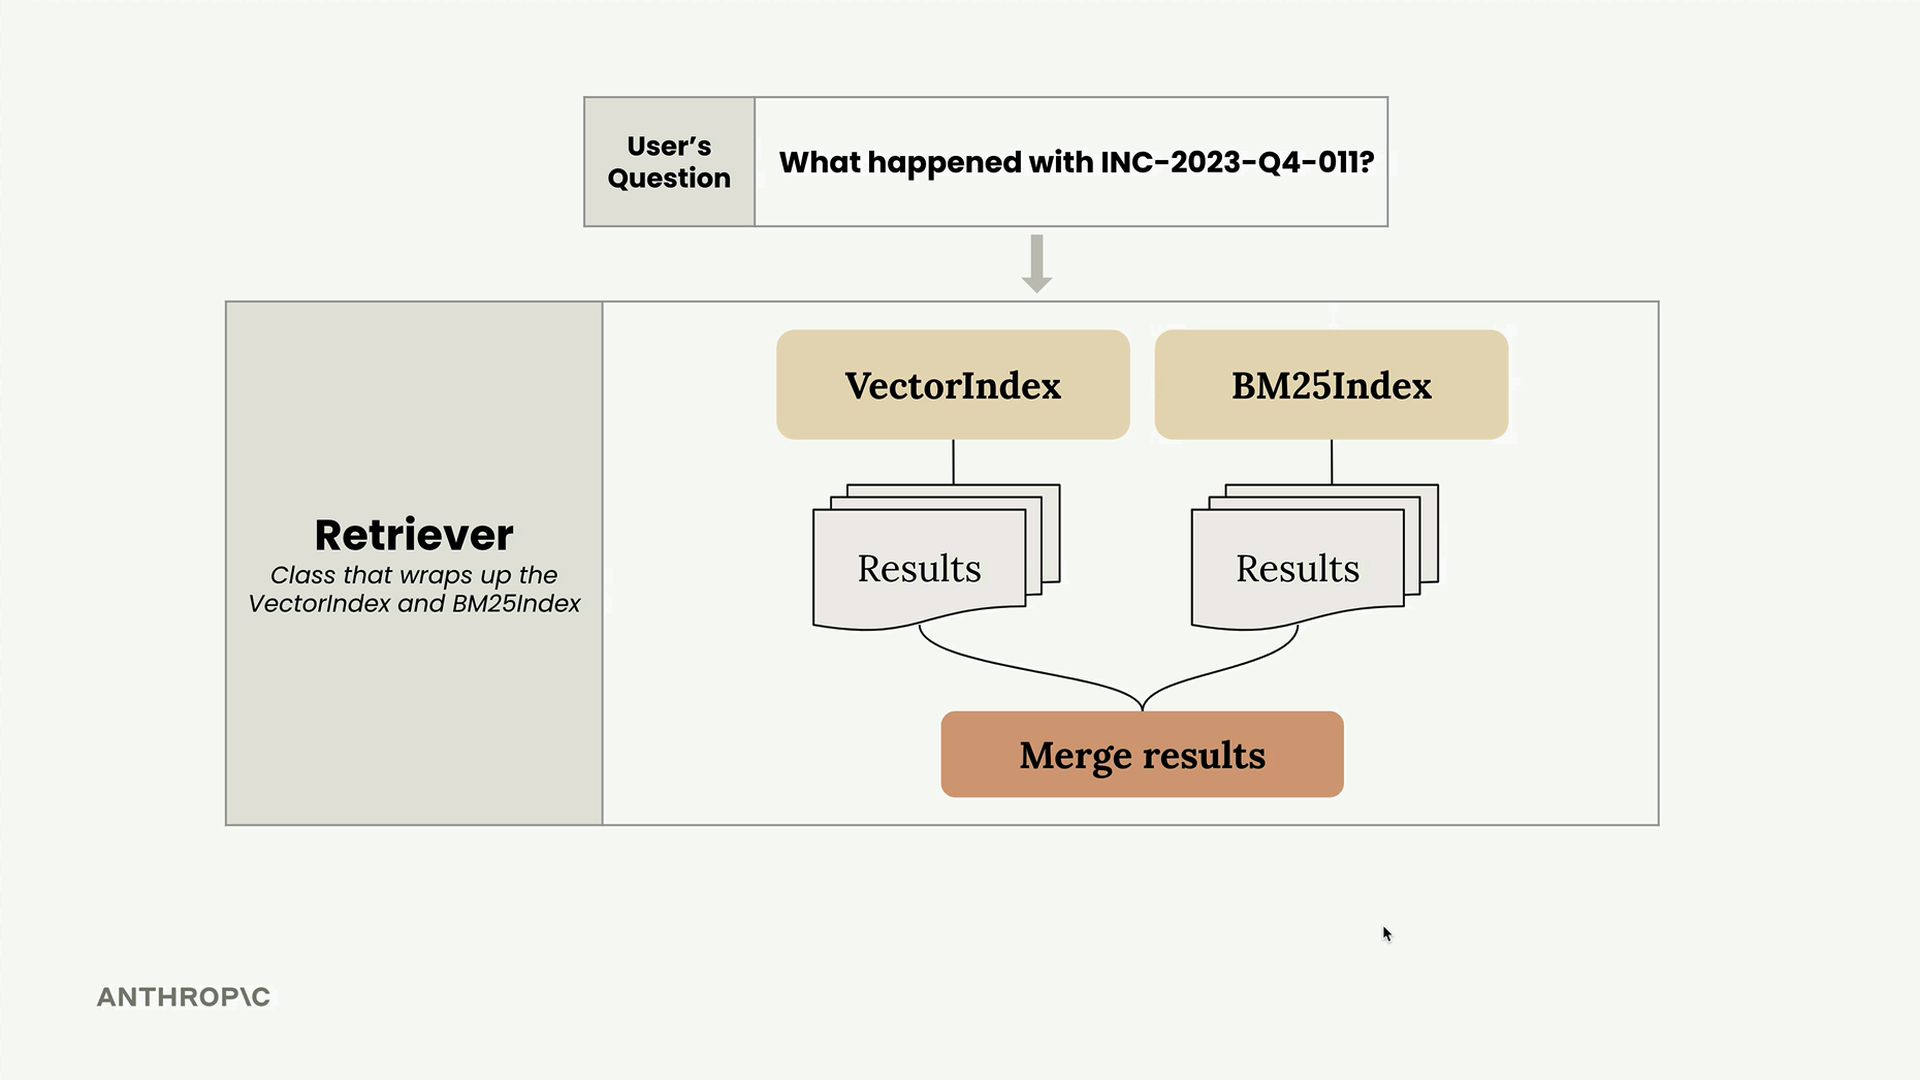
このハイブリッド検索の基盤は、いずれかの方法単独よりも大幅に堅牢な検索を提供し、より広範なクエリタイプにわたってより優れたパフォーマンスを発揮するようRAGパイプラインを整えます。