評価データセットの準備が整ったので、次はコアとなる評価パイプラインを構築する段階です。これには、各テストケースを取得し、プロンプトと組み合わせ、Claudeに渡し、その結果を採点するという作業が含まれます。
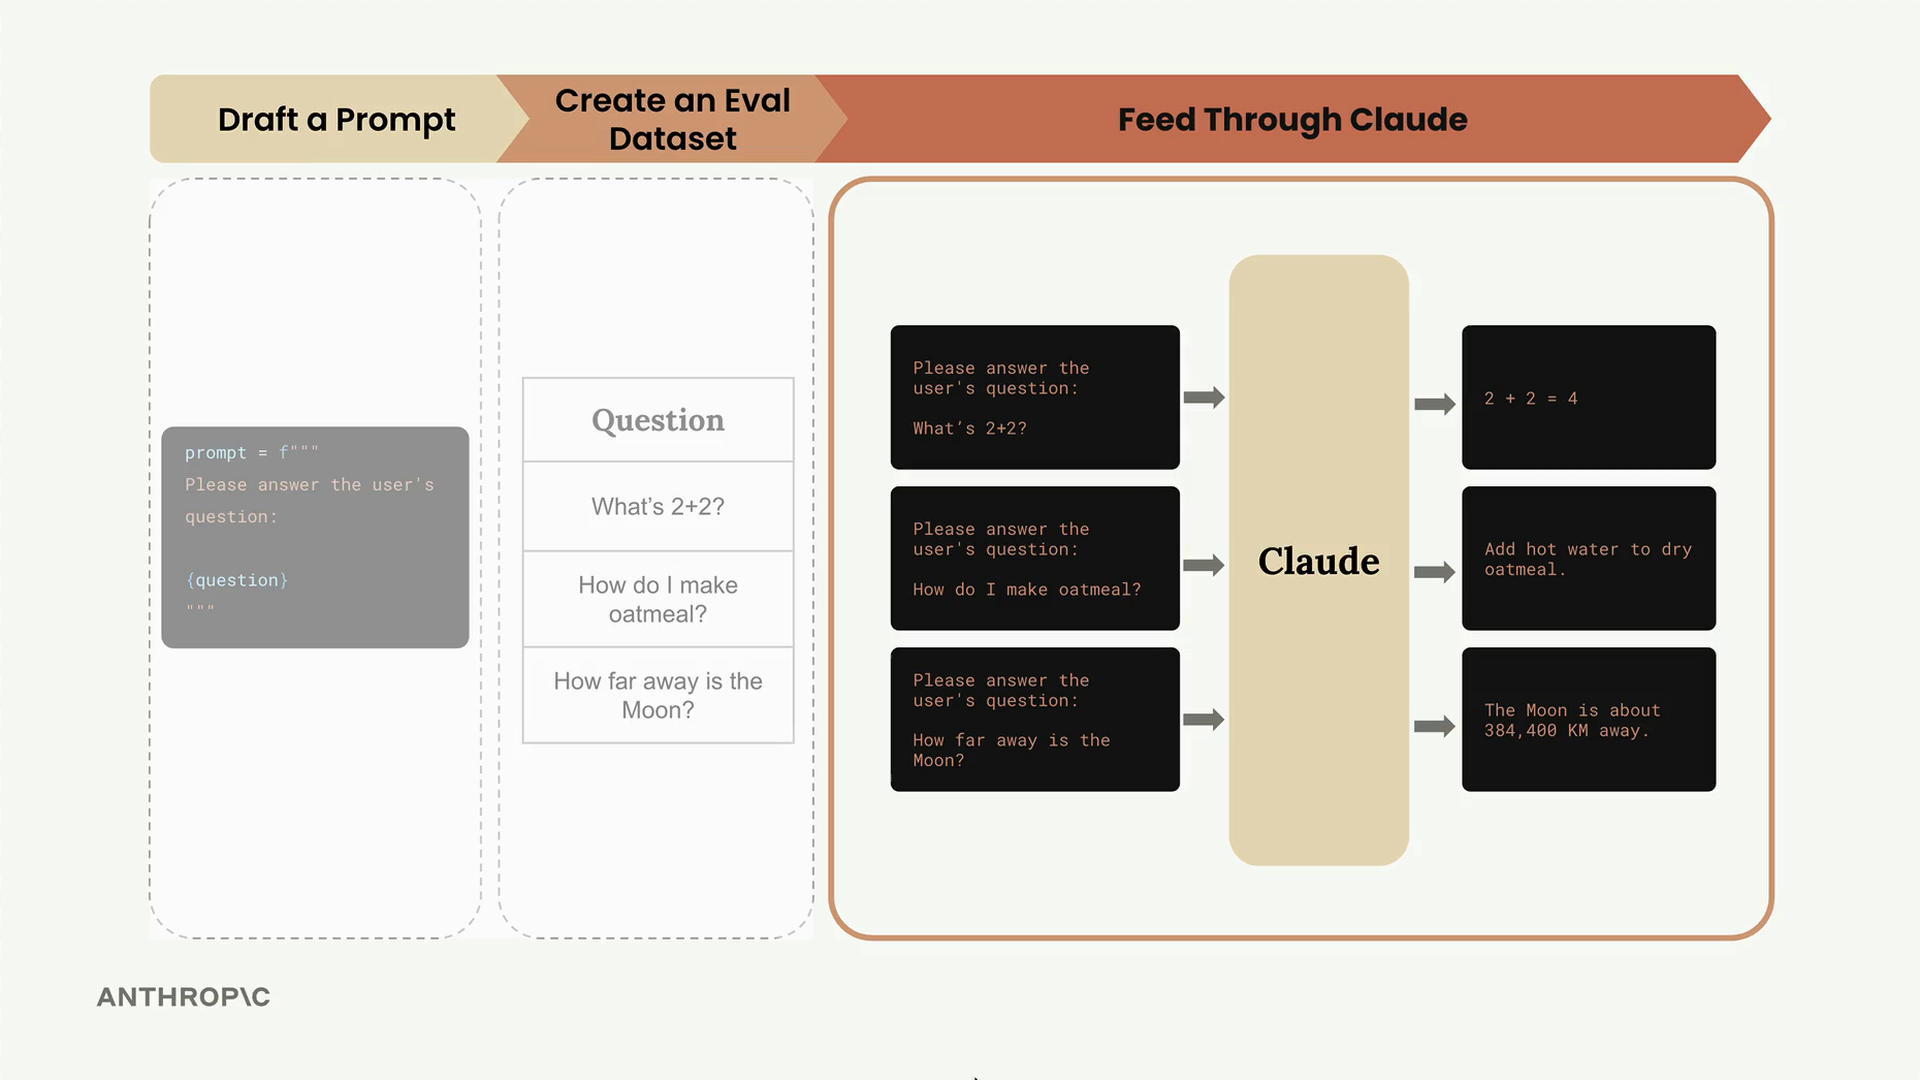
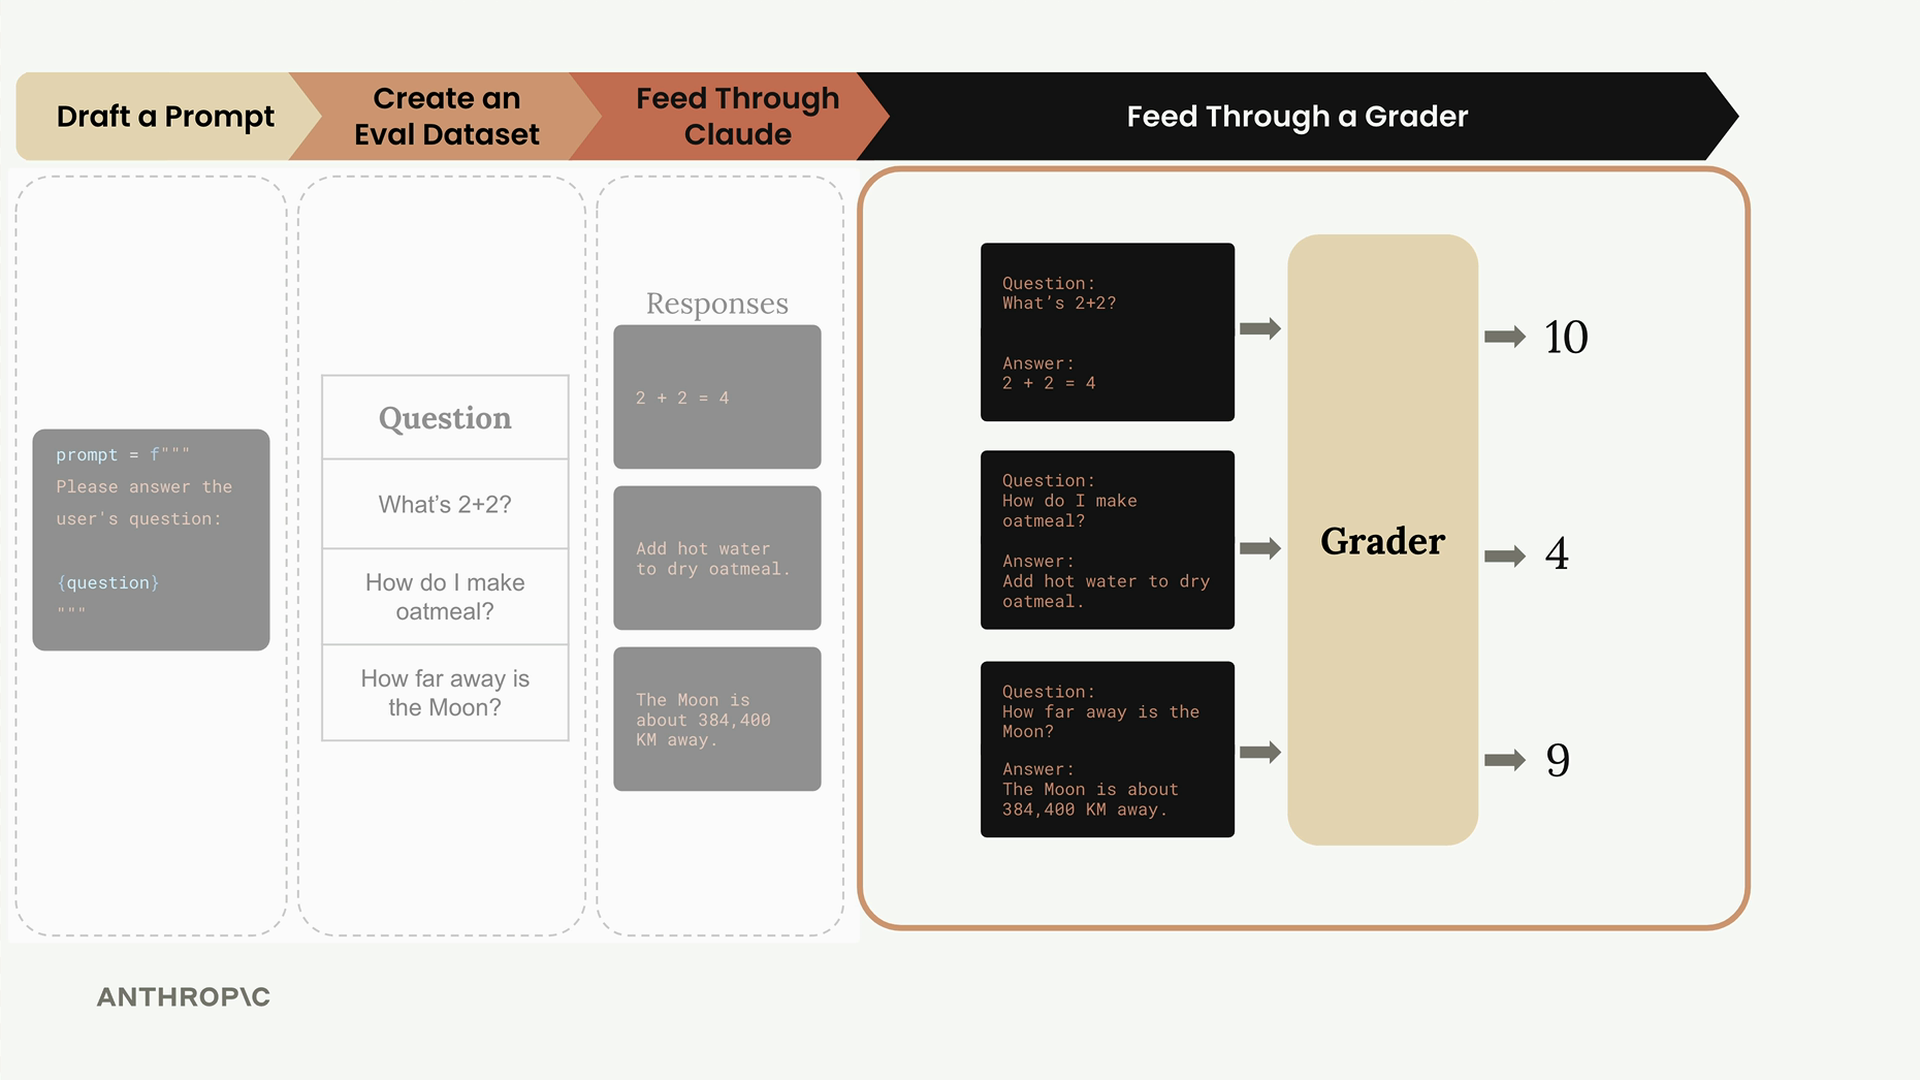
評価プロセスは明確なワークフローに従います。まずテストケースのデータセットを用意し、それぞれをプロンプトテンプレートと組み合わせ、Claudeに送信して処理させ、その出力をグレーダーシステムで評価します。
コア関数の構築
評価パイプラインは、それぞれ特定の役割を持つ3つの主要な関数で構成されています。まずは最もシンプルなもの、つまり個々のプロンプトを処理する関数から始めましょう。
run_prompt 関数
この関数は、テストケースを受け取り、プロンプトテンプレートと結合します。
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
現時点では、プロンプトを極めてシンプルに保っています。フォーマットに関する指示を一切含めていないため、Claudeはおそらく必要以上に冗長な出力を返すでしょう。これについては、プロンプト設計を反復していく中で後ほど改良していきます。
run_test_case 関数
この関数は、1つのテストケースの実行と結果の採点をまとめて統括します。
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - 採点
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
現時点では、ハードコードされたスコア10を使用しています。採点ロジックは今後のセクションでかなりの時間を費やすことになりますが、このプレースホルダーによってパイプライン全体をテストできるようになります。
run_eval 関数
この関数は、評価プロセス全体を統括します。
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
この関数は、データセット内のすべてのテストケースを処理し、すべての結果を1つのリストにまとめます。
評価の実行
評価パイプラインを実行するには、データセットを読み込み、それを各関数に通します。
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
初回の実行には、ある程度時間がかかることを見込んでおいてください。Claude Haikuを使っていても、データセット全体を処理するのに約30秒かかることがあります。最適化の手法については後ほど取り上げます。
結果の確認
評価は、各オブジェクトが1つのテストケースの結果を表す、構造化されたJSON配列を返します。
print(json.dumps(results, indent=2))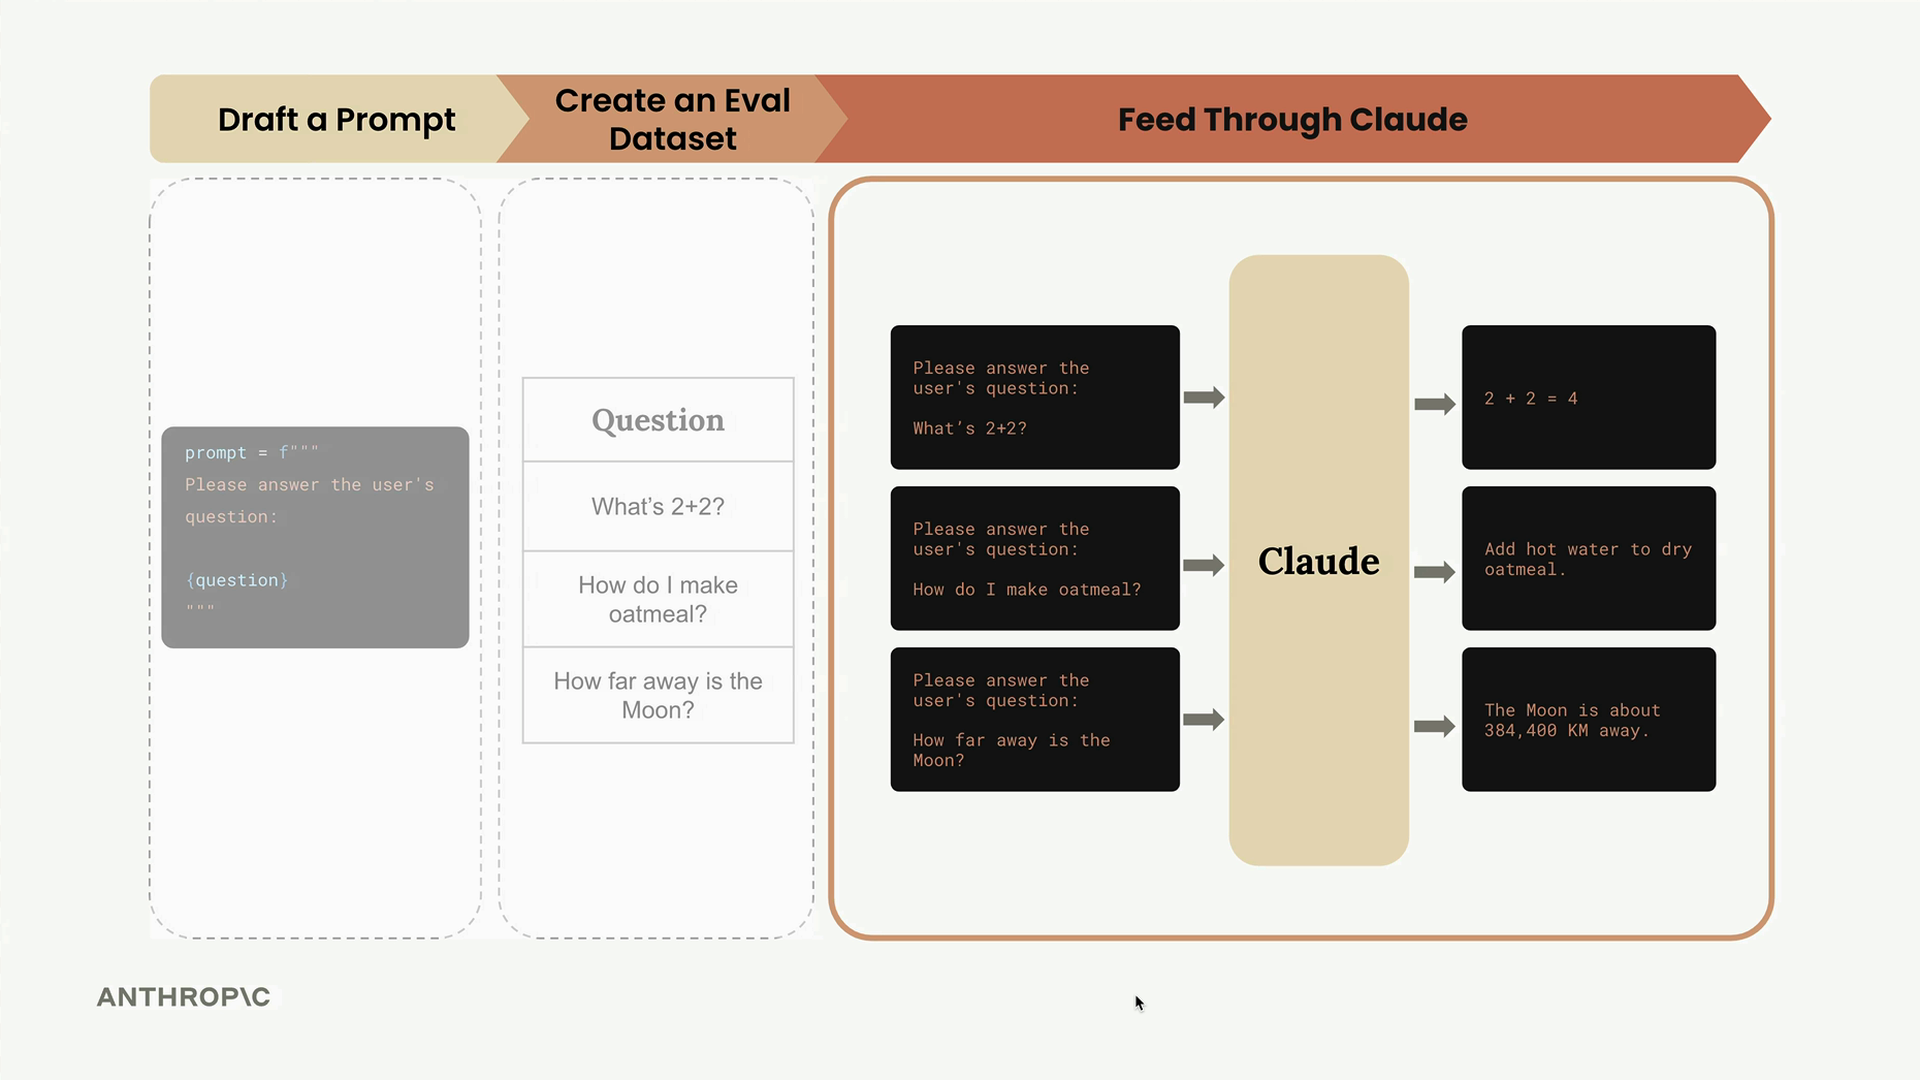
各結果には、3つの重要な情報が含まれています。
- output: Claudeからの完全な応答
- test_case: 処理された元のテストケース
- score: 評価スコア(現在はハードコードされています)
出力からわかるように、まだ具体的なフォーマット指示を与えていないため、Claudeはかなり冗長な応答を生成しています。これはまさに、プロンプトを改良する際に対処すべき問題です。
ここまでの到達点
ここまでで、コアとなる評価パイプラインを無事に構築できました。データセットを取得し、それをClaudeで処理し、構造化された結果を収集できるようになりました。残されている大きな課題は採点システムです。つまり、ハードコードされたスコア10を、実際の評価ロジックに置き換える必要があります。
このパイプラインは、ほとんどのAI評価システムの基盤を表すものです。シンプルに見えるかもしれませんが、これで評価パイプラインが実際に行うことの大部分をすでに構築したことになります。複雑さが生じるのは細部、すなわちより優れたプロンプト、洗練された採点、そしてパフォーマンスの最適化といった部分です。
次は、グレーダーという重要なトピックに取り組みます。これにより、ハードコードされたスコアを、Claudeの性能に関する意味のある評価へと変えていきます。