RAGパイプラインを構築していると、セマンティック検索だけでは常に最良の結果が返されるわけではないことにすぐに気づくでしょう。セマンティック検索が見逃してしまうような、完全一致の用語検索が必要になる場合があります。その解決策は、BM25と呼ばれる技術を使用して、セマンティック検索と字句検索を組み合わせることです。
セマンティック検索単独の問題点
例えば、ドキュメント内で「INC-2023-Q4-011」のような特定のインシデントIDを検索しているとします。この正確な用語は関連するセクションに複数回出現しますが、セマンティック検索は意味的には似ているものの、実際には探している特定の用語を含まない無関係なセクションを返してしまう可能性があります。
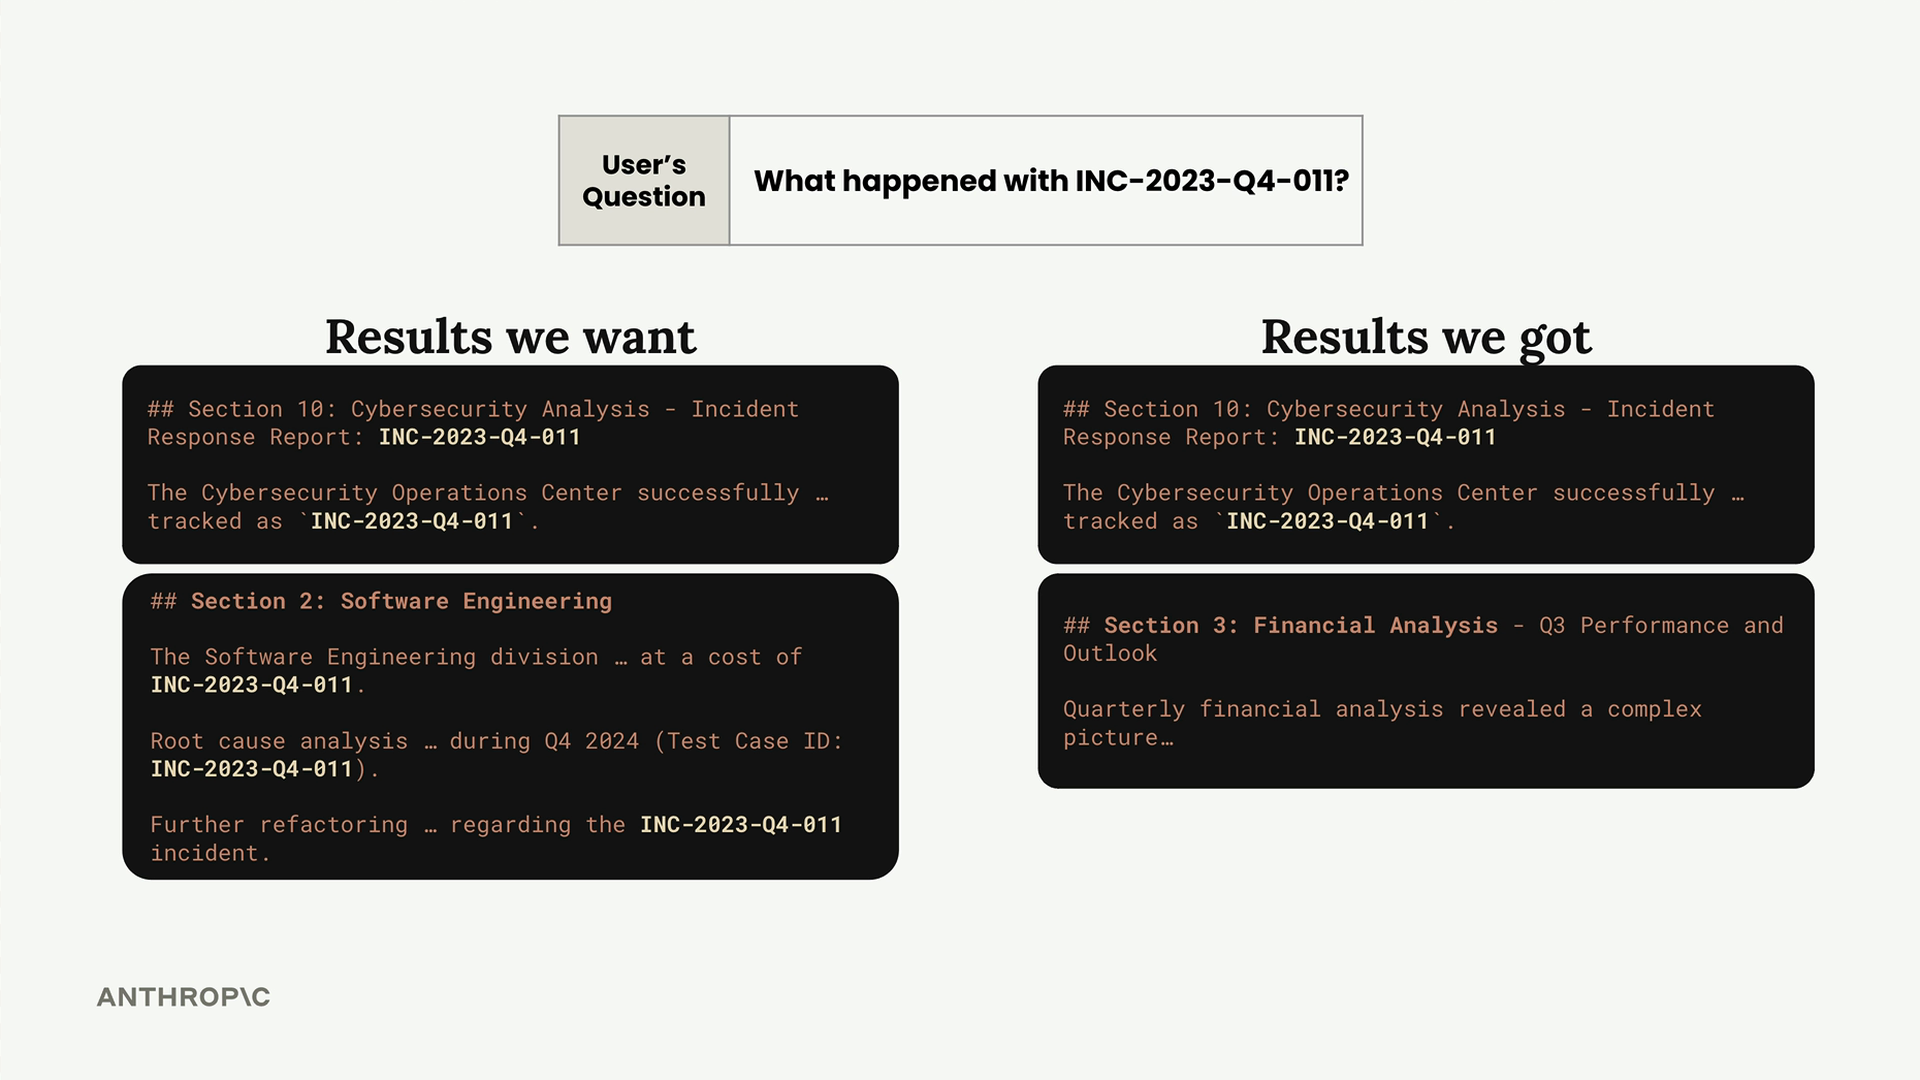
これは、セマンティック検索が完全一致ではなく意味に焦点を当てているために起こります。正確な用語マッチングが必要な場合は、別のアプローチが必要です。
ハイブリッド検索戦略
解決策は、2つの検索を並行して実行し、結果をマージすることです。
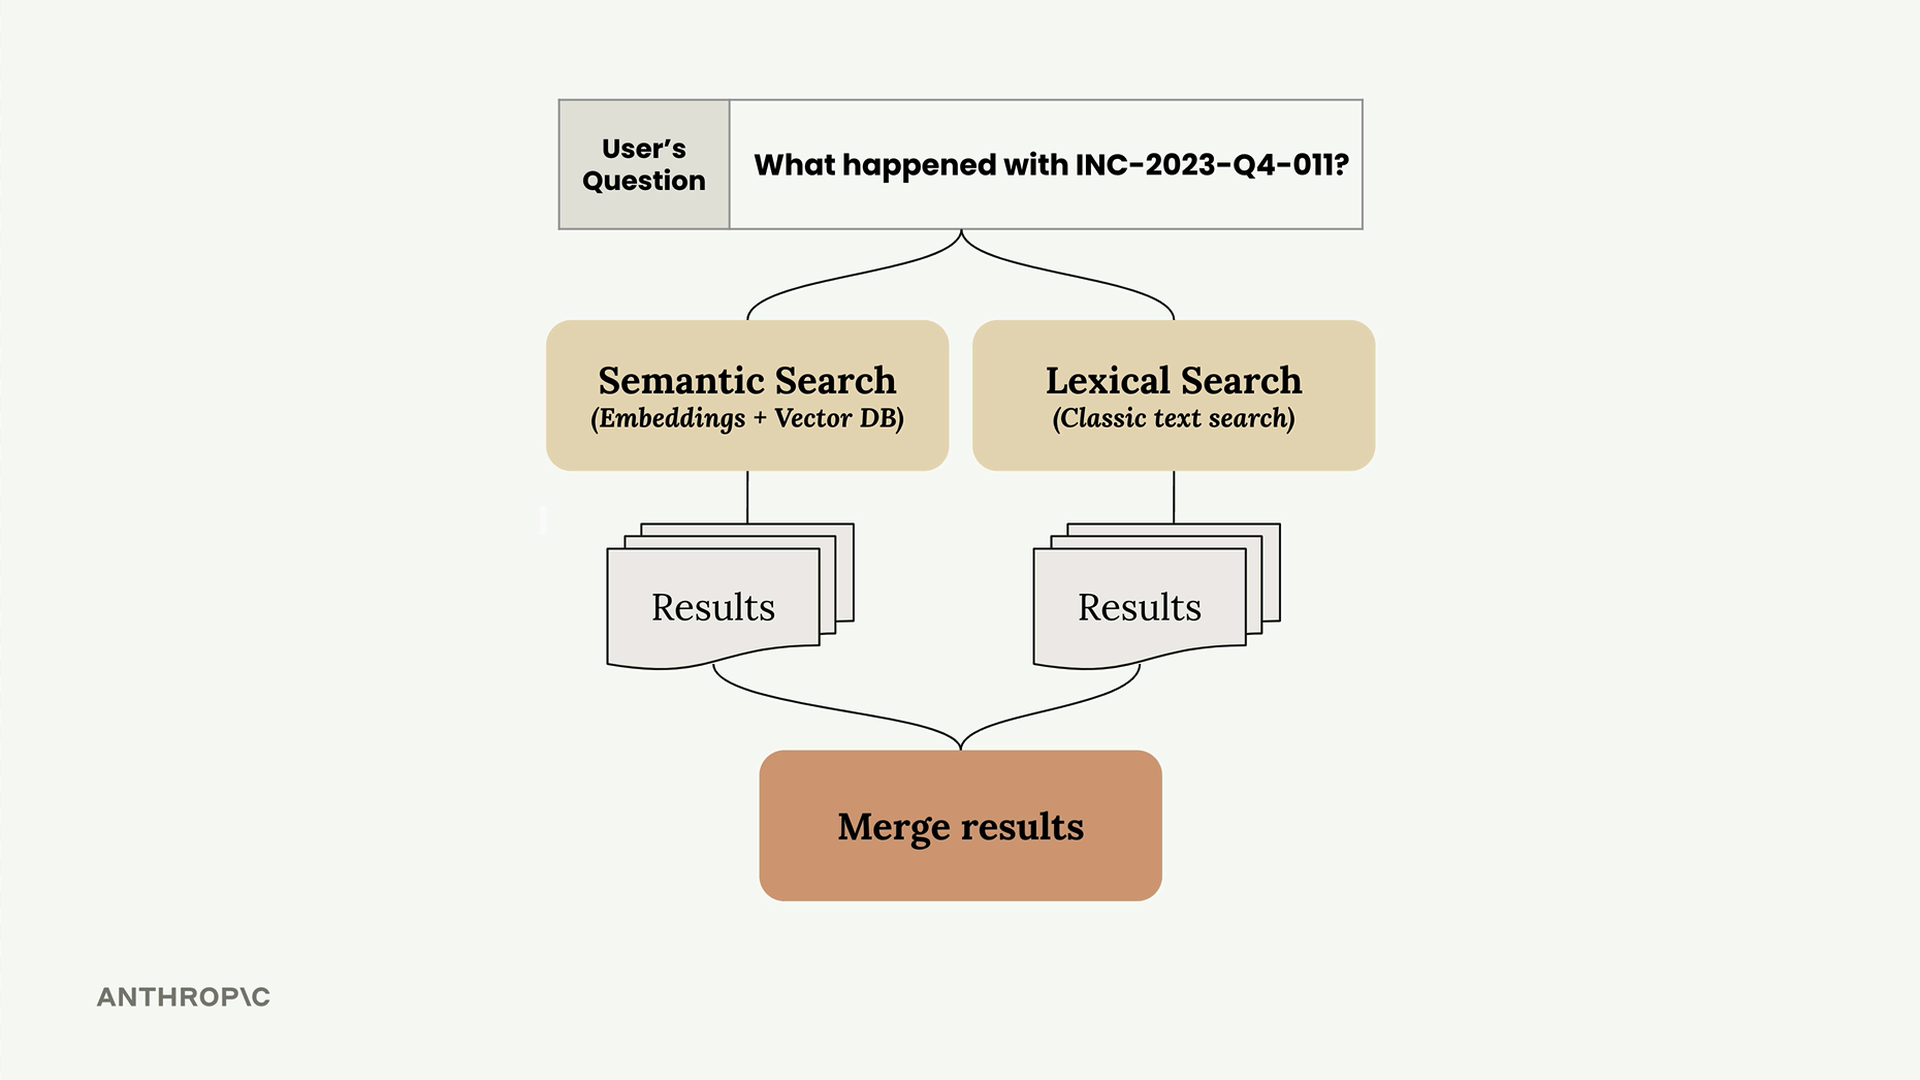
- セマンティック検索 - 埋め込みとベクトルデータベースを使用して意味に基づくマッチングを行う
- 字句検索 - 完全一致の用語マッチングのために従来のテキスト検索を使用する
- 結果のマージ - より良いカバレッジのために両方の結果セットを組み合わせる
BM25の仕組み
BM25(Best Match 25)は、RAGパイプラインにおける字句検索のための人気のあるアルゴリズムです。検索クエリを処理する方法は次のとおりです。
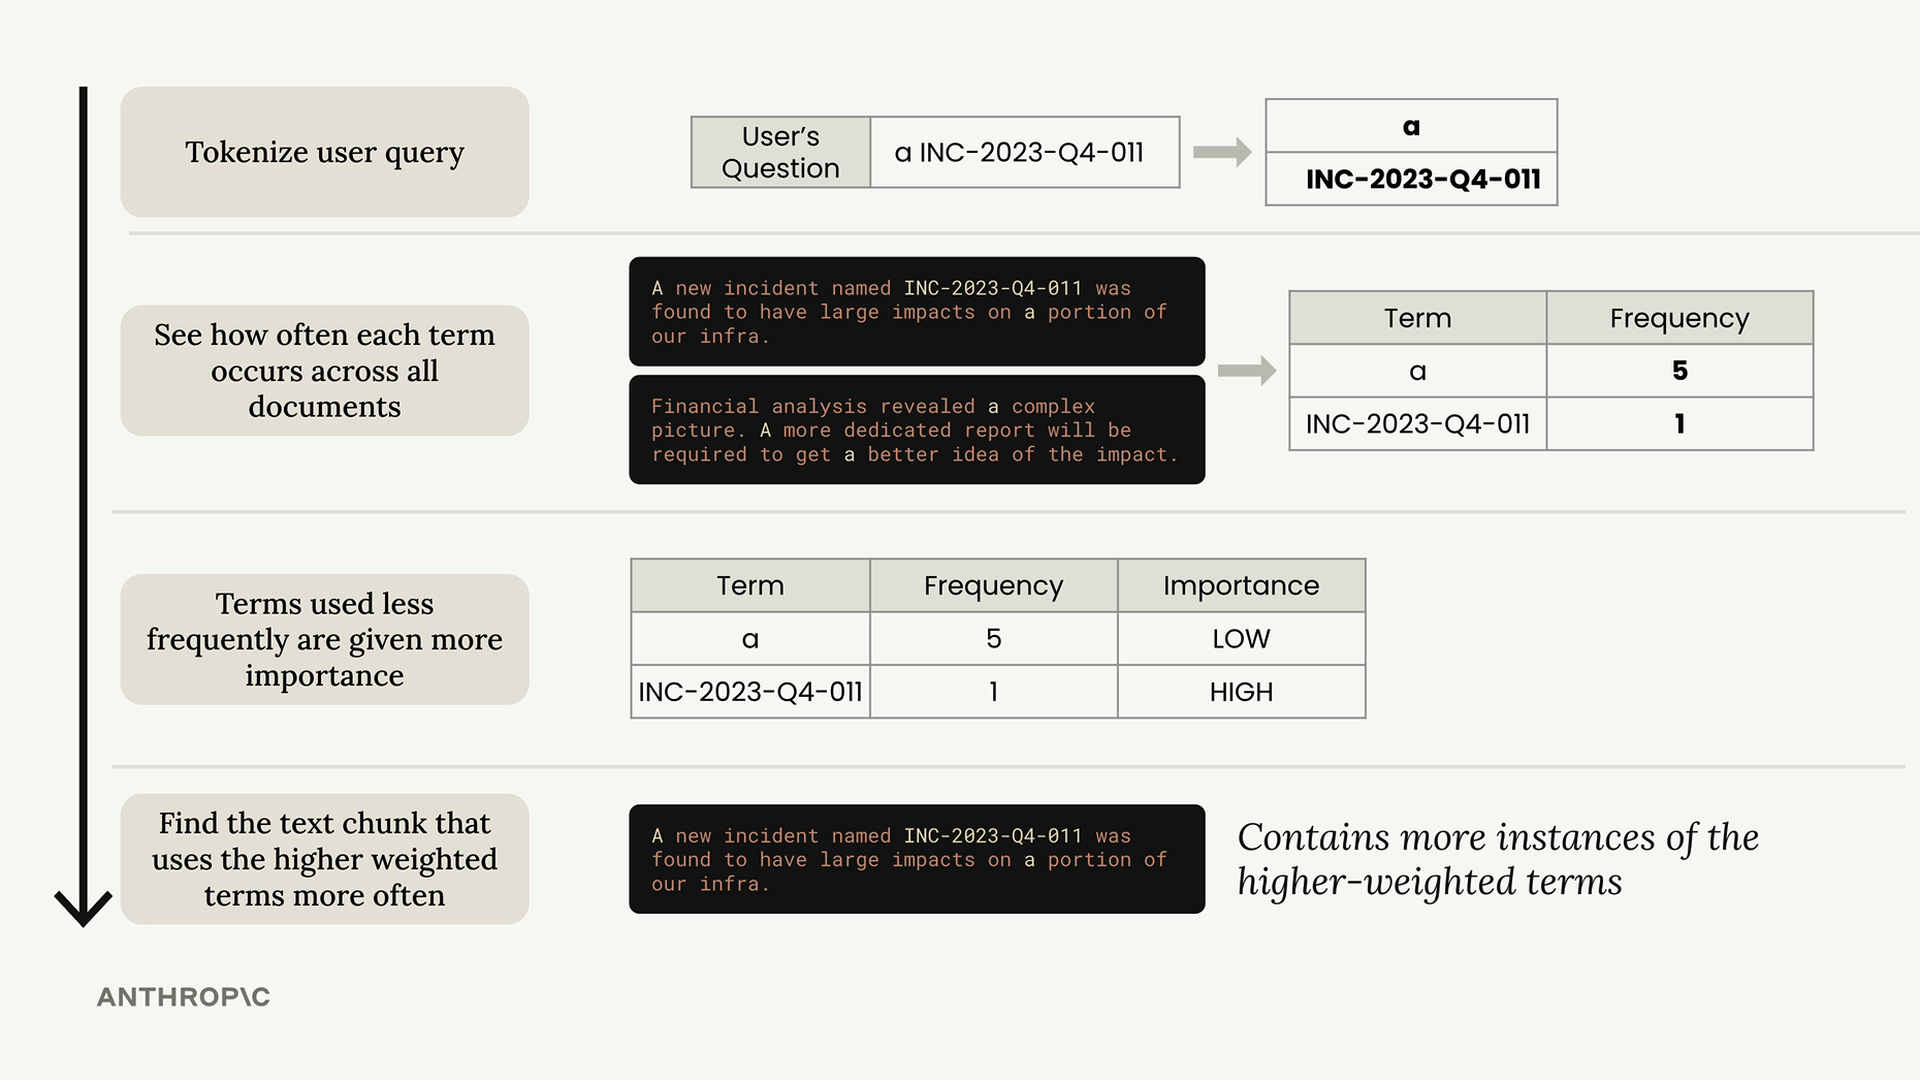
このアルゴリズムは、次の主要なステップに従います。
- クエリのトークン化 - ユーザーの質問を個々の用語に分割する
- 用語頻度のカウント - 各用語がすべてのドキュメントにわたってどのくらいの頻度で出現するかを確認する
- 希少性による用語の重み付け - 使用頻度が低い用語には、より高い重要度スコアが付与される
- 最良のマッチを見つける - より重み付けの高い用語のインスタンスを多く含むチャンクを返す
重要な洞察は、「INC-2023-Q4-011」のような希少な用語は、「a」や「the」のような一般的な単語よりも検索においてはるかに重要であるということです。
BM25検索の実装
BM25検索システムを設定する方法は次のとおりです。
# BM25ストアを作成
store = BM25Index()

# ストアにドキュメントを追加
for chunk in chunks:
    store.add_document({"content": chunk})

# ストアを検索
results = store.search("What happened with INC-2023-Q4-011?", 3)このBM25実装は、セマンティック検索システムと同じAPIを提供します。両方ともadd_document()メソッドとsearch()メソッドを持っているため、一緒に使用しやすくなっています。
より良い検索結果
セマンティック検索単独では失敗した同じクエリをBM25で実行すると、はるかに良い結果が得られます。無関係なセクションを返す代わりに、BM25は実際に特定の検索用語を含むセクションを優先します。
このアルゴリズムは、「INC-2023-Q4-011」が希少で重要な用語であることを正しく識別し、それを含むドキュメントを、クエリ内の一般的な単語のみを含むドキュメントよりもはるかに高くランク付けします。
次のステップ
セマンティック検索と字句検索の両方のシステムが独立して動作するようになったので、次のステップはそれらの結果をマージすることです。このハイブリッドアプローチは、両方の利点を提供します。セマンティック検索の文脈理解と、字句検索による完全一致の精度を組み合わせたものです。
両方の検索システムは似たようなAPIを使用しているため、両方を並行してクエリし、その結果を単一の、より包括的な結果セットに組み合わせることが簡単にできます。