ClaudeにJSON、Pythonコード、箇条書きリストなどの構造化データを生成させたいとき、よくある問題に直面することがあります。Claudeは親切であろうとして、コンテンツの周りに説明文を付け加えようとするのです。これは通常は素晴らしいことですが、時には他の何も付かない生のデータだけが必要な場合があります。
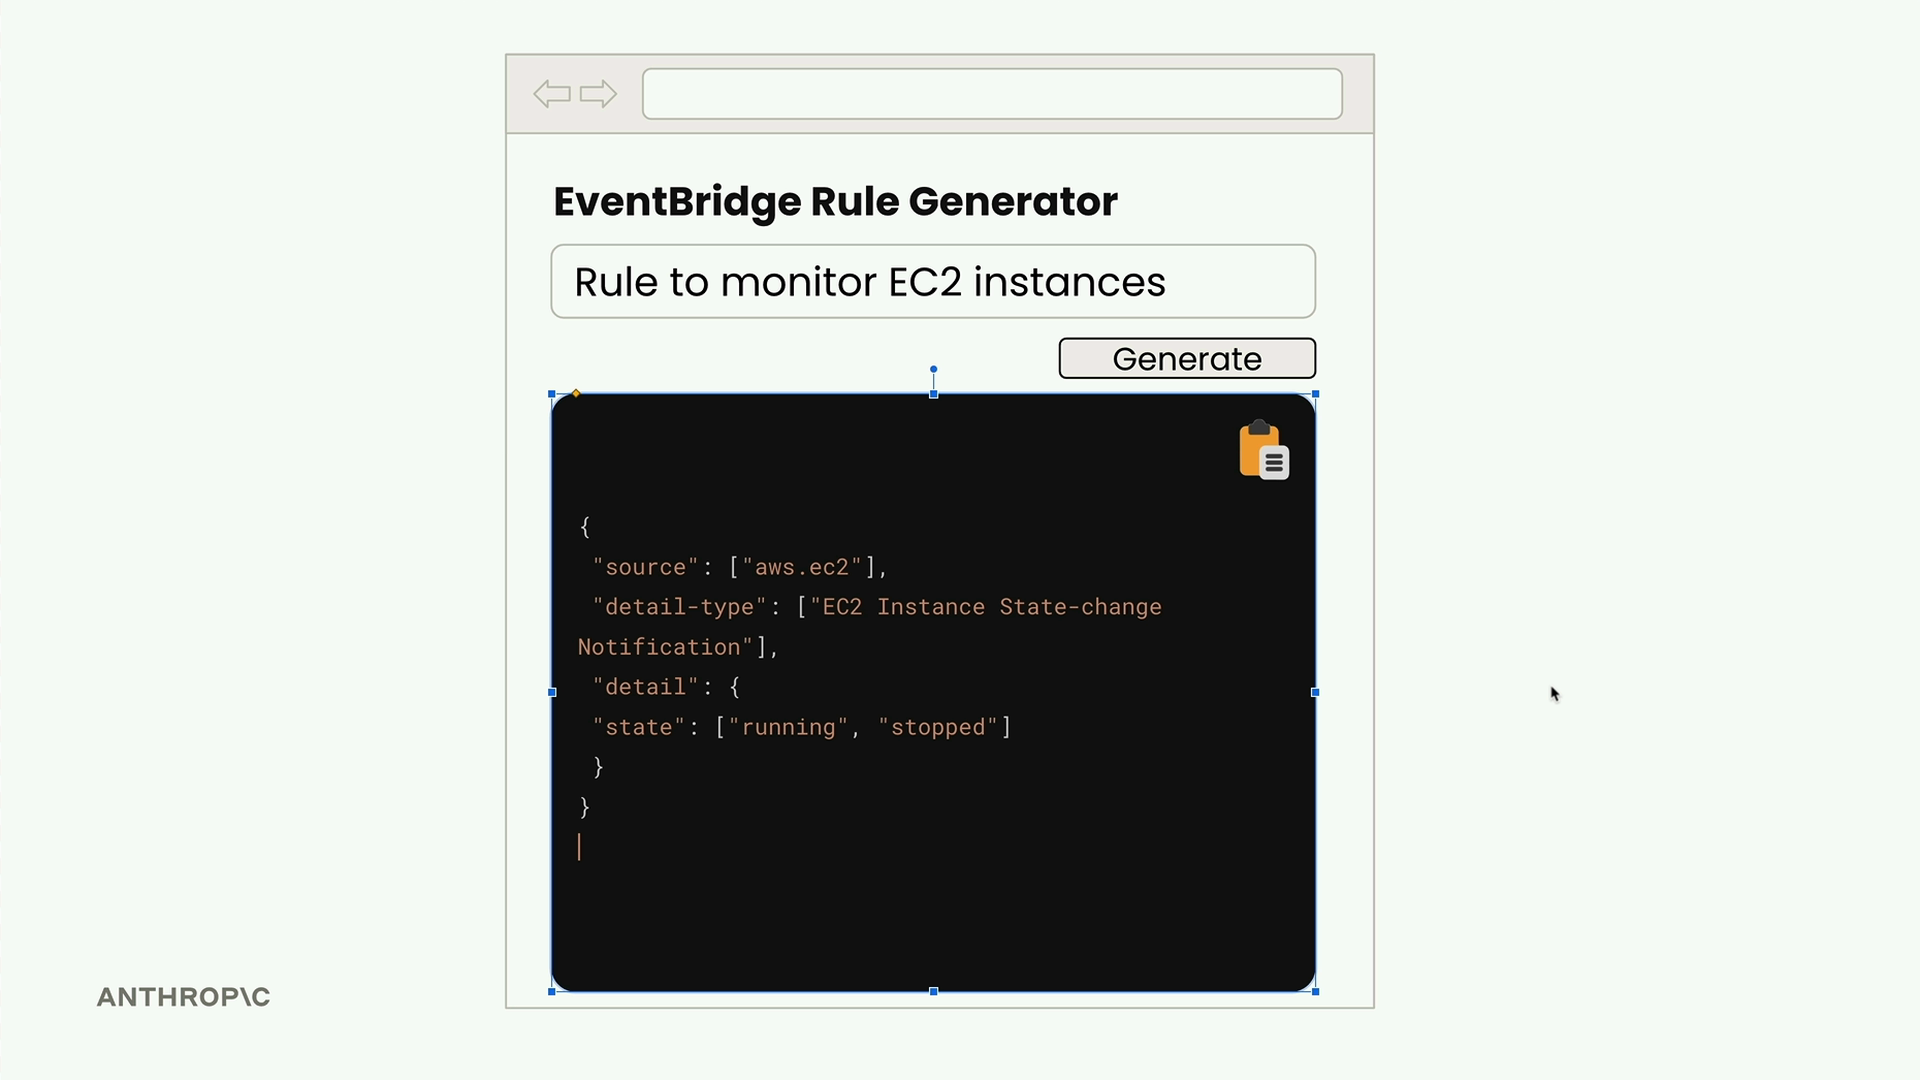
AWS EventBridgeルールを生成するWebアプリを構築する場合を考えてみましょう。ユーザーが説明を入力し、生成ボタンをクリックすると、すぐにコピーして使えるきれいなJSONが表示されることを期待します。もしClaudeが説明用のヘッダーやフッター付きのmarkdownコードブロックでJSONを返してしまうと、ユーザーは単純に「すべてコピー」をクリックすることができず、JSON部分だけを手動で選択しなければなりません。
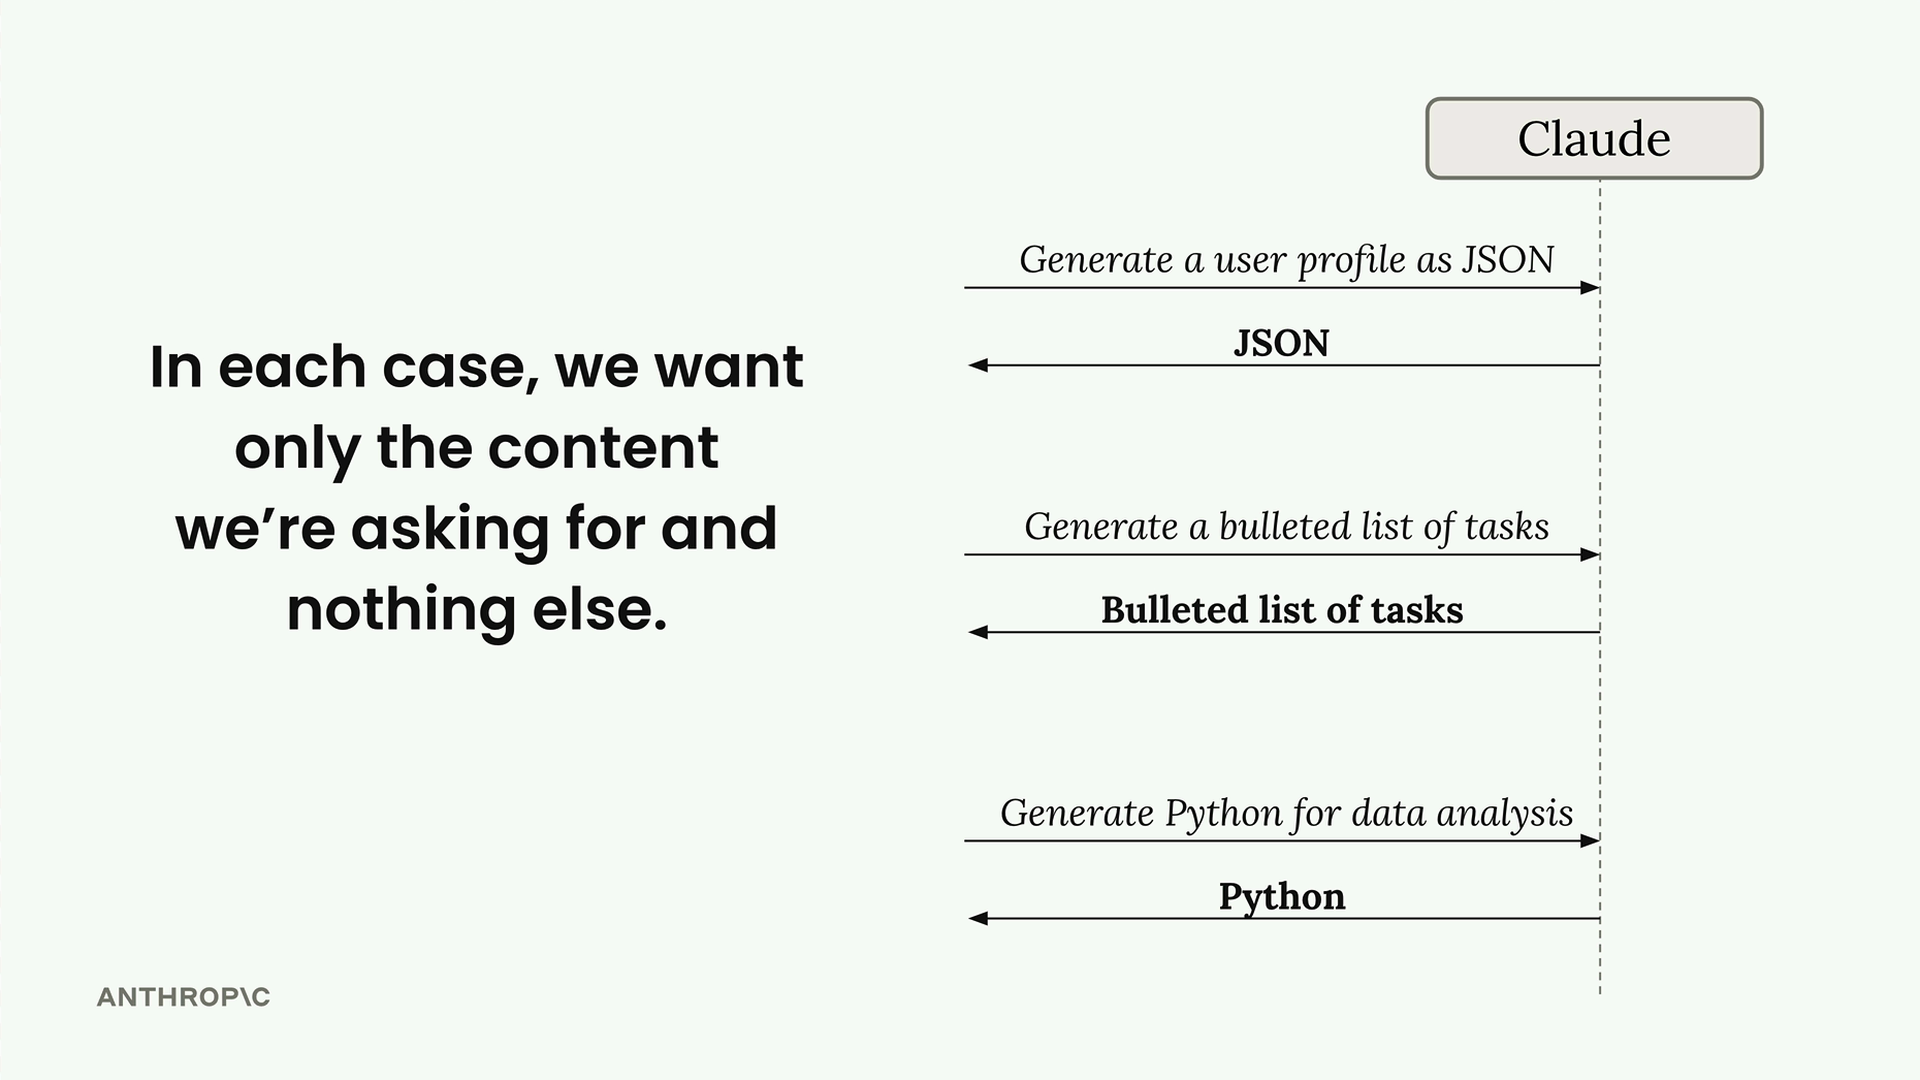
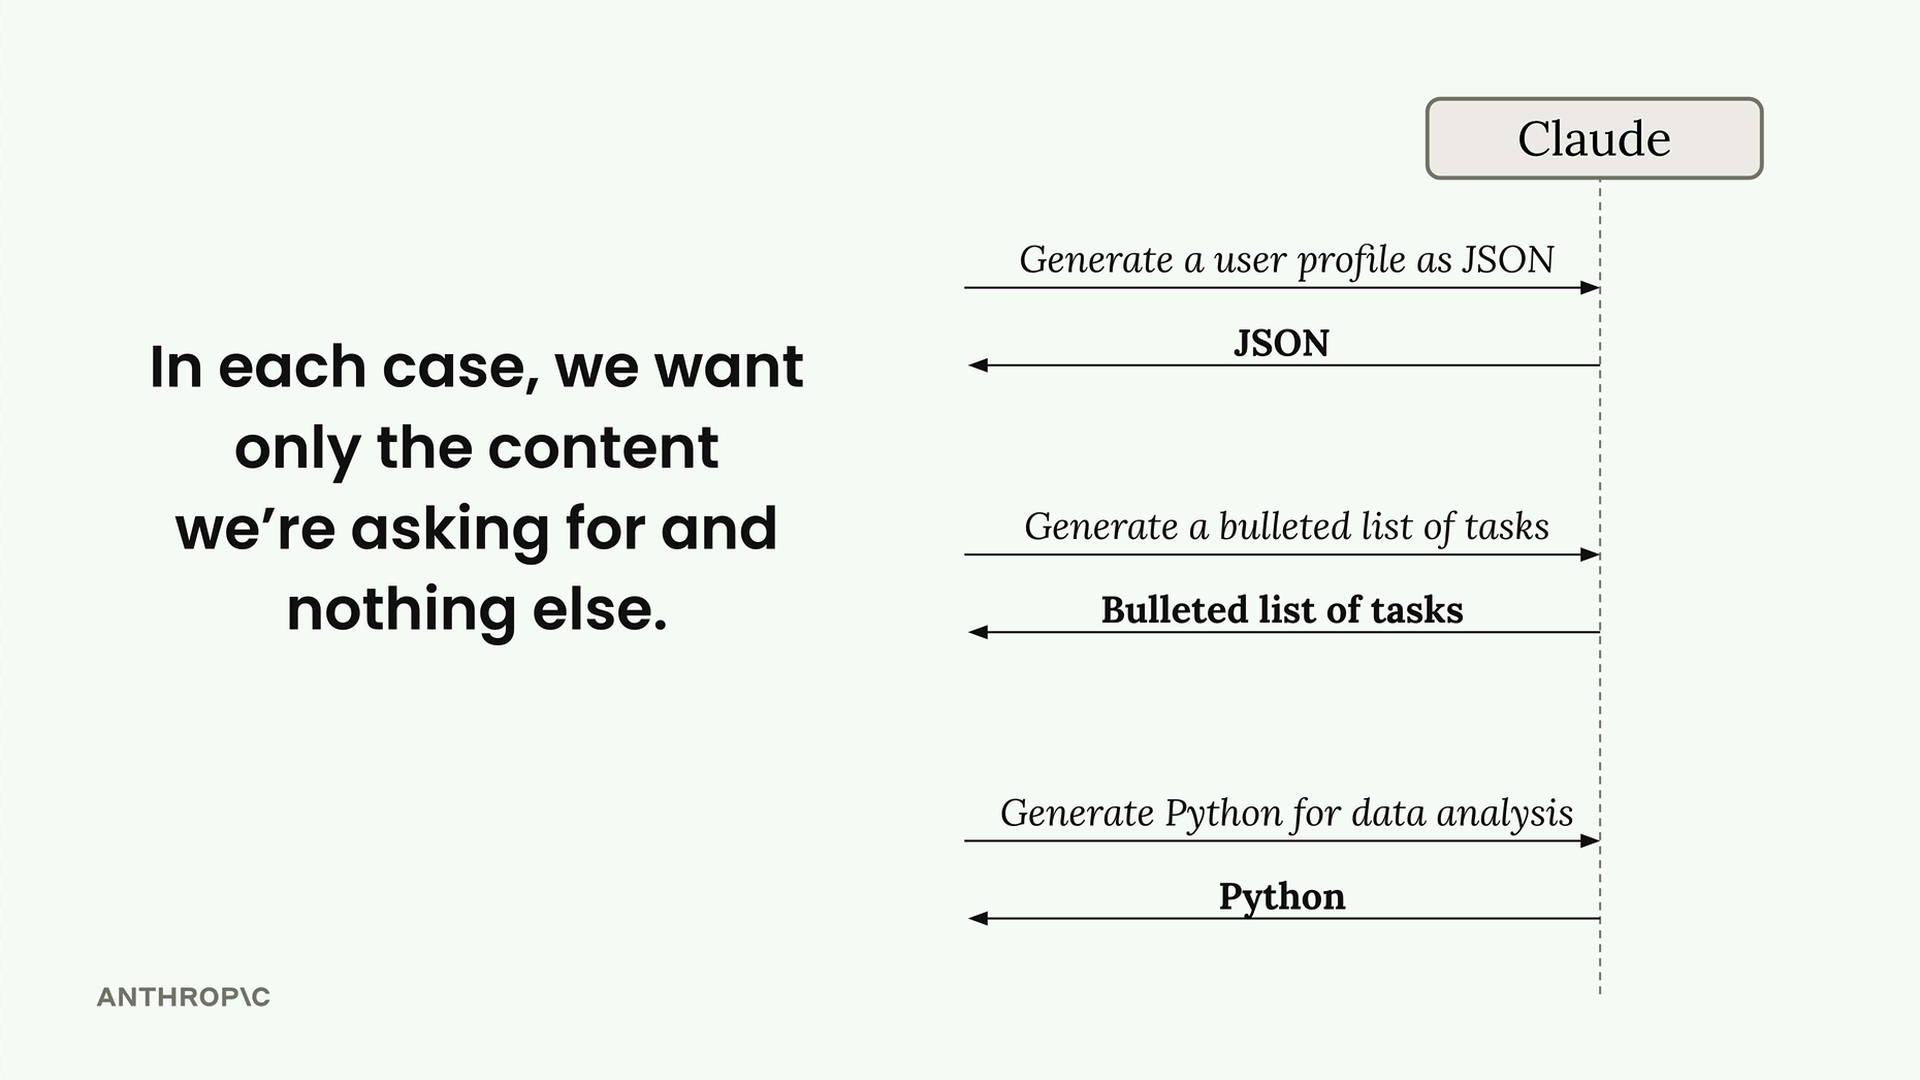
このパターンは、構造化データを生成するときにいつも現れます。Claudeは自然に自分の作業を説明したがりますが、多くの場合、依頼したコンテンツだけが必要で、それ以外は何もいりません。
停止シーケンスとアシスタントメッセージの事前入力を組み合わせる
この解決策は、これまで扱ってきた2つのテクニック、すなわち停止シーケンスとアシスタントメッセージの事前入力を組み合わせたものです。実際にどう機能するか見てみましょう。
messages = []

add_user_message(messages, "Generate a very short event bridge rule as json")
add_assistant_message(messages, "```json")

text = chat(messages, stop_sequences=["```"])
このコードを実行すると、markdown形式や追加のコメントなしに、JSONコンテンツだけが返ってきます。
内部での仕組み
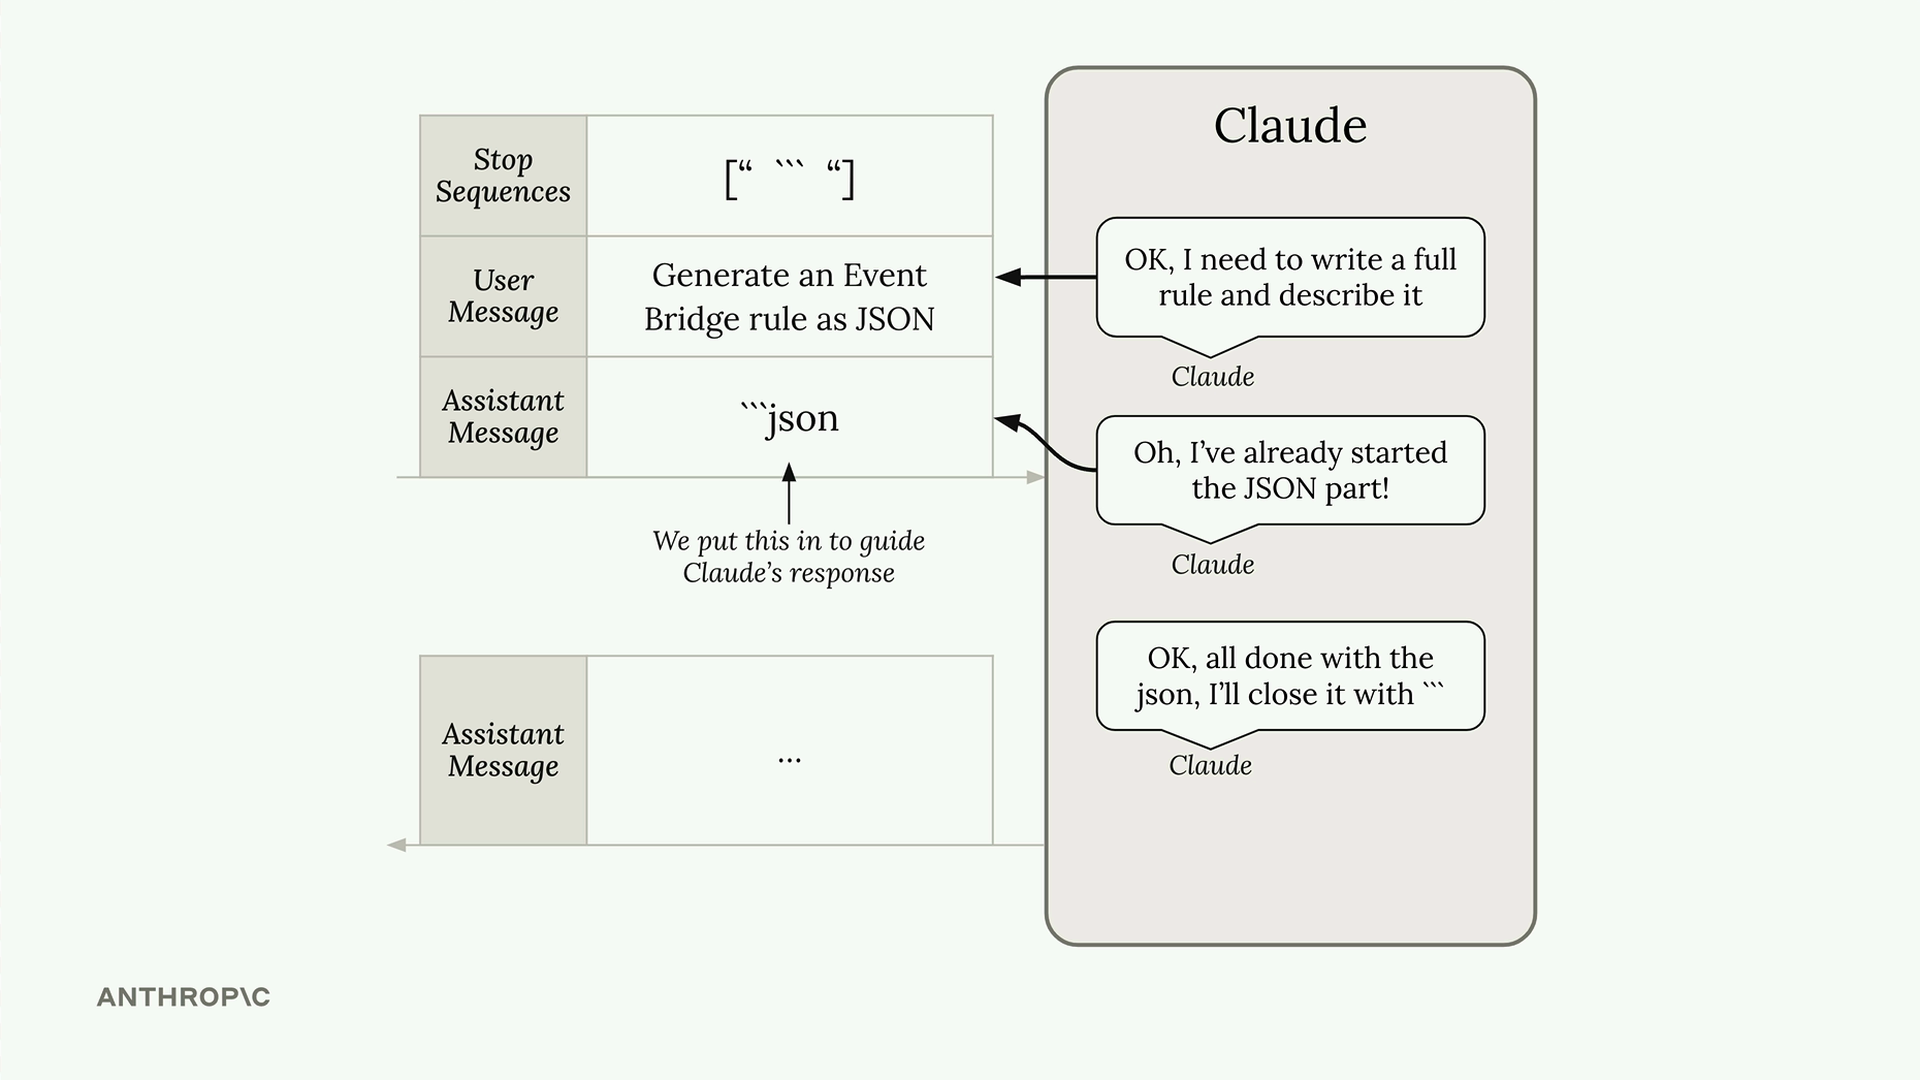
Claudeがリクエストを処理するときに何が起きているかを見てみましょう。
- Claudeはユーザーメッセージを読み、「完全なルールを書いて、おそらくそれについて説明する必要がある」と考えます
- 事前入力されたアシスタントメッセージを見て、すでにJSONのmarkdownブロックを書き始めたものと見なします
- Claudeは「ああ、すでにJSON部分を書き始めているので、実際のJSONコンテンツだけを書けばいい」と考えます
- JSONコンテンツを生成します
- Claudeがmarkdownブロックを
```で閉じようとすると、停止シーケンスに当たり、生成が即座に停止します
その結果、事前入力された開始部分と停止シーケンスの間にあるすべて、つまりまさに求めていたコンテンツが得られます。
出力のクリーンアップ
返されたテキストには余分な改行が含まれている場合がありますが、これは簡単にクリーンアップできます。
import json

# JSONとしてパースし、検証・整形する
parsed_json = json.loads(text.strip())
このテクニックは、JSONに限らず、どのような構造化データ形式にも使えます。Pythonコード、箇条書きリスト、その他特定のコンテンツ形式を生成する場合でも、アシスタントメッセージの事前入力でレスポンスを開始し、停止シーケンスで望み通りの場所で終了させることができます。
このアプローチにより、Claudeの出力形式を正確に制御できるようになり、下流の処理を妨げる可能性のある余分な書式やコメントのない、クリーンで利用しやすいデータをアプリケーションが確実に取得できるようになります。