コンテキスト検索は、根本的な問題を解決することでRAGパイプラインの精度を向上させる手法です。その問題とは、ドキュメントをチャンクに分割すると、各チャンクが広範なドキュメントのコンテキストとのつながりを失ってしまうというものです。
標準的なチャンク分割の問題点
ソースドキュメントを取得してベクトルデータベース用にチャンクに分割すると、個々の断片はそれがどこから来たのか、ドキュメントの他の部分とどう関係しているのかが分からなくなります。これは重要なコンテキスト情報がチャンクに欠けているため、検索精度を損なう可能性があります。
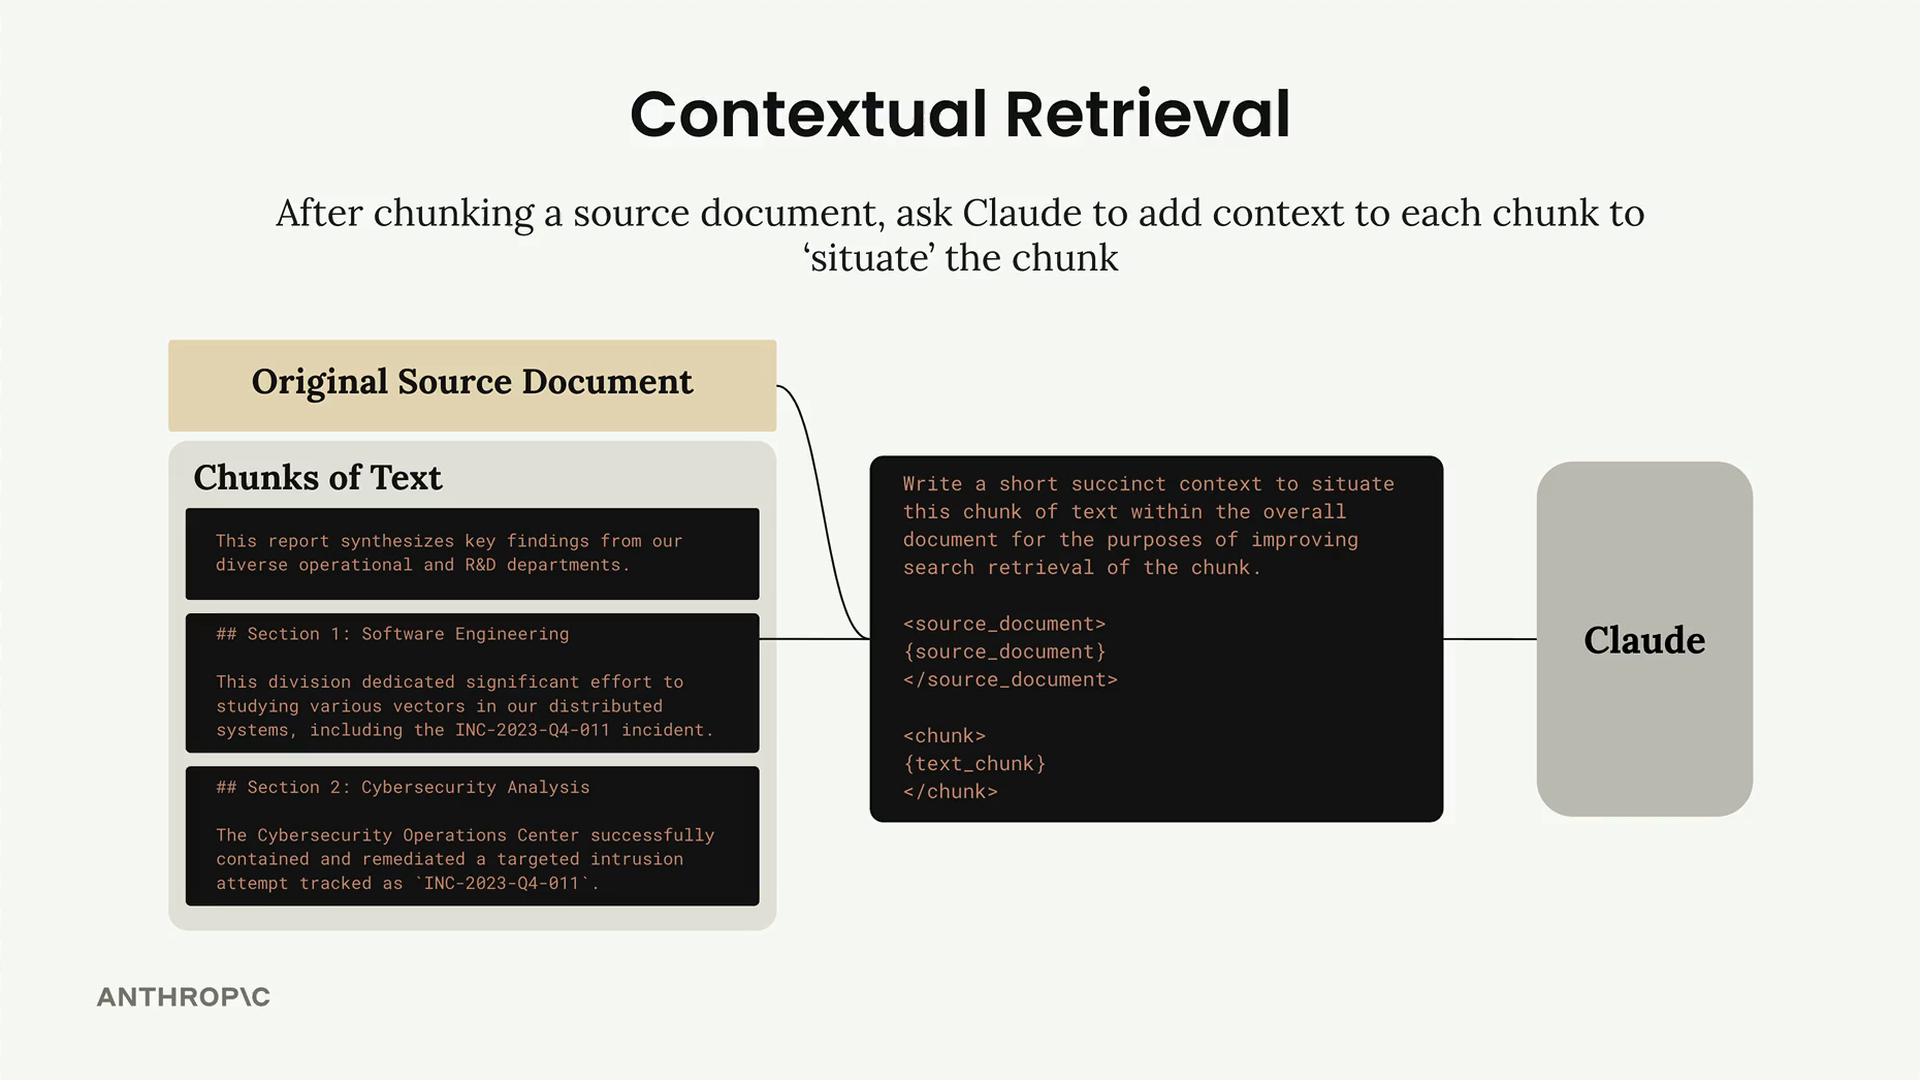
コンテキスト検索の仕組み
コンテキスト検索は、チャンクをリトリーバーデータベースに挿入する前に前処理ステップを追加します。その手順は次のとおりです。
- 各チャンクと元のソースドキュメントを取得する
- 両方をコンテキストを追加するよう依頼する特定のプロンプトとともにClaudeに送信する
- Claudeは、より大きなドキュメント内にそのチャンクを「位置付ける」短いスニペットを生成する
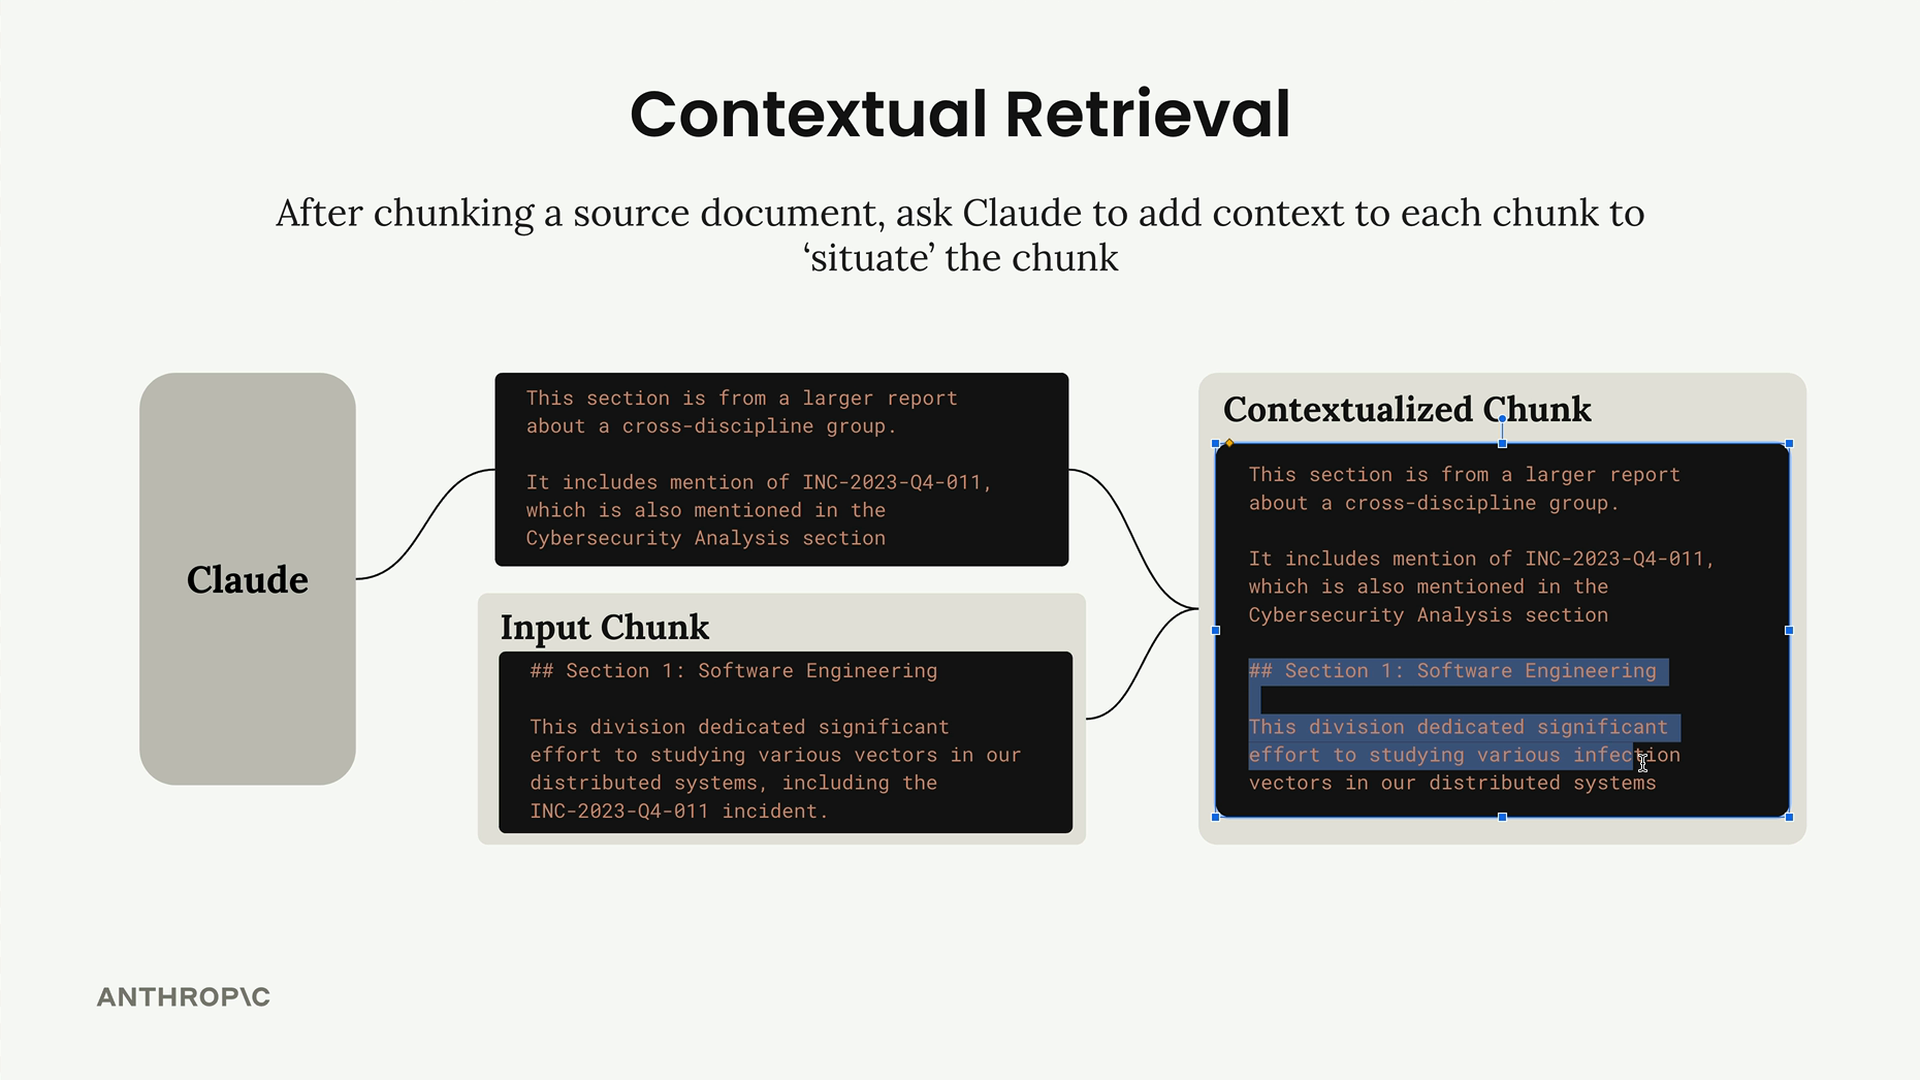
- このコンテキストを元のチャンクと組み合わせて「コンテキスト化されたチャンク」を作成する
- コンテキスト化されたチャンクをベクトルインデックスとBM25インデックスで使用する
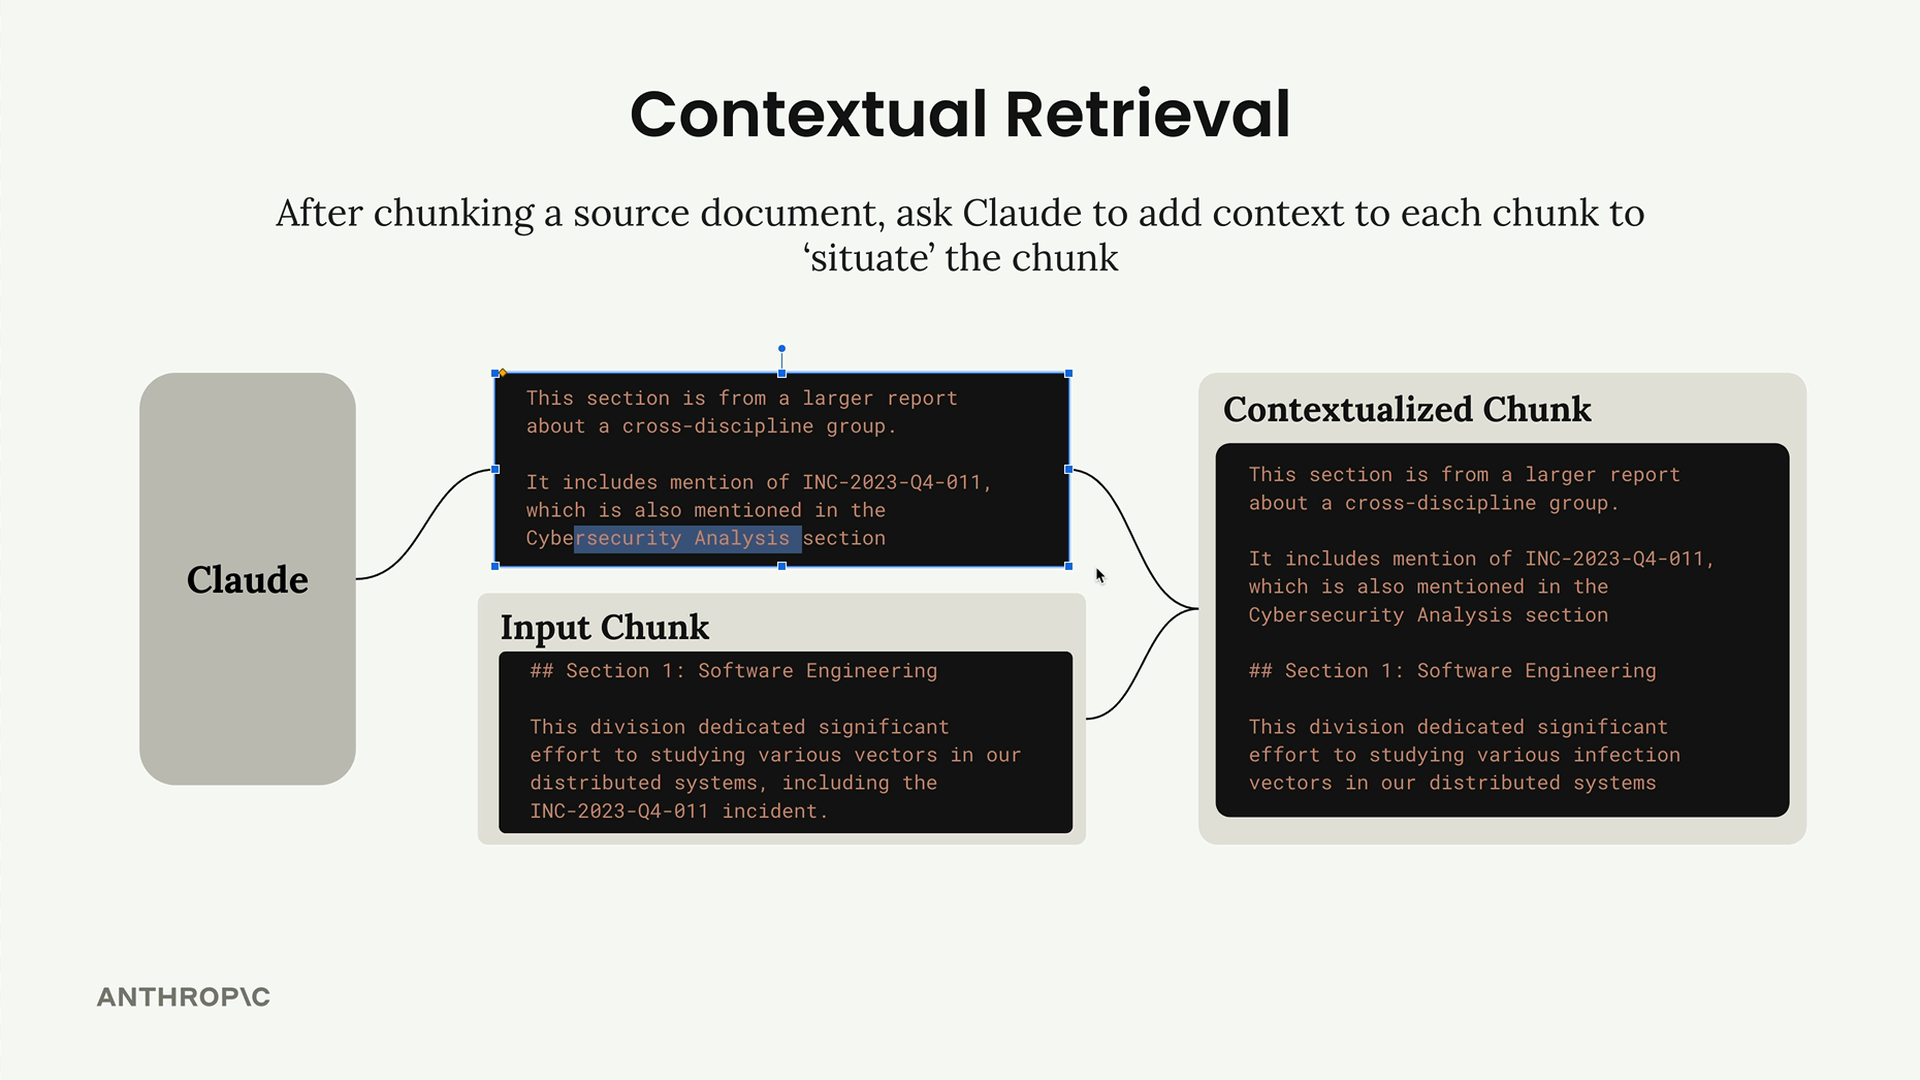
たとえば、2023年のインシデントに言及しているソフトウェアエンジニアリングに関するセクションがある場合、Claudeは次のようなコンテキストを生成するかもしれません。「このセクションは、複数分野にまたがるグループに関するより大きなレポートの一部です。INC-2023-04-011について言及しており、これはサイバーセキュリティ分析セクションでも言及されています。」
大規模なドキュメントの扱い
よくある問題は、ソースドキュメントが大きすぎてClaudeのコンテキストウィンドウに収まらない場合です。このような場合でも、コンテキストの範囲を絞ることでコンテキスト検索を利用できます。
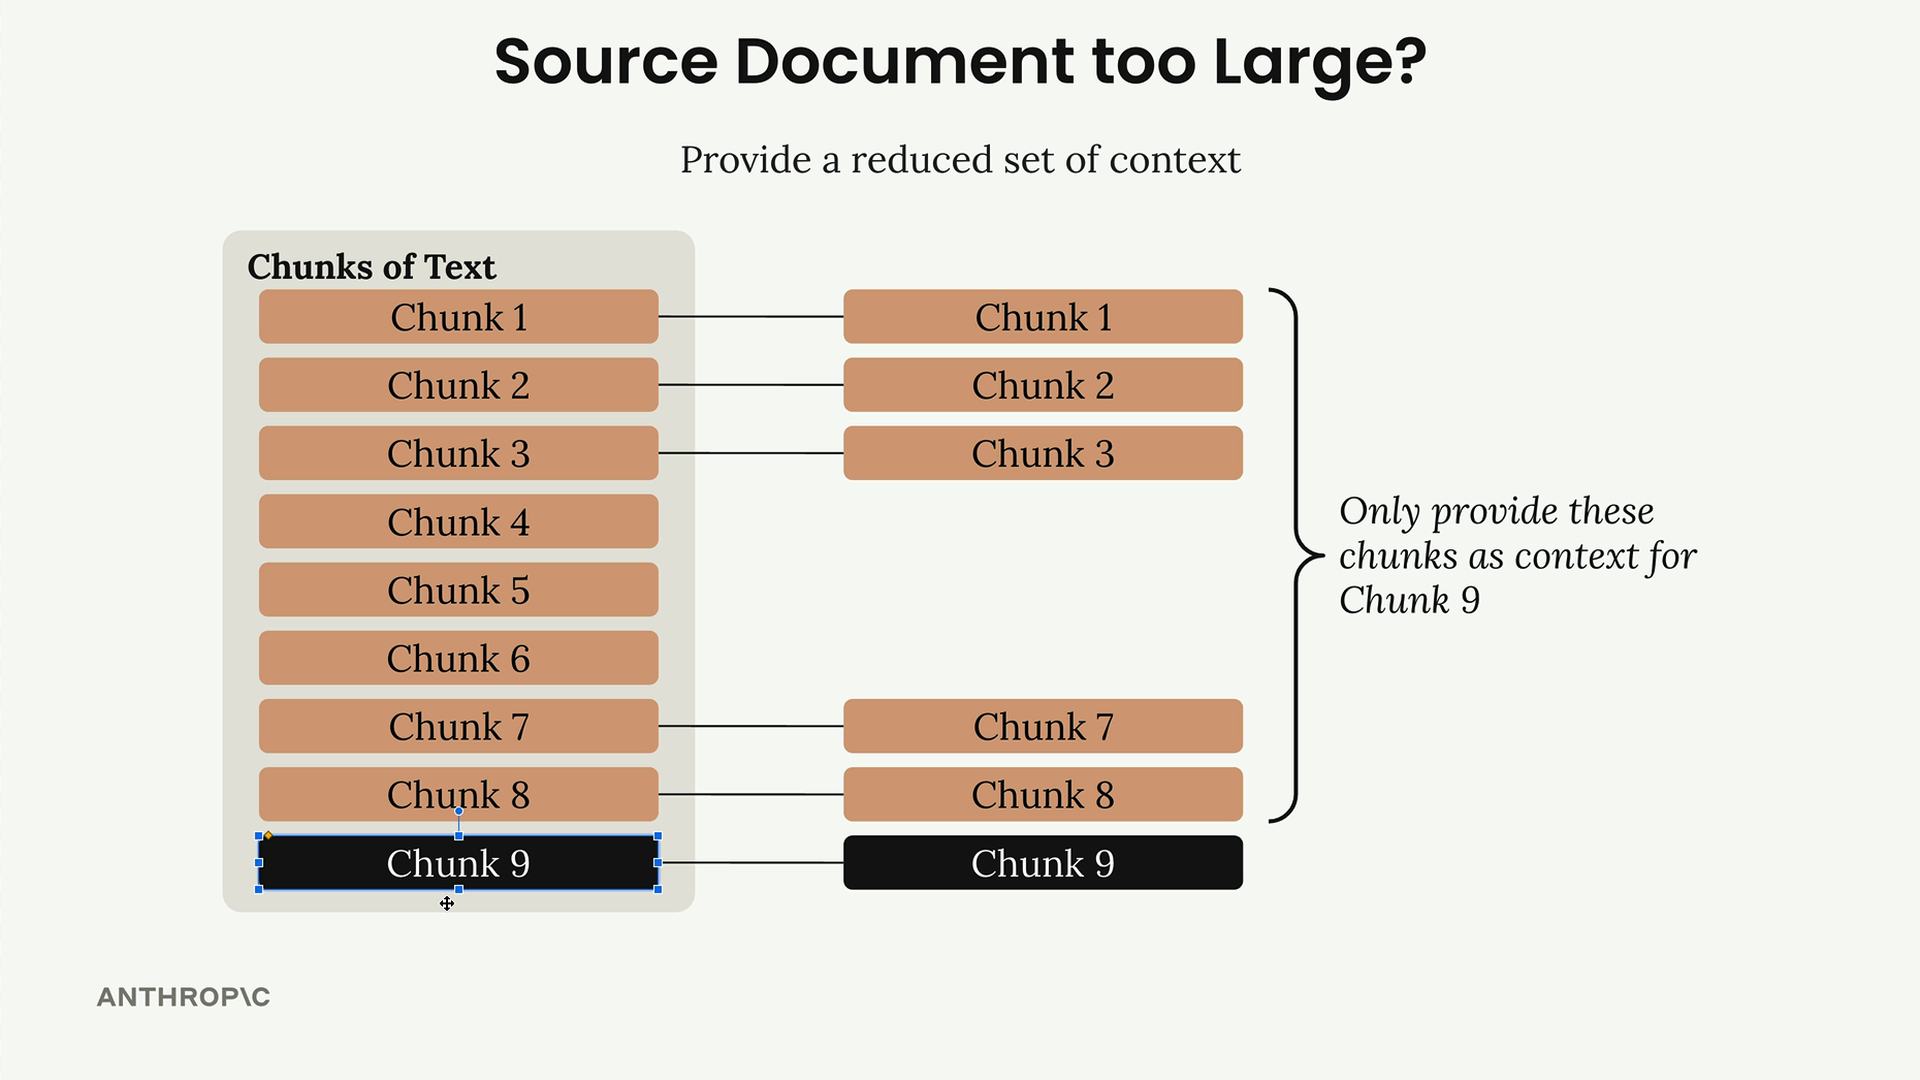
ドキュメント全体を含めるのではなく、次のものを提供します。
- ドキュメントの冒頭からのいくつかのチャンク(多くの場合、要約や概要が含まれる)
- コンテキスト化しようとしているチャンクの直前のチャンク
このアプローチにより、プロンプトを過負荷にすることなく、Claudeがドキュメント構造と直近のコンテキストを理解するのに十分な情報が得られます。
実装例
チャンクにコンテキストを追加するための基本的な関数は次のとおりです。
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
大規模なドキュメントの場合は、関連するコンテキストチャンクを選択する戦略を実装できます。
# 各チャンクにコンテキストを追加してからretrieverに追加
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # ドキュメント先頭からの初期チャンク群
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # コンテキストを付与中の現在のチャンクより先にある追加チャンク群
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
コンテキスト検索を使用すべき場合
この手法は、次のような場合に最も価値を発揮します。
- ドキュメントのセクション間に複雑な内部関係がある場合
- チャンクがドキュメントの他の場所で定義された概念を参照している場合
- 正確な検索のためにドキュメント構造の理解が重要な場合
- 技術文書、レポート、学術論文を扱っている場合
コンテキスト検索は処理時間とコストを追加しますが(追加のAPI呼び出しを行うため)、コンテキストが重要な複雑なドキュメントにおいては、検索精度を大幅に向上させることができます。