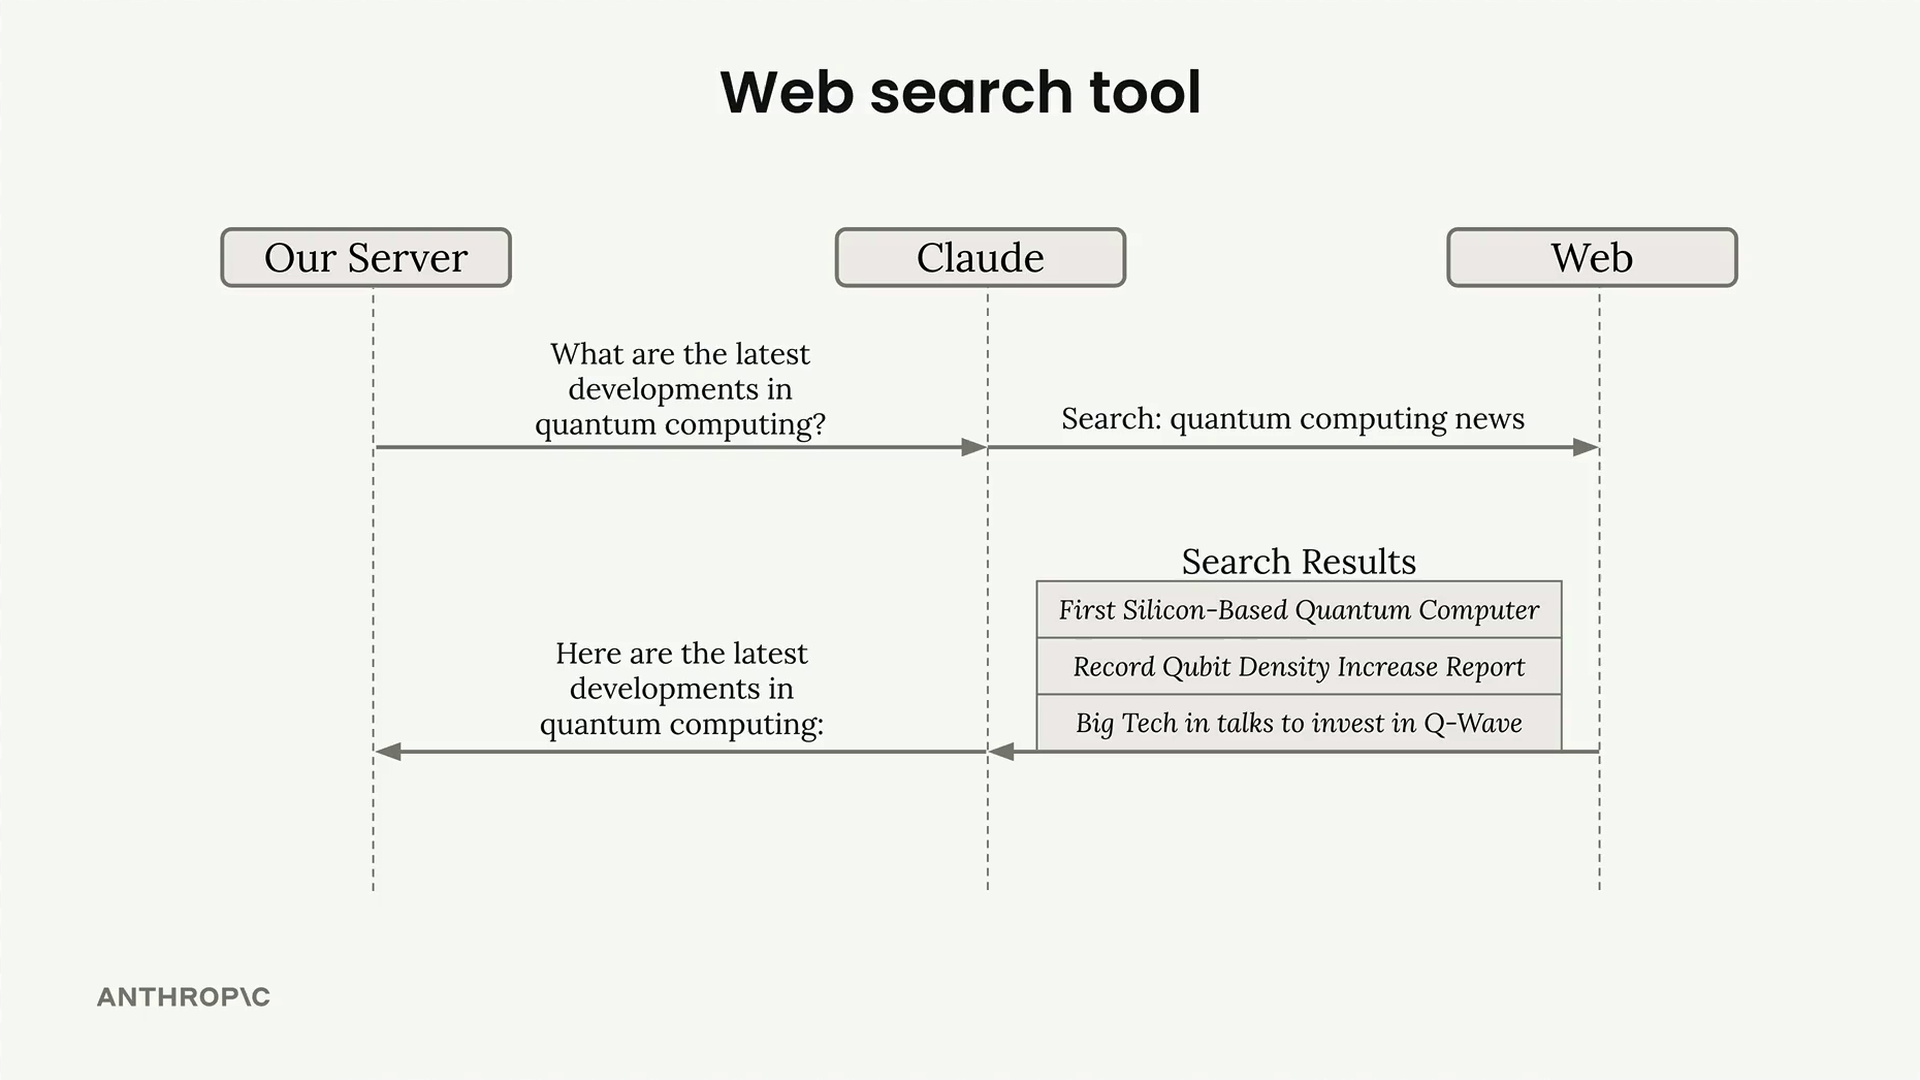
Claudeには組み込みのウェブ検索ツールが含まれており、これを使用してインターネットを検索し、ユーザーの質問に答えるための最新情報や専門的な情報を取得できます。実装を自分で用意する必要がある他のツールとは異なり、Claudeは検索プロセス全体を自動的に処理します。有効にするには、シンプルなスキーマを提供するだけで済みます。
ウェブ検索ツールのセットアップ
ウェブ検索ツールを使用するには、次の必須フィールドを持つスキーマオブジェクトを作成します。
web_search_schema = {
    "type": "web_search_20250305",
    "name": "web_search",
    "max_uses": 5
}
max_uses フィールドは、Claudeが実行できる検索回数を制限します。Claudeは最初の結果に基づいて追加の検索を行うことがあるため、これによって過剰なAPI呼び出しを防ぎます。
仕組み
ツールリストにウェブ検索スキーマを含めると、Claudeは質問内容に基づいて検索するタイミングを自動的に判断します。例えば、「脚の筋肉をつけるのに最適な運動は何ですか?」と尋ねると、最新のフィットネス研究の検索がトリガーされることがあります。
レスポンスには、いくつかの種類のブロックが含まれます。
- TextBlock - Claudeが何をしているかの説明
- ServerToolUseBlock - Claudeが使用した正確な検索クエリを表示
- WebSearchToolResultBlock - 検索結果を含む
- WebSearchResultBlock - タイトルとURLを持つ個々の検索結果
- CitationsWebSearchResultLocation - Claudeの発言を裏付ける特定のテキストの引用
検索対象ドメインの制限
allowed_domains フィールドを使用して、検索を特定のドメインに制限できます。これは、信頼できる情報源を求める場合に特に便利です。
web_search_schema = {
    "type": "web_search_20250305",
    "name": "web_search",
    "max_uses": 5,
    "allowed_domains": ["nih.gov"]
}
これにより、Claudeは信頼性が不確かな無作為のフィットネスブログではなく、政府の医療関連サイトなどの信頼できるドメインのみを検索するようになります。
検索結果のレンダリング
レスポンスの構造は、豊かなUIレンダリングのために設計されています。通常は次のようにします。
- テキストブロックを通常のコンテンツとして表示する
- ウェブ検索結果を上部に参照リストとして表示する
- 引用を元の情報源へのリンク付きでインラインにレンダリングする
- 引用されたテキストを強調表示し、Claudeがその発言をどのように裏付けているかを示す
これにより、ユーザーがClaudeの情報源を検証し、どのようにして結論に至ったかを理解できる、透明性のある体験が生まれます。この引用システムは、Claudeの回答の背後にある根拠を示すことで、信頼構築に役立ちます。