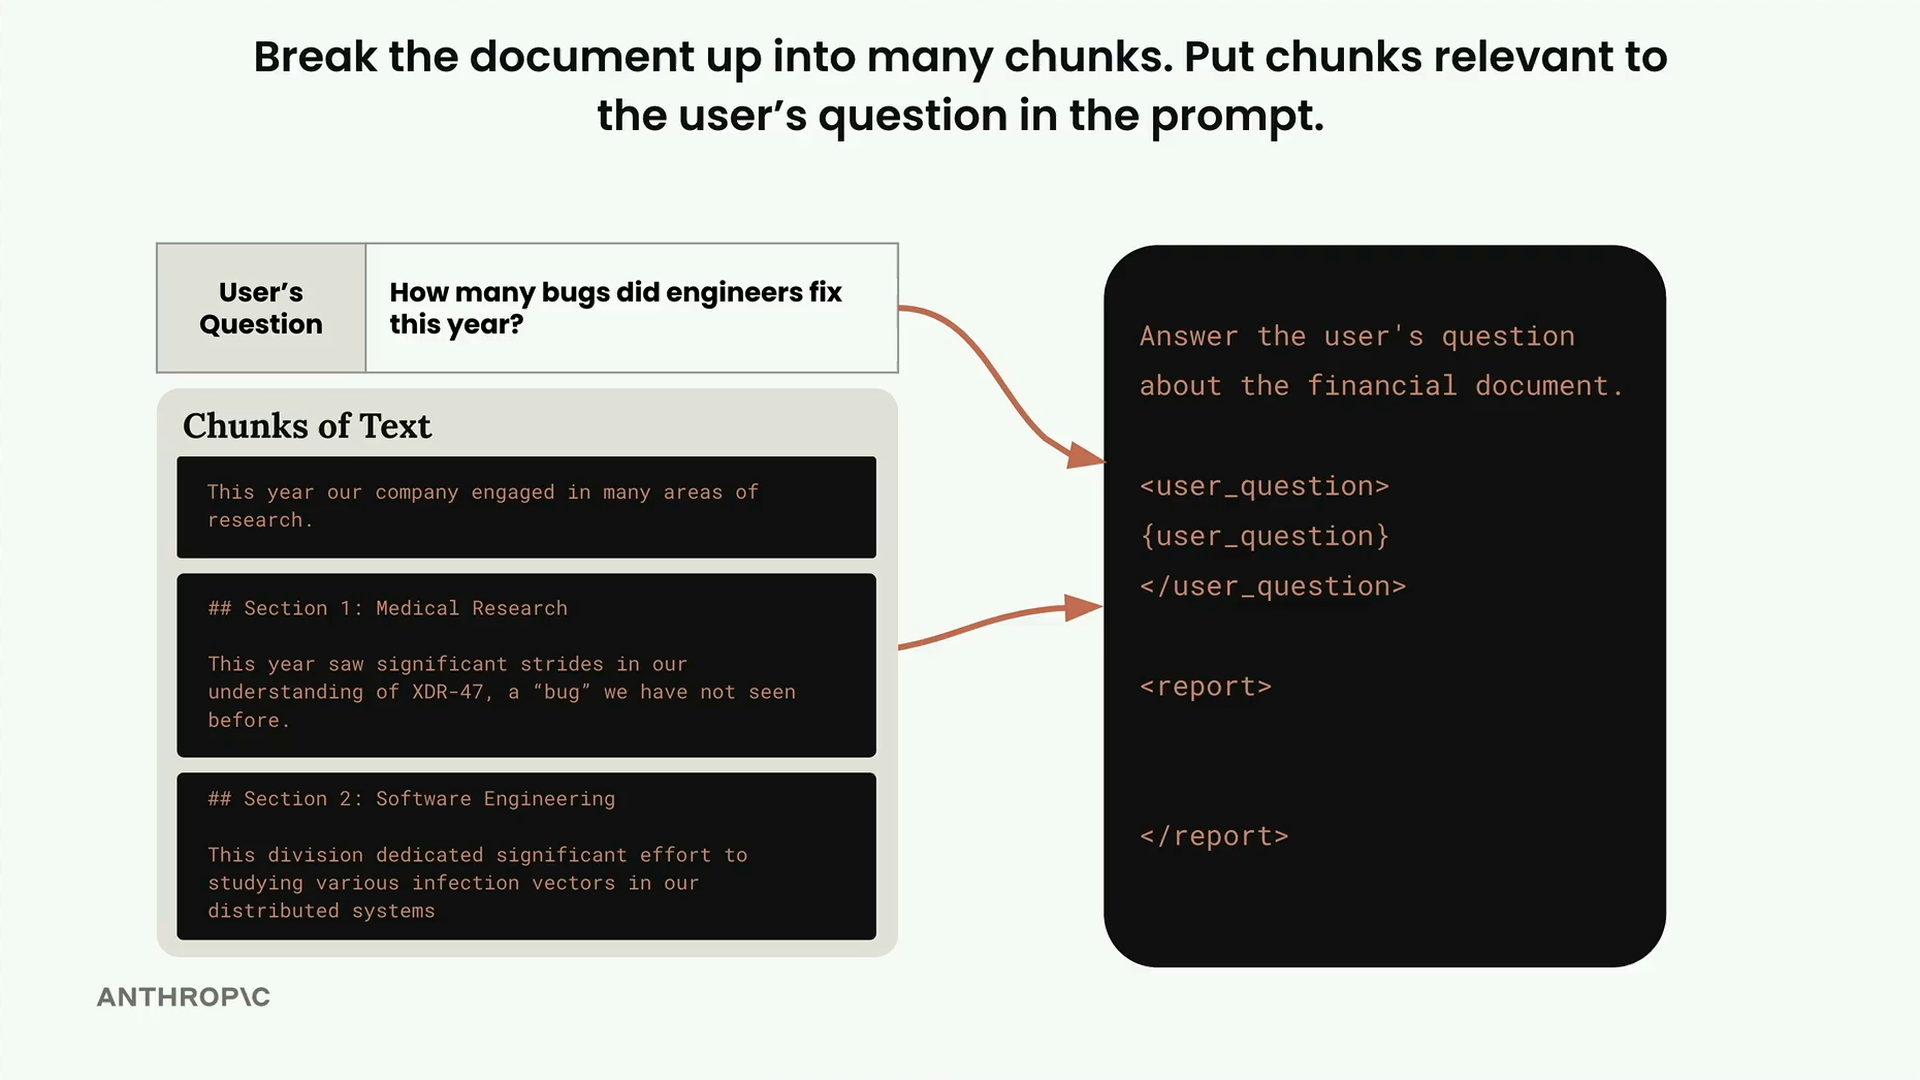
ドキュメントからテキストチャンクを抽出した後、RAGパイプラインの次のステップは、ユーザーの質問に最も関連性の高いチャンクを見つけることです。これは本質的に検索の問題です。すべてのチャンクを調べて、ユーザーが尋ねている内容に関連するものを特定する必要があります。
セマンティック検索
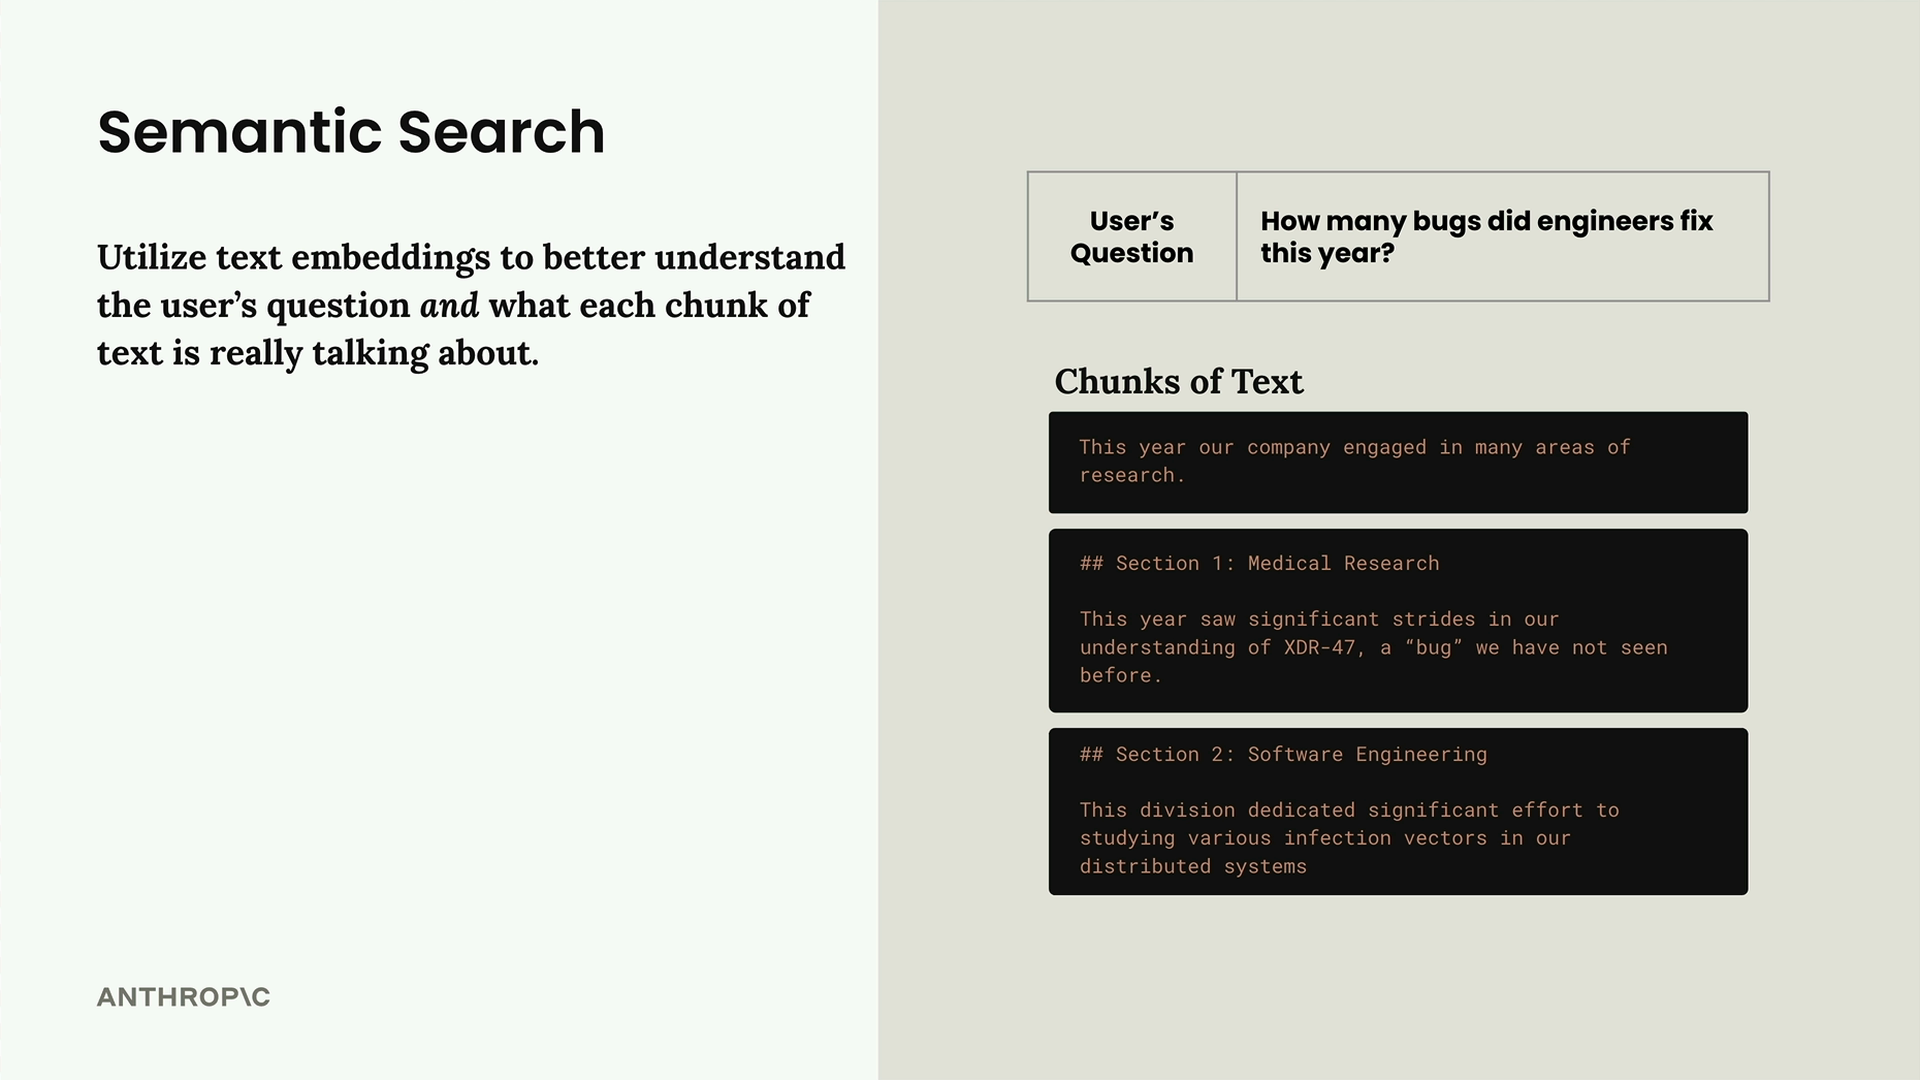
関連するチャンクを見つけるための最も一般的なアプローチはセマンティック検索です。従来のキーワードベースの検索とは異なり、セマンティック検索ではテキスト埋め込みを使用して、ユーザーの質問と各テキストチャンクの実際の意味を理解します。これにより、正確な単語が一致しない場合でも、概念的に関連するコンテンツを見つけることができます。
テキスト埋め込みとは何か
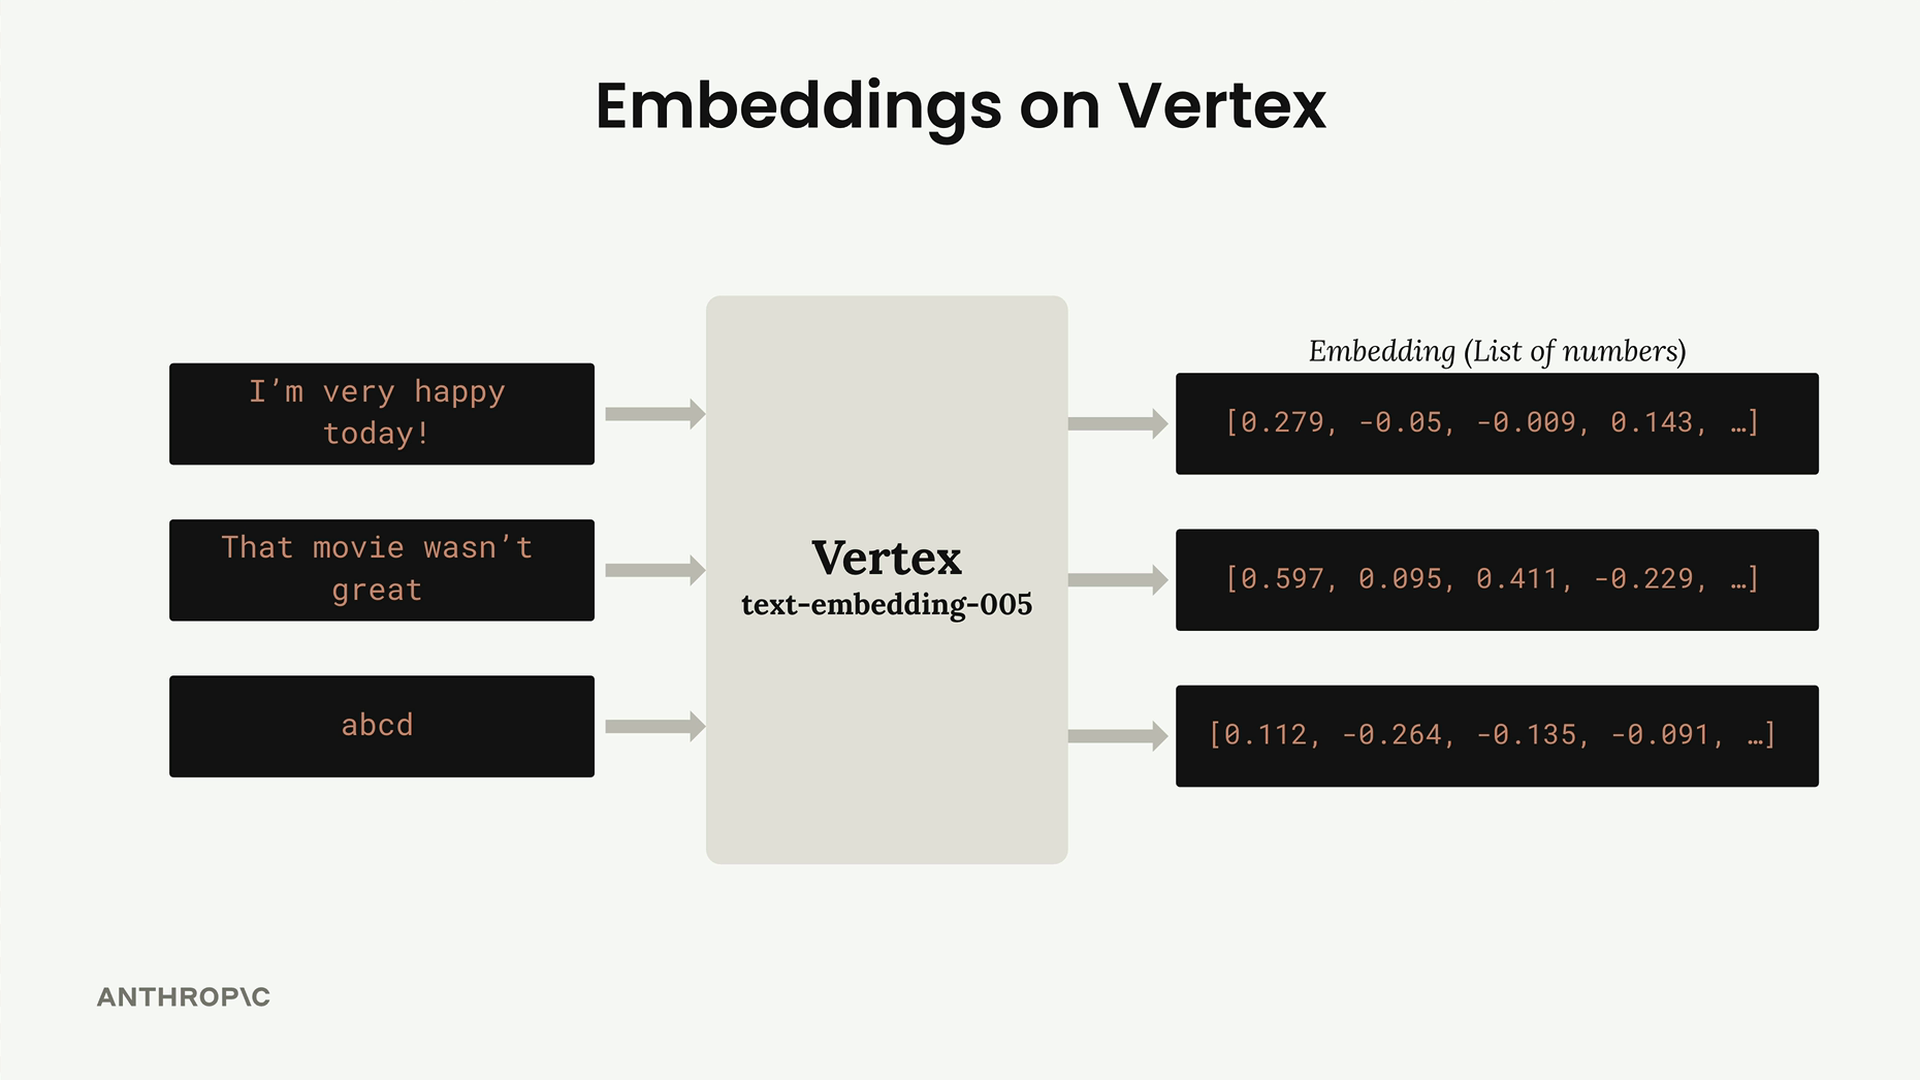
テキスト埋め込みとは、あるテキストに含まれる意味を数値で表現したものです。単語や文章を、コンピューターが数学的に扱える形式に変換すると考えてください。
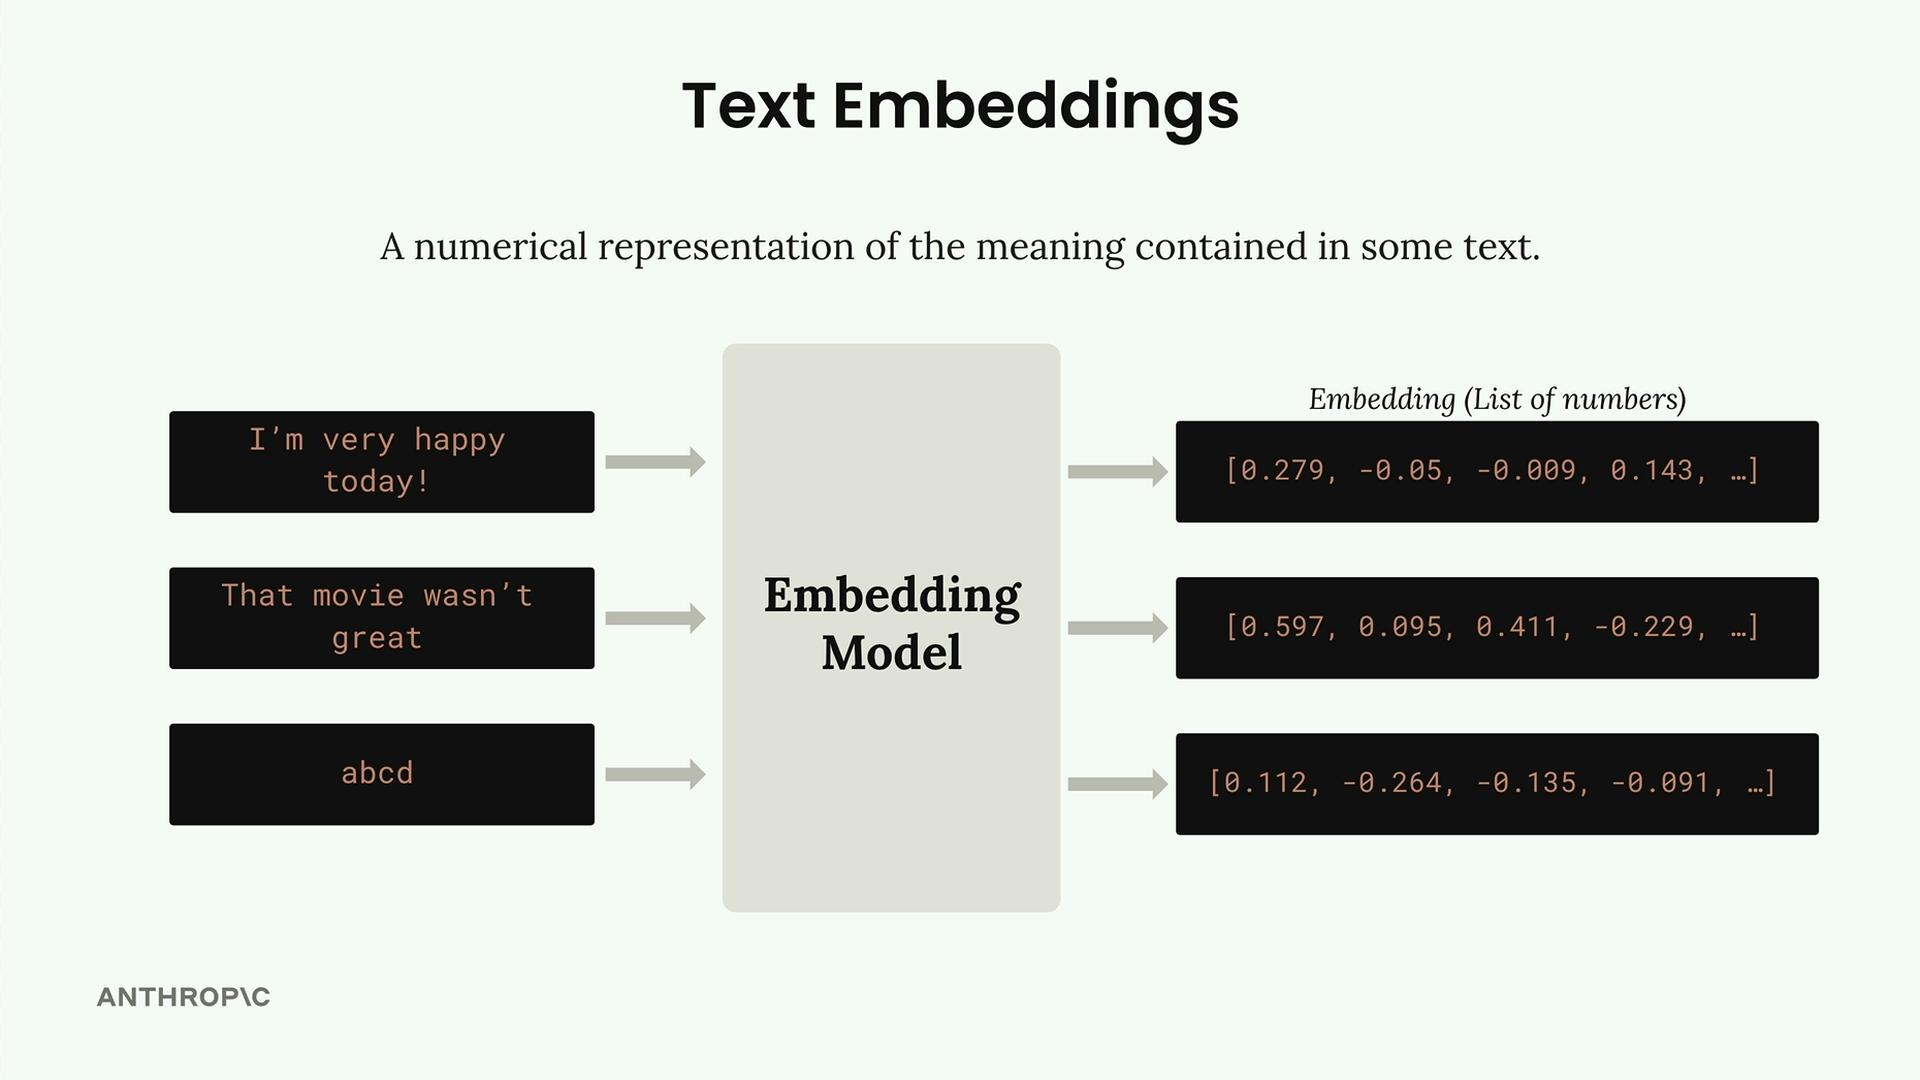
処理の流れは次のとおりです。
- テキストを埋め込みモデルに入力する
- モデルが長い数字のリスト(埋め込み)を出力する
- 各数字は-1から+1の範囲にある
- これらの数字は、入力テキストのさまざまな性質や特徴を表している
数字を理解する
埋め込み内の各数字は、基本的に入力テキストの何らかの性質に対する「スコア」です。ただし、ここで重要な注意点があります。それは、それぞれの数字が具体的に何を表しているのかを、私たちは実際には知らないということです。
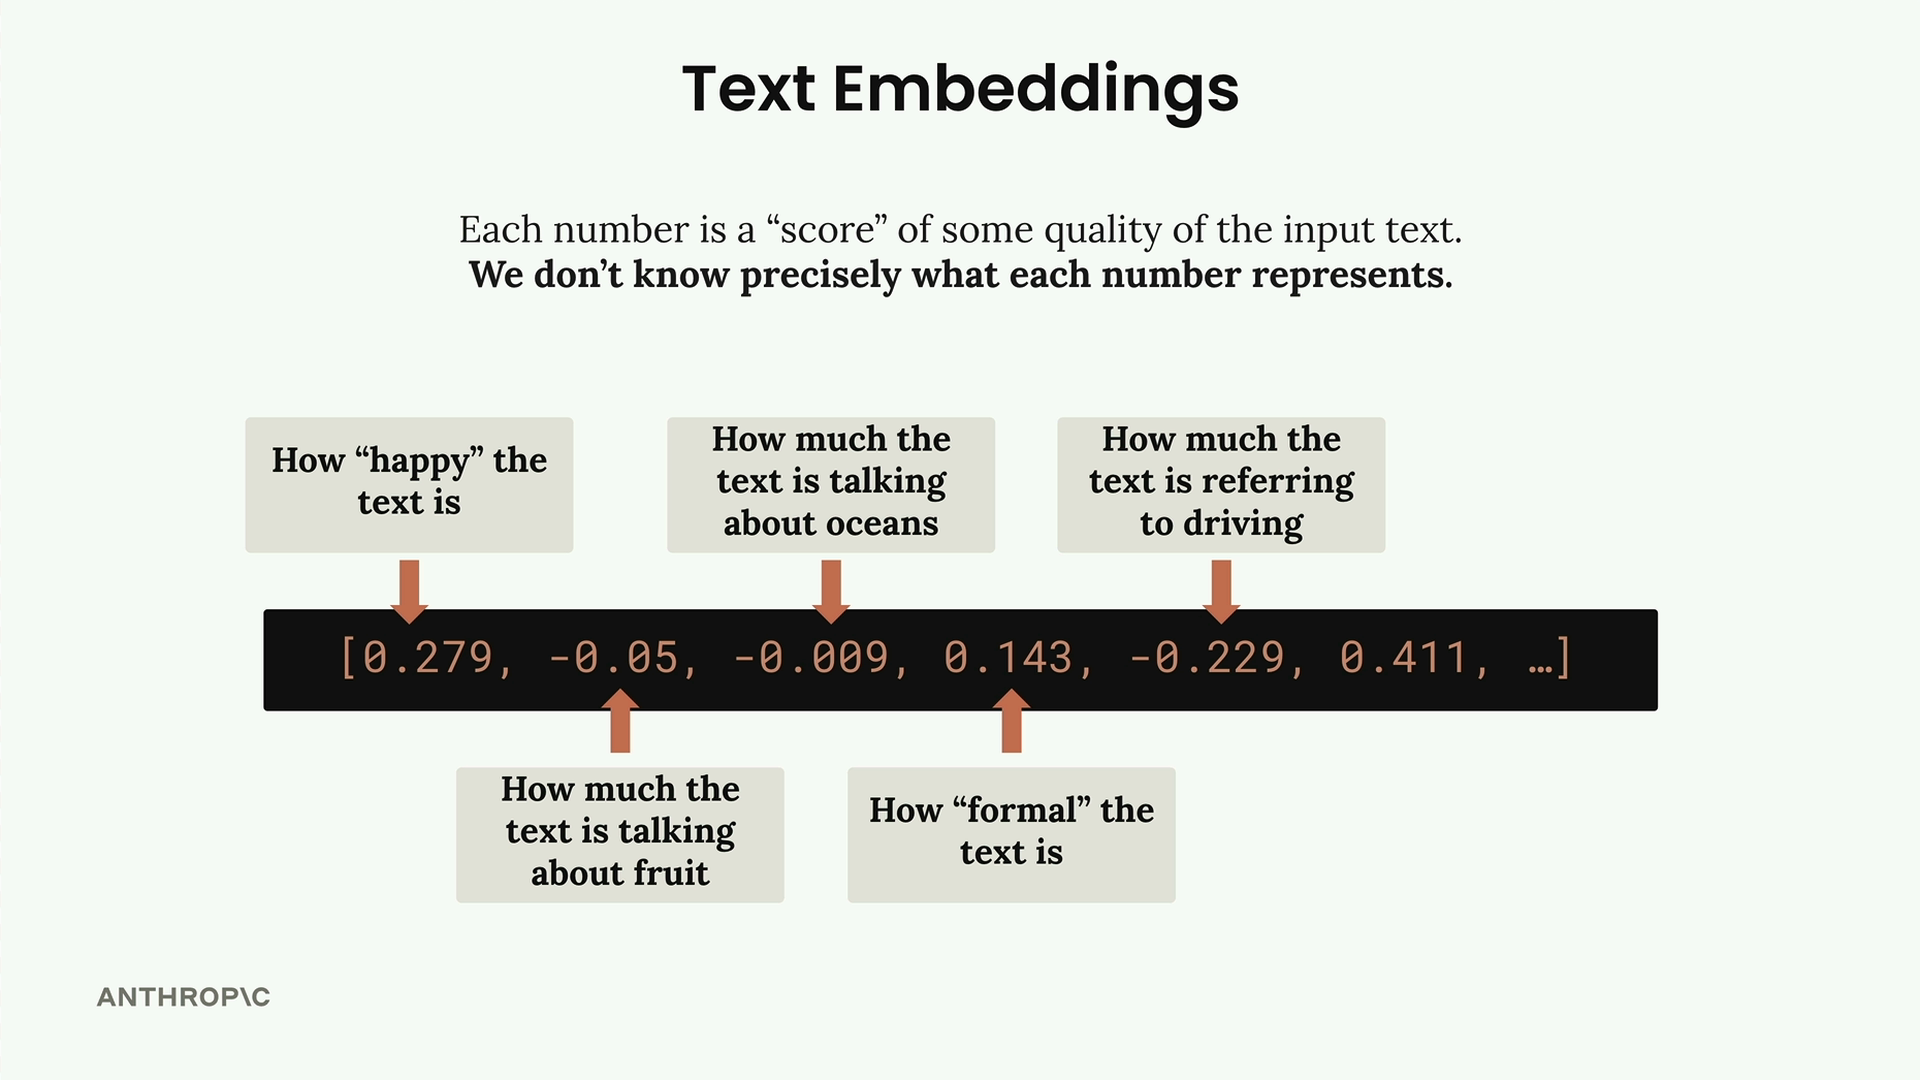
ある数字は「テキストがどれほど幸せな内容か」を表し、別の数字は「テキストがどれほど海について語っているか」を表していると想像すると理解しやすいですが、これらはあくまで概念的な例にすぎません。埋め込みモデルは訓練中にこれらの特徴を学習しますが、それらは明示的にラベル付けされているわけではなく、私たちにとって解釈可能なものでもありません。
このような不透明さにもかかわらず、埋め込みは異なるテキスト同士を数学的に比較できる形で意味的な意味を捉えるため、非常に強力です。
Vertex AIにおける埋め込み
Claudeは埋め込みを直接生成することはできません。代わりに、専用の埋め込みモデルを使用する必要があります。Vertex AIでは、使用するモデルはtext-embedding-005と呼ばれます。
実装
Vertex AIで埋め込みを扱うには、Google GenAI SDKをインストールする必要があります。
pip install google-genai以下は、埋め込みを生成するための基本的なセットアップです。
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
この関数をテキストチャンクと共に実行すると、そのテキストの意味的な内容を表す浮動小数点数のリストが返ってきます。これらの埋め込みは、RAGシステムでセマンティック検索を実装するための基盤となります。
次のステップは、これらの埋め込みを実際にどう使ってユーザーの質問に最も関連性の高いチャンクを見つけるかを理解することであり、これには埋め込みを数学的に比較して類似度を判定することが含まれます。