これまで構築してきたハイブリッド検索アプローチはうまく機能していますが、まだ改善の余地があります。「eng teamはINC-2023-Q4-011に対して何をしたか?」と検索した場合、エンジニアリングチームとそのインシデントに具体的に言及しているソフトウェアエンジニアリングのセクションが上位にランクされることを期待するはずです。しかし、依然としてサイバーセキュリティのセクションが最初に表示されます。
ここで登場するのが再ランク付け(re-ranking)です。これは、検索精度を大幅に向上させることができる後処理の手法です。
再ランク付けの仕組み
再ランク付けは、ハイブリッド検索プロセスの後に追加のステップを加えます。ベクトルインデックスとBM25インデックスからマージされた結果をそのまま返す代わりに、それらの結果をLLMに通して、知的な再順序付けを行います。
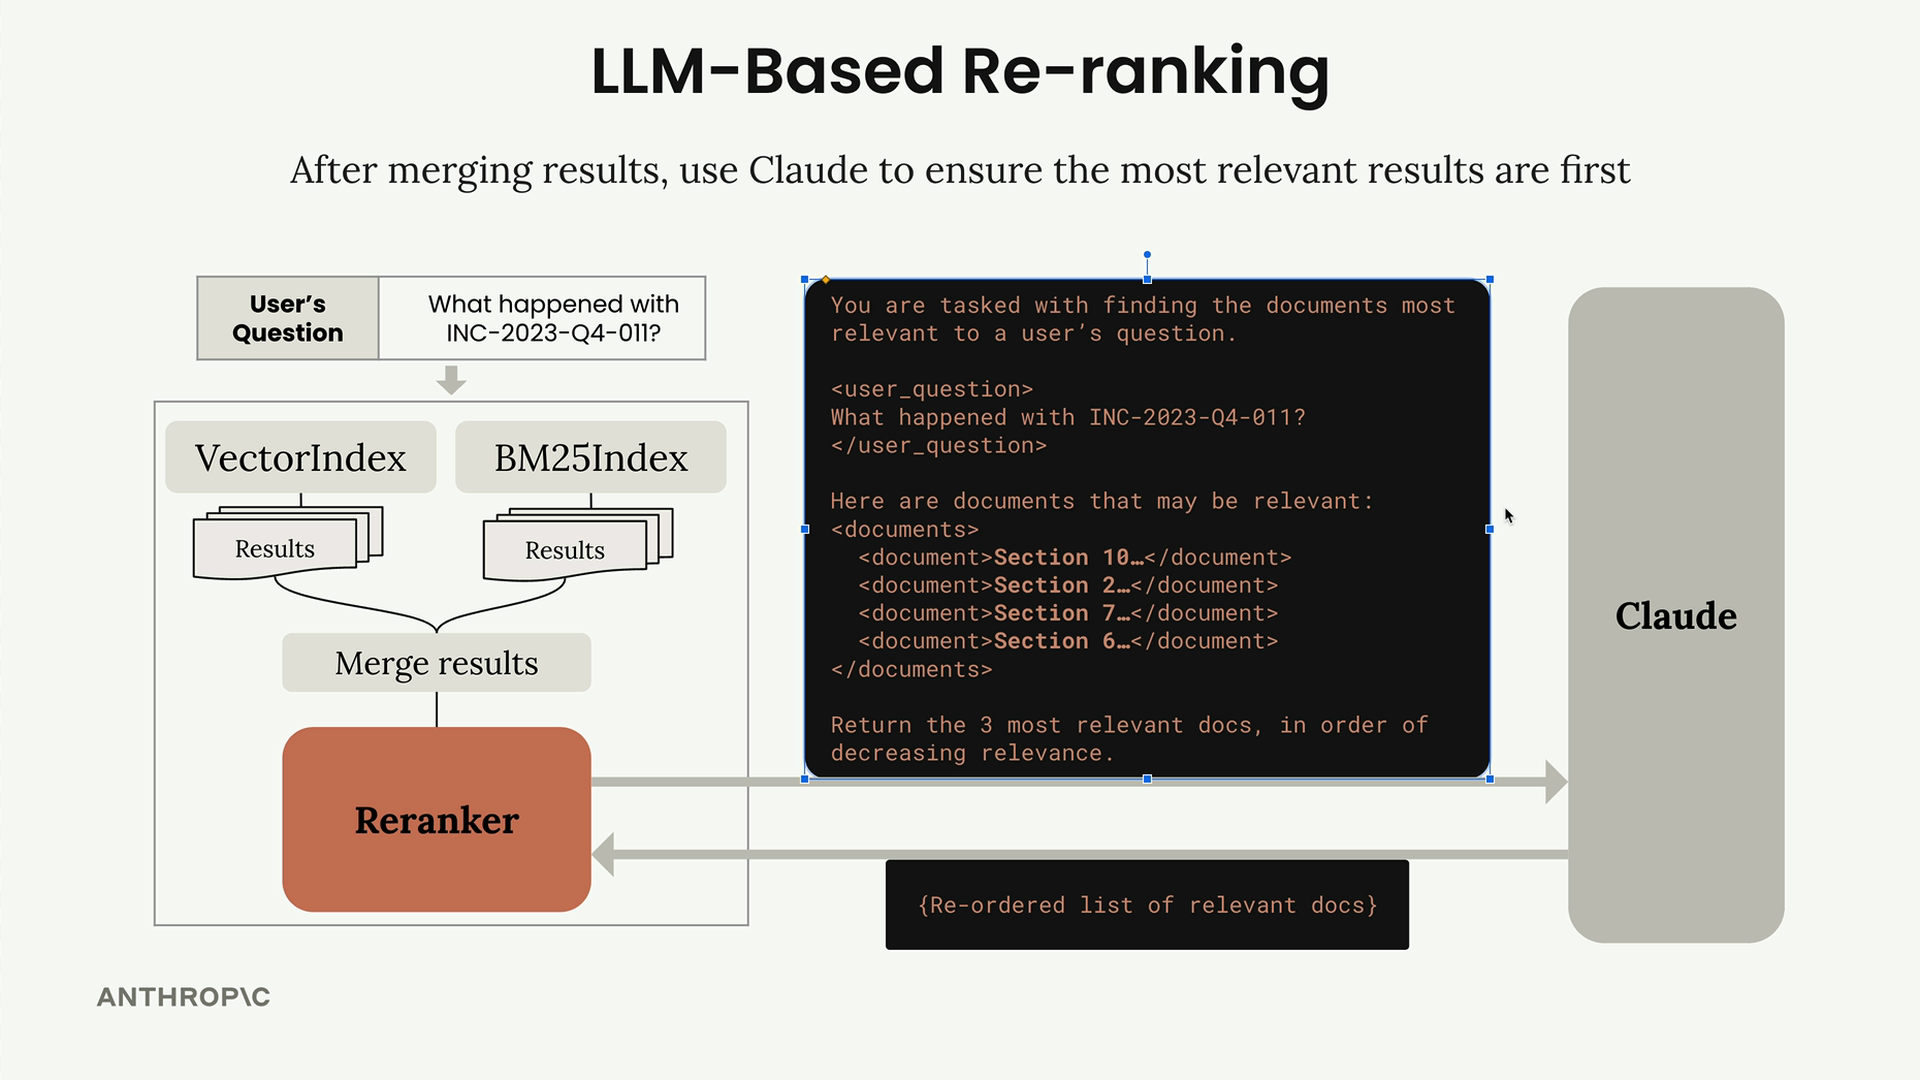
このプロセスは単純です。
- 既存のハイブリッド検索(ベクトル + BM25)を実行する
- これまでと同様に結果をマージする
- マージされた結果を再ランク付け用プロンプトとともにClaudeへ送信する
- 最も関連性の高いドキュメントの再順序付けされたリストを受け取る
再ランク付けプロンプト
プロンプトの構造はシンプルですが効果的です。ユーザーの質問とすべての候補ドキュメントをClaudeに提供し、関連性の高い順に最も関連性の高いものを返すよう依頼します。
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
{
  "document_ids": str[] # List document ids, {k} elements long, sorted in order of decreasing relevance
}
```効率性に関する考慮事項
重要な最適化の1つは、Claudeに完全なテキストチャンクを返すよう依頼する代わりに、ドキュメントIDを使用することです。Claudeに各関連ドキュメントの完全なテキストを返すよう求めると、大量のテキストをコピーするのを待つ時間が無駄になってしまいます。
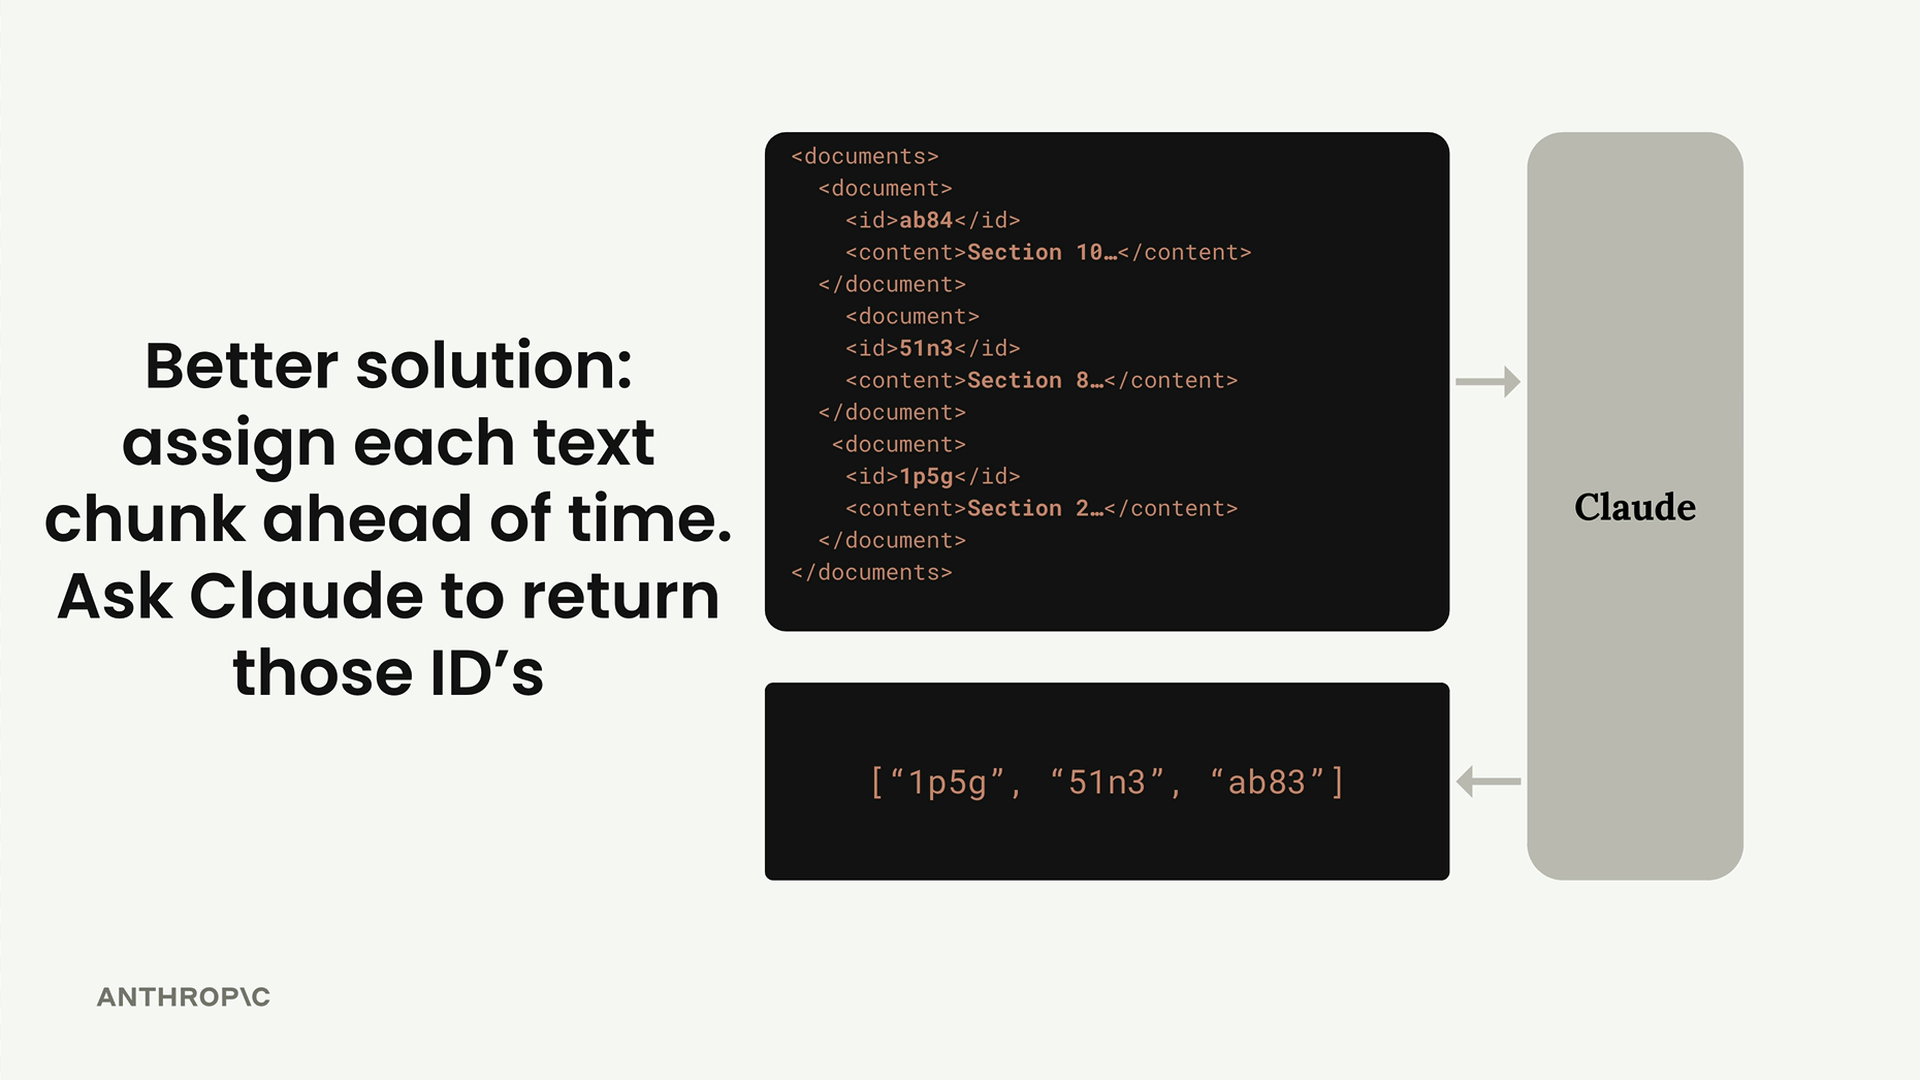
その代わりに、各テキストチャンクに一意のIDを事前に割り当て、ClaudeにはそれらのIDだけを望ましい順序で返すよう依頼します。これにより、再ランク付けのプロセスが大幅に高速化される一方で、必要な再順序付けされた結果を得ることができます。
実装
再ランカー関数は、最初のハイブリッド検索が完了した後に自動的に呼び出されます。基本的な構造は以下のとおりです。
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # ユーザーの質問とドキュメントからプロンプトを構築
    # JSONレスポンス形式でClaudeに送信
    # 並べ替え後のドキュメントIDを解析して返す
再ランカー関数をパラメータとして渡すことで、これをリトリーバーに統合できます。
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)結果
再ランク付けのアプローチには明確な改善が見られます。「eng teamはINC-2023-Q4-011に対して何をしたか?」というクエリをテストしたところ、ソフトウェアエンジニアリングのセクションが正しくサイバーセキュリティのセクションよりも先に表示されるようになりました。Claudeは、ユーザーが具体的にインシデントへのエンジニアリングチームの関与について尋ねていることを正しく特定できました。
トレードオフ
再ランク付けには考慮すべきトレードオフがあります。
- レイテンシの増加: 追加のLLM呼び出しが完了するのを待つ必要があります
- 精度の向上: LLMは単純な類似度スコアよりも、文脈や意図をよりよく理解できます
- コストに関する考慮事項: 各検索で追加のLLM APIコールが必要になります
多くのアプリケーションでは、精度の向上が追加のレイテンシとコストを正当化します。特に、ユースケースにおいて正確な検索が重要な場合はなおさらです。