プロンプト評価ワークフローを構築する際、採点システムは出力品質に関する客観的なシグナルを提供します。グレーダーはモデルの出力を受け取り、何らかの測定可能なフィードバックを返します。これは通常1から10までの数値で、10が高品質を表し、1が低品質を表します。
グレーダーの種類
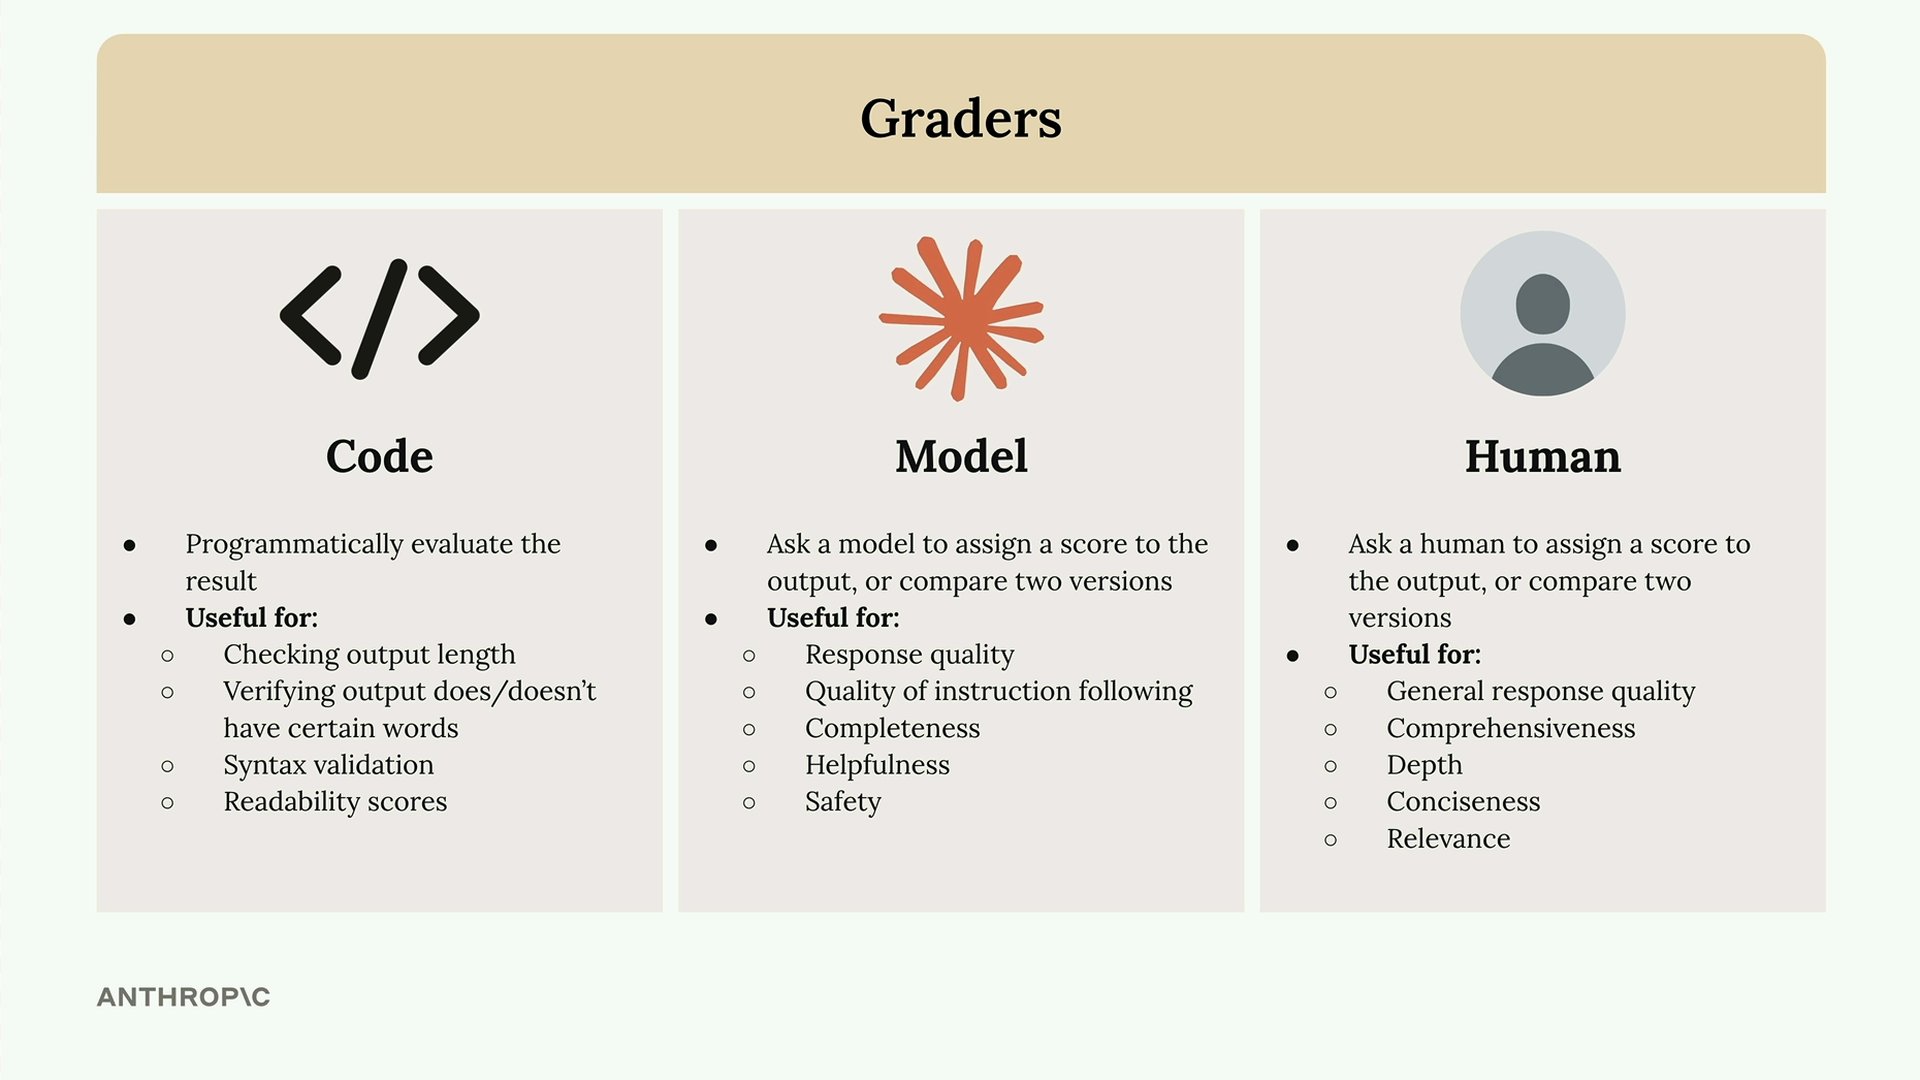
モデルの出力を採点する主なアプローチには、次の3つがあります。
- コードグレーダー - カスタムコードを使用してプログラム的に出力を評価する
- モデルグレーダー - 別のAIモデルを使用して品質を評価する
- 人間によるグレーダー - 人が手動で出力をレビューし、採点する
コードグレーダー
コードグレーダーでは、思いつく限りのあらゆるプログラム的チェックを実装できます。一般的な用途には次のものがあります。
- 出力の長さの確認
- 出力に特定の単語が含まれる、または含まれないことの検証
- JSON、Python、正規表現の構文検証
- 適切な読みやすさのレベルを確保するための読みやすさスコア
モデルグレーダー
モデルグレーダーは、出力を評価するために追加のAPI呼び出しを使用することで、非常に高い柔軟性を提供します。これは次のような評価に役立ちます。
- 応答の品質
- 指示への追従の質
- 完全性
- 有用性
- 安全性
人間によるグレーダー
人間によるグレーダーは最も柔軟性が高いですが、大きな欠点も伴います。人間は想像しうるあらゆる基準で応答を評価できますが、そのプロセスは時間がかかり、退屈なものです。
評価基準の定義
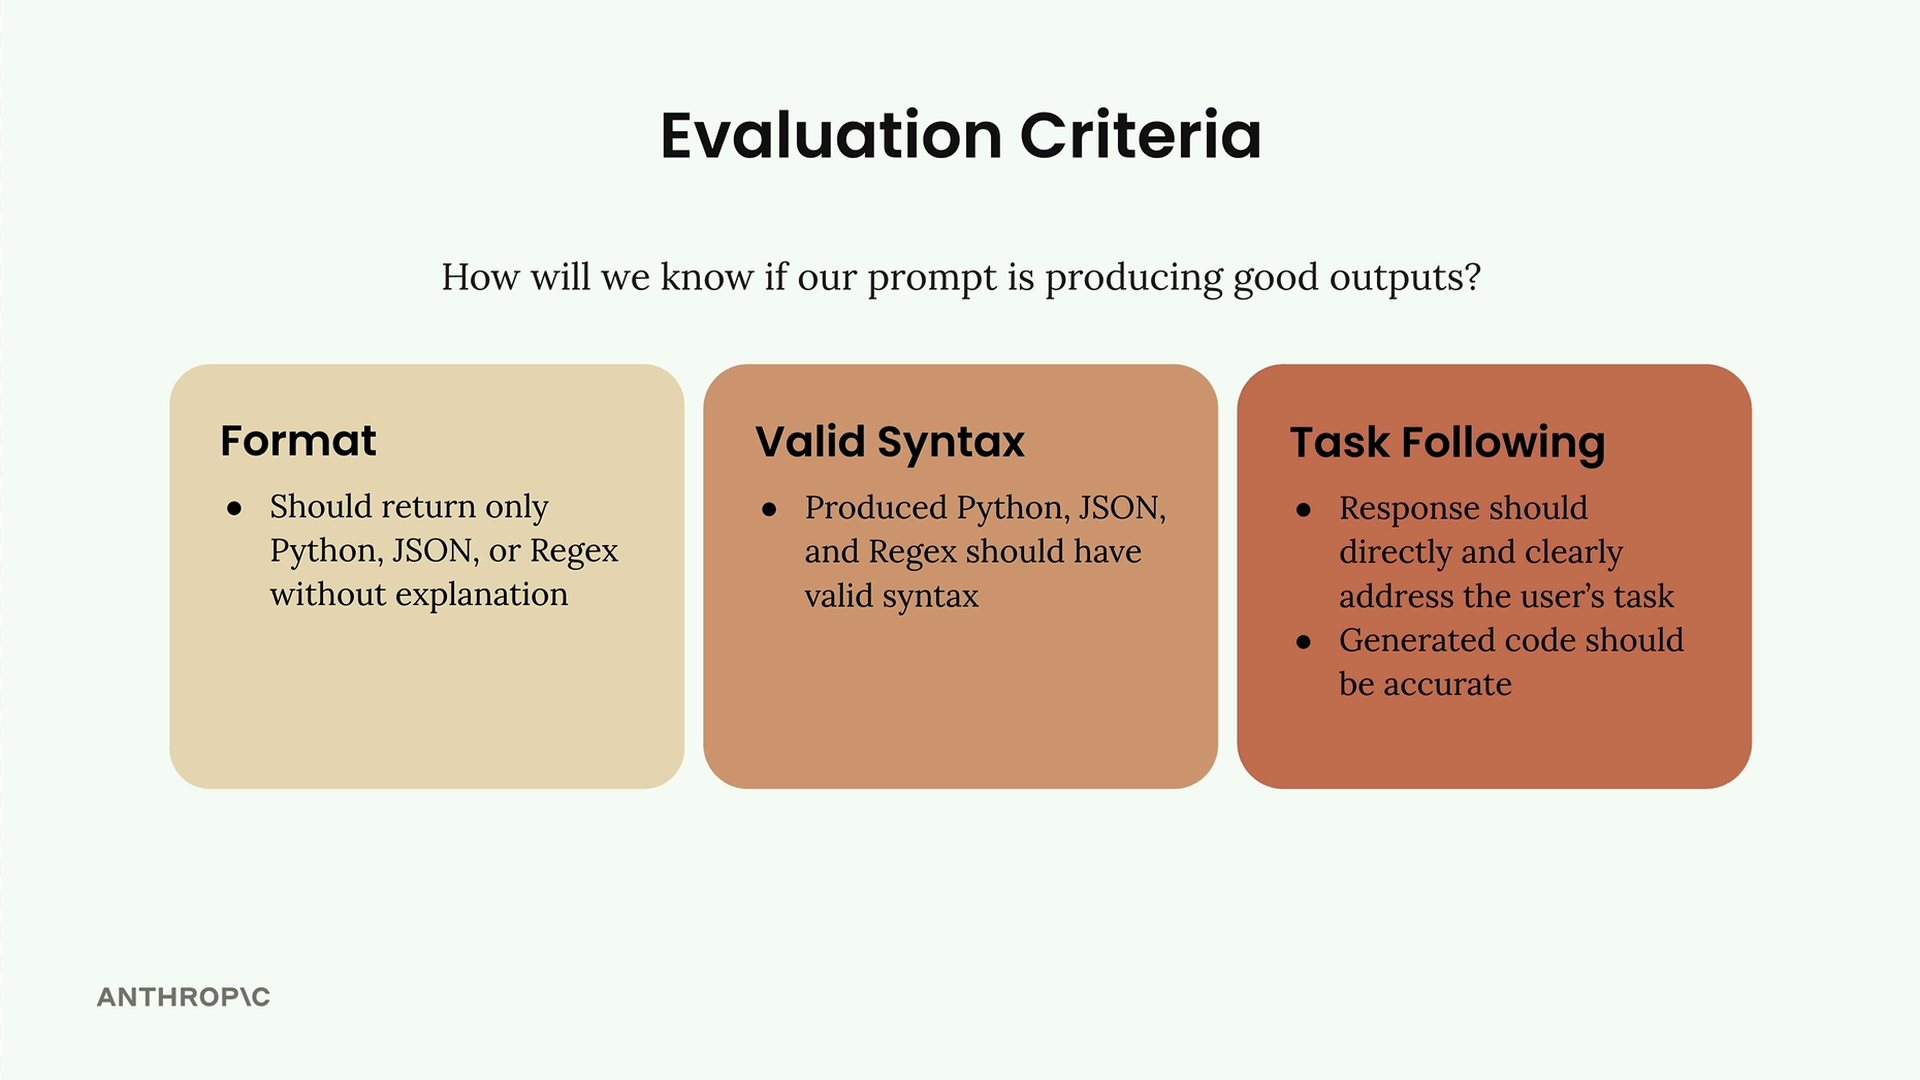
グレーダーを実装する前に、明確な評価基準が必要です。コード生成プロンプトの場合、次のような点に焦点を当てるとよいでしょう。
- 形式 - 説明なしにPython、JSON、または正規表現のみを返すべきである
- 有効な構文 - 生成されたコードは有効な構文を持つべきである
- タスクへの追従 - 応答はユーザーのタスクに正確なコードで直接対応すべきである
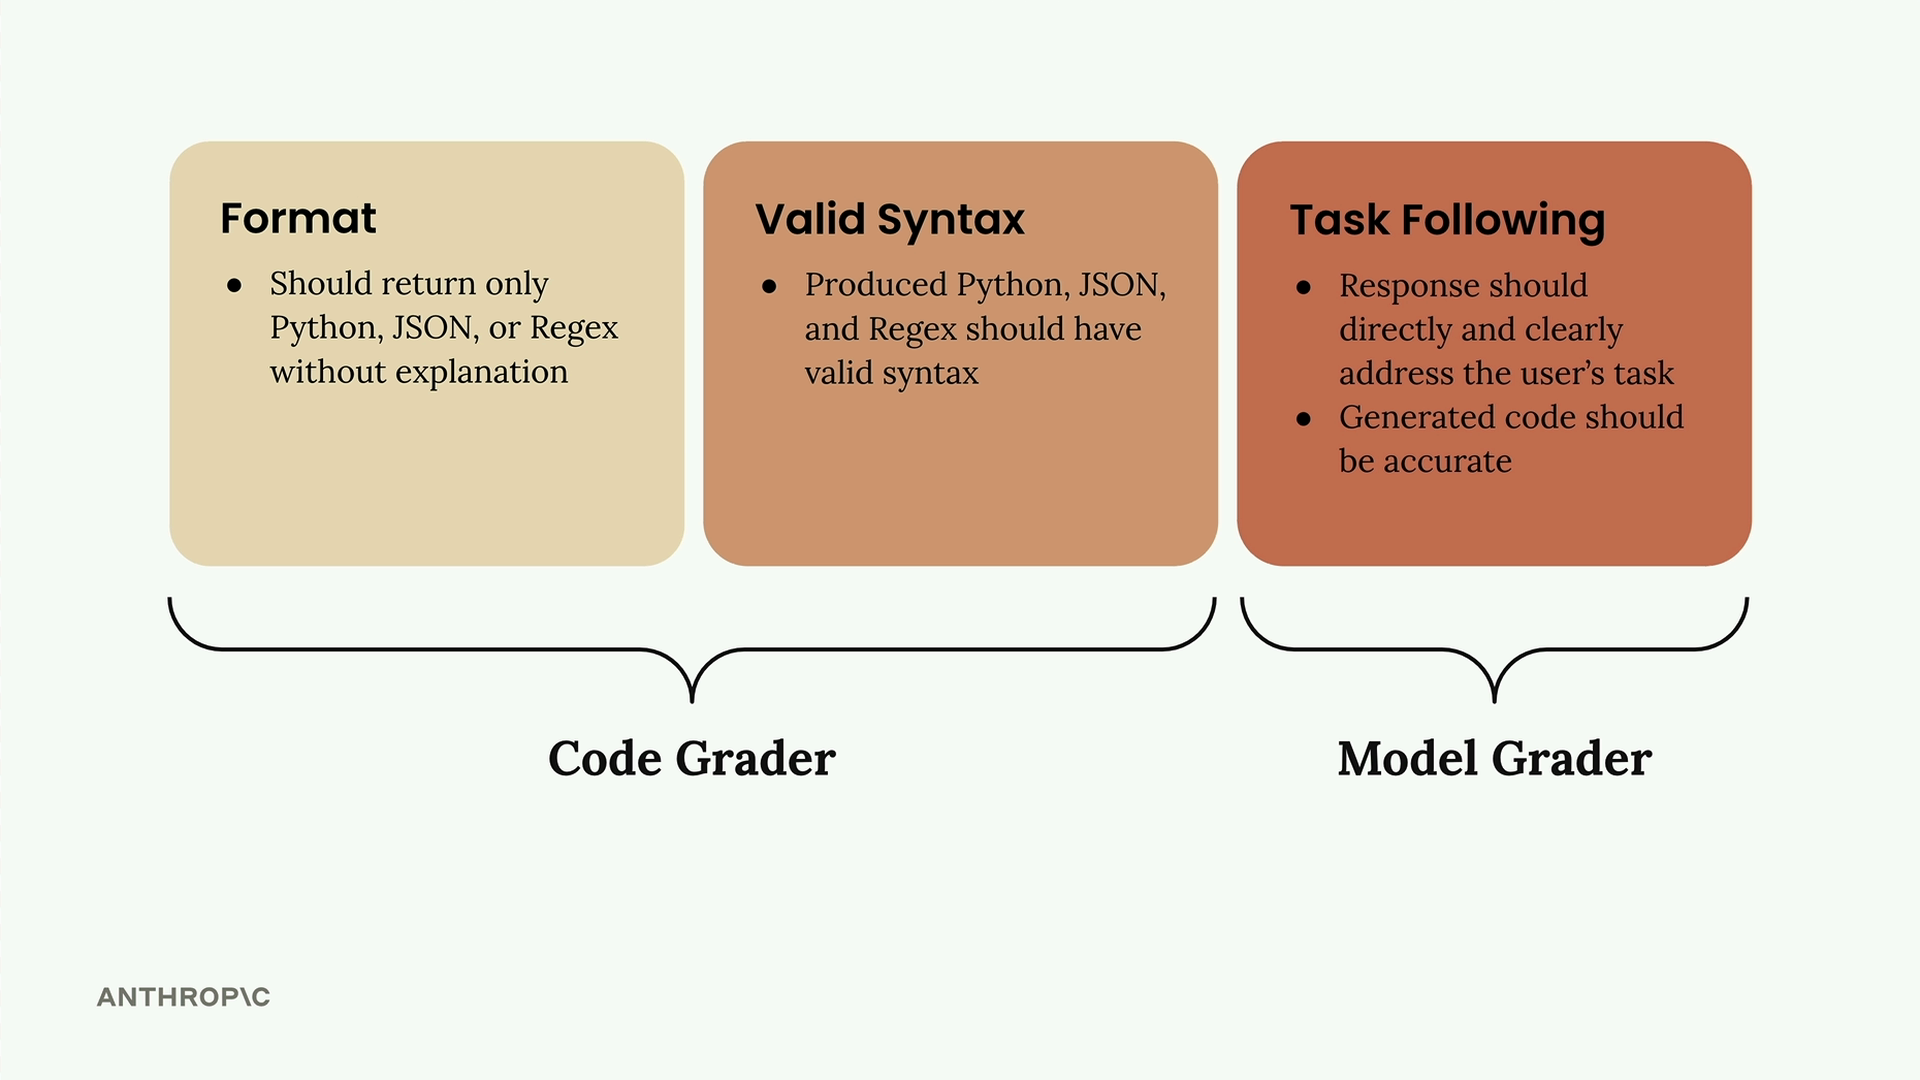
最初の2つの基準はコードグレーダーとの相性が良い一方で、タスクへの追従はその柔軟性から、モデルグレーダーの方が適しています。
モデルグレーダーの実装
モデルグレーダーは多くの場合、実装が最も容易です。基本的な構造は次のとおりです。
def grade_by_model(test_case, output):
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)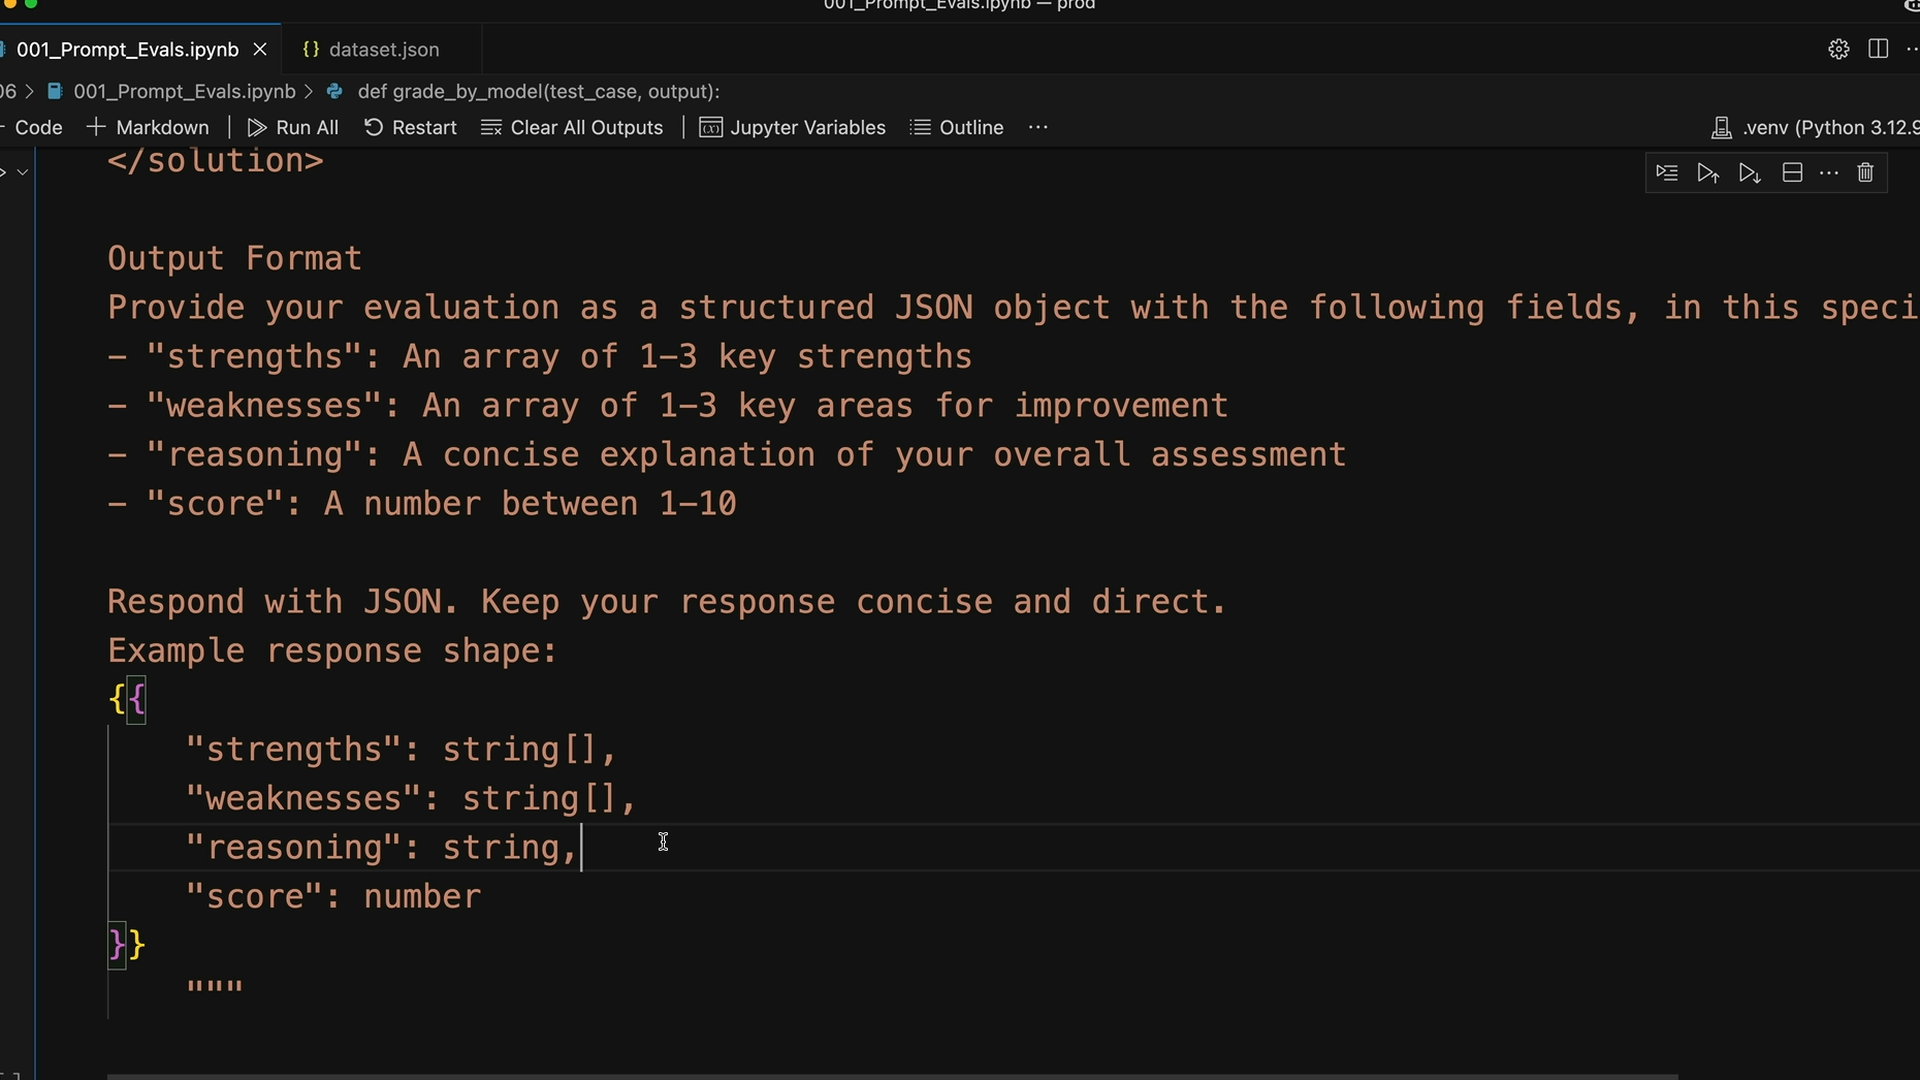
採点プロンプトは包括的であるべきで、次の要素を含める必要があります。
- グレーダーの明確な役割定義
- 元のタスク
- 評価対象となるAI生成のソリューション
- 具体的な出力形式の要件
スコアだけでなく、それ以上のものを求めてください。数値スコアとあわせて、強み、弱み、理由を求めましょう。これにより、モデルが6のような中間的なスコアにとどまりがちになるのを防ぎ、より思慮深い評価が行われるようになります。
グレーダーをワークフローに統合する
グレーダー関数ができたら、それをテストケースランナーに統合します。
def run_test_case(test_case):
    output = run_prompt(test_case)

    # モデルグレーダーを呼び出す
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
すべてのテストケースを実行した後、平均スコアを計算して、プロンプトのパフォーマンスに関する客観的な指標を得ます。
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
これにより、改善に集中するための具体的な数値が得られます。モデルグレーダーはやや気まぐれで、より良いガイダンスによって改善の余地がある場合もありますが、反復して改善していける客観的な評価の出発点を提供してくれます。