Retrieval Augmented Generation(RAG)は、Claudeを使用する際に大規模なドキュメントを扱うのに役立つテクニックです。800ページに及ぶ財務報告書全体を1つのプロンプトに詰め込む代わりに、RAGを使用すると、各質問に最も関連性の高いセクションだけをインテリジェントに見つけて含めることができます。
大規模なドキュメントの問題点
巨大な財務文書があり、それについてClaudeに「この会社にはどのようなリスク要因がありますか?」といった具体的な質問をしたいとします。ここで根本的な課題に直面します。それは、文書から正しい情報をどのようにしてClaudeに渡し、効果的に質問に答えられるようにするかということです。
オプション1:プロンプトにすべてを含める
最初のアプローチは単純に見えます。文書からすべてのテキストを抽出し、ユーザーの質問とともにプロンプトに直接詰め込むというものです。
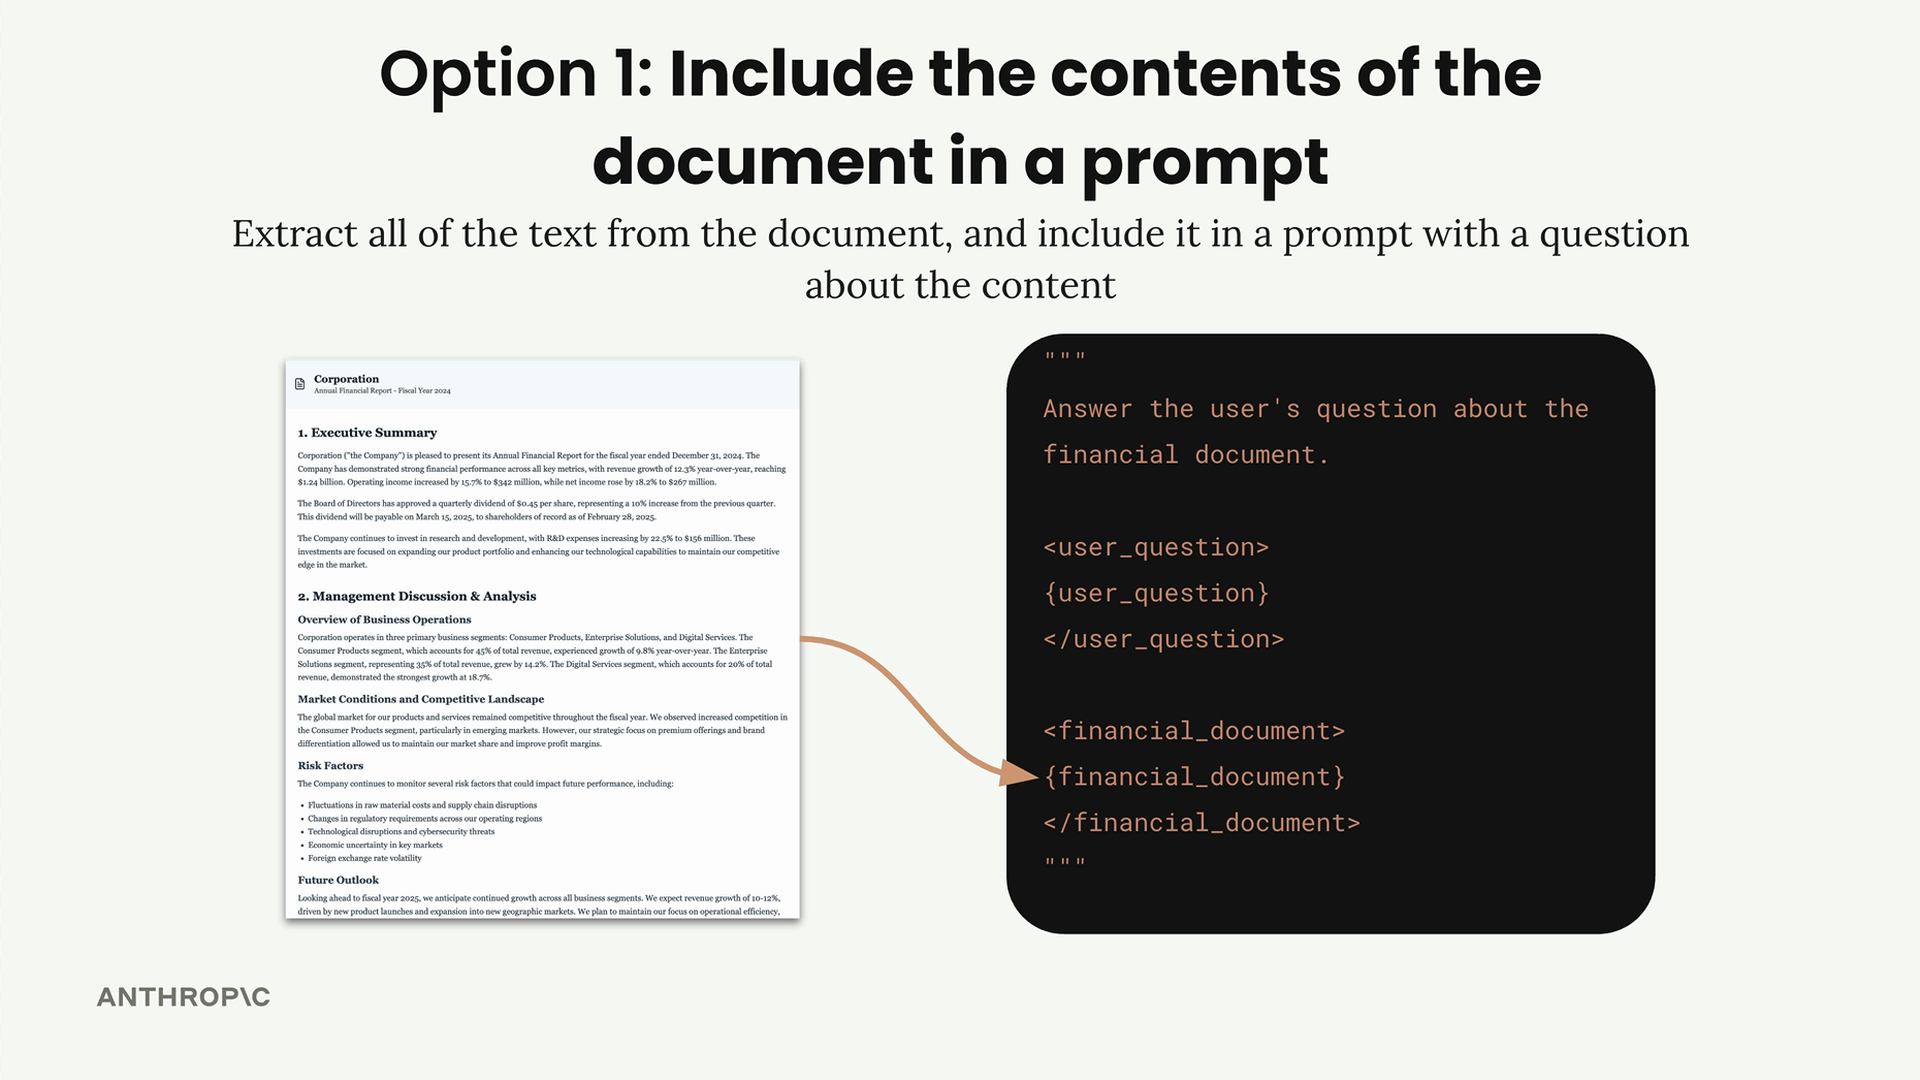
このアプローチにはいくつかの問題があります。
- Claudeが処理できるテキスト量には厳格な上限があるため、文書が長すぎる可能性があります
- Claudeは非常に長いプロンプトでは効果が低下します
- 大きなプロンプトはより多くの費用がかかり、処理にも時間がかかります
オプション2:ドキュメントをチャンクに分割する
2つ目のアプローチはより洗練されています。前処理のステップで文書を小さなチャンクに分割し、各ユーザーの質問に関連するチャンクだけを見つけて含めるというものです。
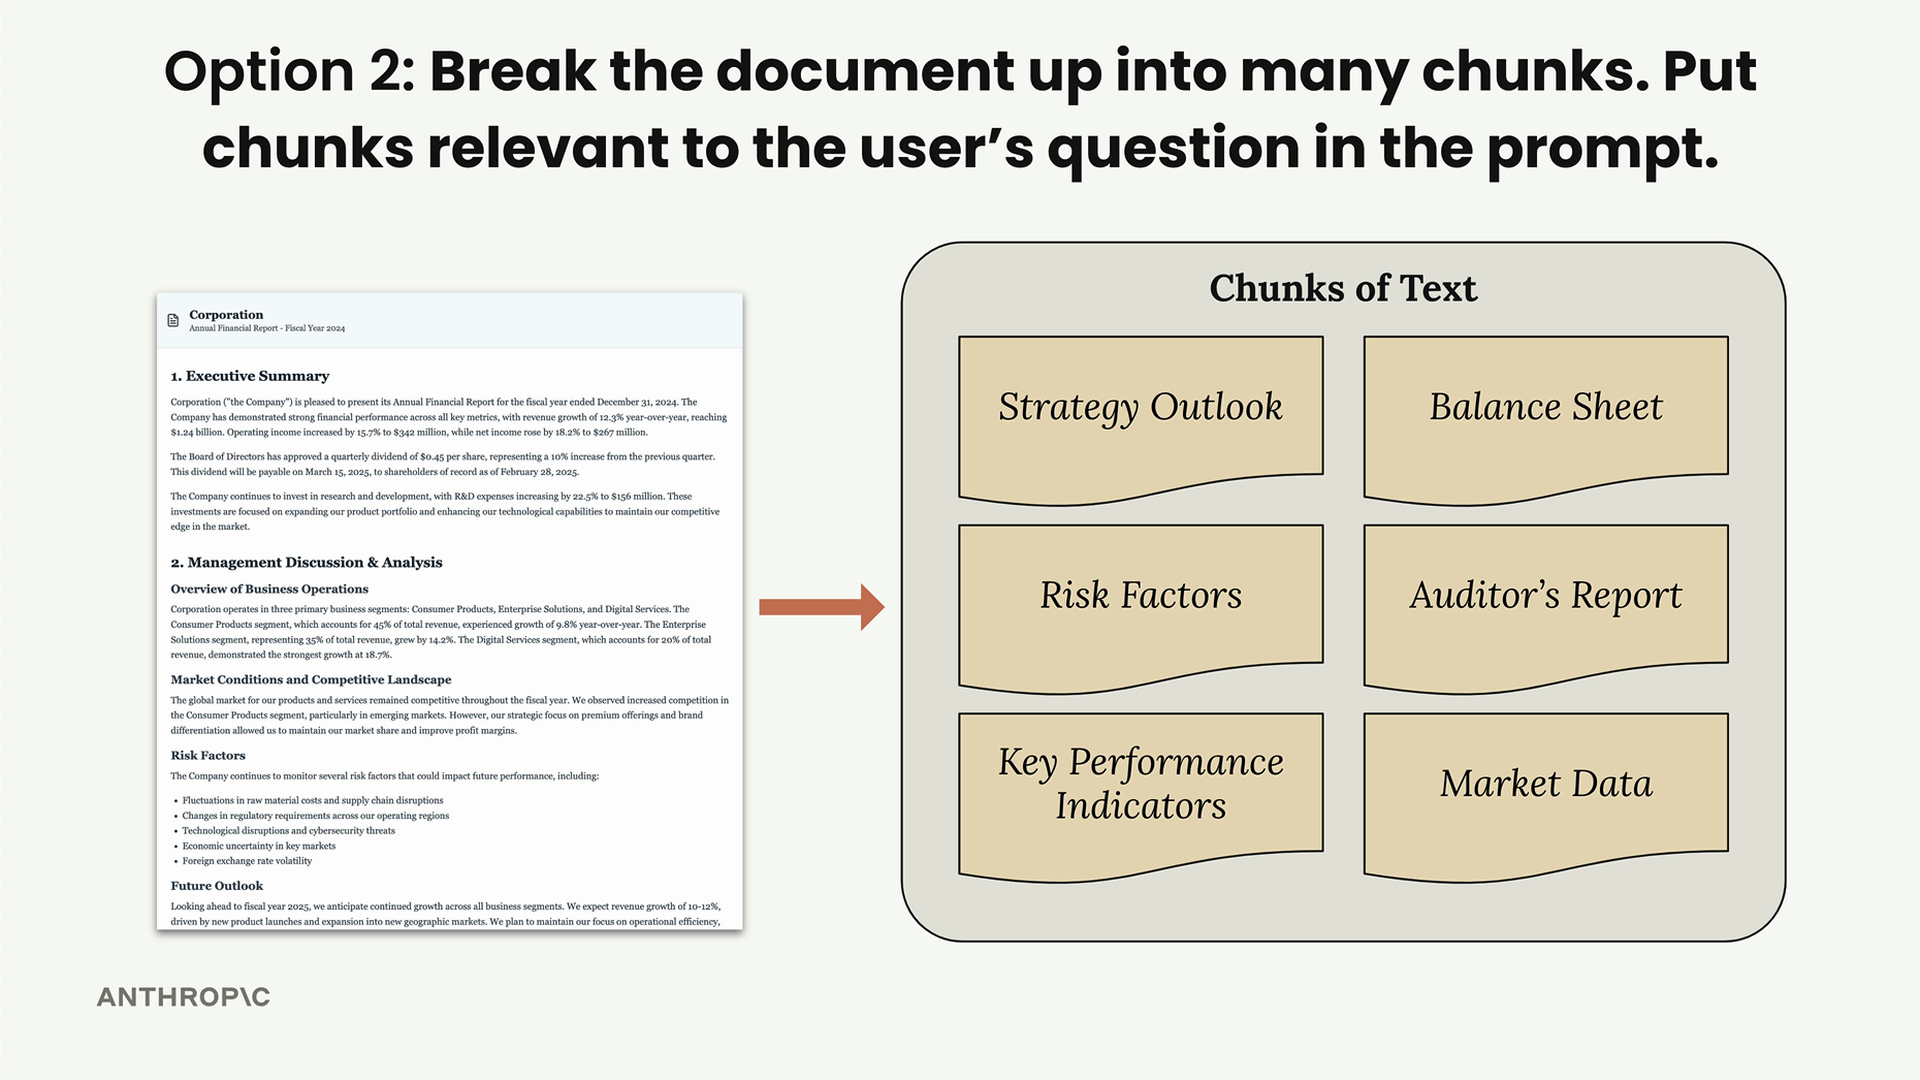
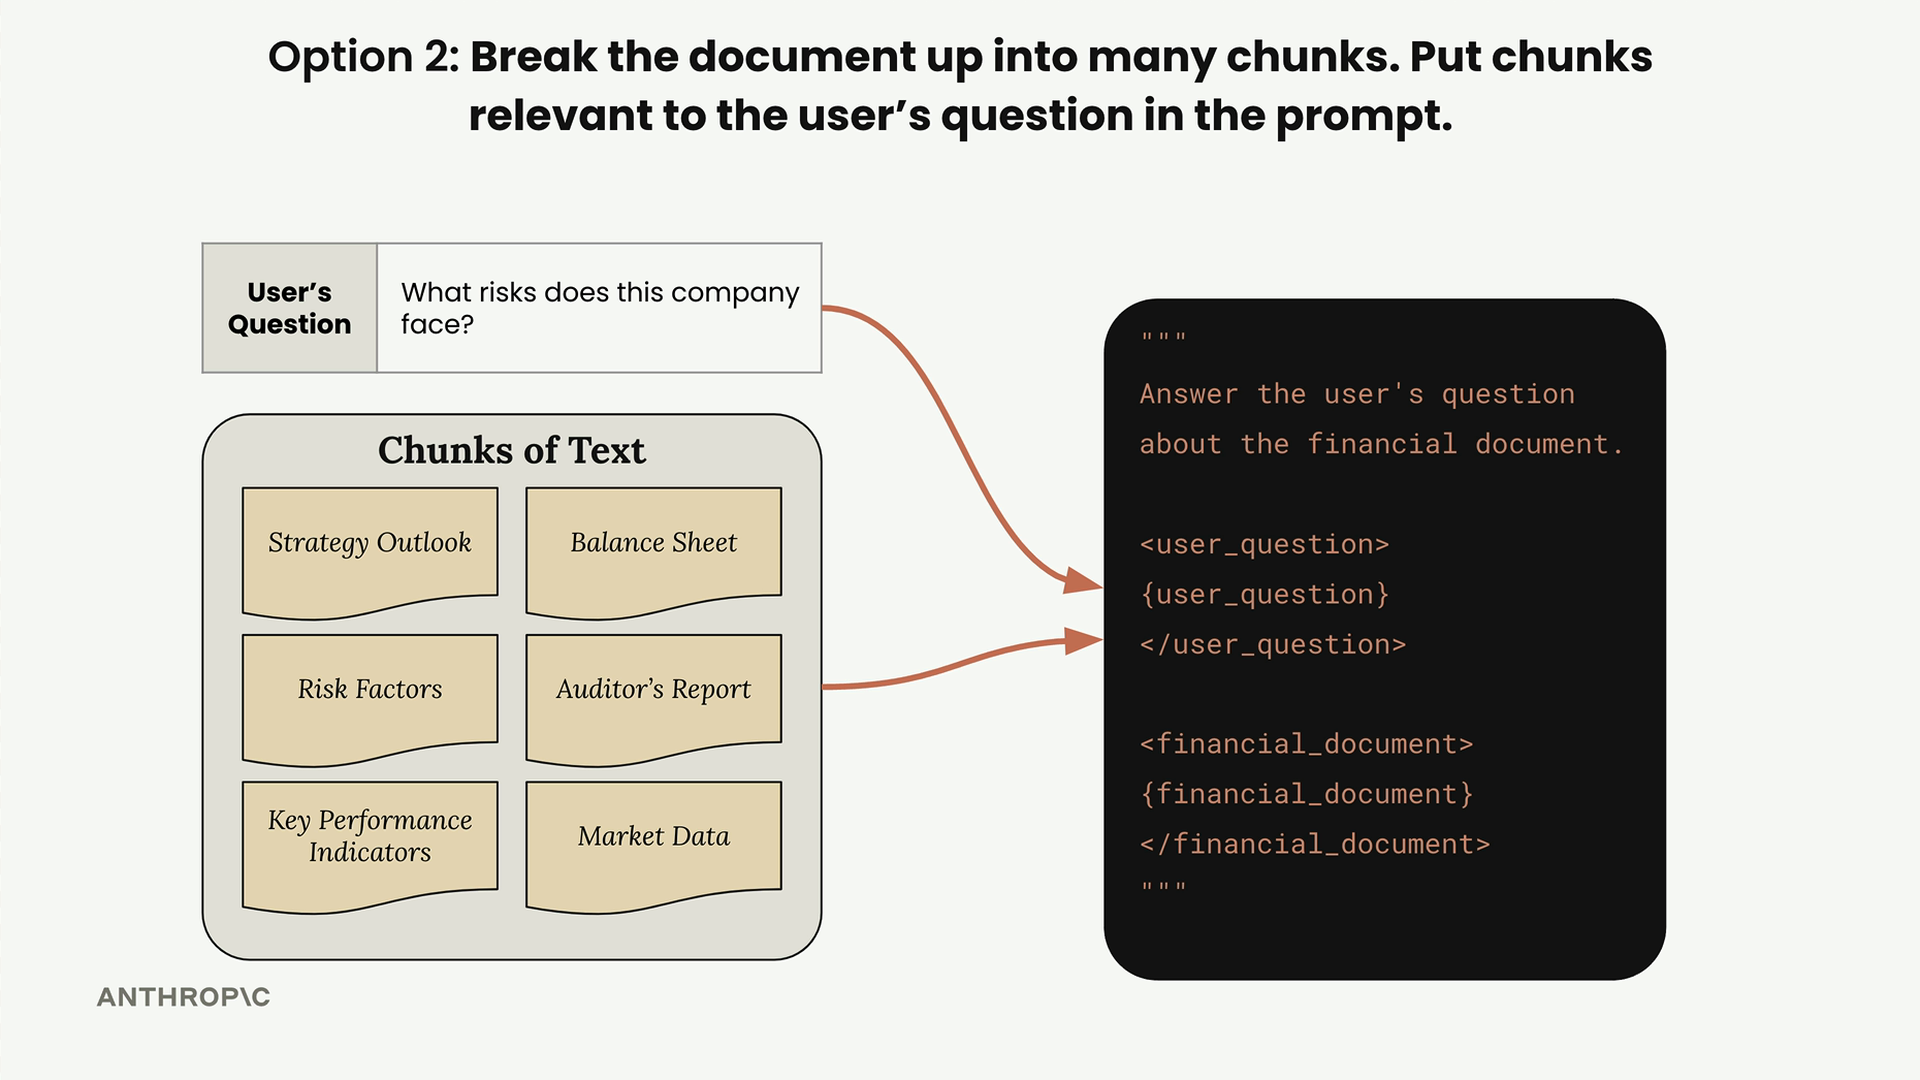
仕組みは次のとおりです。ユーザーが「この会社が直面しているリスクは何ですか?」と尋ねると、チャンクの中から「リスク要因」についてのものを検索して見つけ、そのセクションだけをClaudeへのプロンプトに含めます。
チャンク分割アプローチの利点
- Claudeは最も関連性の高いコンテンツだけに集中できます
- 非常に大規模な文書にも対応できます
- 複数の文書にも対応できます
- プロンプトが小さくなることで、コストが下がり、処理も高速化します
チャンク分割の課題
- 文書を分割するための前処理ステップが必要です
- 「関連性のある」チャンクを見つけるための検索メカニズムが必要です
- 含まれるチャンクには、Claudeが必要とするすべてのコンテキストが含まれていない可能性があります
- テキストをチャンク分割する方法は多数あり、どのアプローチが最適かという問題があります
例えば、「リスク要因」セクションだけを含めた場合、会社がそれらのリスクにどう対処する計画かを扱う「戦略的見通し」セクションの重要なコンテキストを見逃してしまうかもしれません。
これがRAGです
オプション2がRetrieval Augmented Generationです。その複雑さにもかかわらず、RAGは大規模な文書を扱う上で大きな利点をもたらしますが、慎重に検討すべき技術的課題も伴います。
RAGの主要な構成要素は次のとおりです。
- 文書の前処理とチャンク分割
- 関連するチャンクを見つけるための検索メカニズム
- プロンプトに含めるチャンクのインテリジェントな選択
アプリケーションにRAGを採用するかどうかを検討する際は、自社のユースケースにおいて、その利点が追加される複雑さに見合うかどうかを評価する必要があります。このテクニックは、正確でコンテキストに即した回答が必要な大規模な文書コレクションを扱う場合に真価を発揮しますが、単に文書全体をプロンプトに含めるよりも多くの事前のエンジニアリング作業を必要とします。