より良いプロンプトを作成することに加えて、Claudeの出力を制御する2つの強力なテクニックがあります。それがプリフィルされたアシスタントメッセージとストップシーケンスです。これらの手法により、Claudeがどのように応答し、いつテキストの生成を停止するかを精密に制御できます。
プリフィルされたアシスタントメッセージ
メッセージのプリフィルを使用すると、Claudeの応答の冒頭部分を自分で用意でき、Claudeはその開始点から続きを生成します。このテクニックは、Claudeを特定の方向に誘導する際に非常に役立ちます。
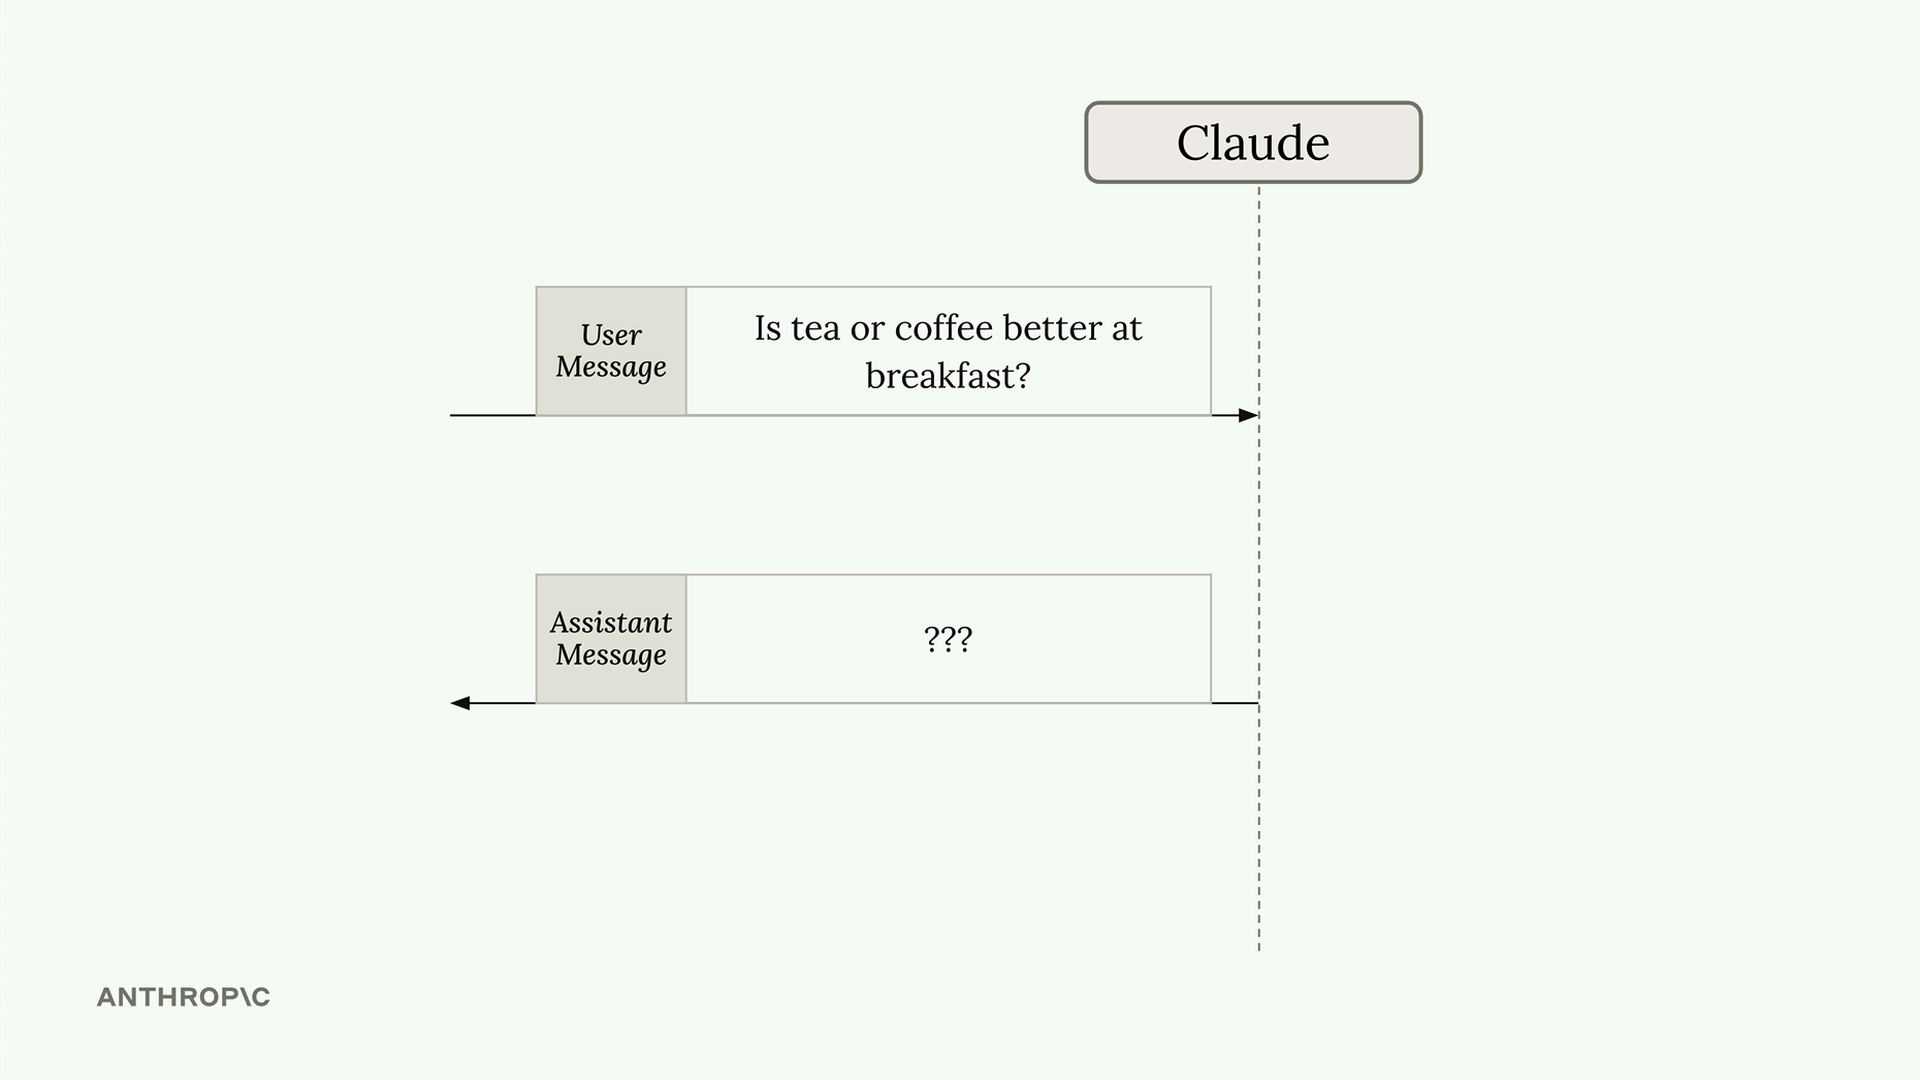
仕組みは次の通りです。ユーザーメッセージを送るだけでなく、メッセージリストの最後にアシスタントメッセージを追加します。Claudeはこのアシスタントメッセージを見て、「この質問への応答をすでに開始しているので、続きから生成すべきだ」と考えます。
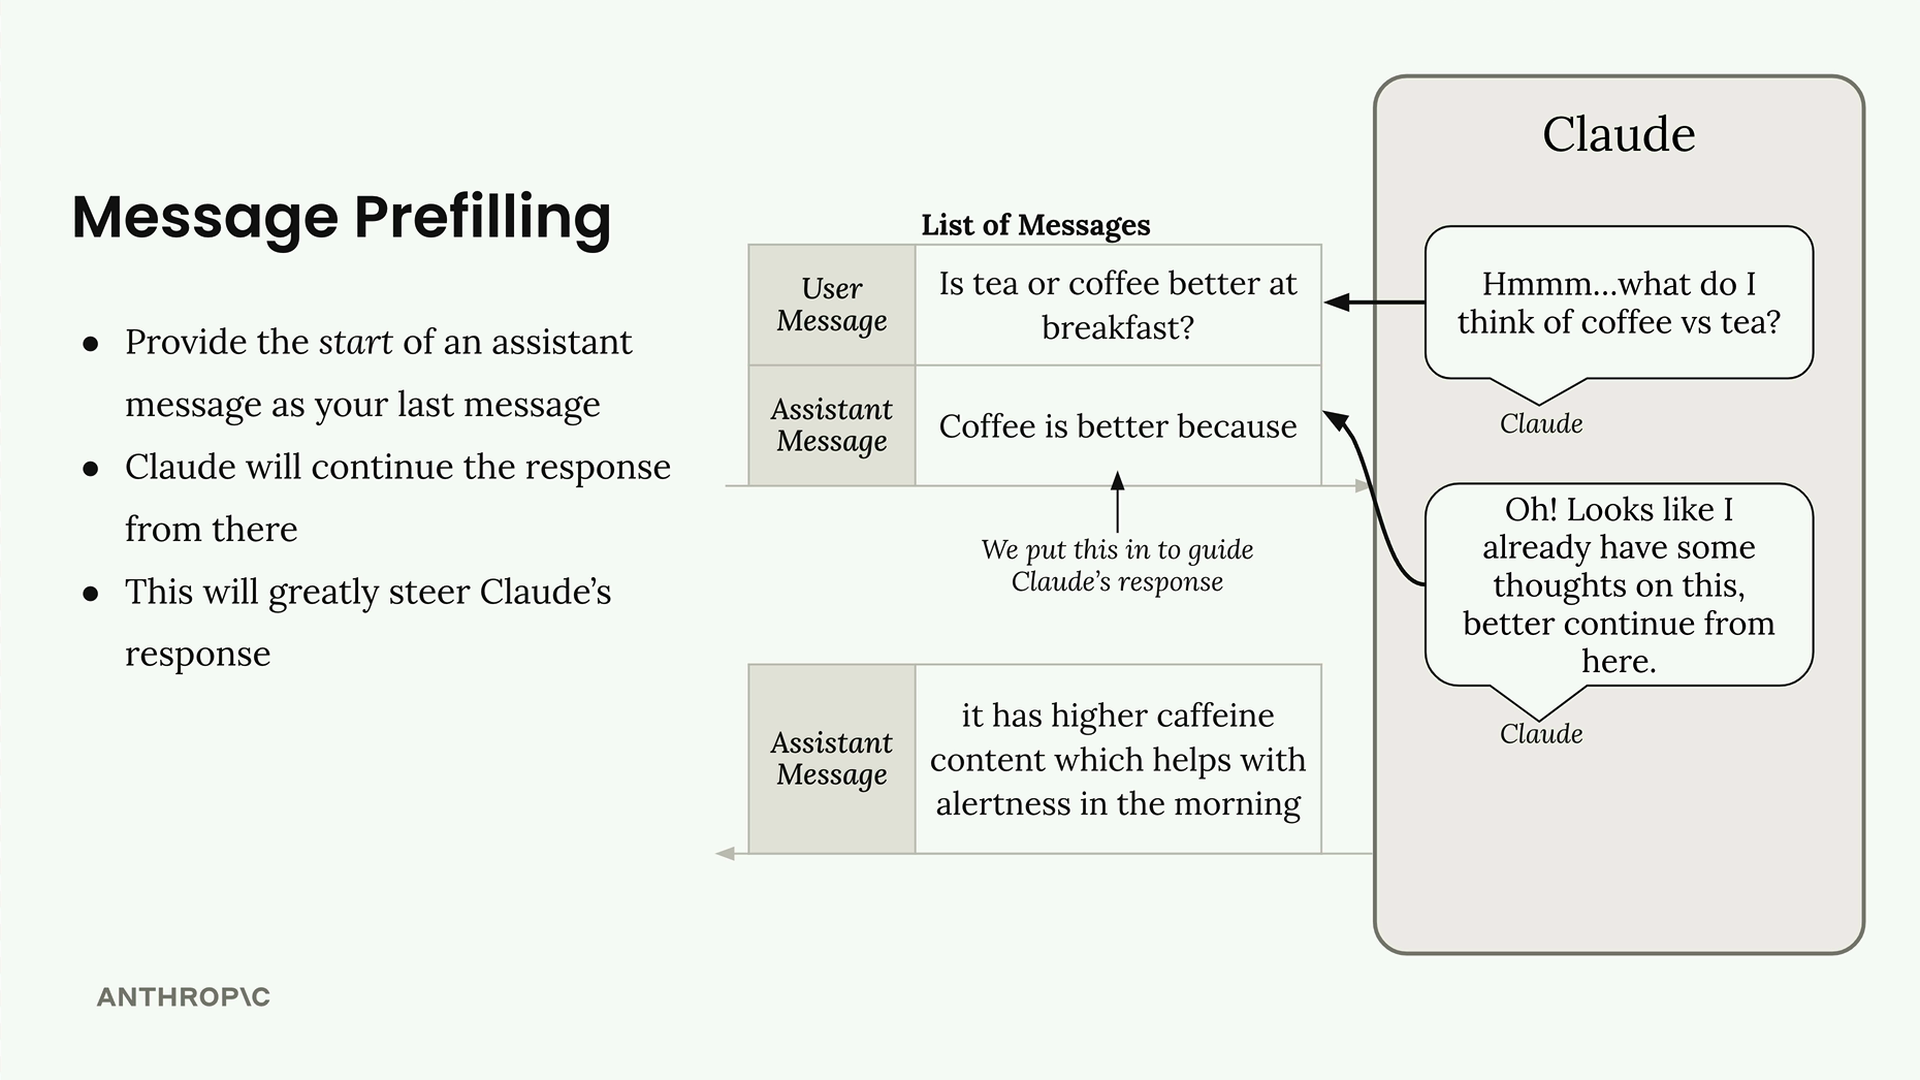
例えば、「Is tea or coffee better at breakfast?」と尋ねて、プリフィルをしない場合、Claudeは通常、両方の選択肢に言及するバランスの取れた応答をします。しかし、「Coffee is better because」というアシスタントメッセージを追加すると、Claudeはそこから続きを生成し、コーヒーを支持する論拠を組み立てます。
ここで理解しておくべき重要な点は、Claudeはプリフィルされたテキストが終わるちょうどその場所から続きを生成するということです。「Coffee is better because」と書いた場合、Claudeはそのテキストを繰り返さず、「because」の直後から続けて考えを完結させます。
コードの構造は次の通りです。
messages = []
add_user_message(messages, "Is tea or coffee better at breakfast?")
add_assistant_message(messages, "Coffee is better because")
answer = chat(messages)
このテクニックを使えば、Claudeを任意の方向に誘導できます。
- コーヒーを支持する場合: 「Coffee is better because」
- 紅茶を支持する場合: 「Tea is better because」
- あえて反対の立場を取る場合: 「Neither is very good because」
ストップシーケンス
ストップシーケンスは、Claudeが特定の文字列を生成した時点で応答を直ちに終了させるものです。これは応答の長さや終端を制御するのに最適です。
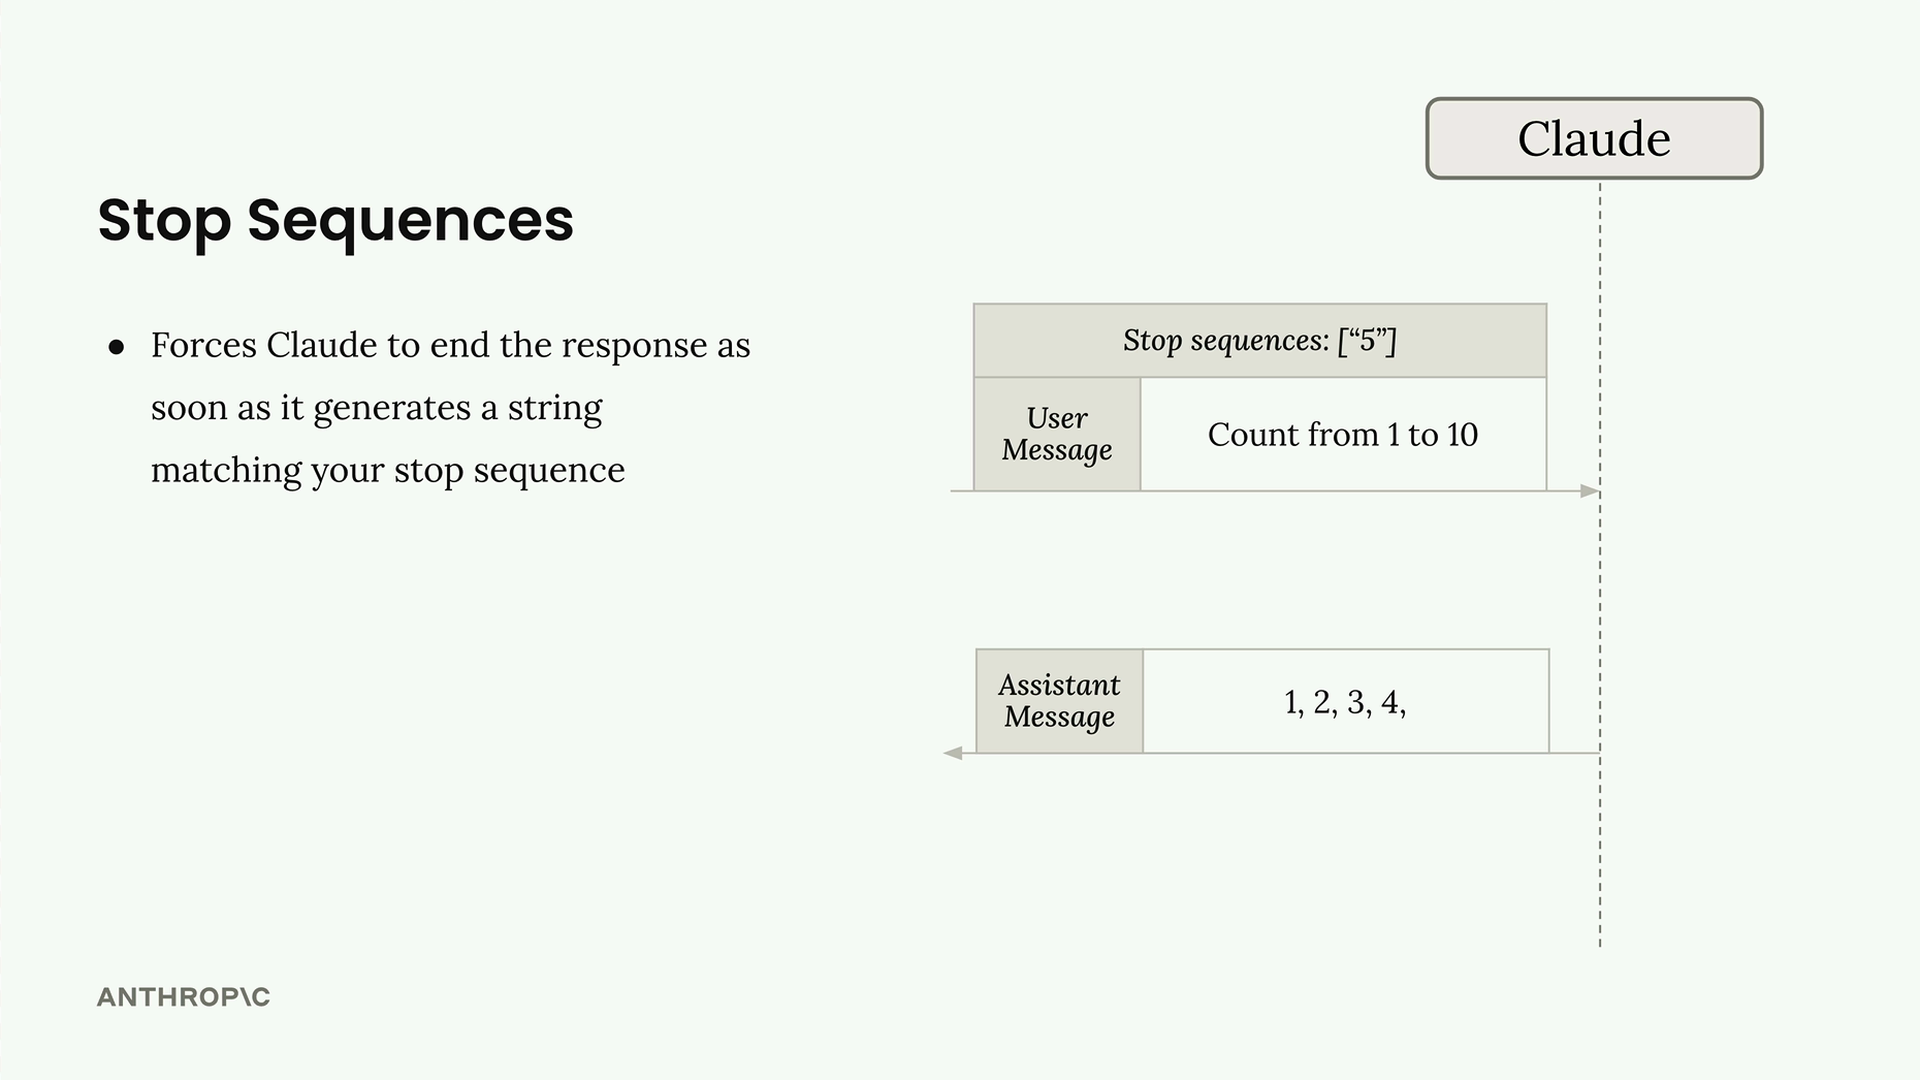
この概念は単純です。文字列のリストを指定し、Claudeがそれらの文字列のいずれかを生成すると、その時点で直ちに停止し、そこまでに生成した内容を返します。
ストップシーケンスを使用するには、chat 関数がそれらのリストを受け取るようにします。
def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    message = client.messages.create(**params)
    return message.content[0].text
例えば、ストップシーケンスを「5」に設定して、Claudeに「Count from 1 to 10」と指示してみます。
add_user_message(messages, "Count from 1 to 10")
answer = chat(messages, stop_sequences=["5"])
これは「1, 2, 3, 4, 」を返します。出力に「5」が含まれる直前で停止しています。
ストップシーケンスはさらに精密に指定することもできます。末尾のカンマとスペースを避けたい場合は、代わりに stop_sequences=[", 5"] を使用してください。これにより、よりすっきりした結果「1, 2, 3, 4」が得られます。
ストップシーケンスは特に以下のような場合に役立ちます。
- リストの長さを制限する
- 特定のマーカーや区切り文字で停止する
- 一貫性のある出力形式を作成する
- 過度に長い応答を防ぐ
これら2つのテクニックにより、Claudeの動作をきめ細かく制御でき、アプリケーションにおいてより予測可能で的を絞った応答を作成できるようになります。