カスタムプロンプト評価ワークフローの構築は、しっかりとしたプロンプトを作成し、その後テストデータを生成してパフォーマンスを確認することから始まります。ユーザーがAWS固有のコードを書くのを支援するプロンプトの評価システムを設定する手順を見ていきましょう。
ゴールの設定
私たちのプロンプトは、AWSのユースケースに対して3種類の特定の出力を書く際にユーザーを支援する必要があります。
- Pythonコード
- JSON設定ファイル
- 正規表現
重要な要件は、ユーザーがタスクの支援を求めたとき、余計な説明やヘッダー、フッターなしに、これらの形式のいずれかでクリーンな出力を返すことです。
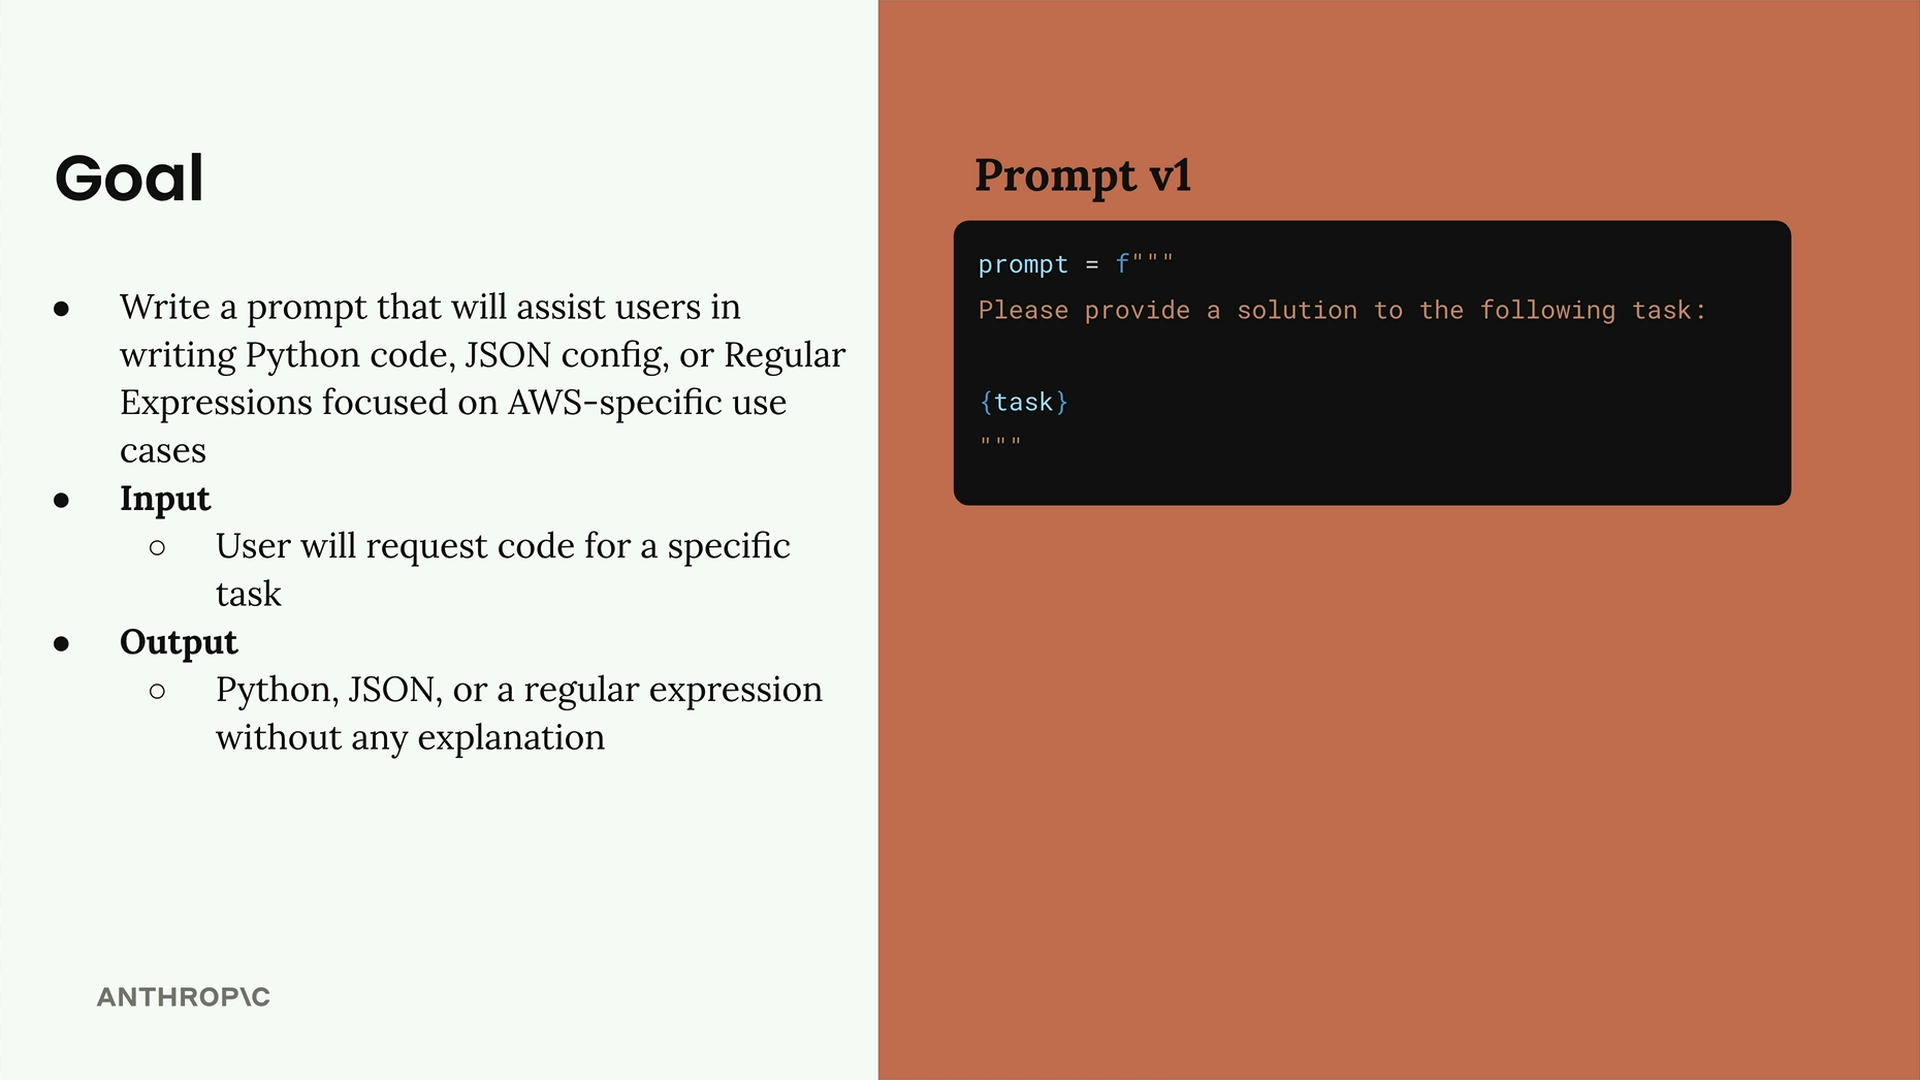
こちらが最初のプロンプトテンプレートです。
prompt = f"""
Please provide a solution to the following task:
{task}
"""
評価用データセットの作成
評価用データセットには、プロンプトのパフォーマンスをテストするために投入する入力が含まれています。今回のケースでは、各オブジェクトにClaudeに達成してほしいことを記述する「task」プロパティを持つ、JSONオブジェクトの配列が必要です。
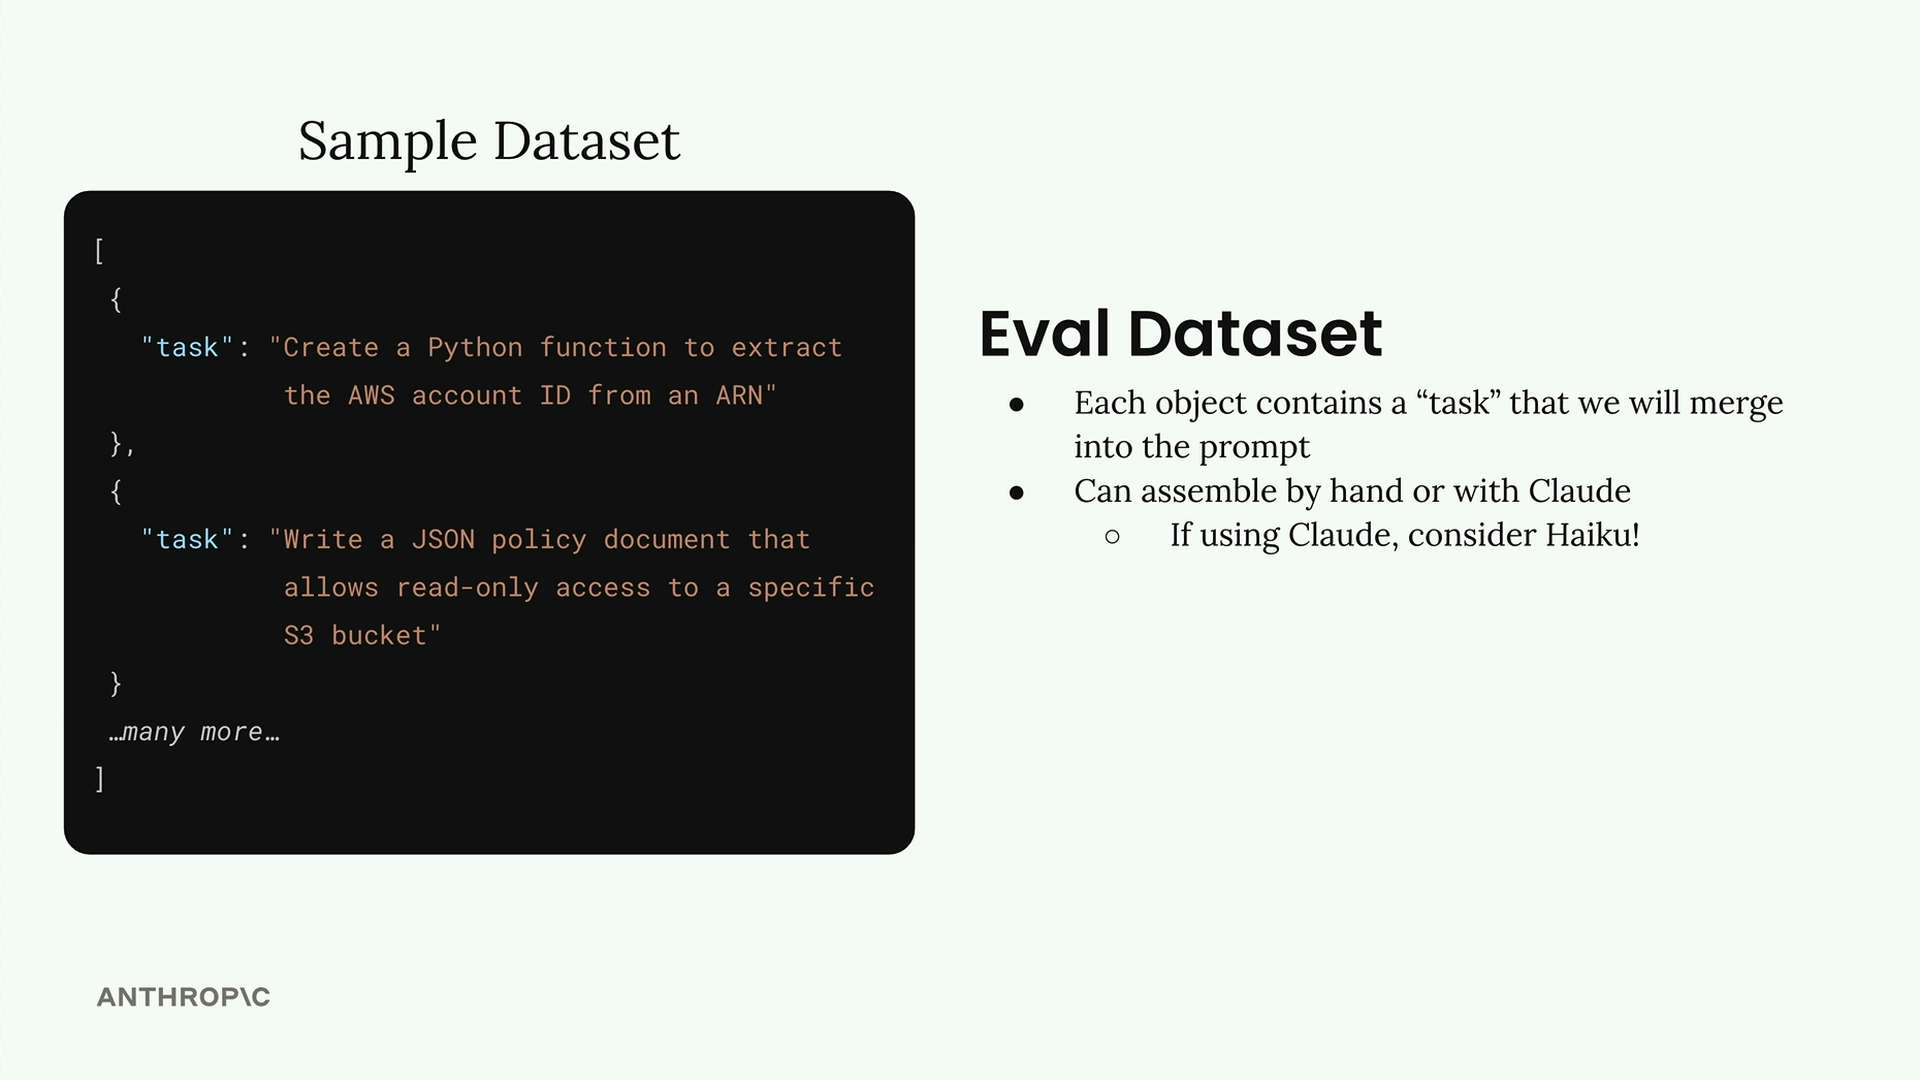
データセットの作成方法は2通りあります。
- 手動で組み立てる
- Claudeを使って自動生成する
自動生成の場合、テストデータを生成しているだけで本番用の出力ではないため、Haikuのような高速なモデルを使うのが理にかなっています。
コードによるテストデータの生成
Claudeにテストケースを生成するよう依頼する関数を構築しましょう。この関数は、AWS関連の特定の種類のタスクをリクエストする包括的なプロンプトを作成します。
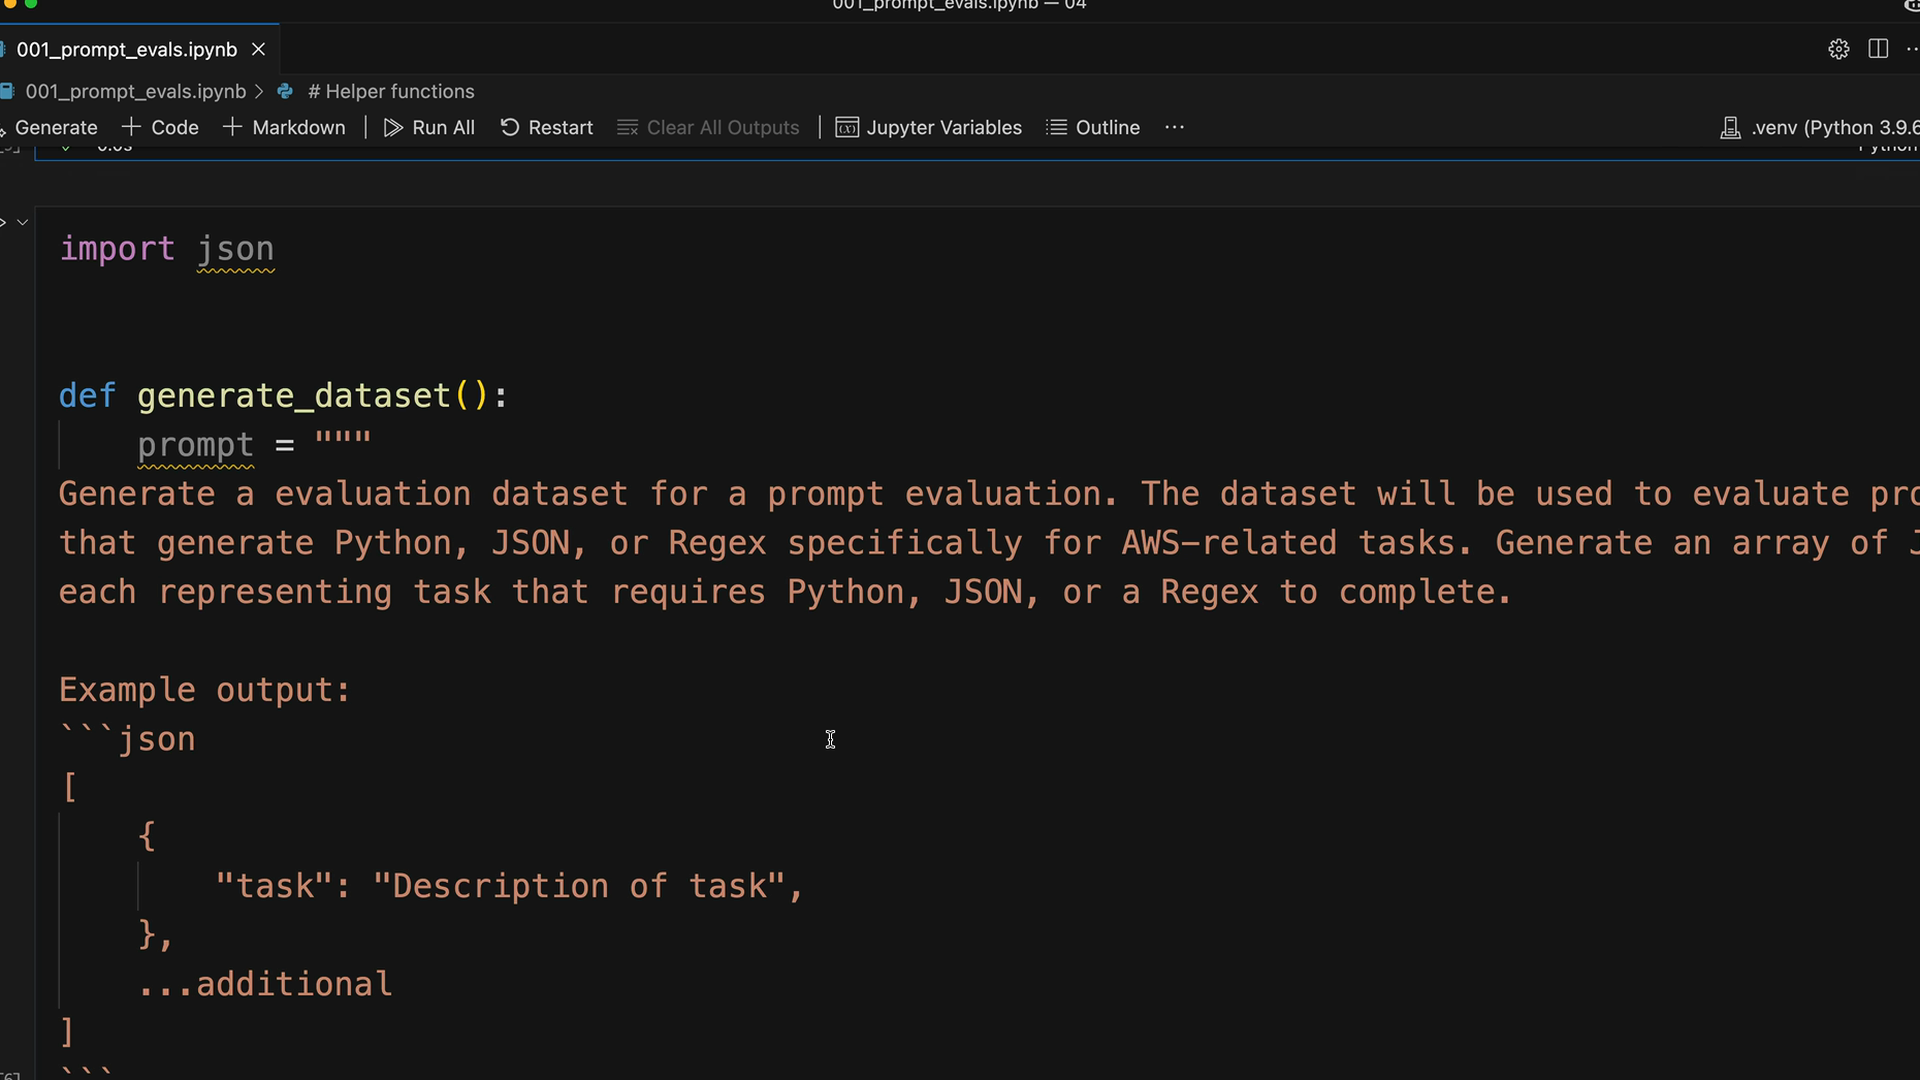
こちらがコアとなる関数構造です。
def generate_dataset():
    prompt = """
    Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts
    that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of objects,
    each representing task that requires Python, JSON, or a Regex to complete.

    Example output:
    ```json
    [
        {
            "task": "Description of task",
        },
        ...additional
    ]
    ```

    * Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
    * Focus on tasks that do not require writing much code

    Please generate 3 objects.
    """
生成ロジックの実装
Claudeからクリーンなjson出力を得るために、stop sequenceを使ったプレフィル技法を使用します。
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
このアプローチにより、Claudeは適切にフォーマットされたJSONでレスポンスを開始し、閉じるマークダウンのフェンスで停止することが保証されます。
データセットのテストと保存
生成関数を実行した後、以下のような現実的なテストケースが返されるはずです。
- ARNからAWSリージョンを抽出するPython関数を作成する
- AWS Lambda関数のJSON設定を書く
- AWS S3バケット名を検証する正規表現を作成する
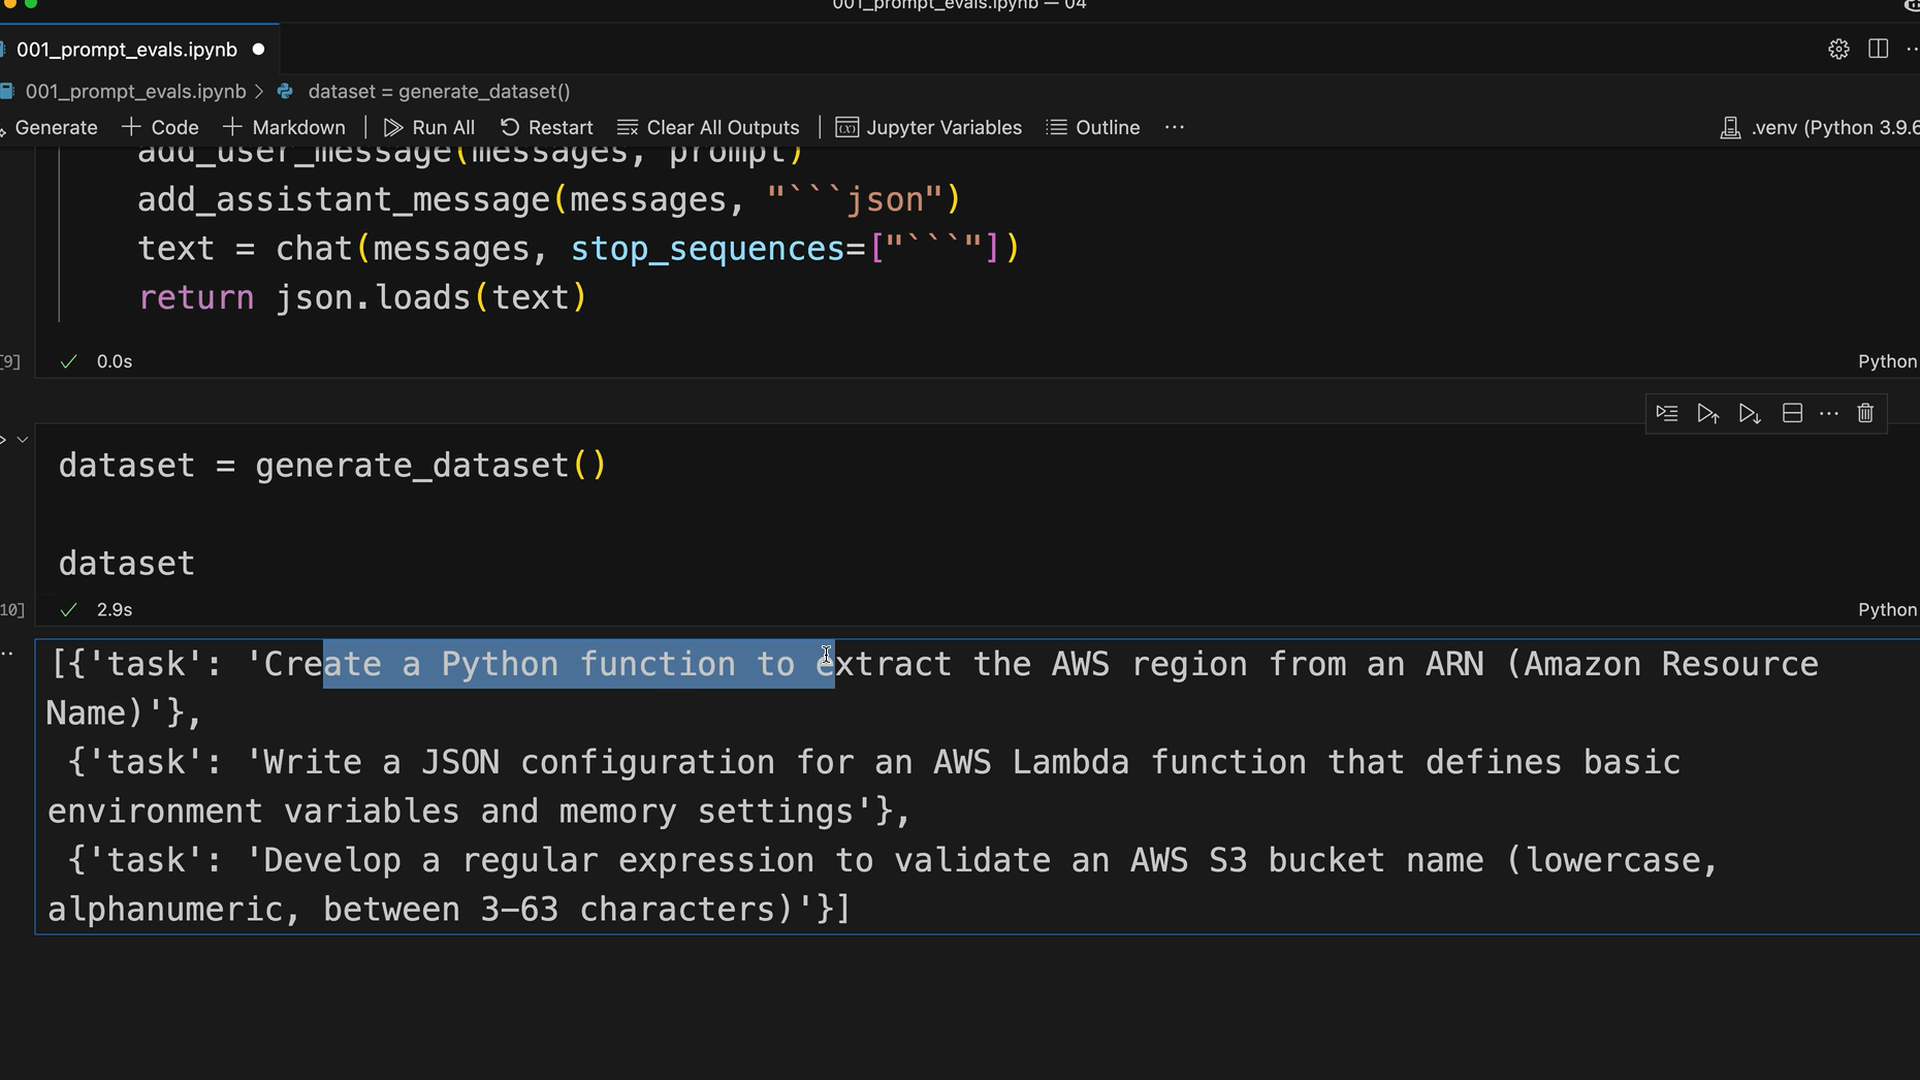
生成したデータセットを簡単に再利用できるようファイルに保存します。
dataset = generate_dataset()

with open('dataset.json', 'w') as f:
json.dump(dataset, f, indent=2)これにより、ノートブックディレクトリ内にすべてのテストケースを含むdataset.jsonファイルが作成され、ワークフローの次のステップでプロンプト評価に使用する準備が整います。