典型的なプロンプト評価ワークフローは、客観的な測定を通じてプロンプトを体系的に改善するのに役立つ5つの重要なステップに従います。これらのワークフローを構築する方法は多岐にわたり、さまざまなオープンソースおよび有料のツールが利用可能ですが、中核となるプロセスを理解しておくことで、小さく始めて必要に応じて拡大していくことができます。
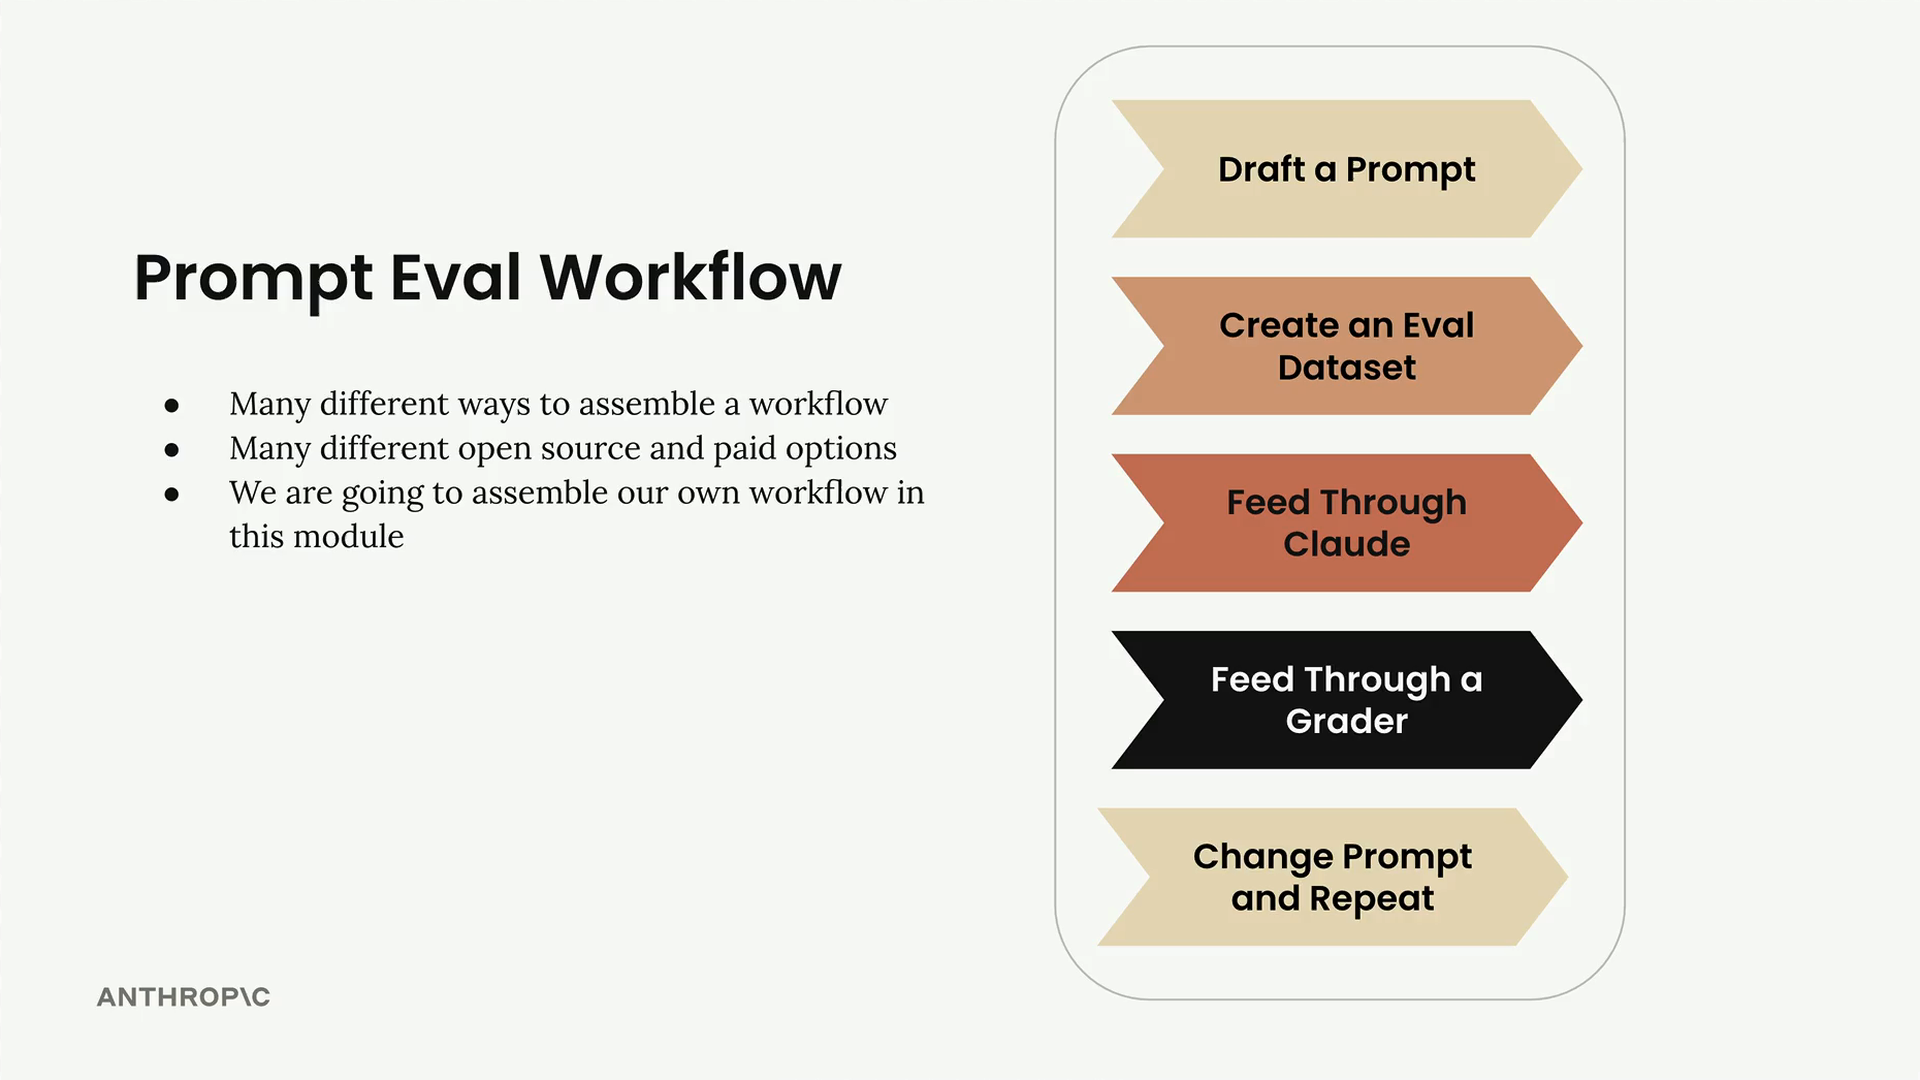
ステップ1:プロンプトを起草する
改善したい初期プロンプトを作成することから始めます。この例では、シンプルなプロンプトを使用します。
prompt = f"""
Please answer the user's question:

{question}
"""
このシンプルなプロンプトが、テストと改善のためのベースラインとして機能します。
ステップ2:評価データセットを作成する
評価データセットには、プロンプトに入力するサンプル入力が含まれます。私たちのプロンプトには入力が1つ(ユーザーの質問)しかないため、テストに使用するさまざまな質問のコレクションが必要です。
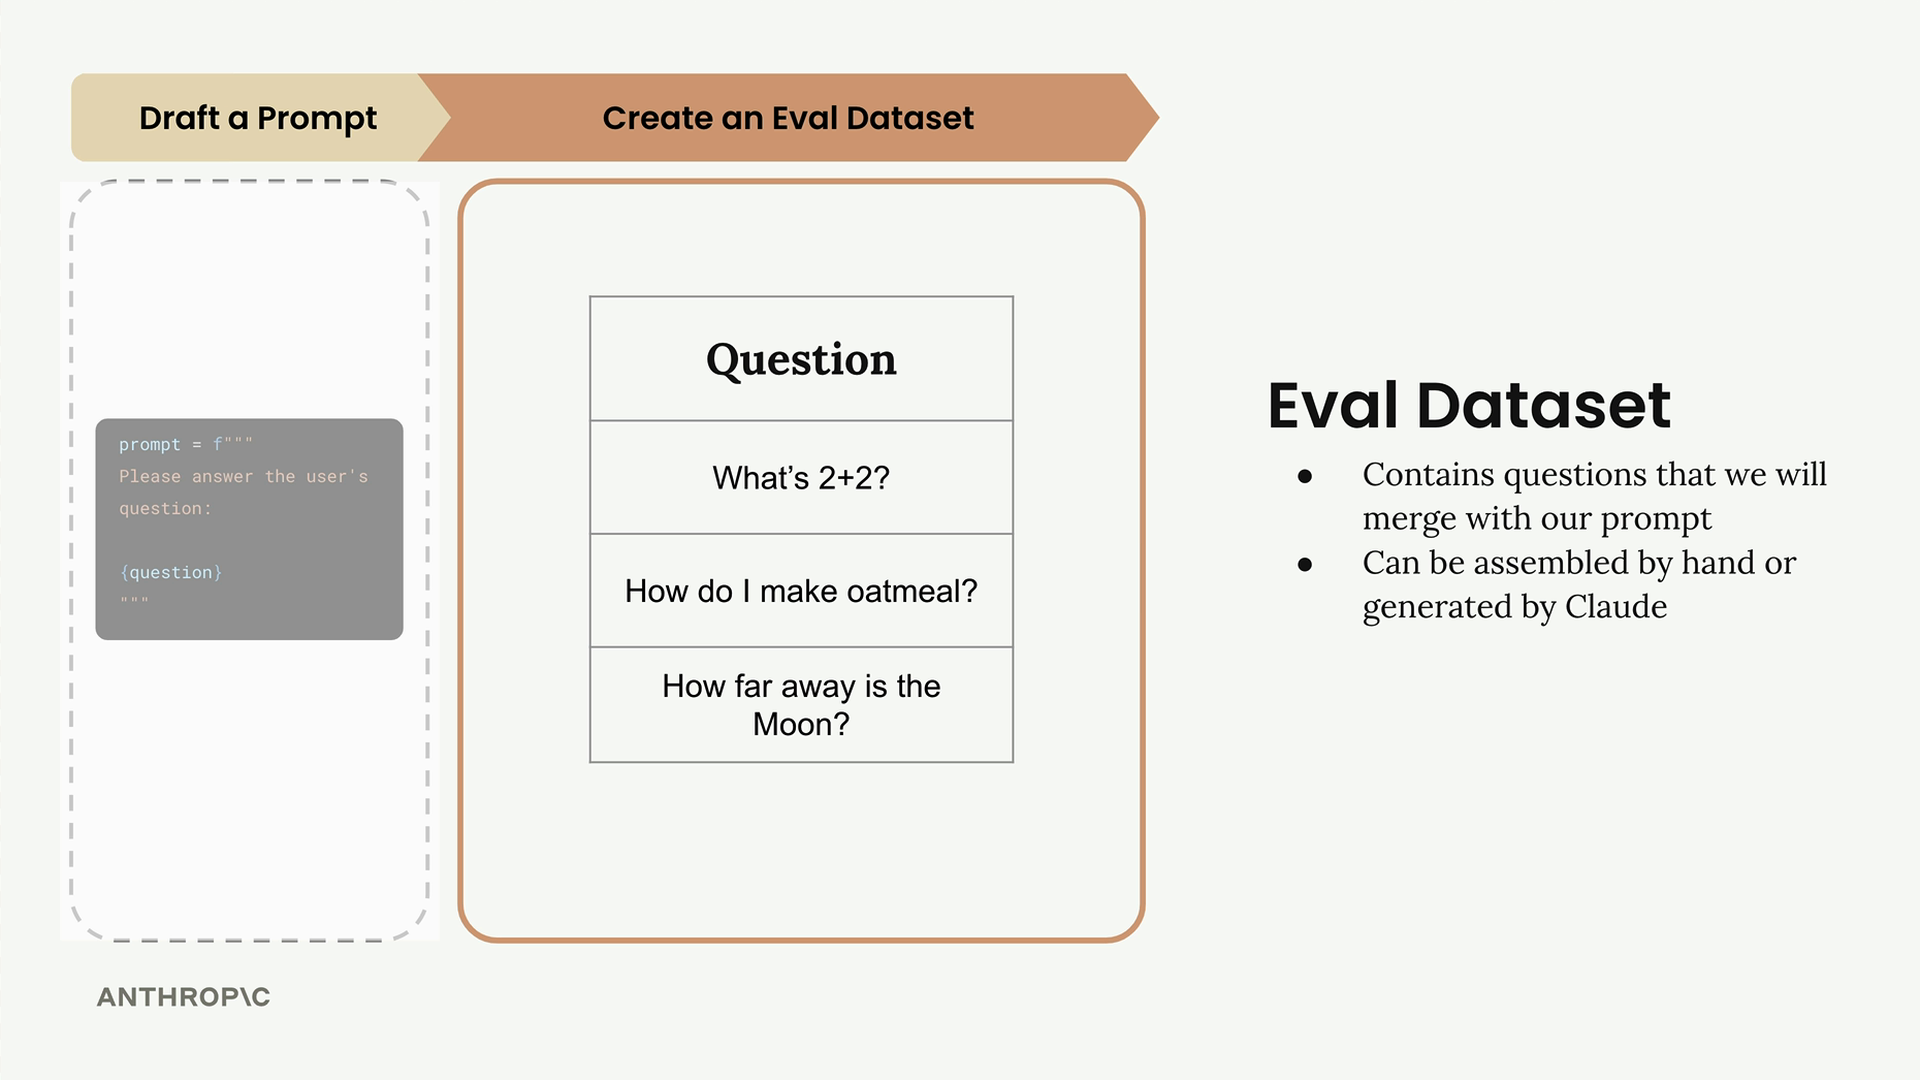
データセットには、プロンプトとマージする質問が含まれています。これらのデータセットは手作業で作成することも、Claudeを使って生成することもできます。実際の評価では、数十、数百、あるいは数千もの異なるレコードがあるかもしれませんが、この例では3つの質問から始めます。
- What's 2+2?
- How do I make oatmeal?
- How far away is the Moon?
ステップ3:Claudeに通す
データセットから各質問を取り出し、プロンプトテンプレートとマージして完全なプロンプトを作成します。そして、それぞれをClaudeに送信し、応答を収集します。
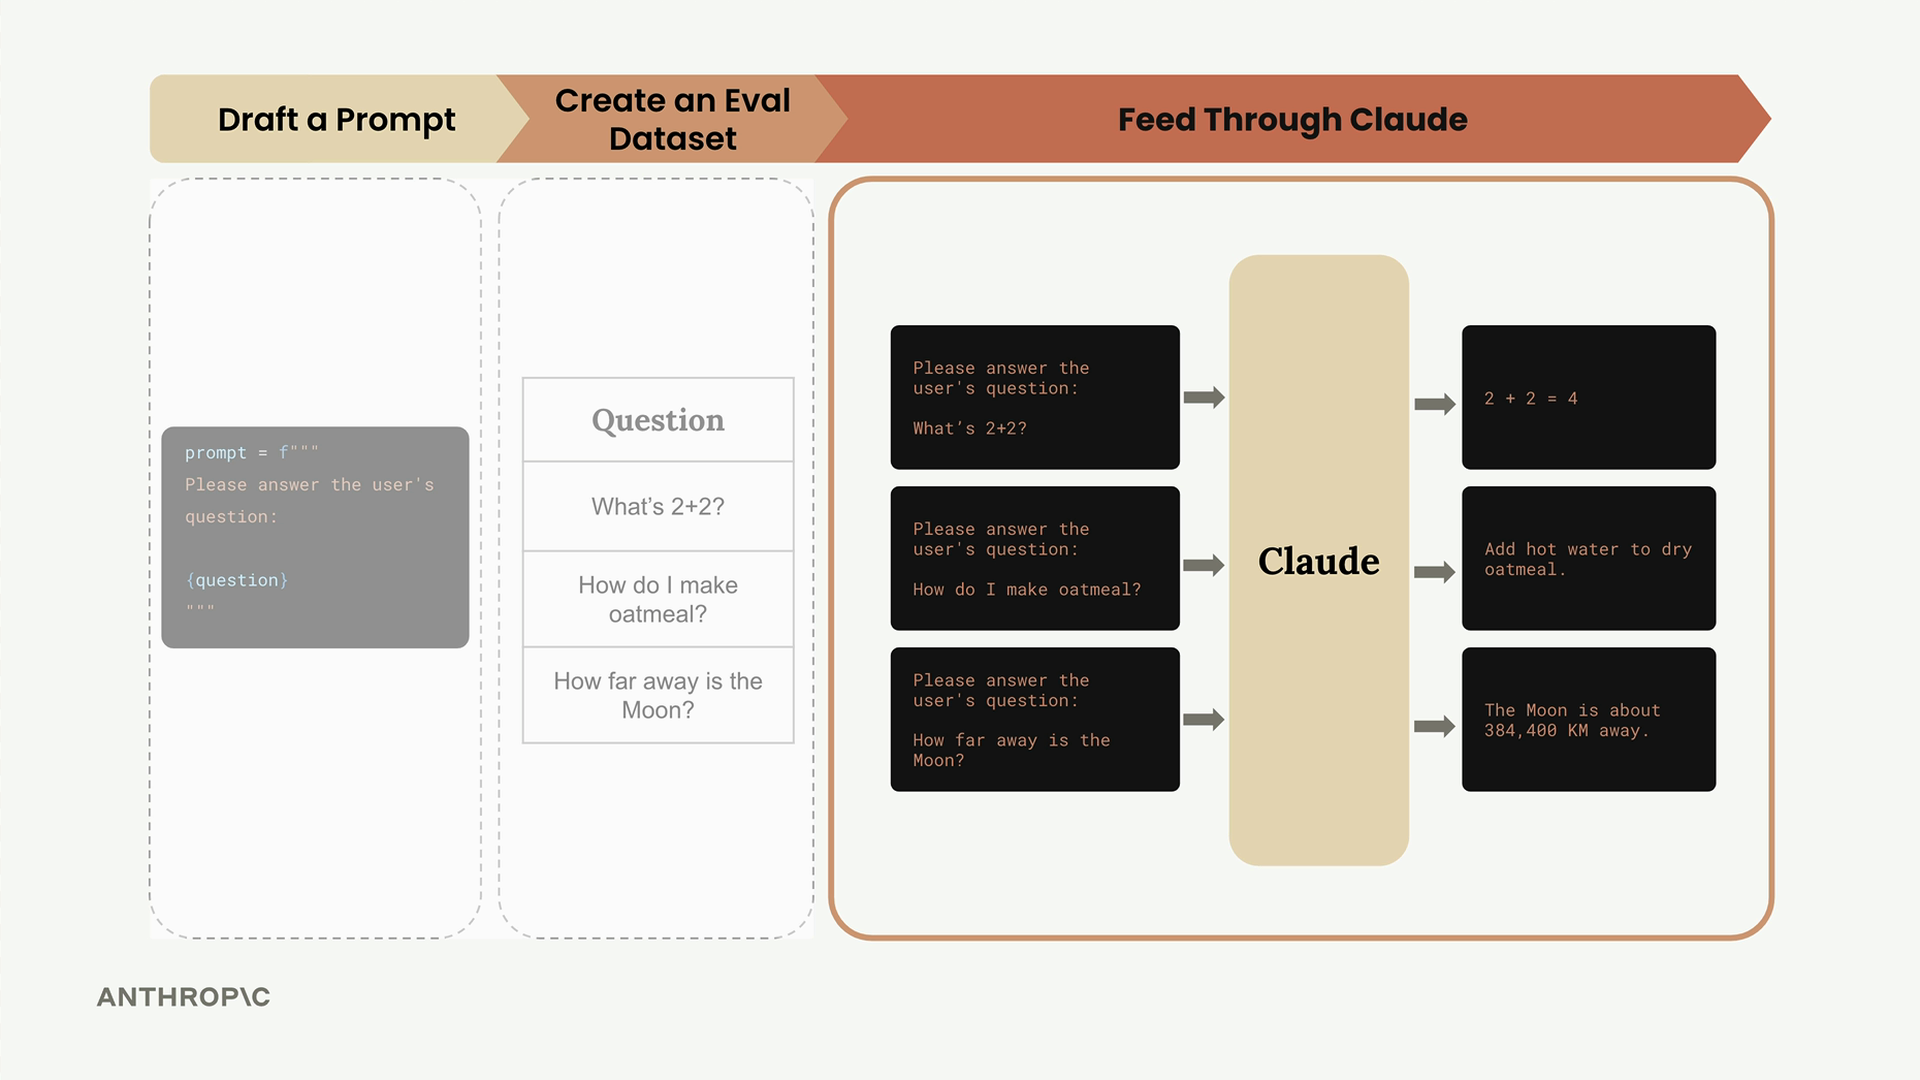
例えば、最初の質問は完全なプロンプトとなり、Claudeがそれを処理して「2 + 2 = 4」のような答えを返します。データセット内のすべての質問についてこのプロセスを繰り返し、質問と回答のペアのコレクションを構築します。
ステップ4:グレーダーに通す
ここで、Claudeの応答の品質を客観的に測定するという重要なステップが登場します。質問と回答のペアをそれぞれ取り出し、応答を採点するグレーダーに入力します。
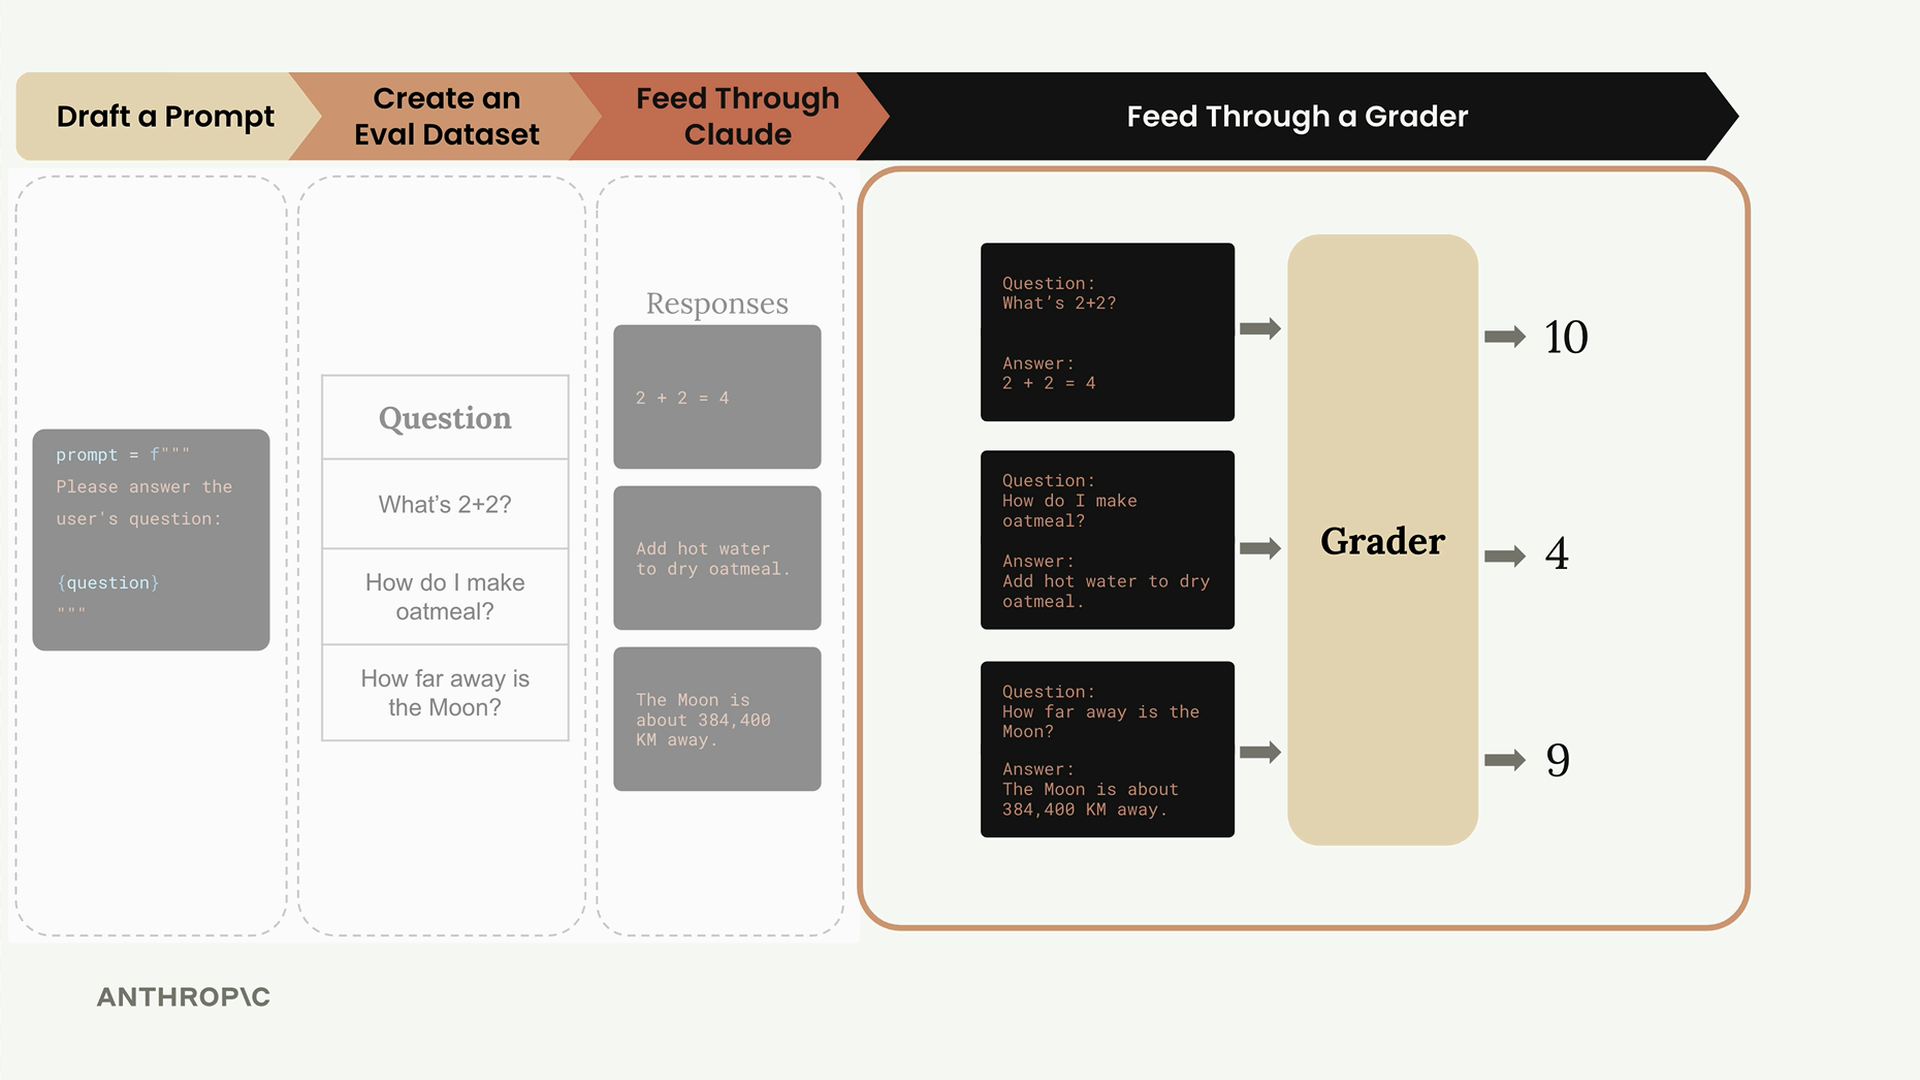
グレーダーは回答の品質に基づいて(通常1〜10の)スコアを割り当てます。
- 10 = 改善の余地がない完璧な回答
- 4 = 妥当ではあるが明らかに改善の余地がある
- それより低いスコアは質の低い応答を示す
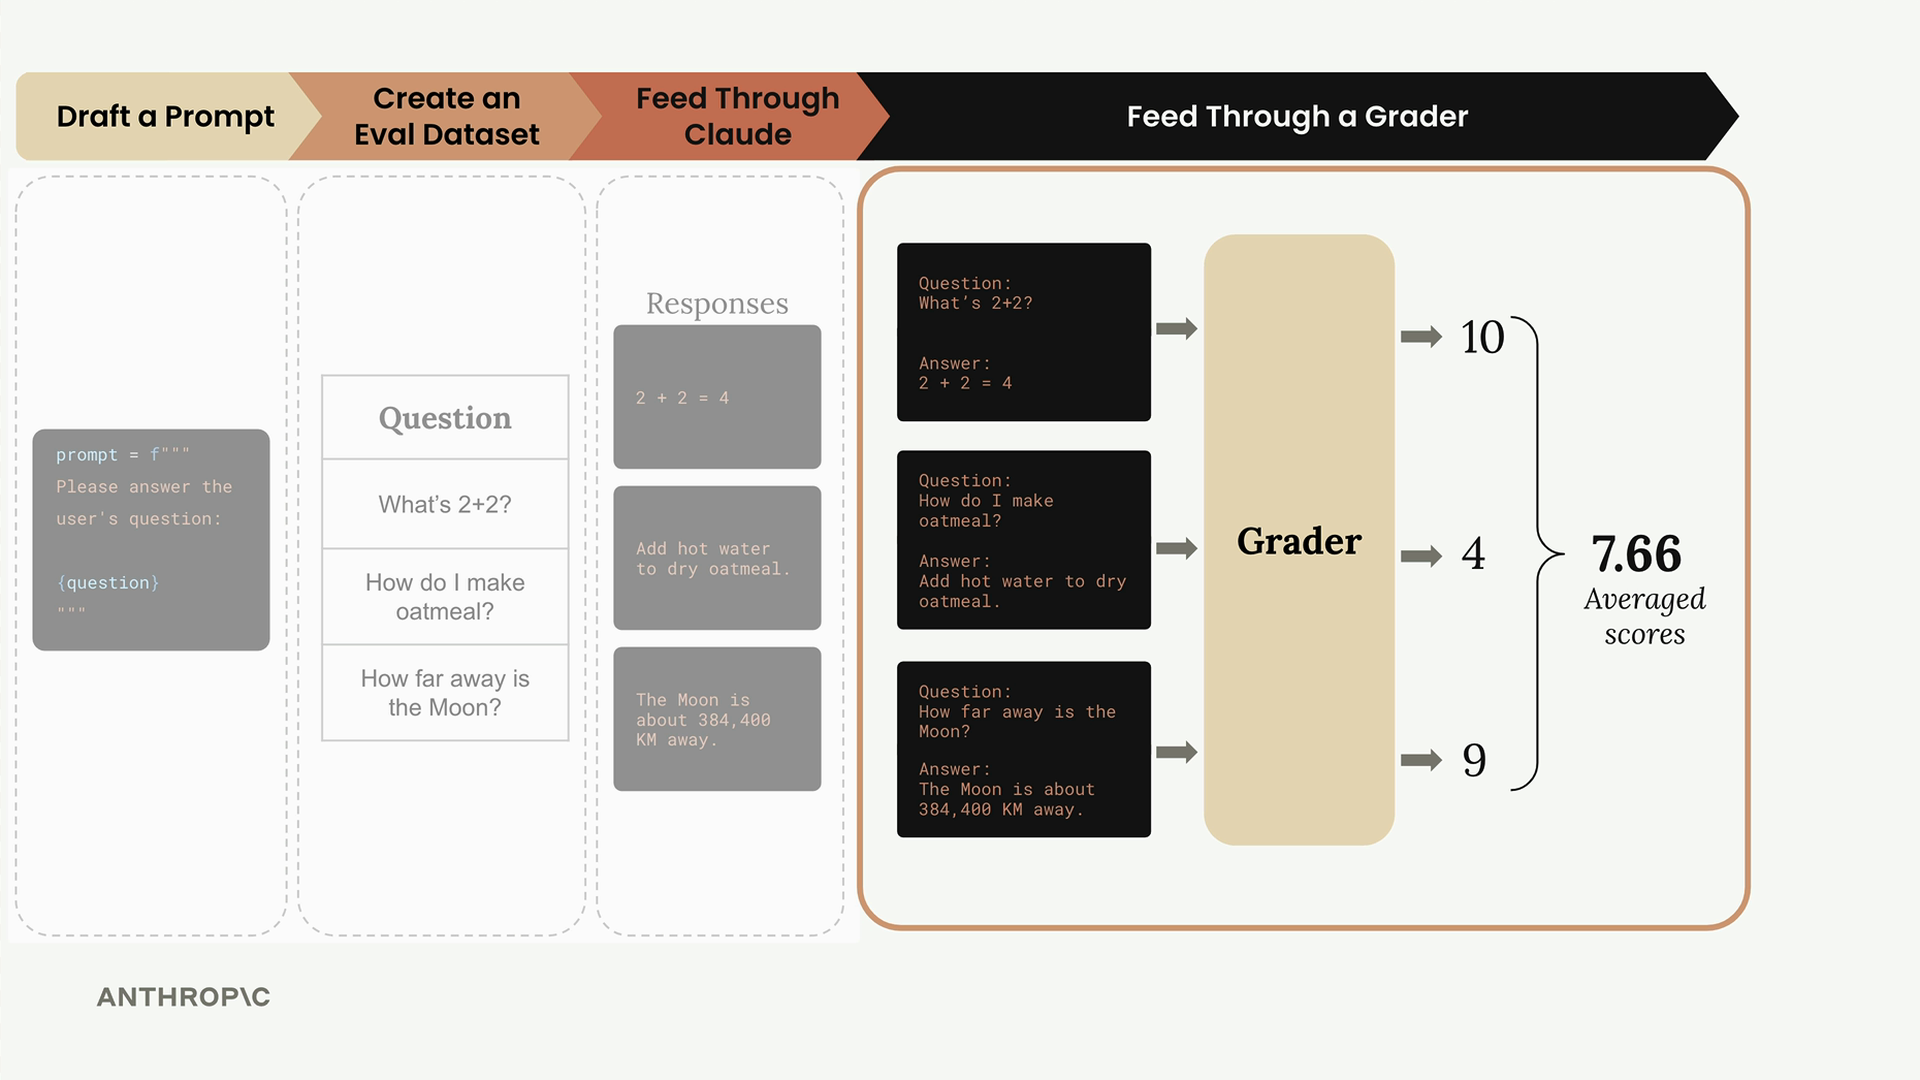
すべての応答を採点した後、スコアを平均します。この例では、10、4、9というスコアの平均は7.66となり、プロンプトのパフォーマンスの客観的な測定値が得られます。
ステップ5:プロンプトを変更して繰り返す
ベースラインのスコアが確立できたら、今度はプロンプトを変更し、プロセス全体を再度実行して、変更によってパフォーマンスが改善されるかどうかを確認できます。
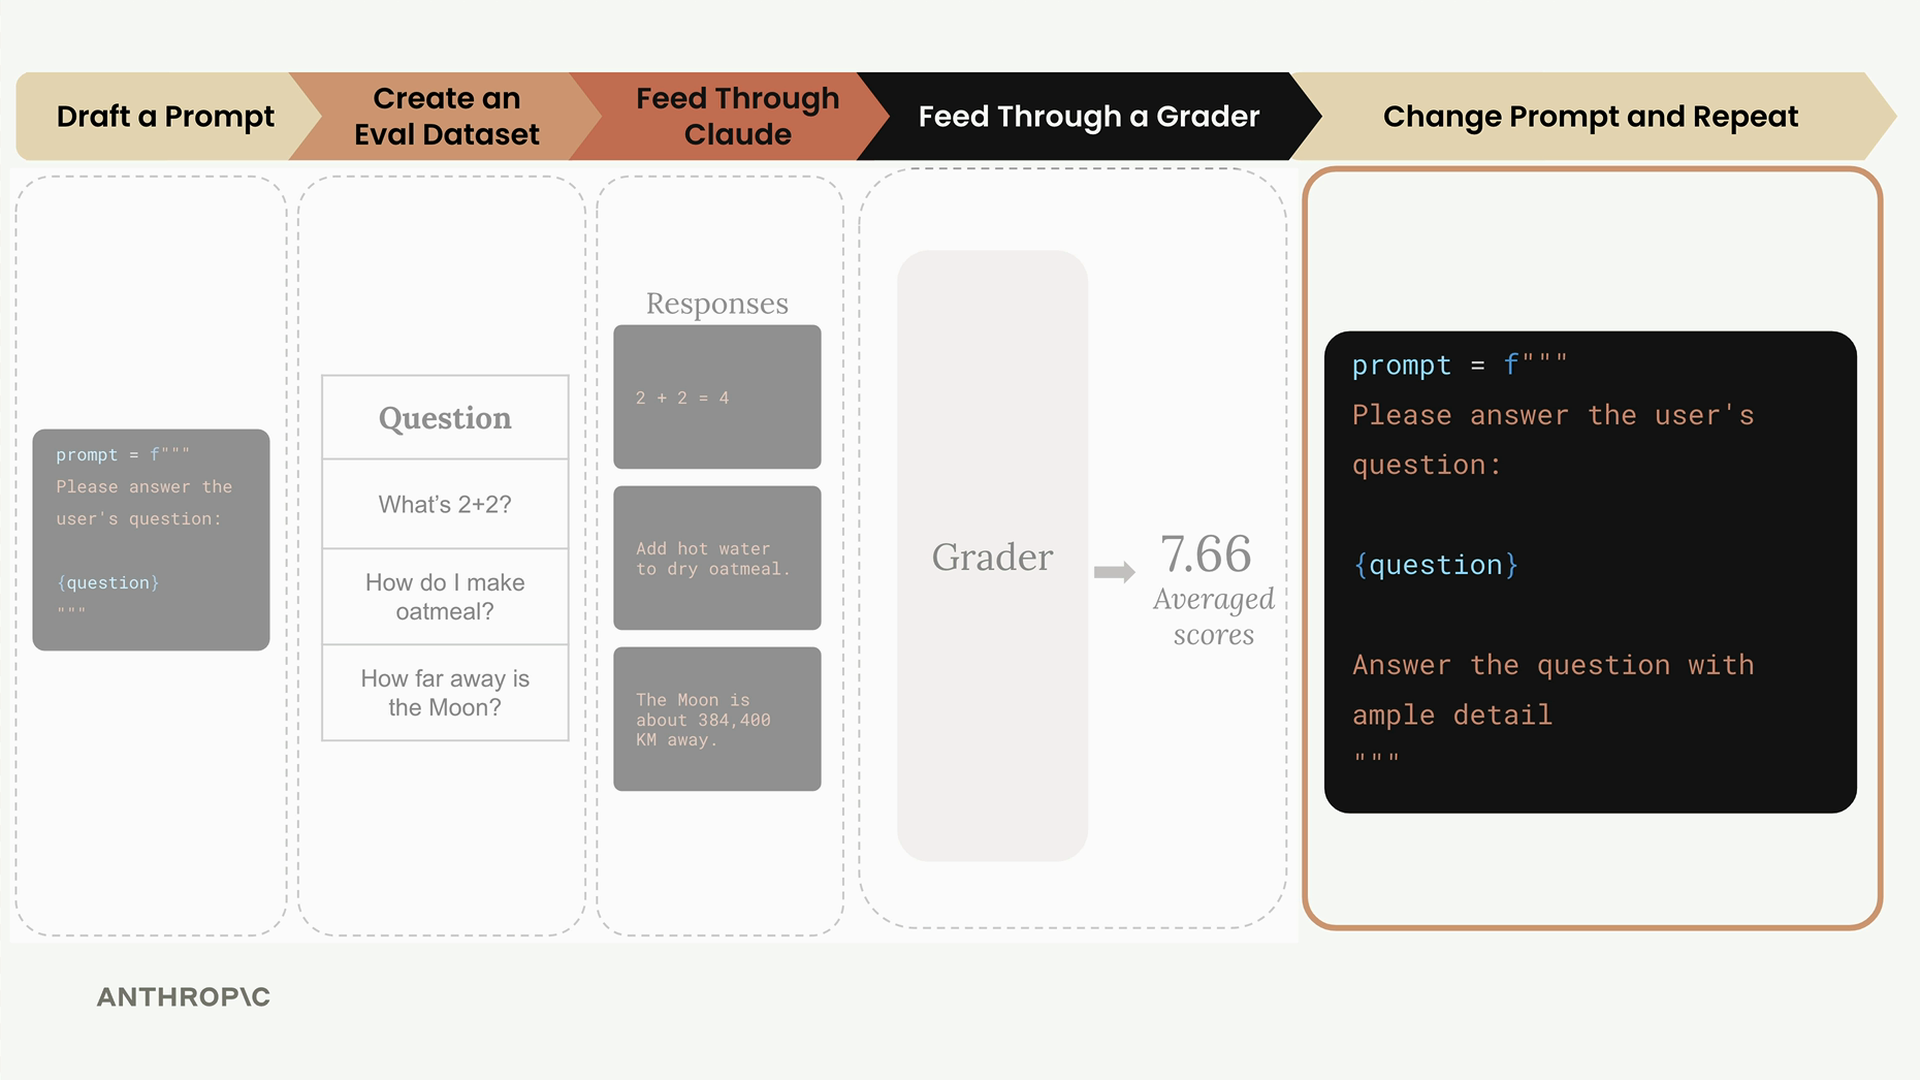
例えば、より具体的な指示を追加することで、元のプロンプトを強化することができます。
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
プロンプトの採点
このワークフローの強みは、プロンプトのパフォーマンスに関する客観的な測定値を得られる点にあります。異なるバージョンのプロンプト間でスコアを比較し、どちらがより優れた性能を発揮するかを判断できます。
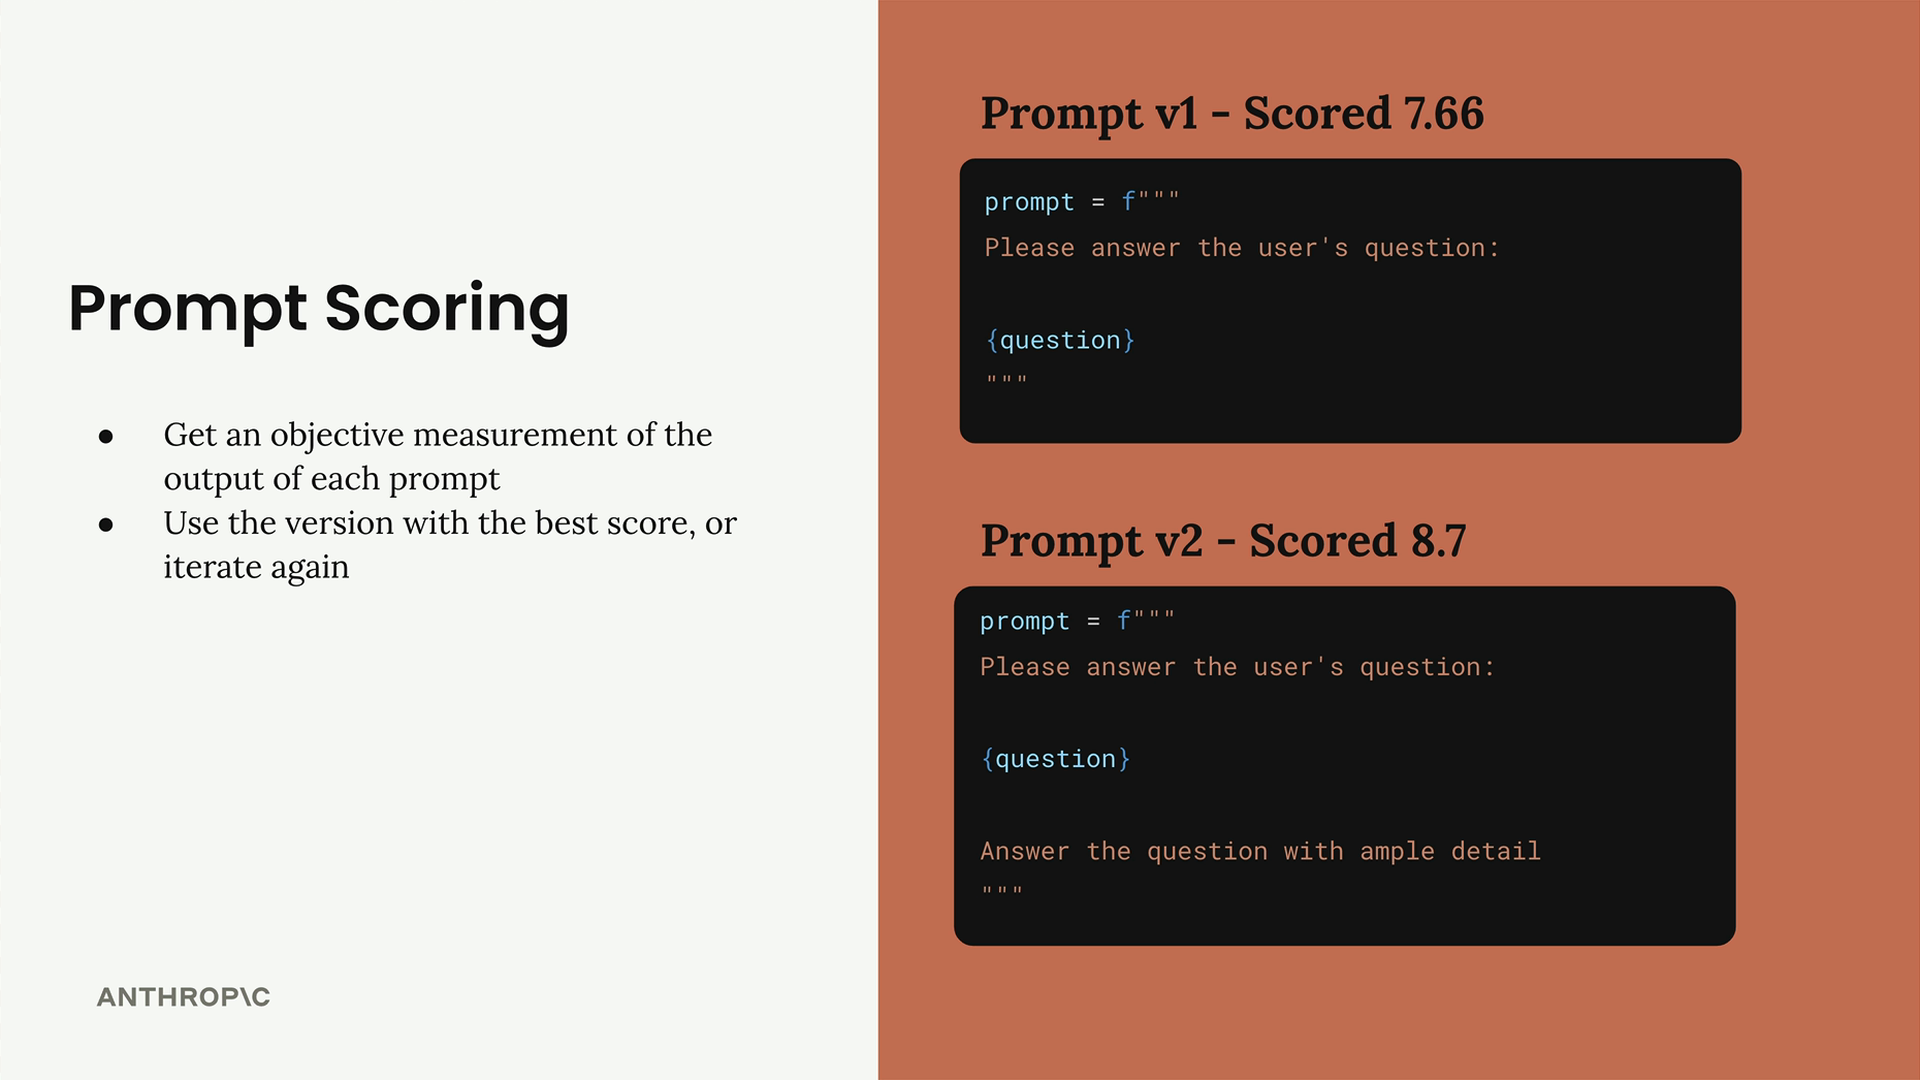
この例では:
- プロンプトv1は7.66点
- プロンプトv2は8.7点
v2のより高いスコアは、「Answer the question with ample detail」を追加したことでプロンプトのパフォーマンスが改善されたことを示す客観的な証拠となります。その後、より優れたパフォーマンスを示したバージョンを使用するか、さらに高いスコアを達成するために反復を続けることができます。
この体系的なアプローチにより、プロンプトの改善から当て推量が排除され、最適化のための信頼できるフレームワークが得られます。効果的なグレーダーを実装するには複雑さが伴いますが、このワークフローは、独自の評価システムを構築するための確かな基盤を提供します。