Claudeを使ってアプリケーションを構築する際には、リクエストのライフサイクル全体を理解しておくことで、より優れたシステムを設計し、問題をより効果的にデバッグできるようになります。ユーザーがAI搭載のチャットアプリケーションにメッセージを送信したときに何が起こるかを、順を追って見ていきましょう。
リクエストの全体フロー
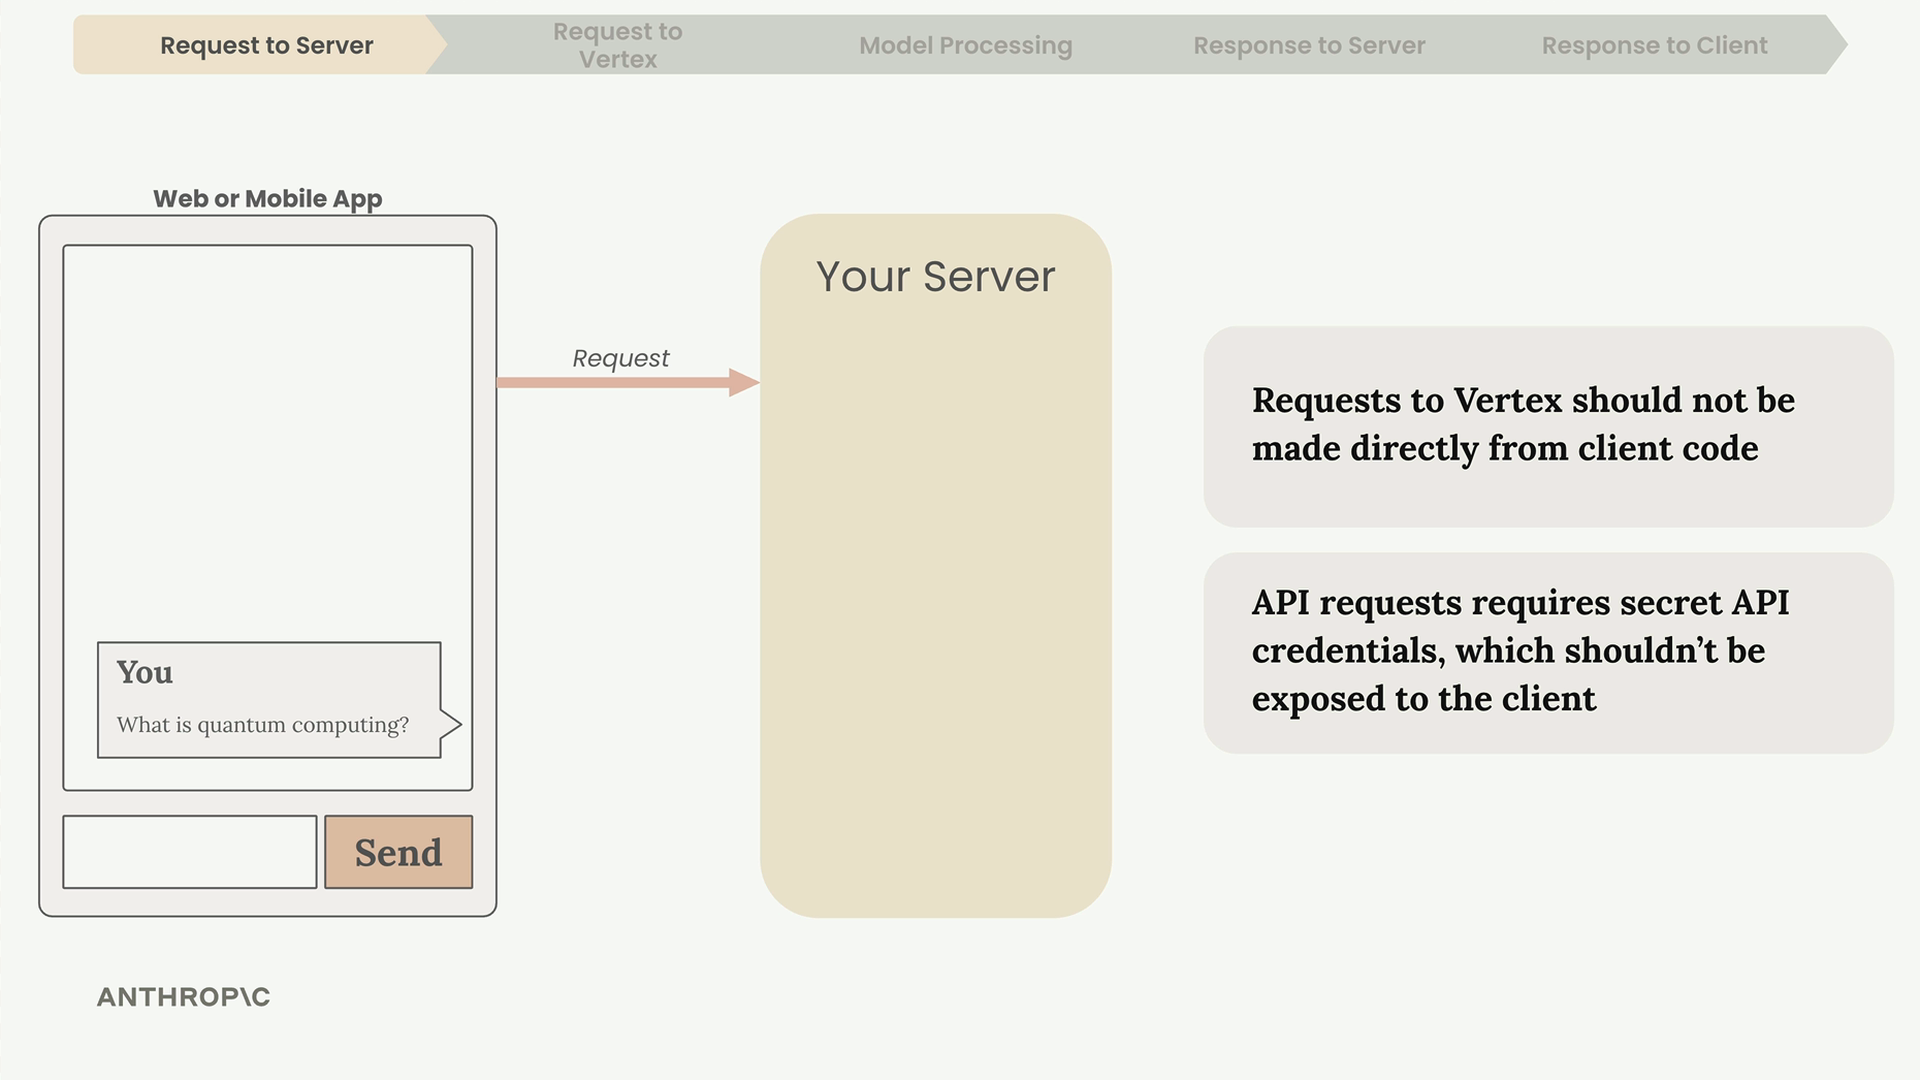
ユーザー入力からAIの応答に至るまでの流れには、Request to Server、Request to Vertex、Model Processing、Response to Server、Response to Clientという5つの明確なステップがあります。各ステップは、ユーザーが期待する「魔法のような」応答を届けるうえで重要な役割を果たします。
サーバーが必要な理由
クライアント側のコードから直接APIリクエストを行ってはいけません。その理由は次のとおりです。
- APIリクエストには、安全に保つ必要がある秘密の認証情報が必要です
- クライアントコード内で認証情報を公開すると、誰からでも見えるようになってしまいます
- サーバーは、アプリとVertexの間の安全な仲介役として機能します
リクエストは必ず、自分が管理・保護している自前のサーバーを経由させてください。
APIリクエストを行う
あなたのサーバーは、AnthropicのSDKまたはGoogleの公式Vertex SDKのいずれかを使ってVertexと通信します。AnthropicはPython、TypeScript、Go、Ruby向けに公式SDKを提供しています。
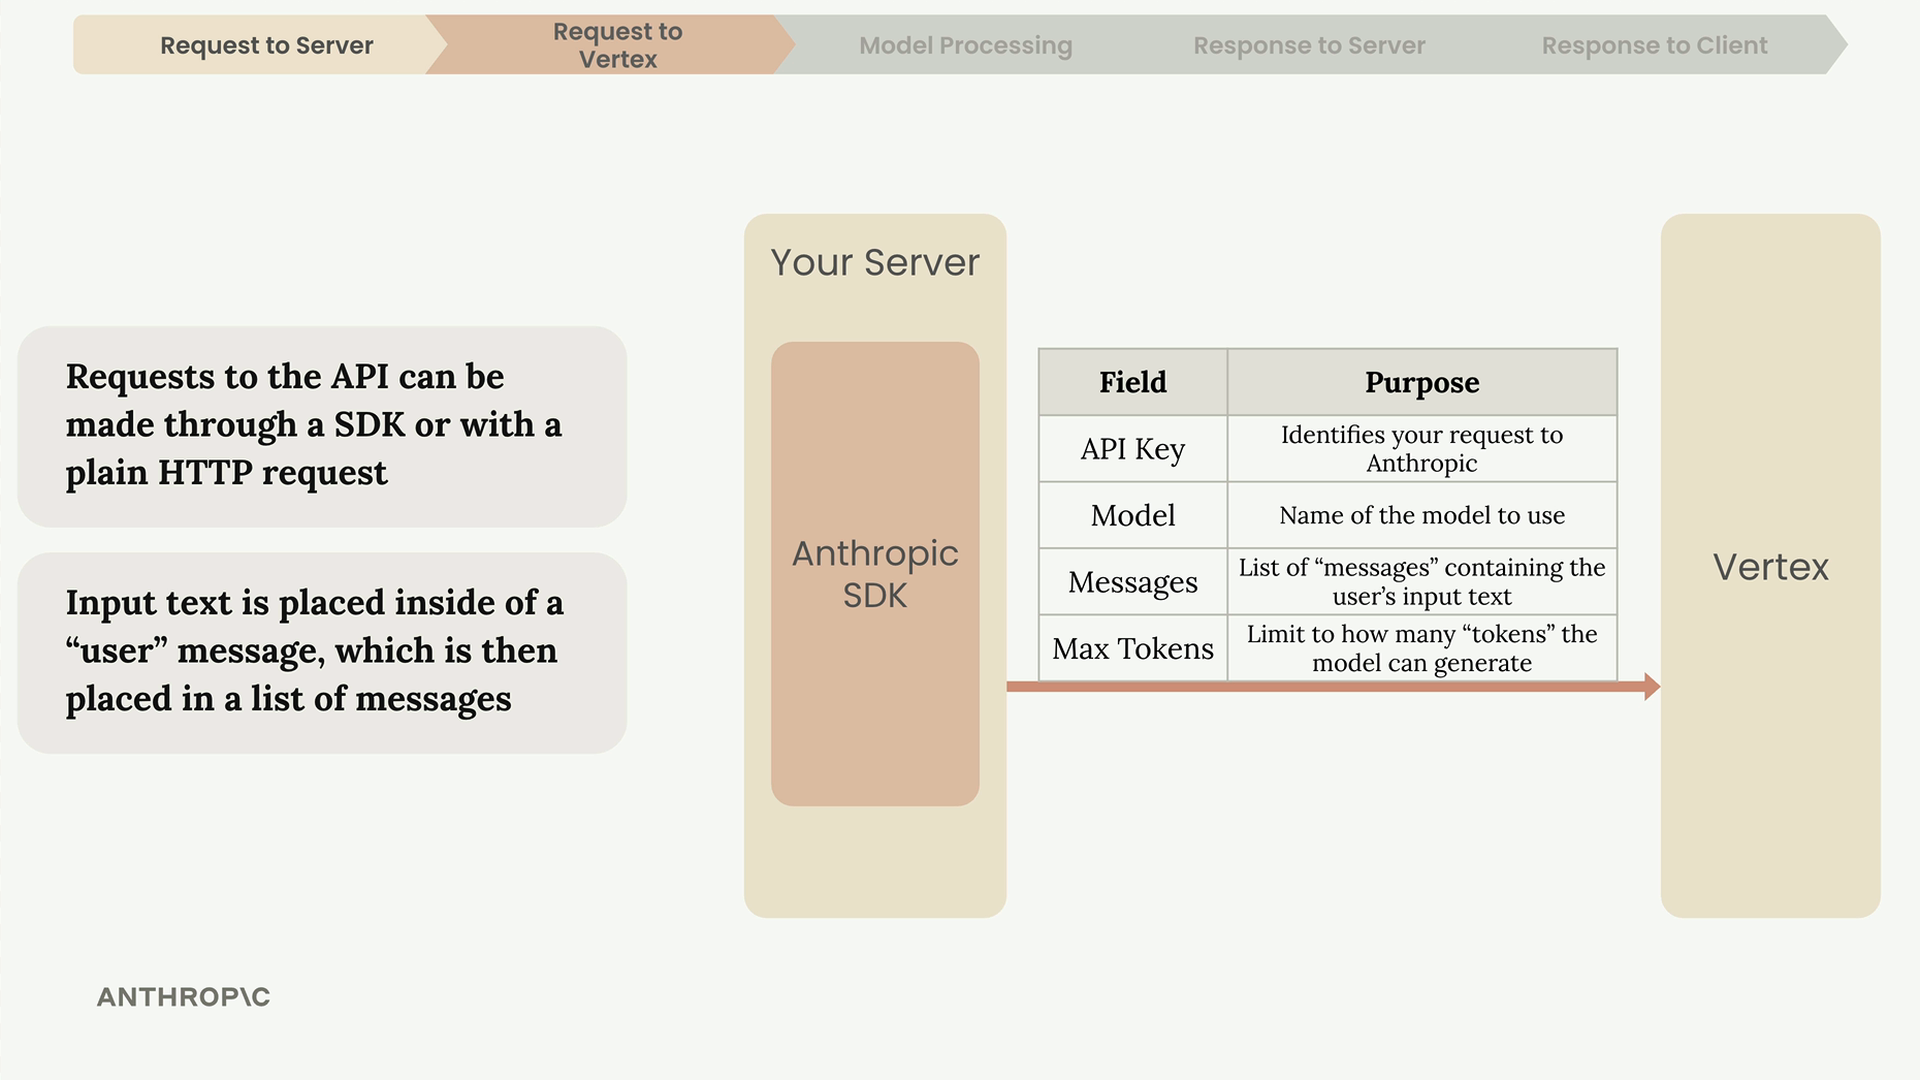
すべてのリクエストには、次の主要なフィールドを含める必要があります。
- Google Cloud Credentials - Google Cloud上でリクエストを認可します
- Model - 使用する特定のモデルの名前
- Messages - ユーザーの入力テキストを含むリスト
- Max Tokens - モデルが生成できるトークン数の上限
ユーザーの入力は「user」メッセージの中に格納され、それがAPIに送信されるメッセージのリストに入ります。
Claude内部:テキスト生成のプロセス
Vertexがリクエストを受け取ると、Claudeはそれを4つの段階(トークン化、埋め込み、文脈化、生成)を通じて処理します。
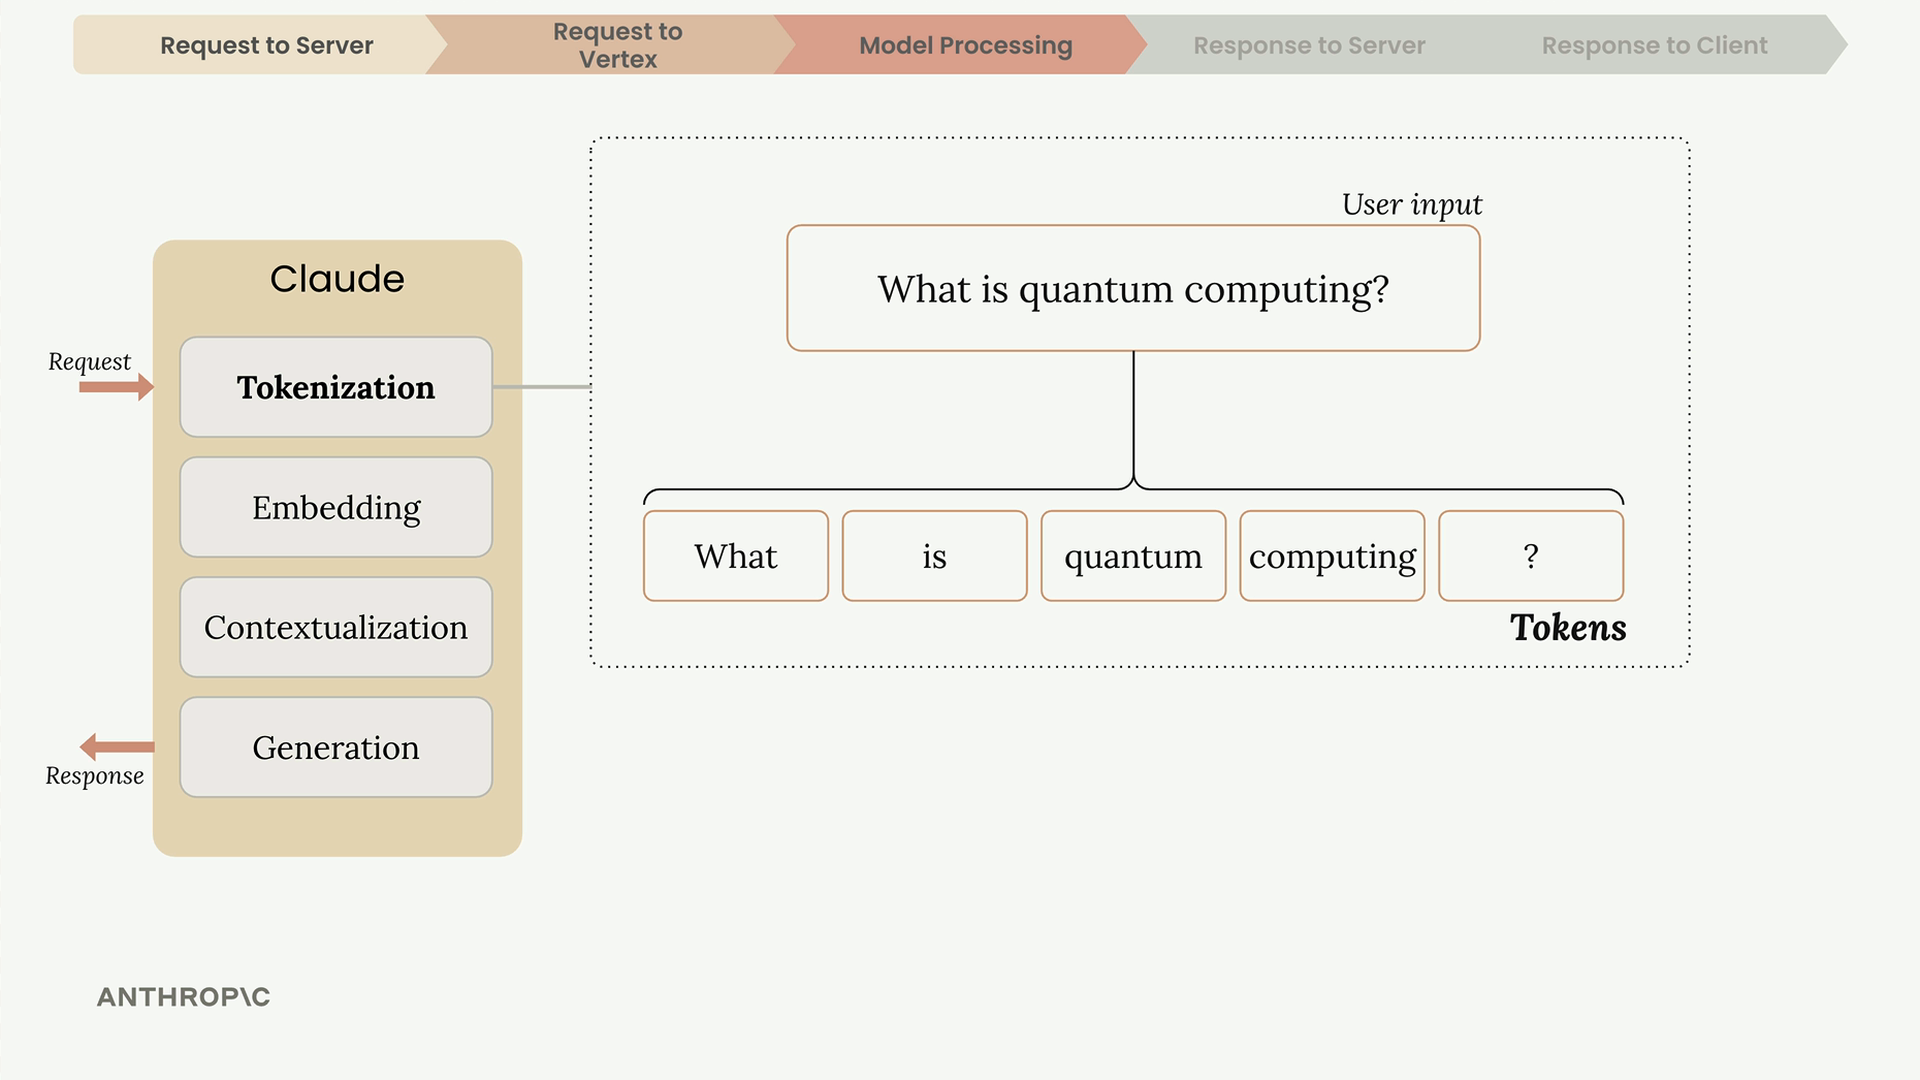
トークン化
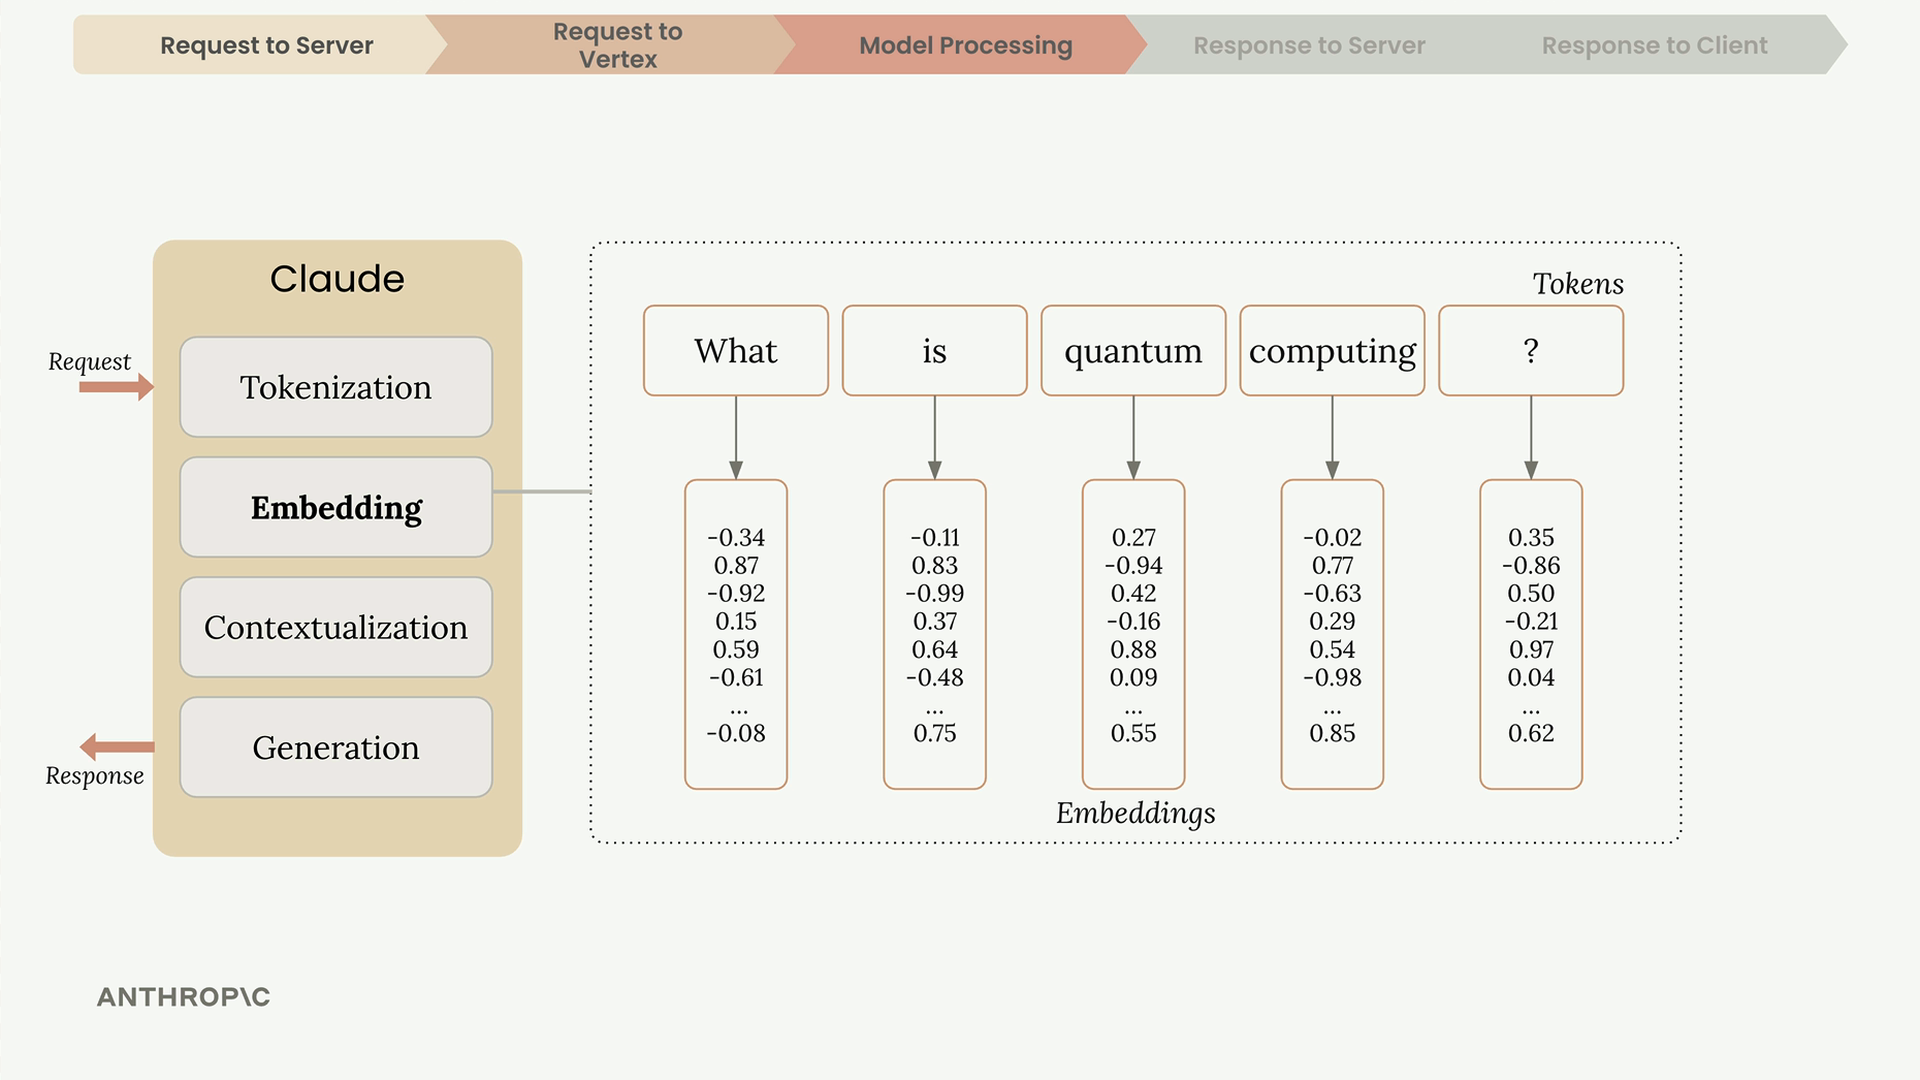
Claudeはまず、入力テキストをトークンと呼ばれる小さな単位に分解します。これらは単語全体、単語の一部、スペース、または記号になることがあります。単純化のために、各単語を1つのトークンと考えてください。
埋め込み
各トークンは埋め込み(エンベディング)へと変換されます。これは、その単語が持ちうるすべての意味を表す、数値の長いリストです。埋め込みを数値ベースの定義と考えてみてください。
文脈化
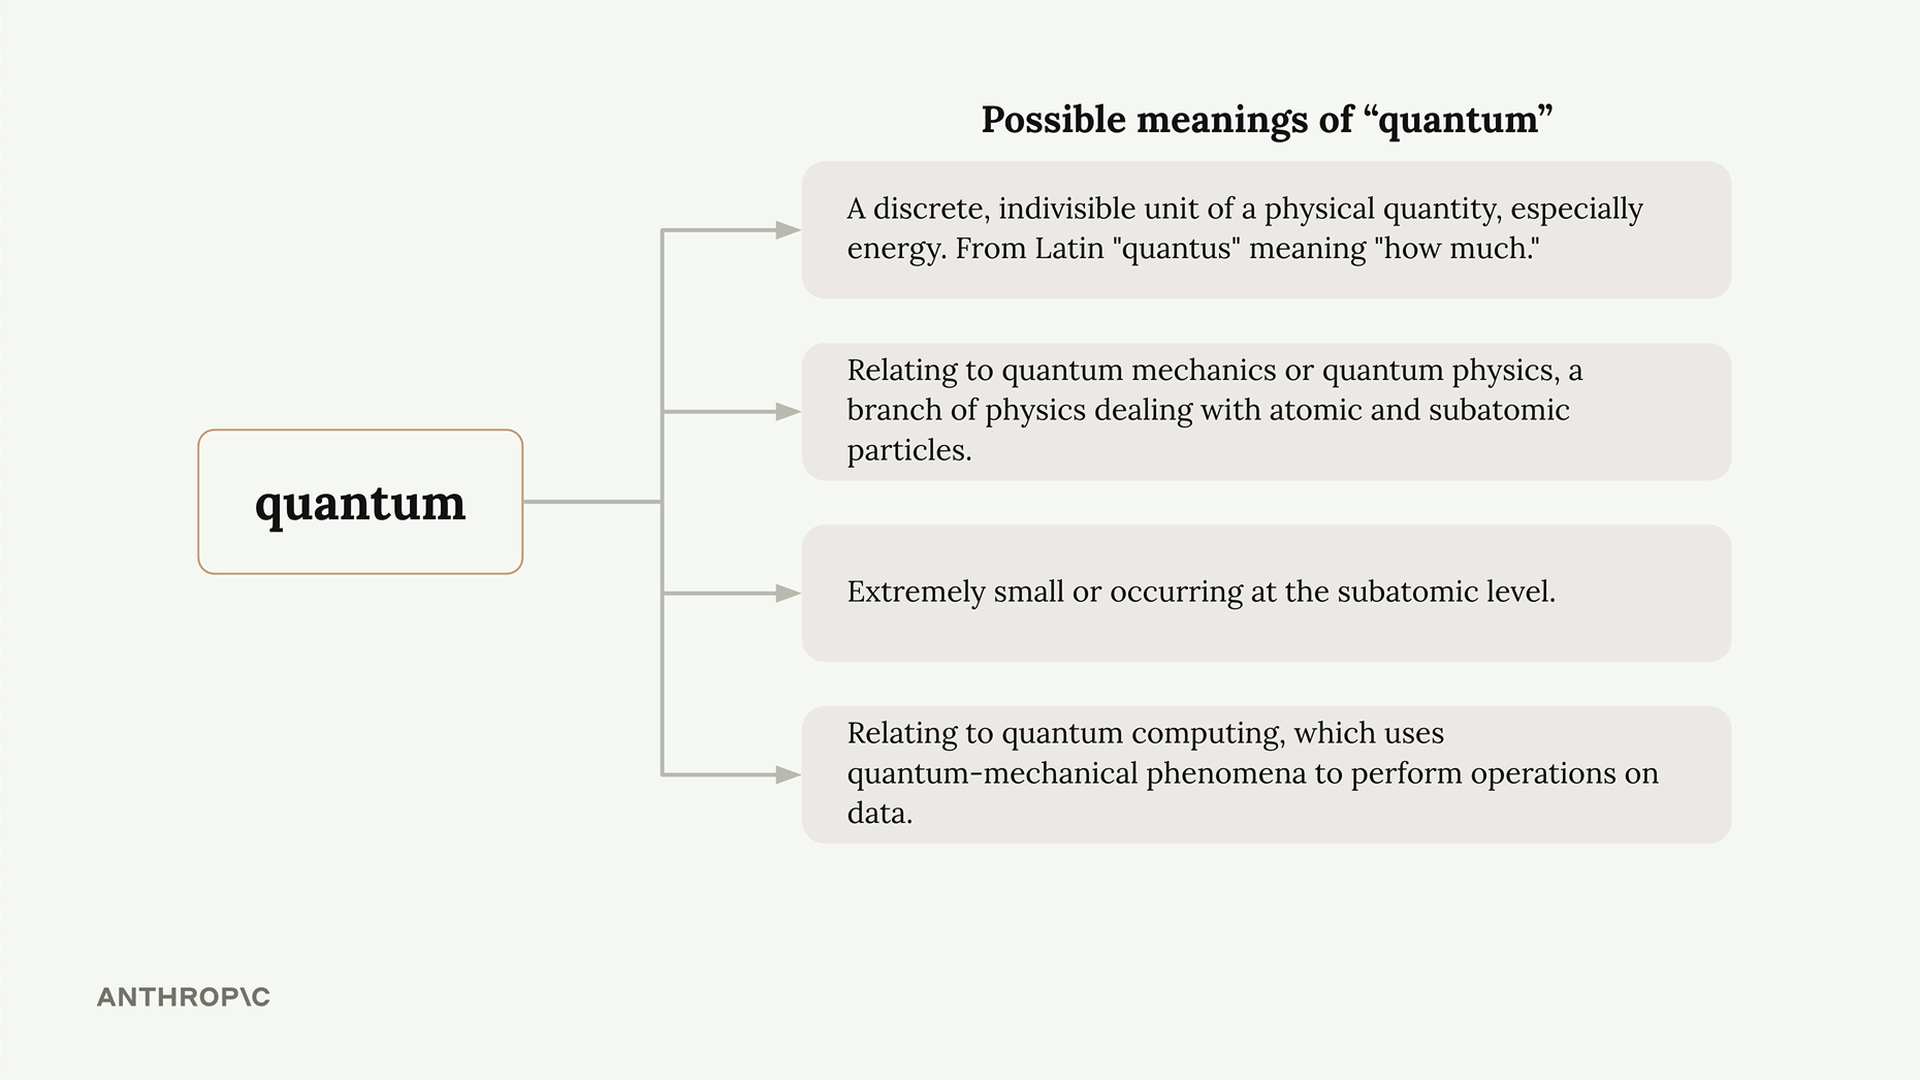
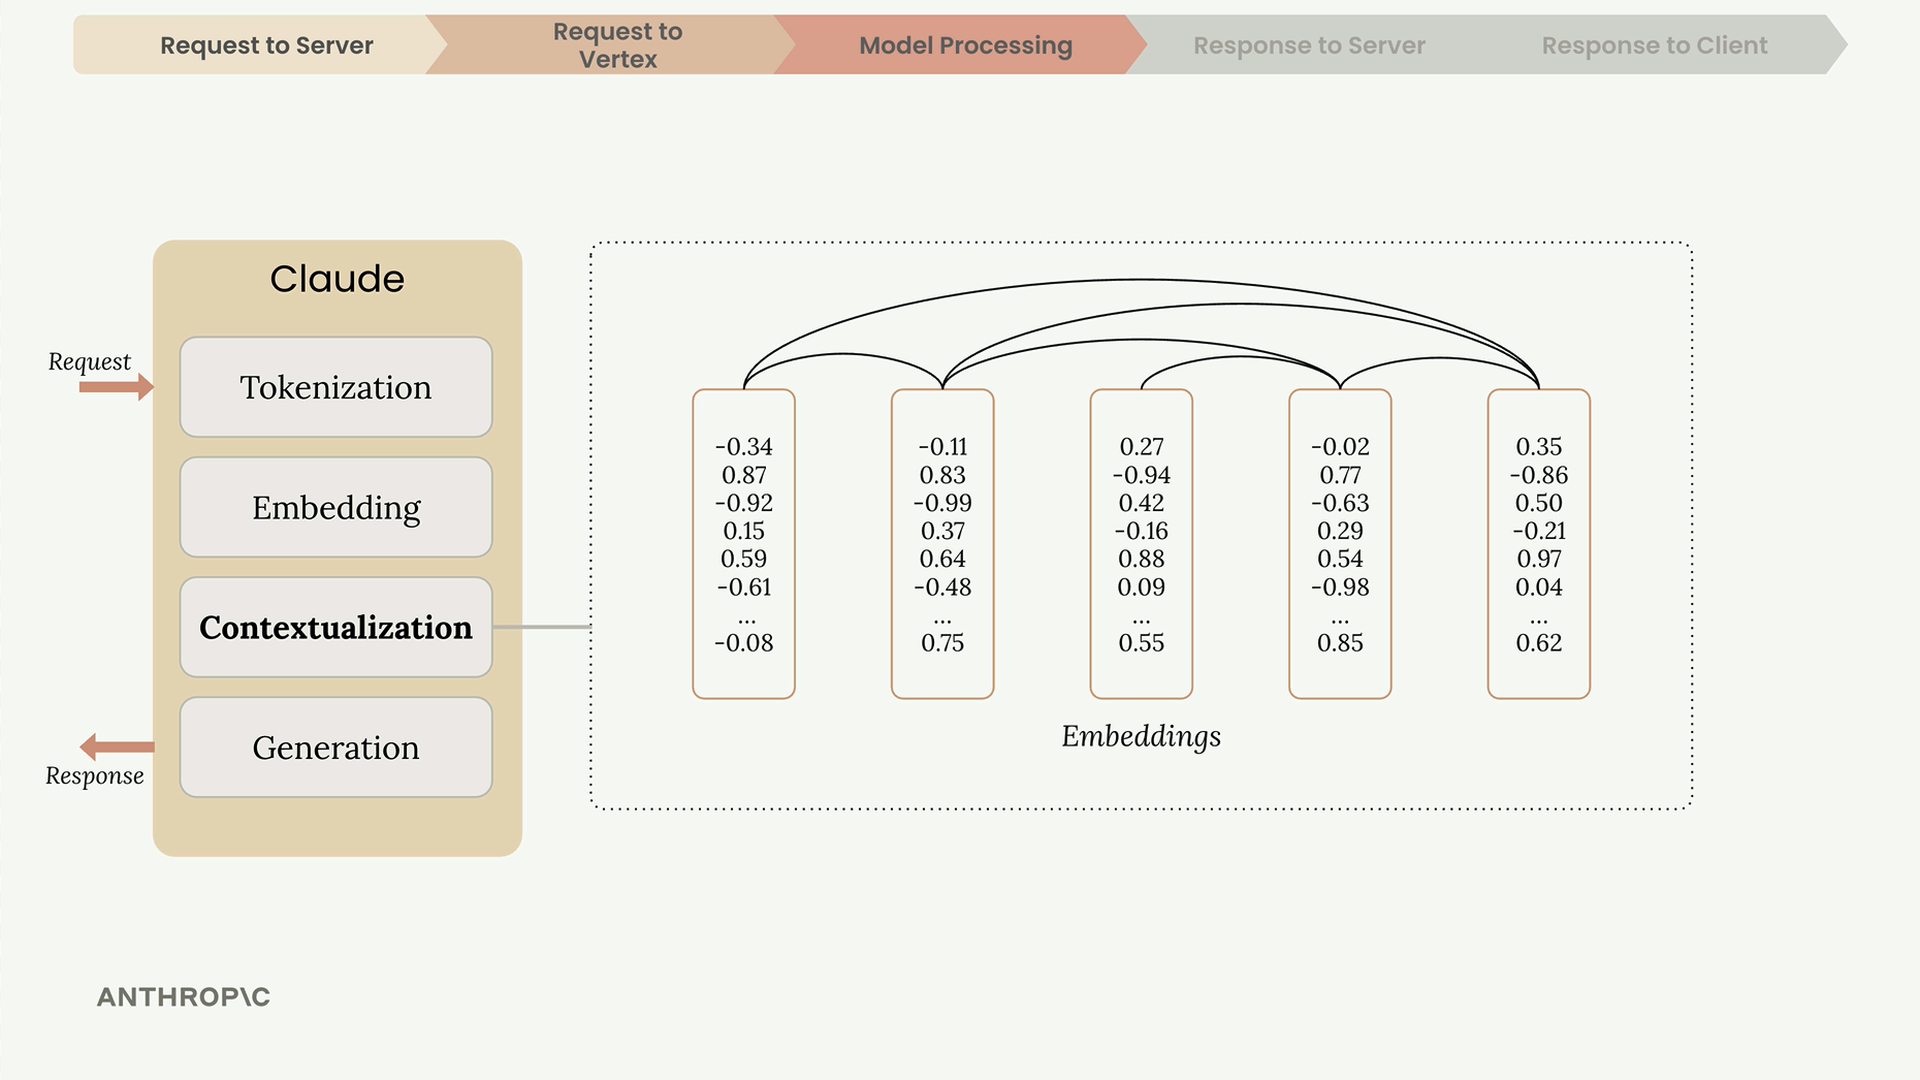
単語には複数の意味があり得るため、Claudeは文脈を使って正しい解釈を判断します。「quantum」という単語は、物理学、コンピューティング、あるいは単に「非常に小さい」という意味を指す場合がありますが、周囲の単語からの文脈によって意図された意味が明確になります。
文脈化の過程では、各埋め込みが周囲のトークンに基づいて調整され、その文脈において最も意味の通る解釈が強調されます。
生成
文脈化された埋め込みは出力層を通過し、次に来る可能性のある単語それぞれについての確率を生成します。Claudeは必ずしも最も確率の高い単語を選ぶわけではなく、確率とランダム性を組み合わせて、より自然で多様性のある応答を作り出します。
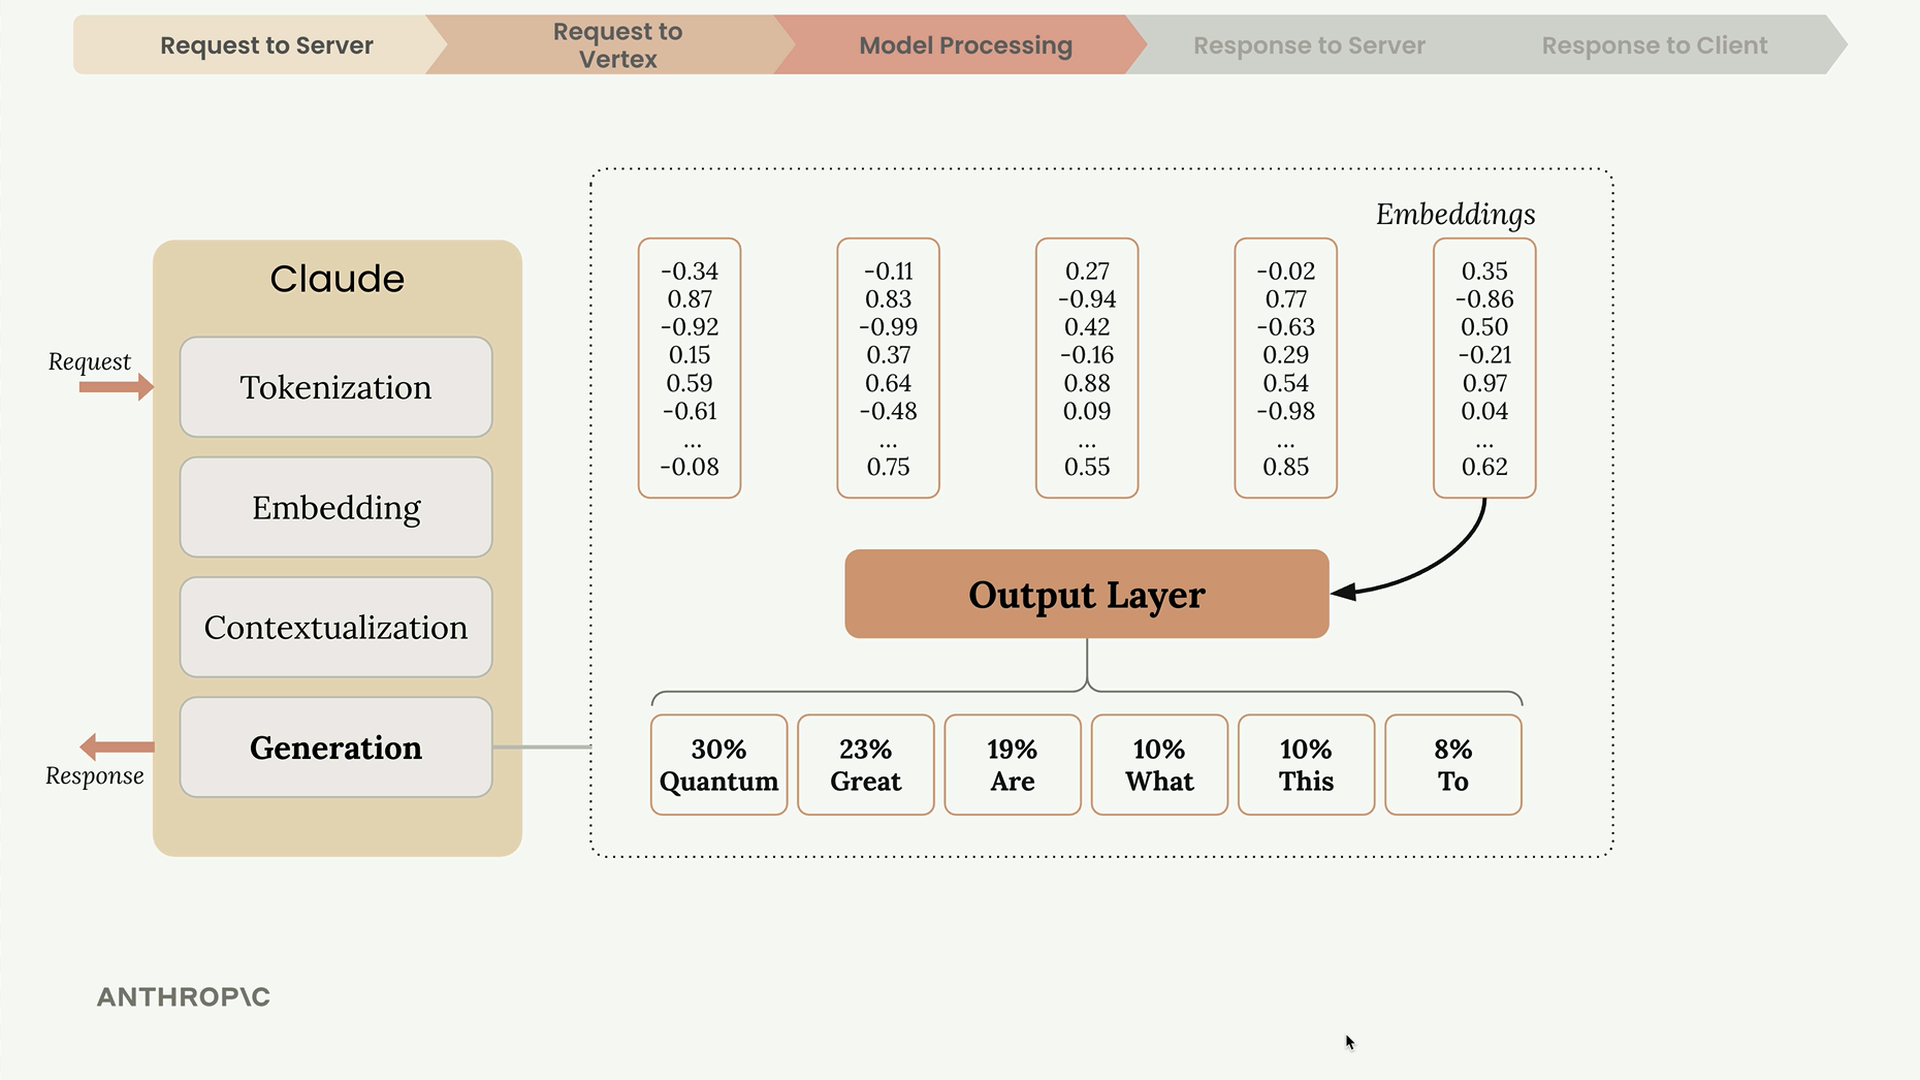
単語を選択した後、Claudeはそれをシーケンスに追加し、次の単語についても同じプロセス全体を繰り返します。
生成が停止するタイミング
各トークンを生成するたびに、Claudeは続行するかどうかを判断するためにいくつかの条件をチェックします。
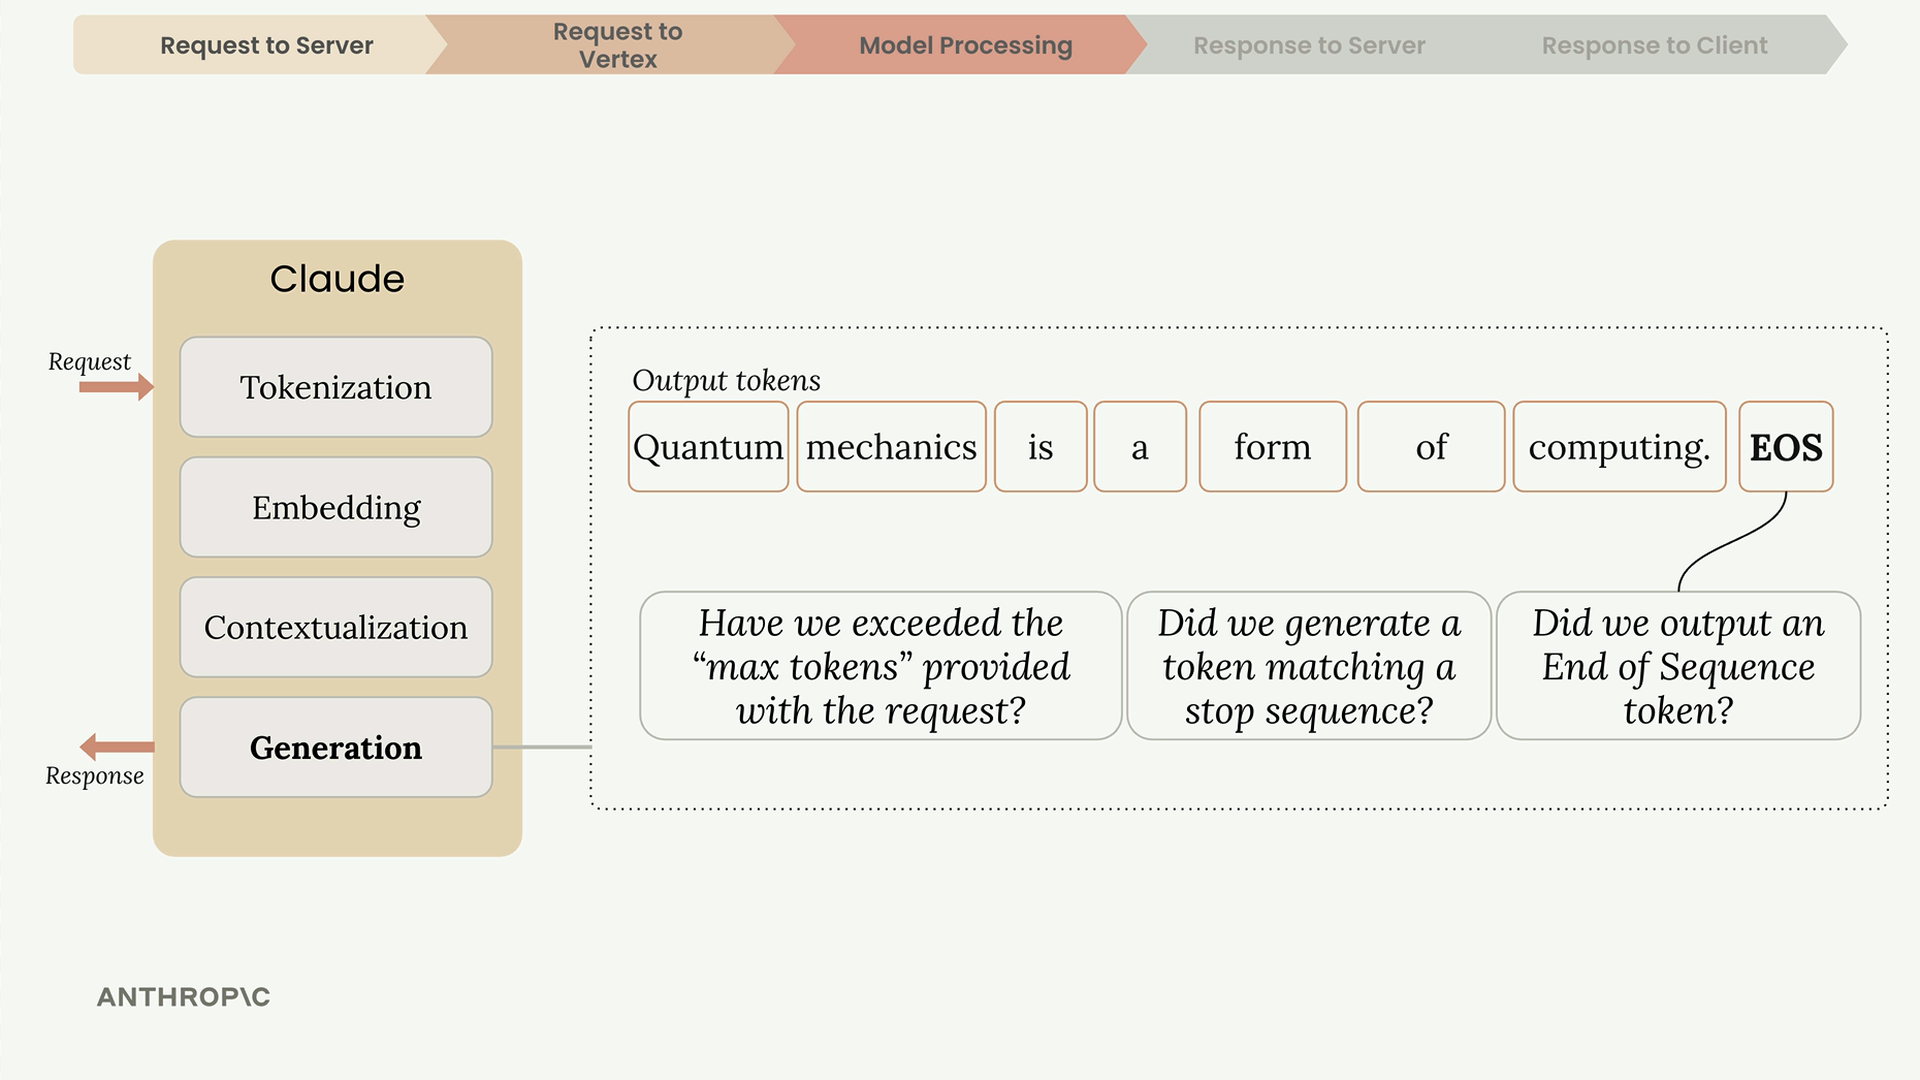
- 最大トークン数に到達 - 指定した上限に達したか?
- 自然な終了 - 終端(end-of-sequence)トークンを生成したか?
- ストップシーケンス - あらかじめ定義された停止フレーズに遭遇したか?
終端トークンは、Claudeが自然な結論に達したことを示すために使う特別な信号(目に見えるテキストではない)です。
レスポンス
生成が完了すると、Vertexはあなたのサーバーに以下を含むレスポンスを返します。
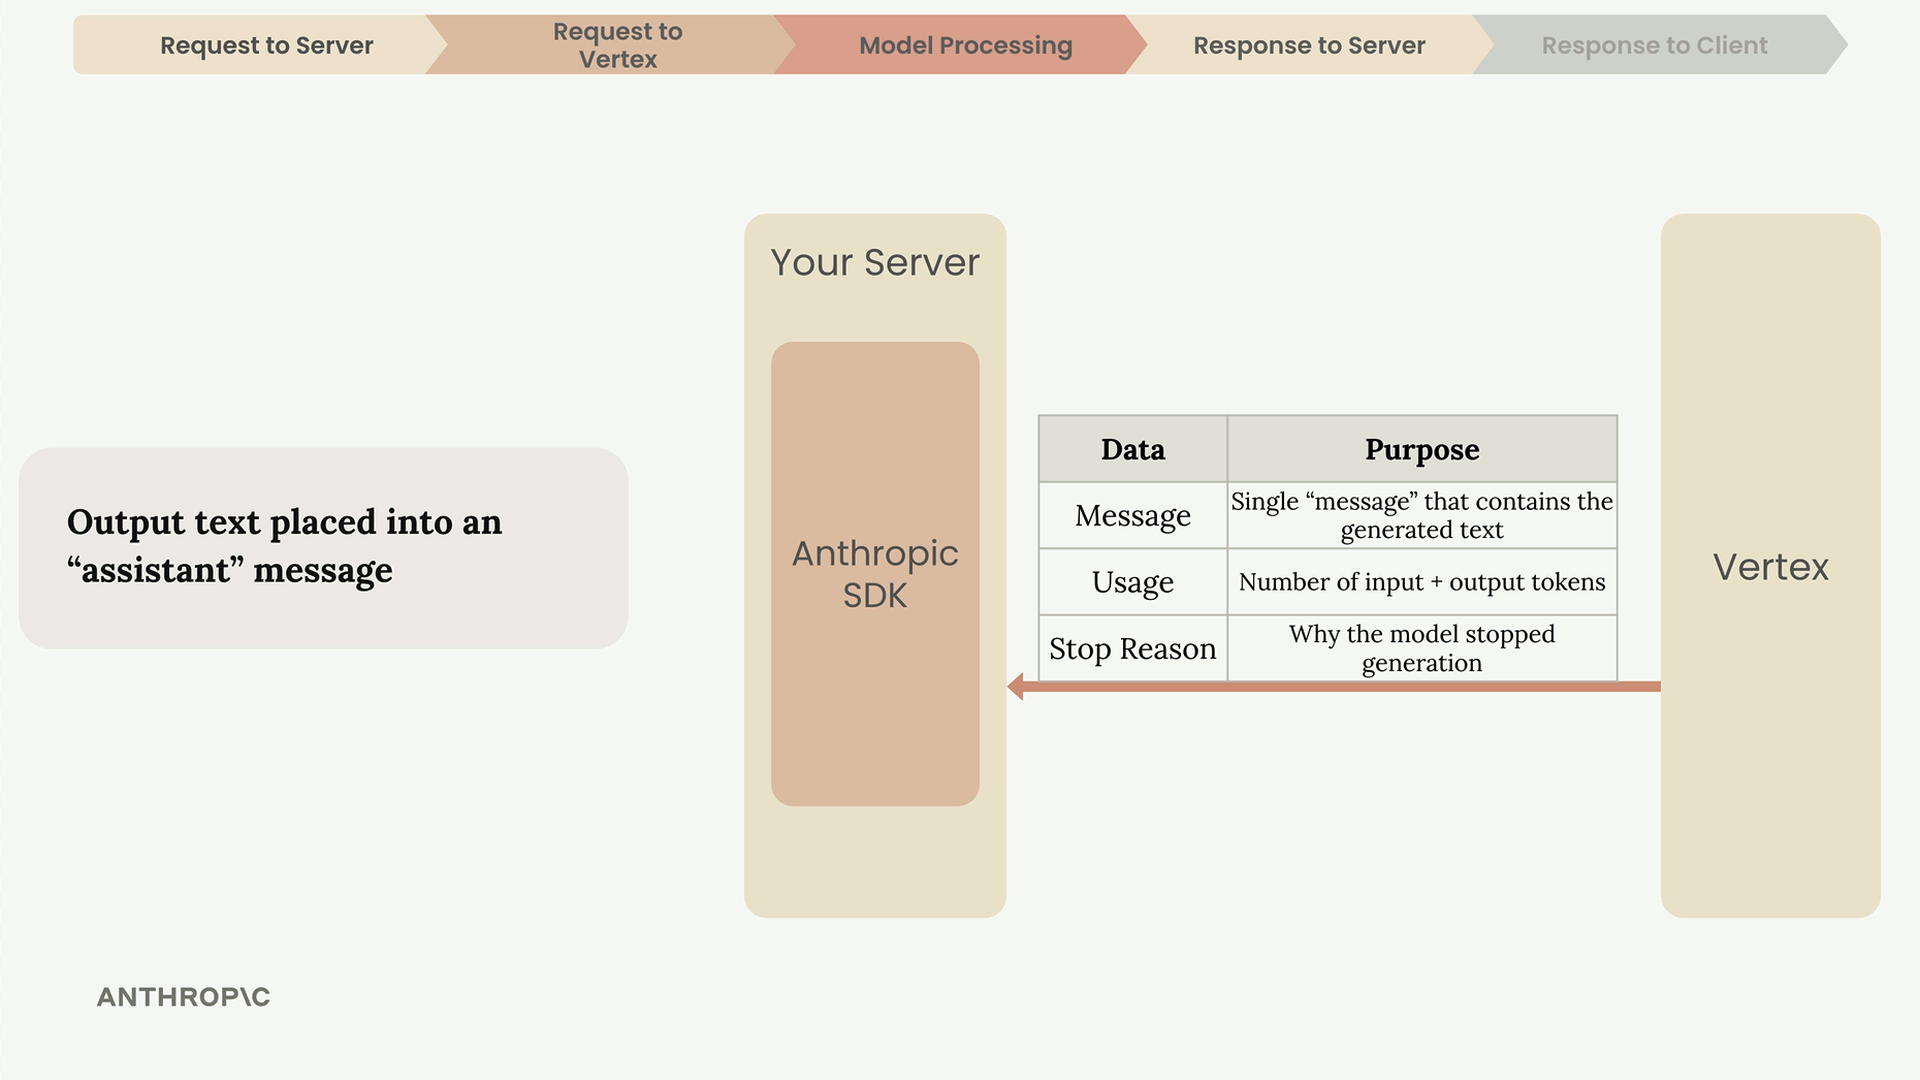
- Message - 生成されたテキスト
- Usage - 入力トークンと出力トークンの数
- Stop Reason - モデルが生成を停止した理由
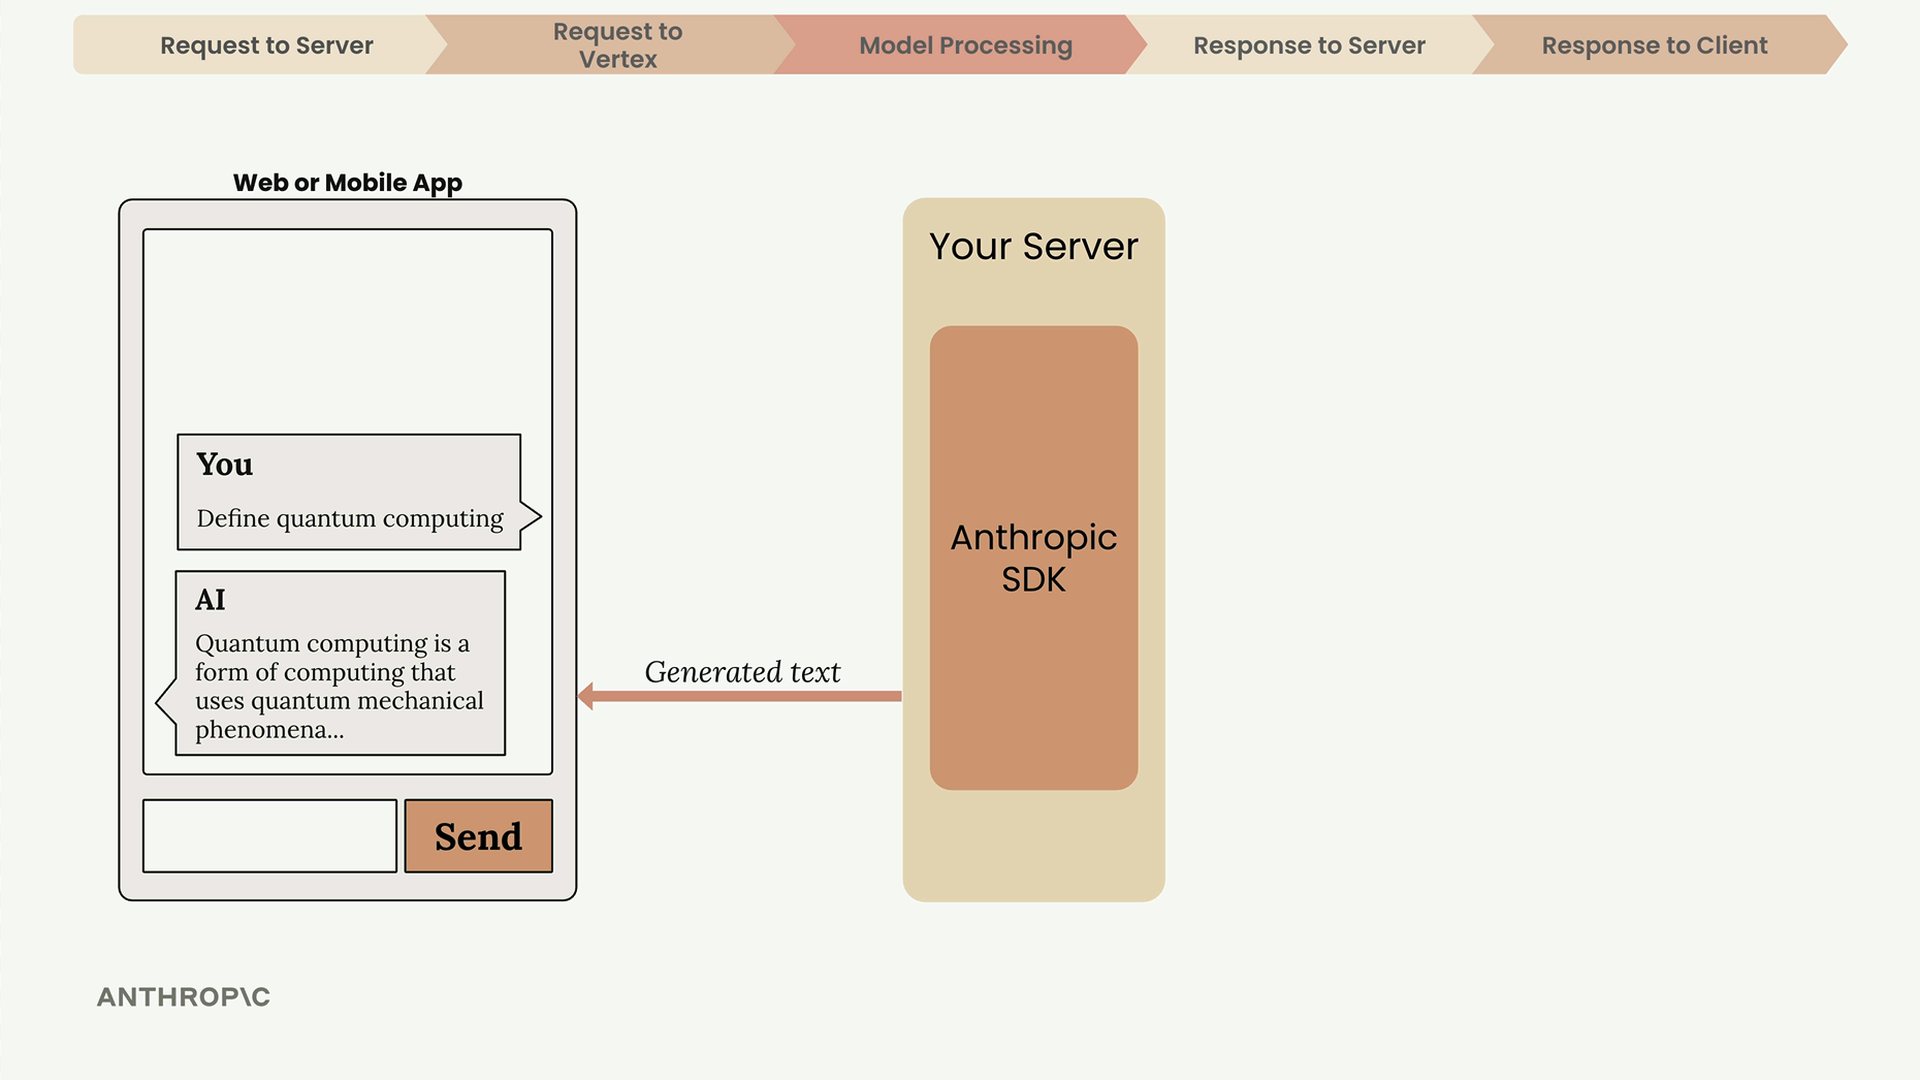
その後、あなたのサーバーは生成されたテキストをクライアントアプリケーションに転送し、そのテキストがチャットインターフェースに表示されます。
全体像
ユーザー入力からトークン化、埋め込み、文脈化、生成を経てユーザーに戻るまでの、この一連のプロセス全体は、わずか数秒のうちに行われます。このフローを理解することで、より堅牢なアプリケーションを構築し、問題が発生した際のトラブルシューティングに役立てることができます。
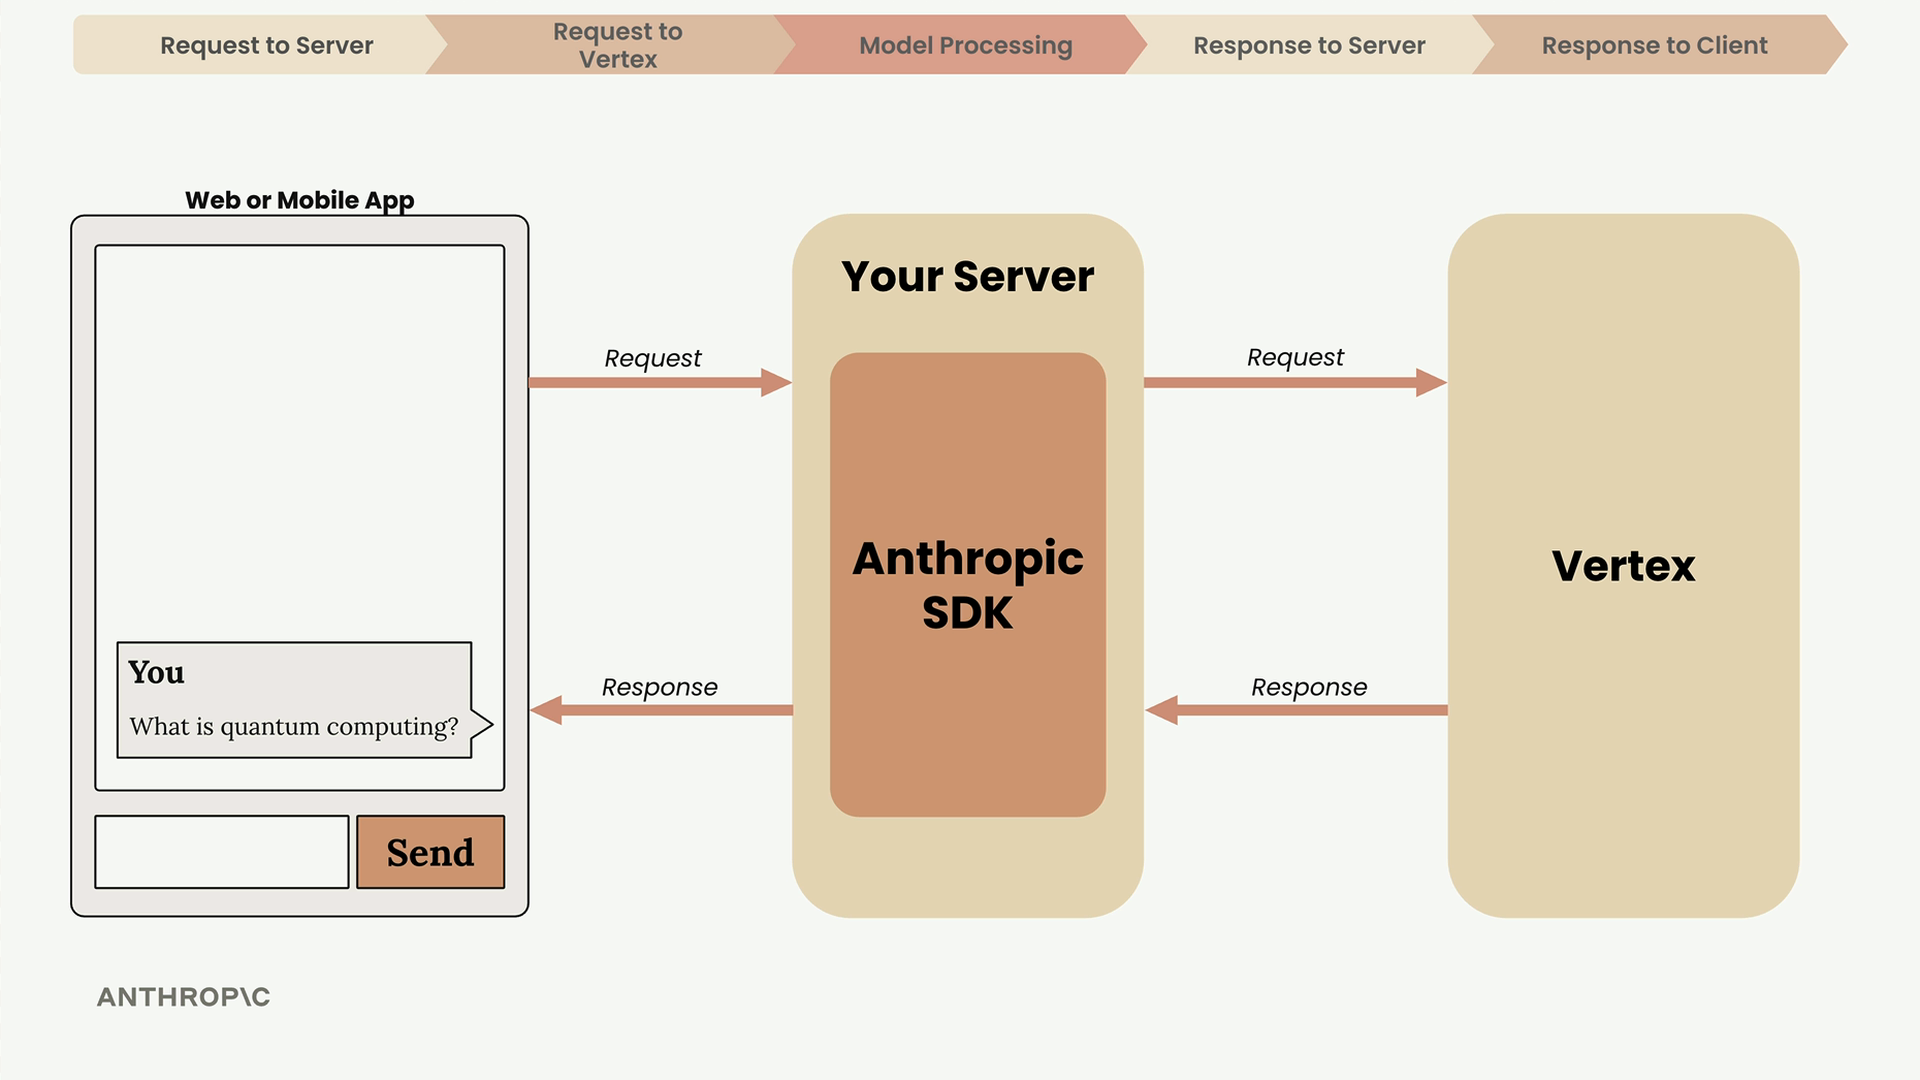
重要なポイント:必ずサーバーを仲介として使用すること、テキスト生成が反復的なプロセスであることを理解すること、そして使用状況を監視しモデルの挙動を理解するために、レスポンスのメタデータに注意を払うことです。