RAG、テキストチャンキング、エンベディングの基本を取り上げたので、次は完全なRAGパイプラインをステップバイステップで見ていきましょう。この詳細な例では、実際の実装においてすべての要素がどのように組み合わさっているかを正確に示します。
ステップ1:ソーステキストをチャンク化する
まず、ソースドキュメントを取り、扱いやすいチャンクに分割します。この例では、次の2つのシンプルなテキストセクションを使用します。
- セクション1:医学研究 - 「今年は、これまで見たことのなかった『バグ』であるXDR-47についての理解が大きく進展しました。」
- セクション2:ソフトウェアエンジニアリング - 「この部門は、分散システムにおけるさまざまな感染経路の研究に多大な労力を注いできました」
ステップ2:エンベディングを生成する
次に、各テキストチャンクを数値のエンベディングに変換します。これを理解しやすくするために、常に正確に2つの数値を返す完璧なエンベディングモデルがあり、それぞれの数値が何を表しているかがわかっているものと想定しましょう。
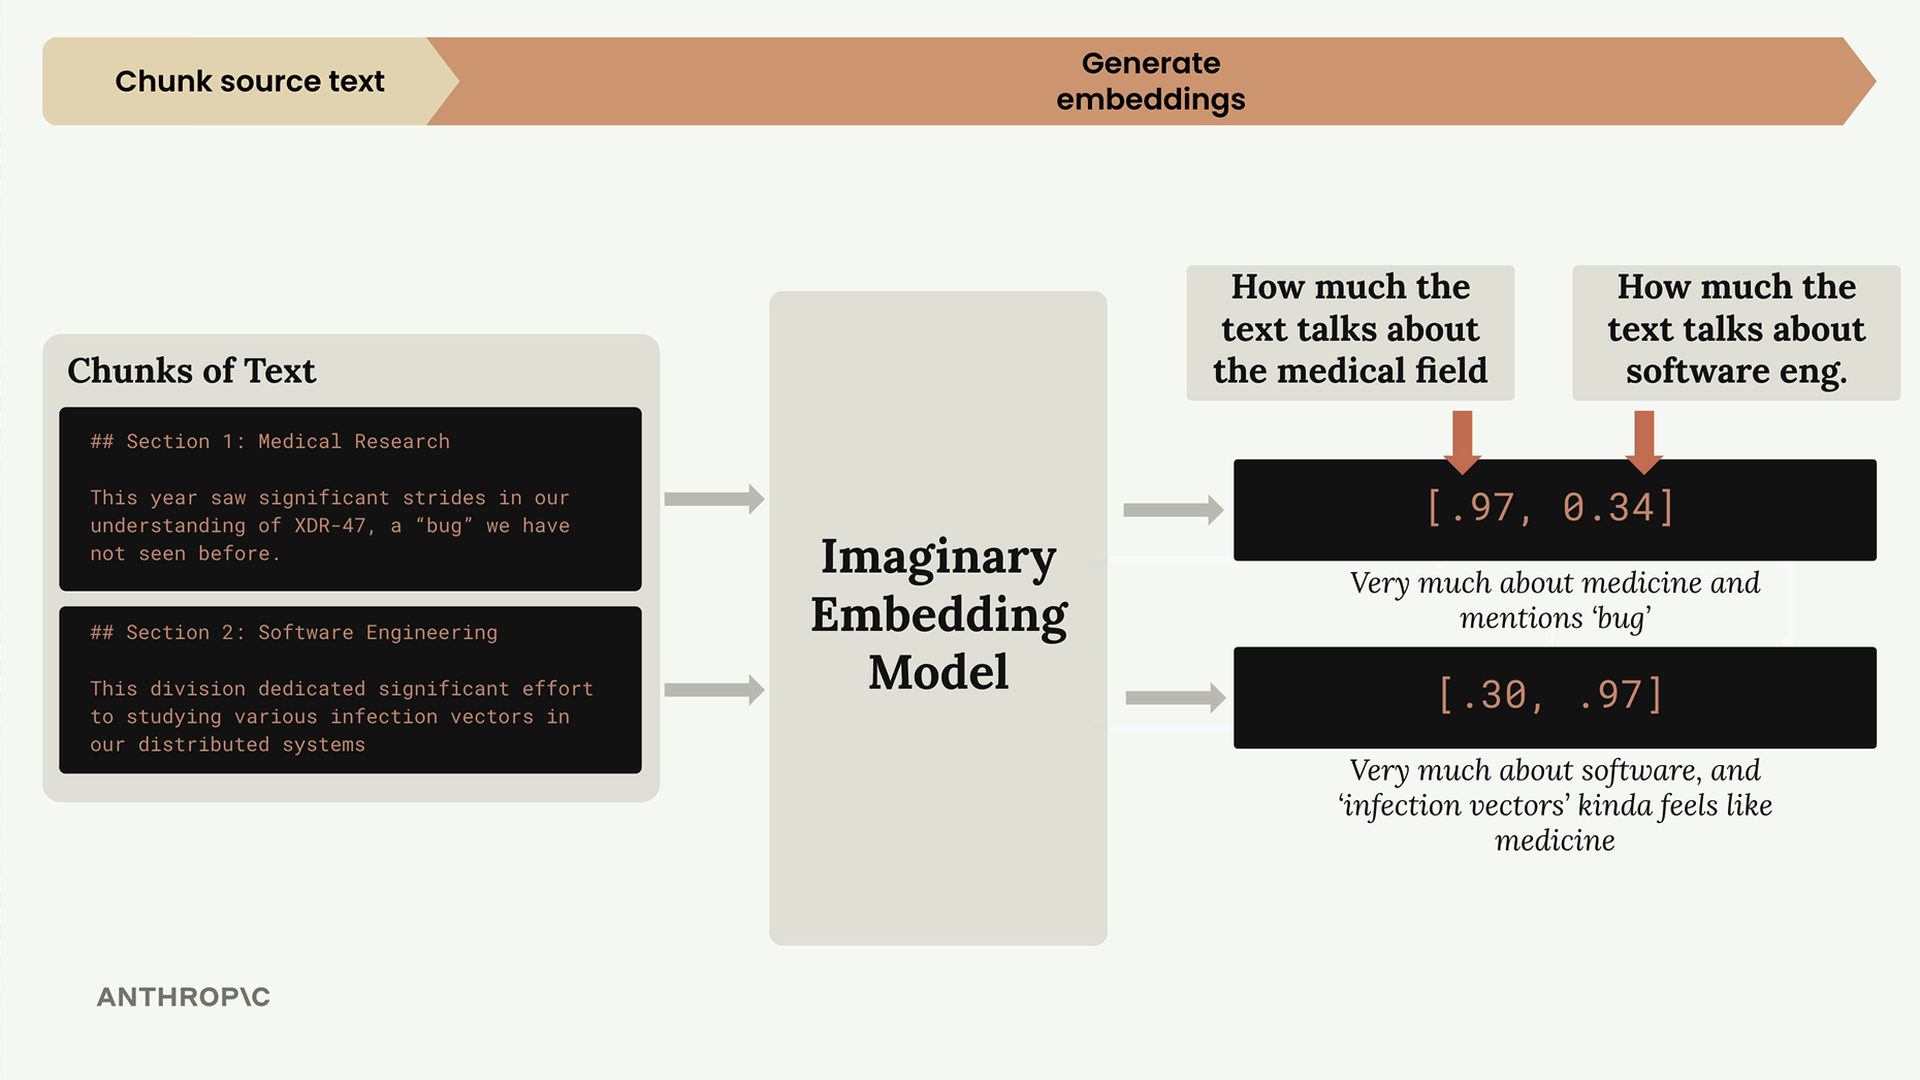
この架空のモデルでは:
- 1つ目の数値:テキストがどの程度医学について語っているか
- 2つ目の数値:テキストがどの程度ソフトウェアエンジニアリングについて語っているか
つまり、医学研究のセクションは[0.97, 0.34]になります - 非常に医学的で、「バグ」という単語のためやや多少ソフトウェア関連でもあります。ソフトウェアエンジニアリングのセクションは[0.30, 0.97]になります - 非常にソフトウェア寄りですが、「感染経路」には医学的な含意があります。
正規化
これらのエンベディングを保存する前に、各ベクトルの大きさを1.0にスケーリングする正規化処理が行われます。これは通常、エンベディングAPIによって自動的に処理されますが、それが起きていることを理解しておくことが重要です。
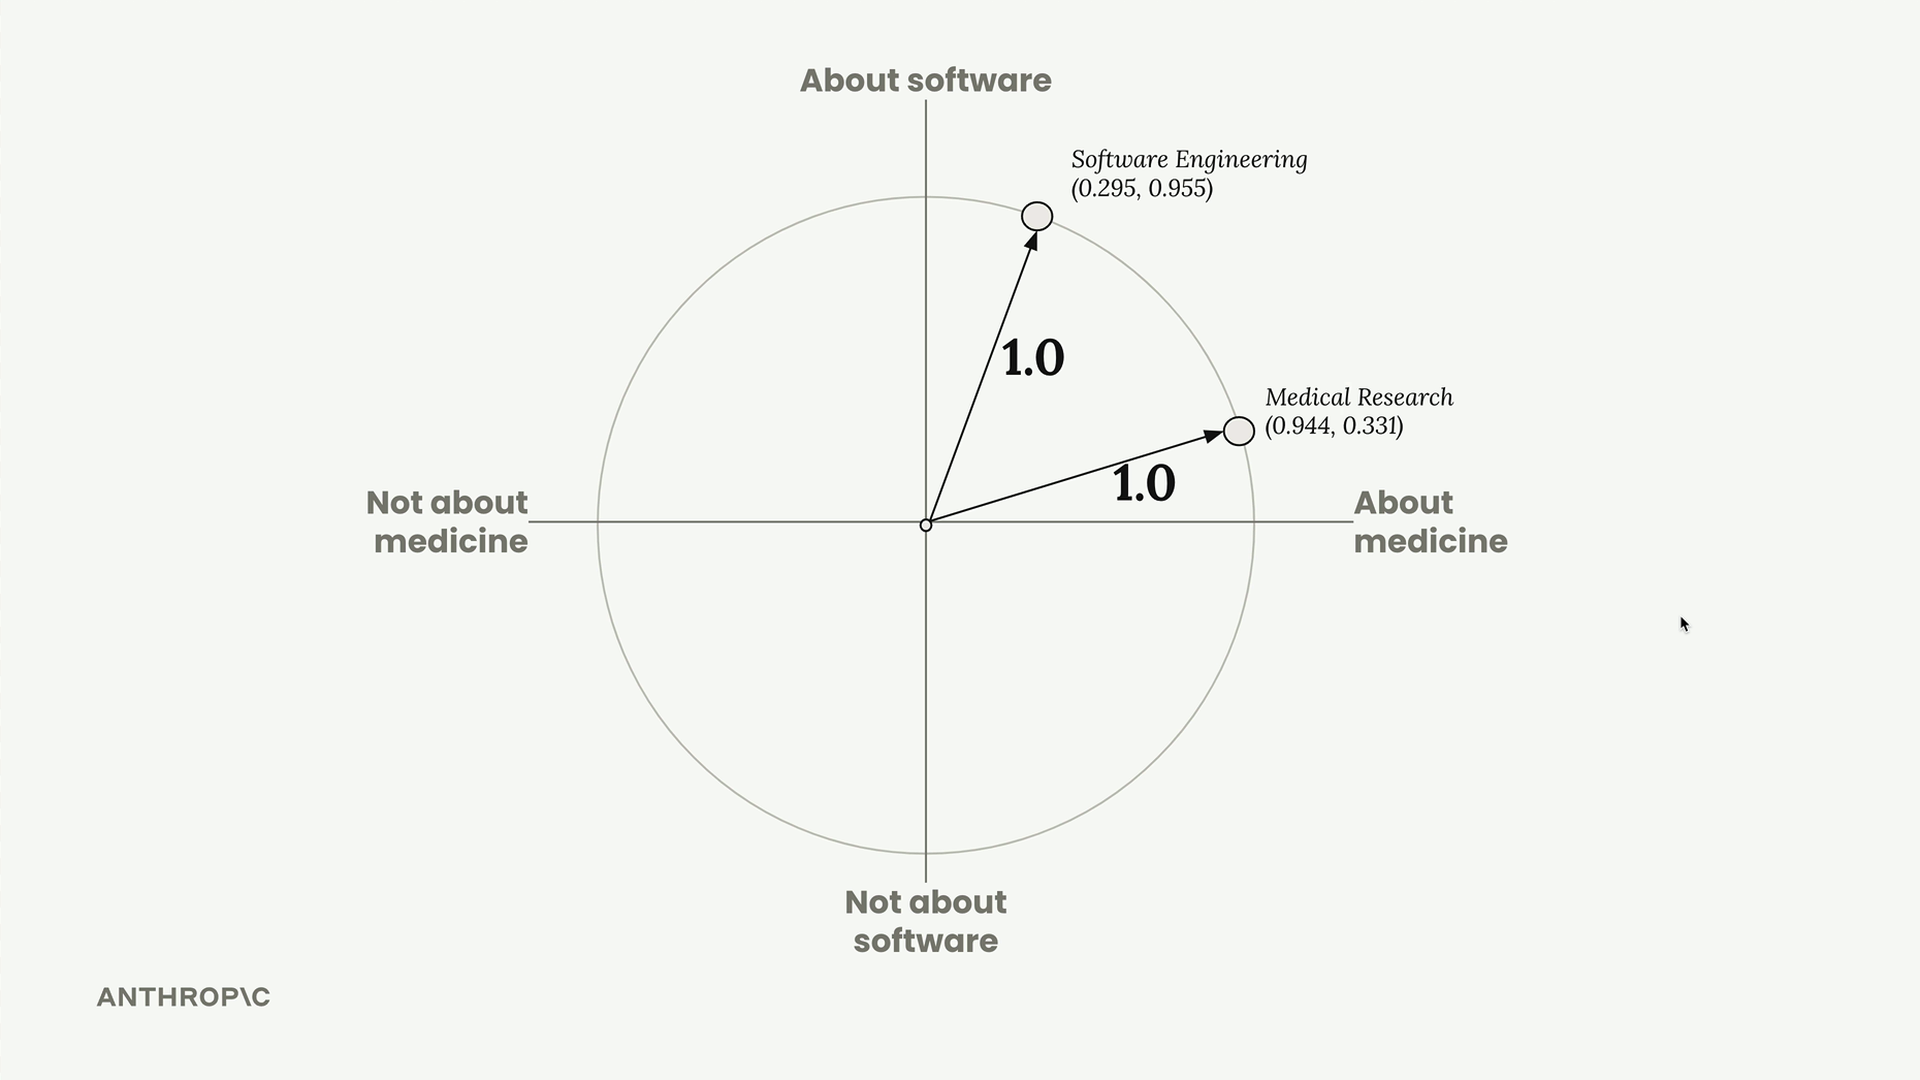
正規化後、私たちのエンベディングは[0.944, 0.331]と[0.295, 0.955]になります。これらを単位円上に可視化すると、両方の点が円の縁上に正確に位置していることがわかります。
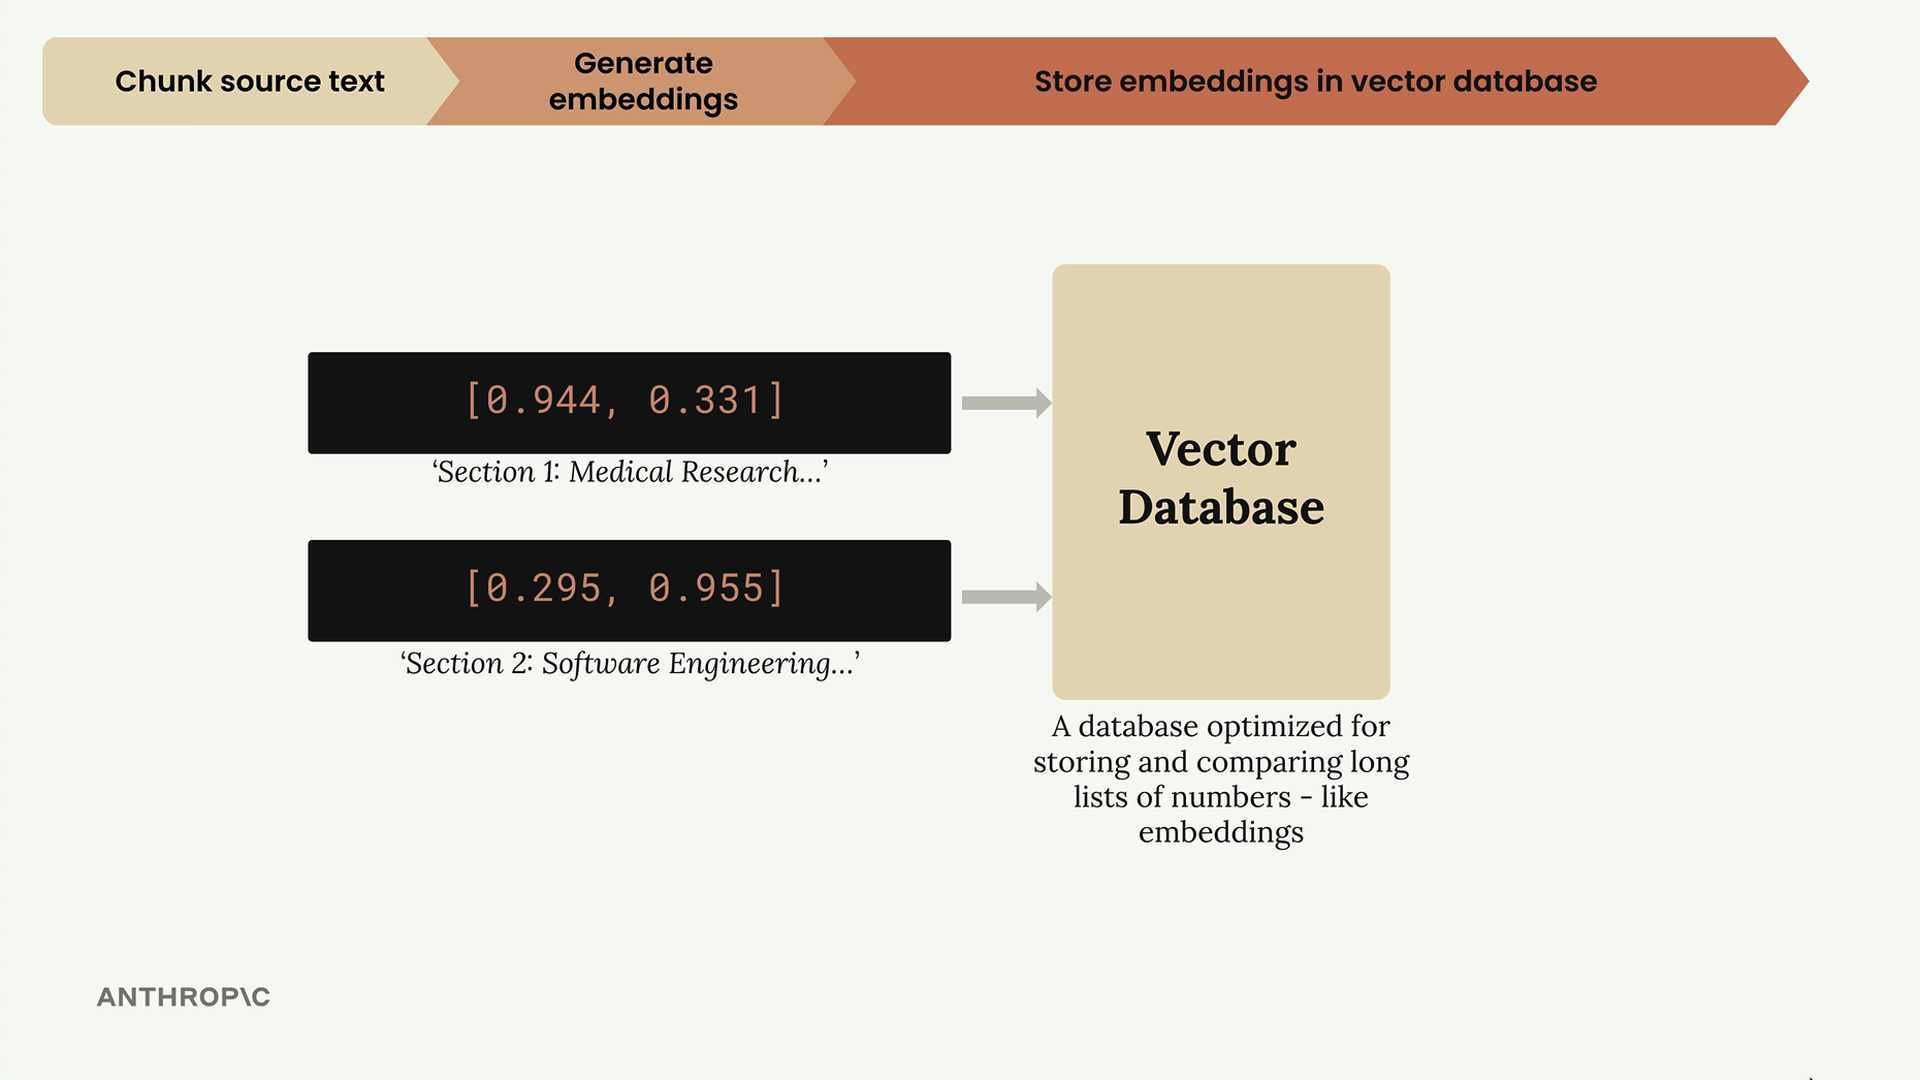
ステップ3:ベクトルデータベースに保存する
正規化されたエンベディングはベクトルデータベース - 私たちのエンベディングのような長い数値のリストを保存、比較、検索するために最適化された特殊なデータベース - に保存されます。
ここで一旦立ち止まります。ここまでの作業はすべて、事前に行われる前処理です。ここからは、ユーザーがクエリを送信するのを待ちます。
ステップ4:ユーザークエリを処理する
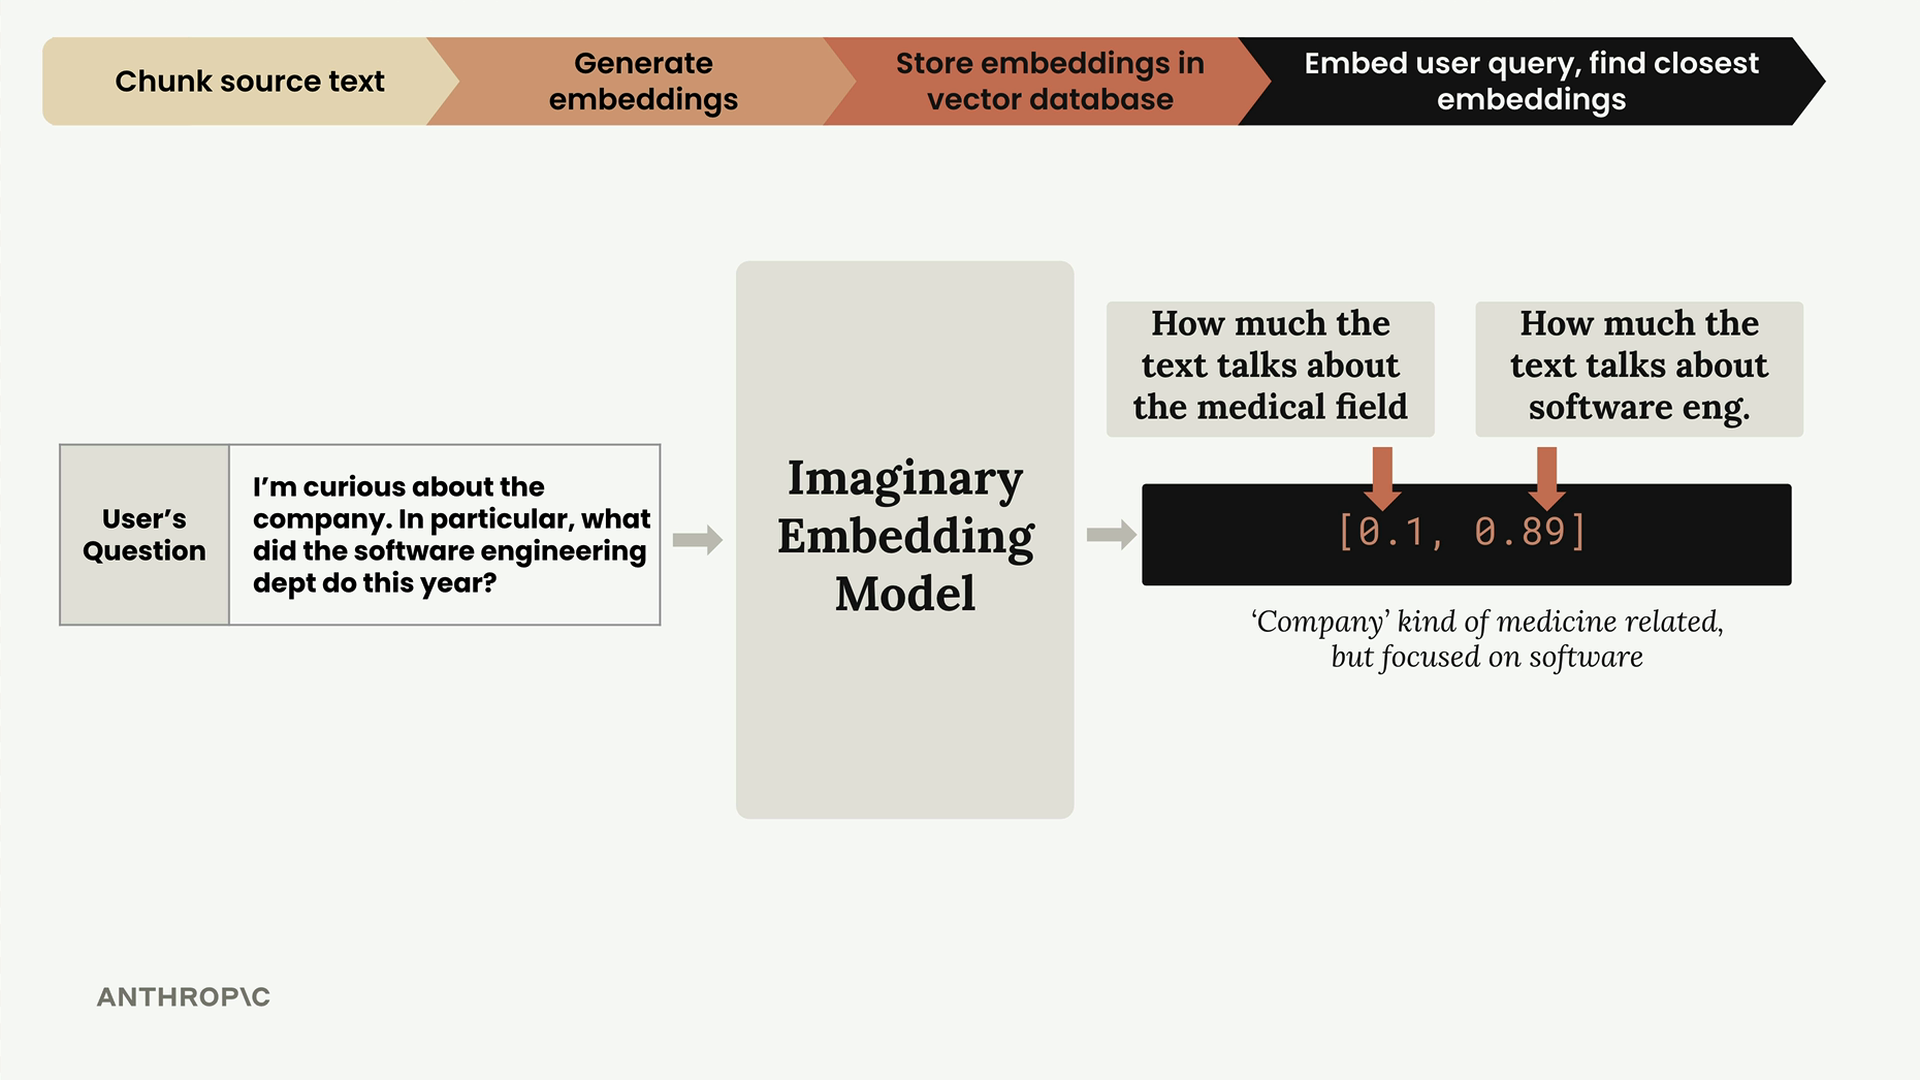
ユーザーが「会社について興味があります。特に、ソフトウェアエンジニアリング部門は今年何をしたのですか?」のような質問をすると、そのクエリを同じエンベディングモデルに通します。
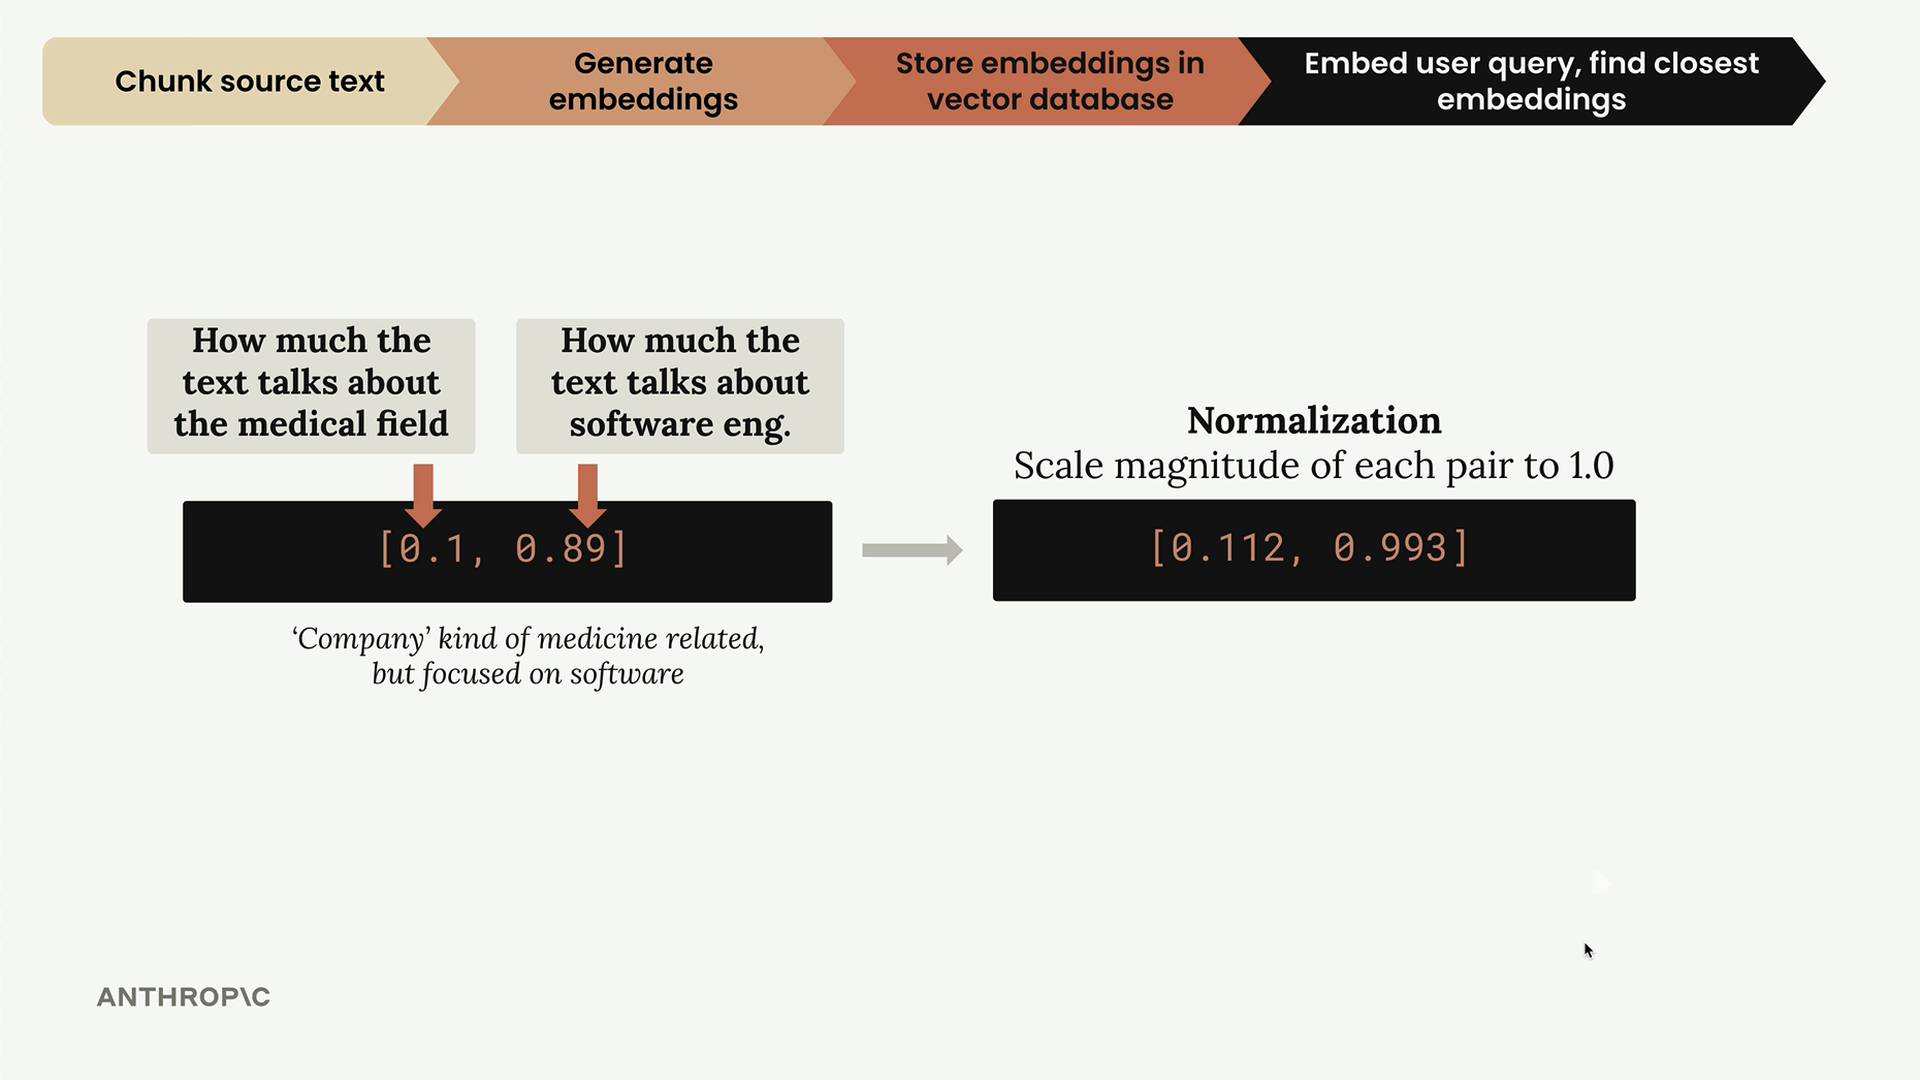
このクエリは[0.1, 0.89]としてエンベディングされます - 医学スコアは低く、ソフトウェアエンジニアリングスコアは高くなります。正規化後、これは[0.112, 0.993]になります。
ステップ5:類似したエンベディングを見つける
次に、ベクトルデータベースに「このユーザークエリのエンベディングに最も近い、保存されているエンベディングを見つけて」と尋ねます。データベースはソフトウェアエンジニアリングのセクションを返します。それが最も類似しているからです。
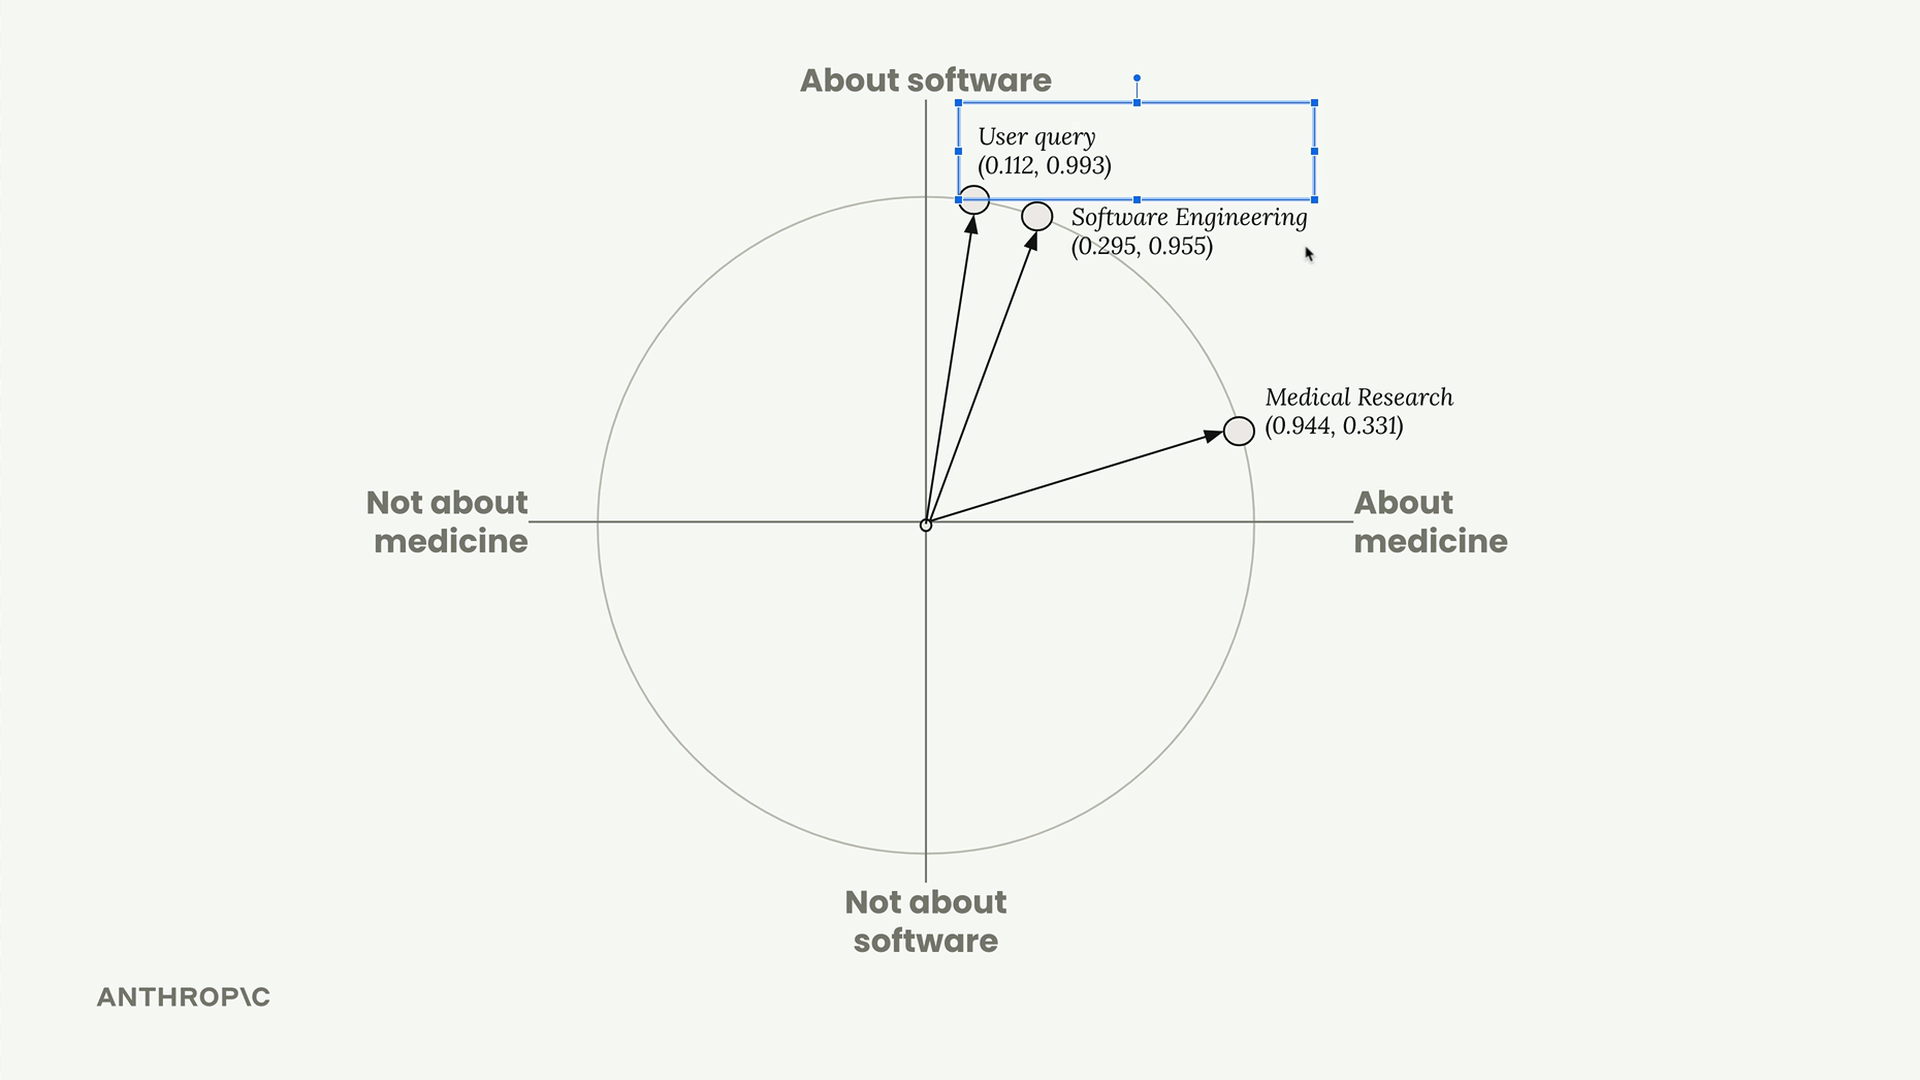
では、データベースはどのようにして「最も近い」を判断するのでしょうか?コサイン類似度を使用します。
コサイン類似度
ベクトルデータベースは、ベクトル間の角度のコサインを計算して類似度を測定します。これにより、-1から1の間の数値が得られます。
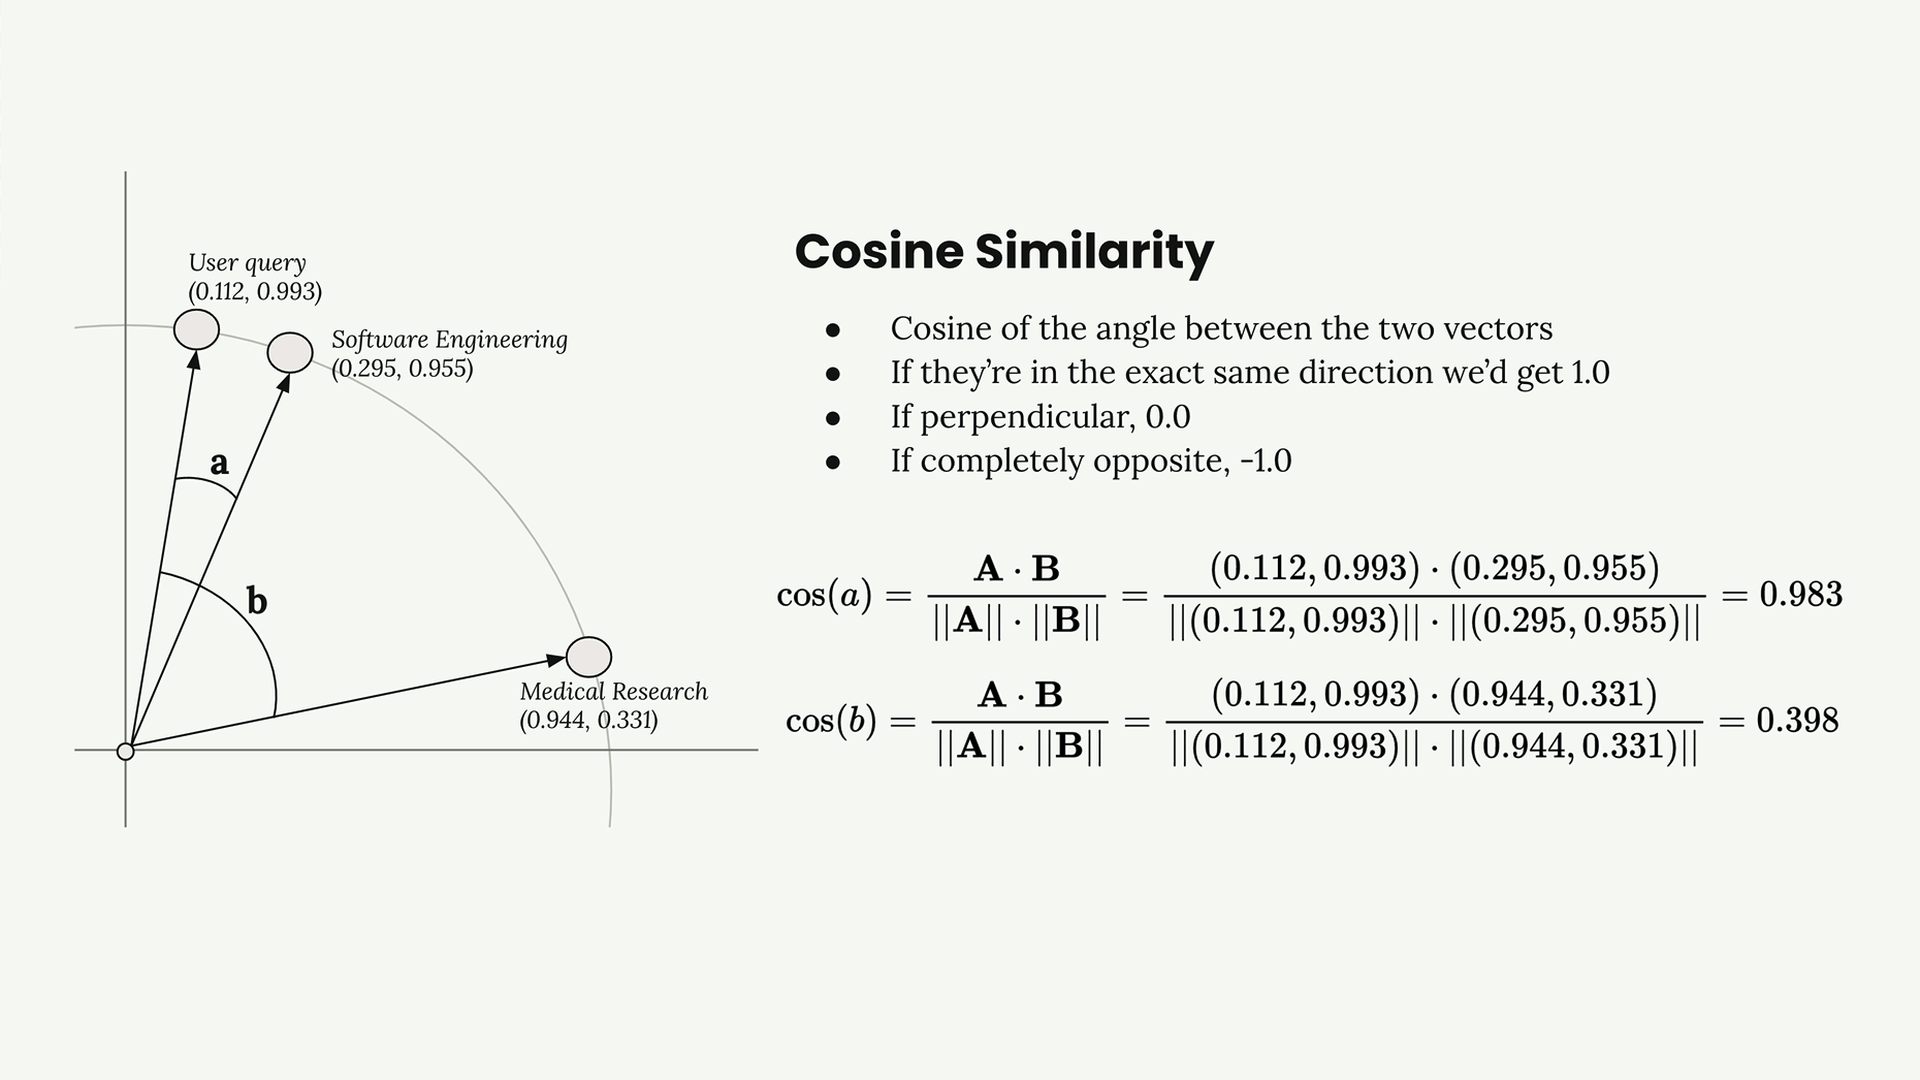
- 1.0 = ベクトルが完全に同じ方向を指している(非常に類似している)
- 0.0 = ベクトルが直交している(無関係)
- -1.0 = ベクトルが反対方向を指している(非常に異なる)
この例では:
- ユーザークエリ対ソフトウェアエンジニアリング:コサイン類似度 = 0.983(非常に類似!)
- ユーザークエリ対医学研究:コサイン類似度 = 0.398(あまり類似していない)
コサイン距離
ベクトルデータベースのドキュメントでは、「コサイン距離」という表現をよく目にすることでしょう。これは単純に1 - コサイン類似度であり、数値が小さいほど類似性が高いことを意味するようにスケールを反転させたものです。
- 0.0 = 非常に類似している
- 1.0 = 直交している
- 2.0 = 完全に正反対
ステップ6:最終的なプロンプトを構築する
最後に、ユーザーの質問と最も関連性の高いテキストチャンク(ソフトウェアエンジニアリングのセクション)を取り出し、それらを組み合わせてClaude向けのプロンプトを作成します。
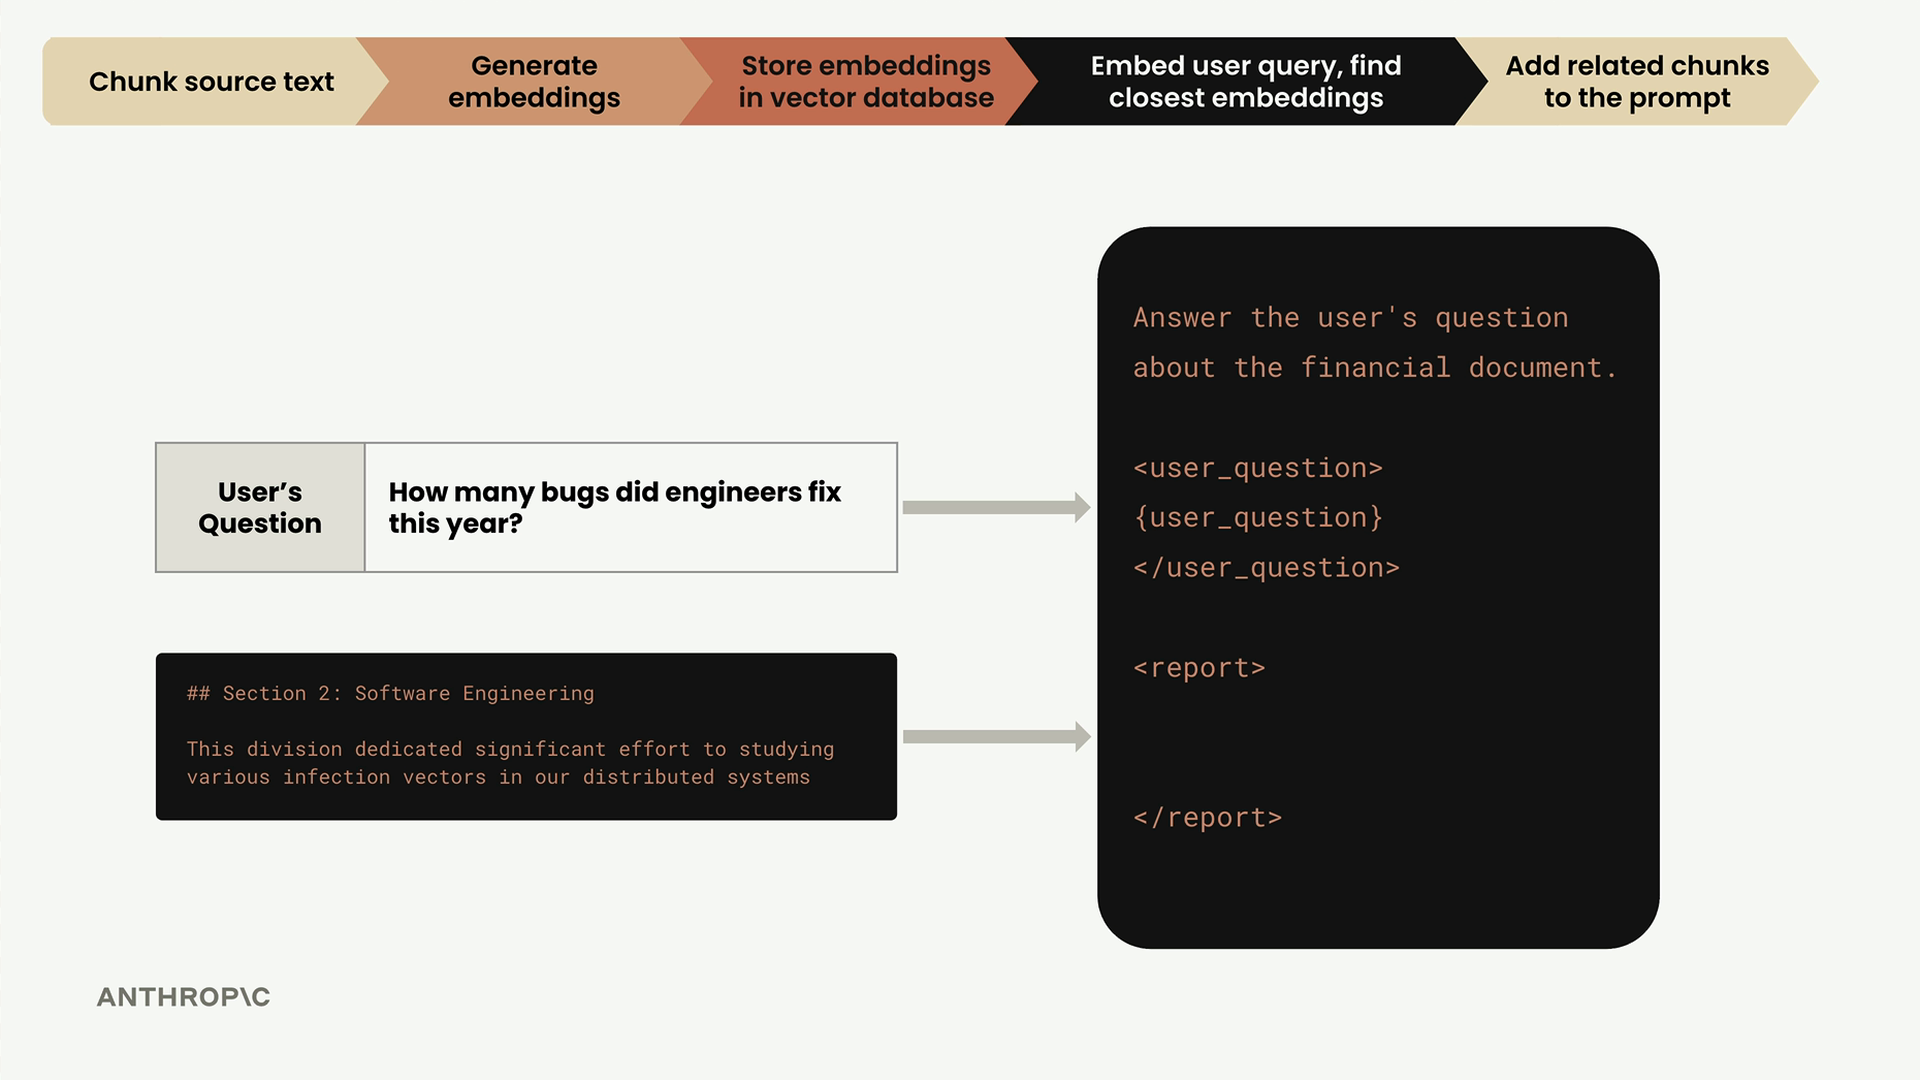
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>これで完全なRAGパイプラインの完成です!このシステムは、ユーザーのソフトウェアエンジニアリングに関する質問に最も関連性の高いコンテキストを正常に見つけ出し、それをClaudeに提供して、情報に基づいた応答を生成させました。
このプロセスは、ユーザーがクエリを送信するたびに自動的に実行され、Claudeが一般的な学習知識だけでなく、あなたの特定のドキュメントに基づいて質問に答えられるようにします。