ここまでRAG、テキストのチャンク化、そして埋め込みの基本について説明してきたので、RAGパイプライン全体をステップごとに詳しく見ていきましょう。この詳細な例では、実際の実装においてすべての要素がどのように組み合わさるのかを正確に示します。
ステップ1: ソーステキストをチャンク化する
まず、ソースドキュメントを取り、扱いやすいチャンクに分割します。この例では、2つのシンプルなテキストセクションを使用します。
- セクション1: 医学研究 - 「今年は、これまで見たことのない『bug(バグ)』であるXDR-47についての理解が大きく進展しました。」
- セクション2: ソフトウェアエンジニアリング - 「この部門は、分散システムにおけるさまざまな感染経路の研究に多大な努力を注ぎました」
ステップ2: 埋め込みを生成する
次に、各テキストチャンクを数値の埋め込みに変換します。この概念をわかりやすくするために、常にちょうど2つの数値を返す完璧な埋め込みモデルがあり、それぞれの数値が何を表すか分かっているとしましょう。
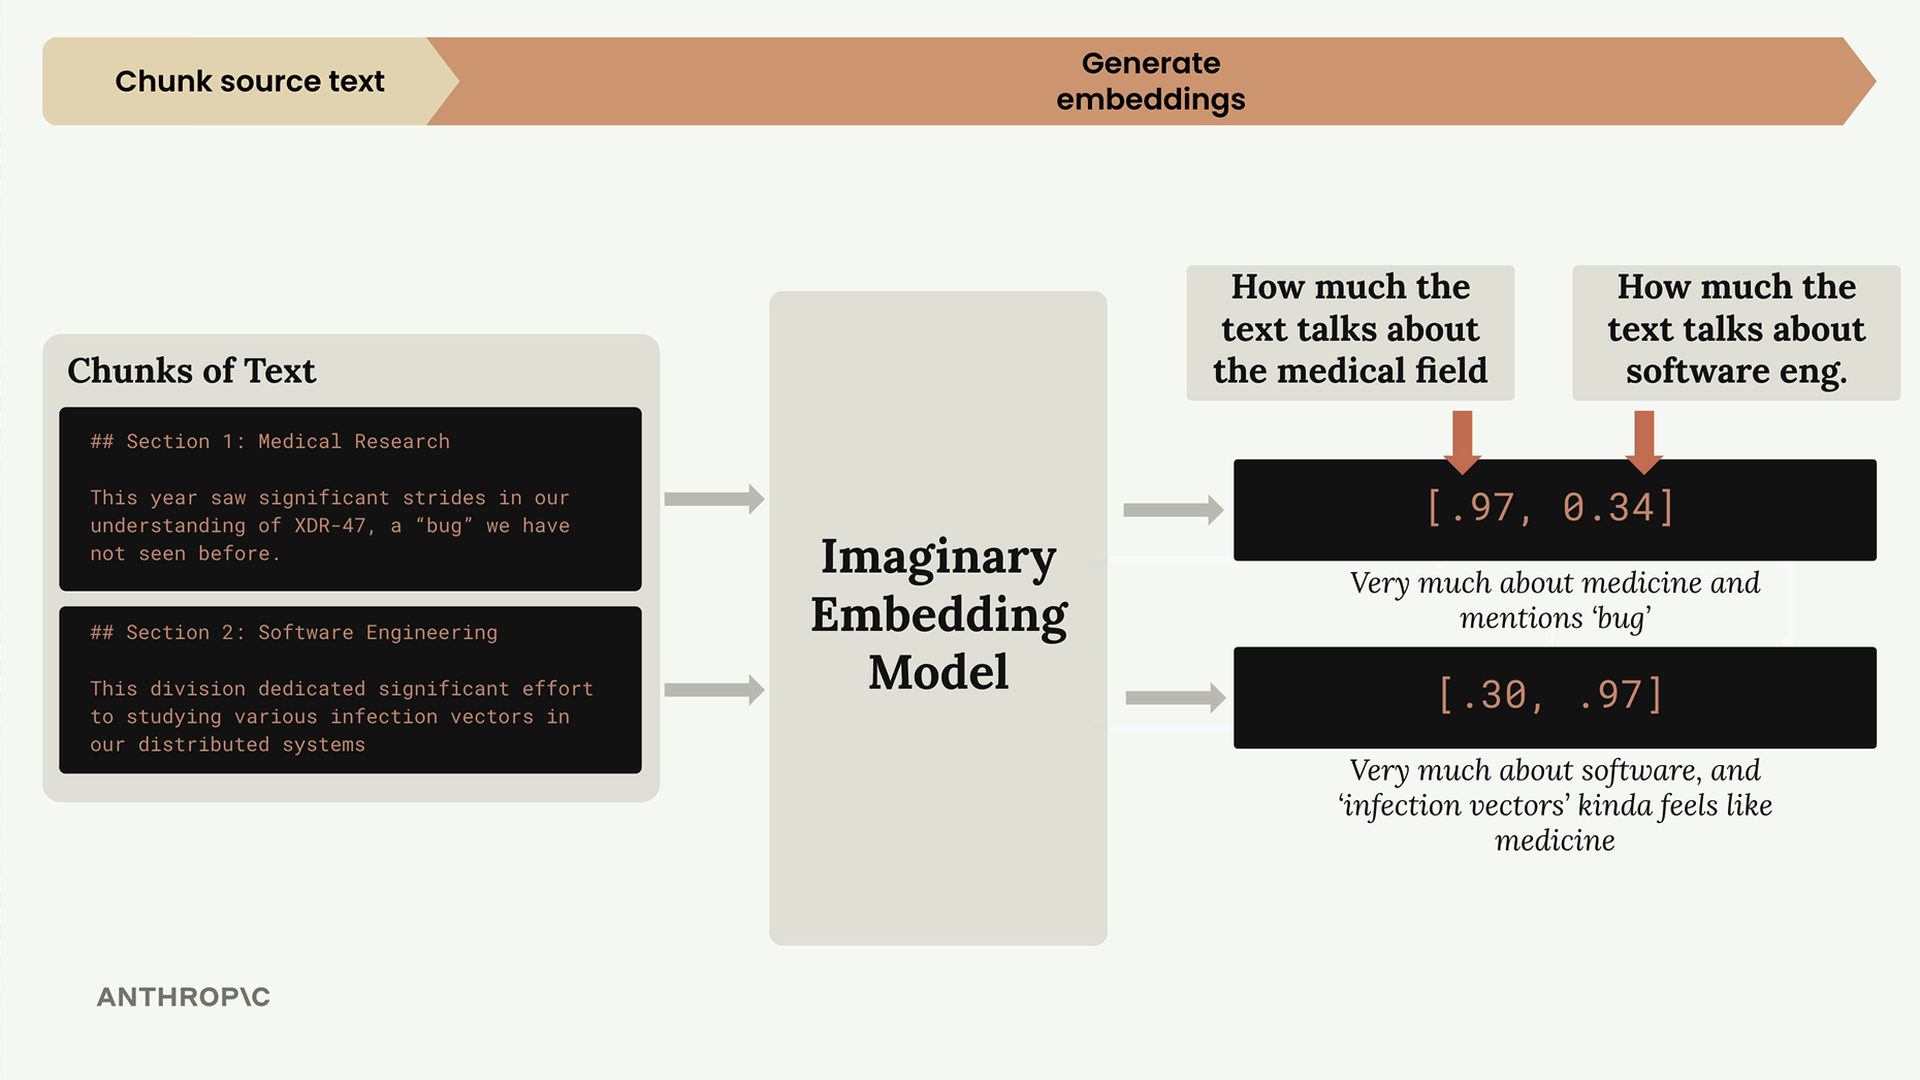
この架空のモデルでは:
- 1番目の数値: テキストが医学分野についてどの程度言及しているか
- 2番目の数値: テキストがソフトウェアエンジニアリングについてどの程度言及しているか
そのため、医学研究セクションの埋め込みは [0.97, 0.34] となります - 非常に医学的ですが、「bug」という単語のためにソフトウェア関連もやや含まれます。ソフトウェアエンジニアリングセクションは [0.30, 0.97] となります - 非常にソフトウェア寄りですが、「感染経路」には医学的な含意があります。
正規化
これらの埋め込みを保存する前に、各ベクトルの大きさを1.0にスケーリングする正規化処理が行われます。これは通常、埋め込みAPIによって自動的に処理されますが、そうした処理が行われているということを理解しておくことが重要です。
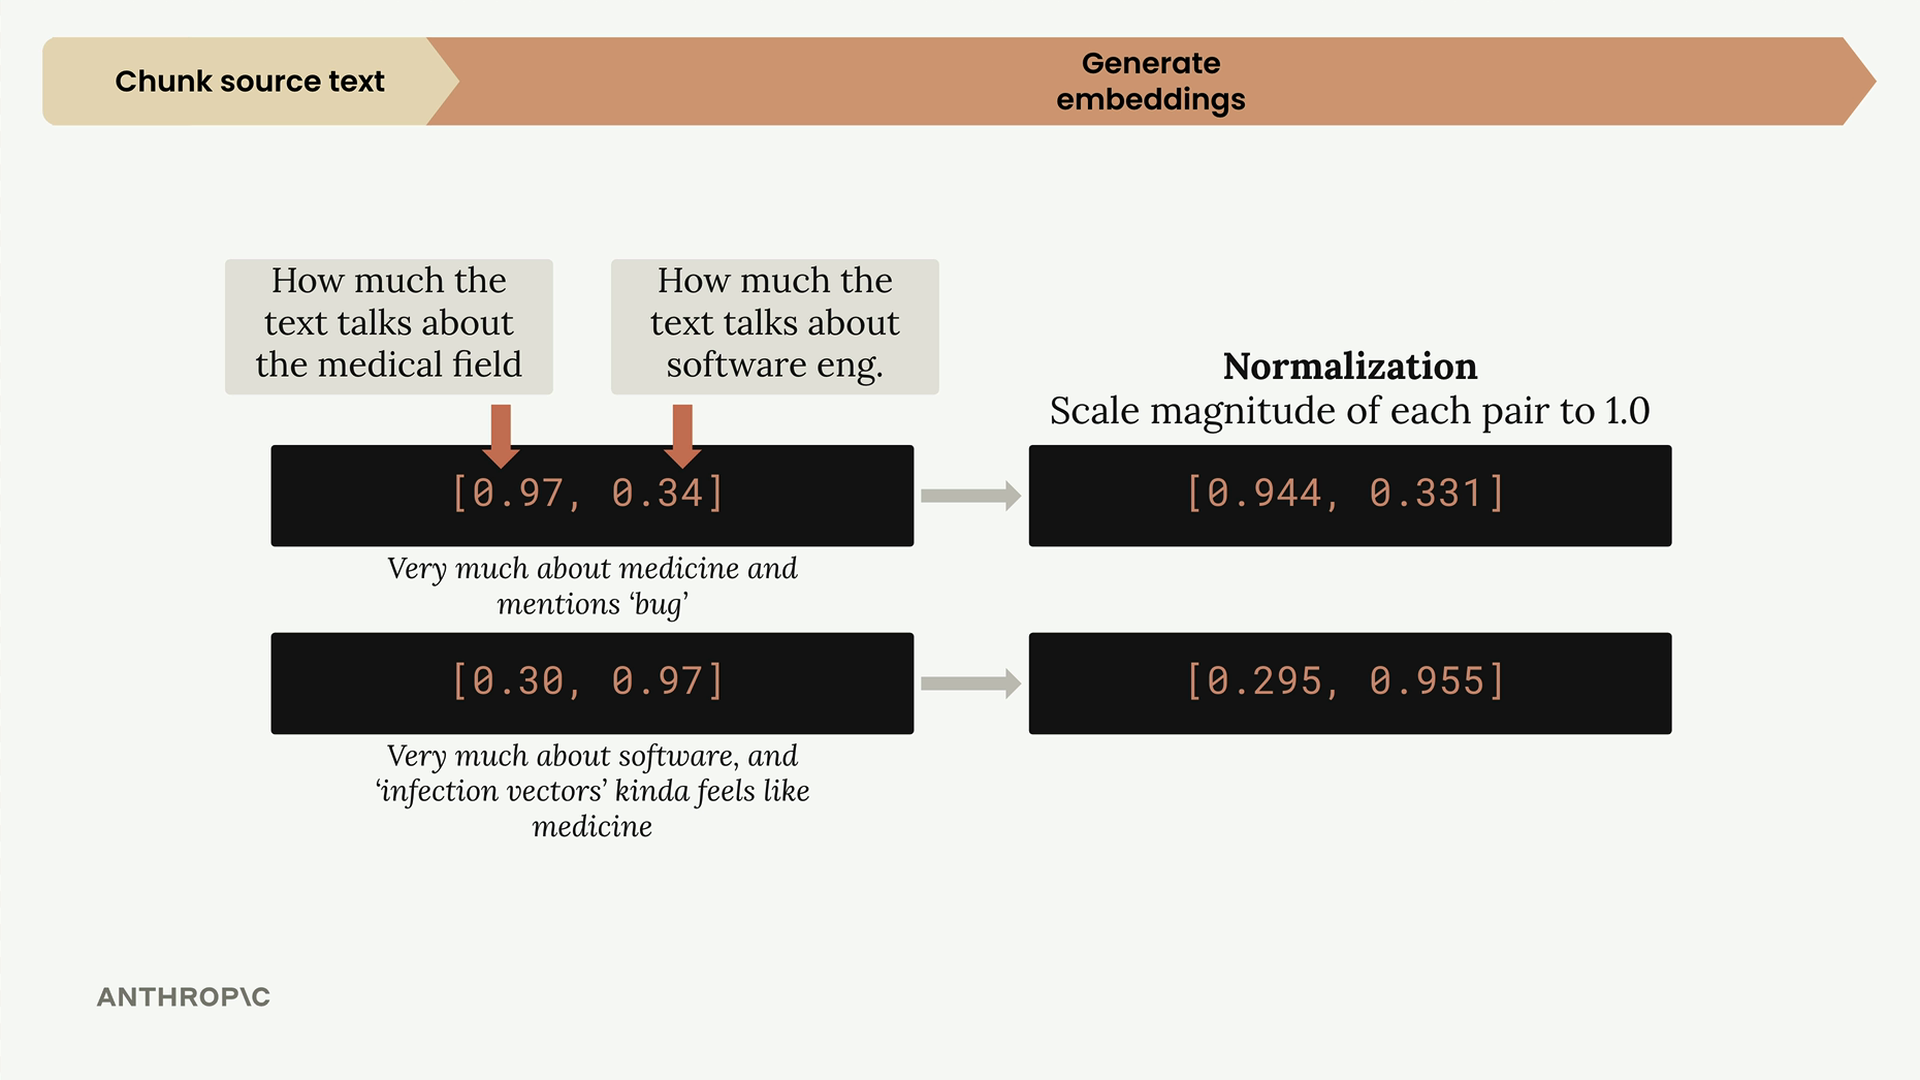
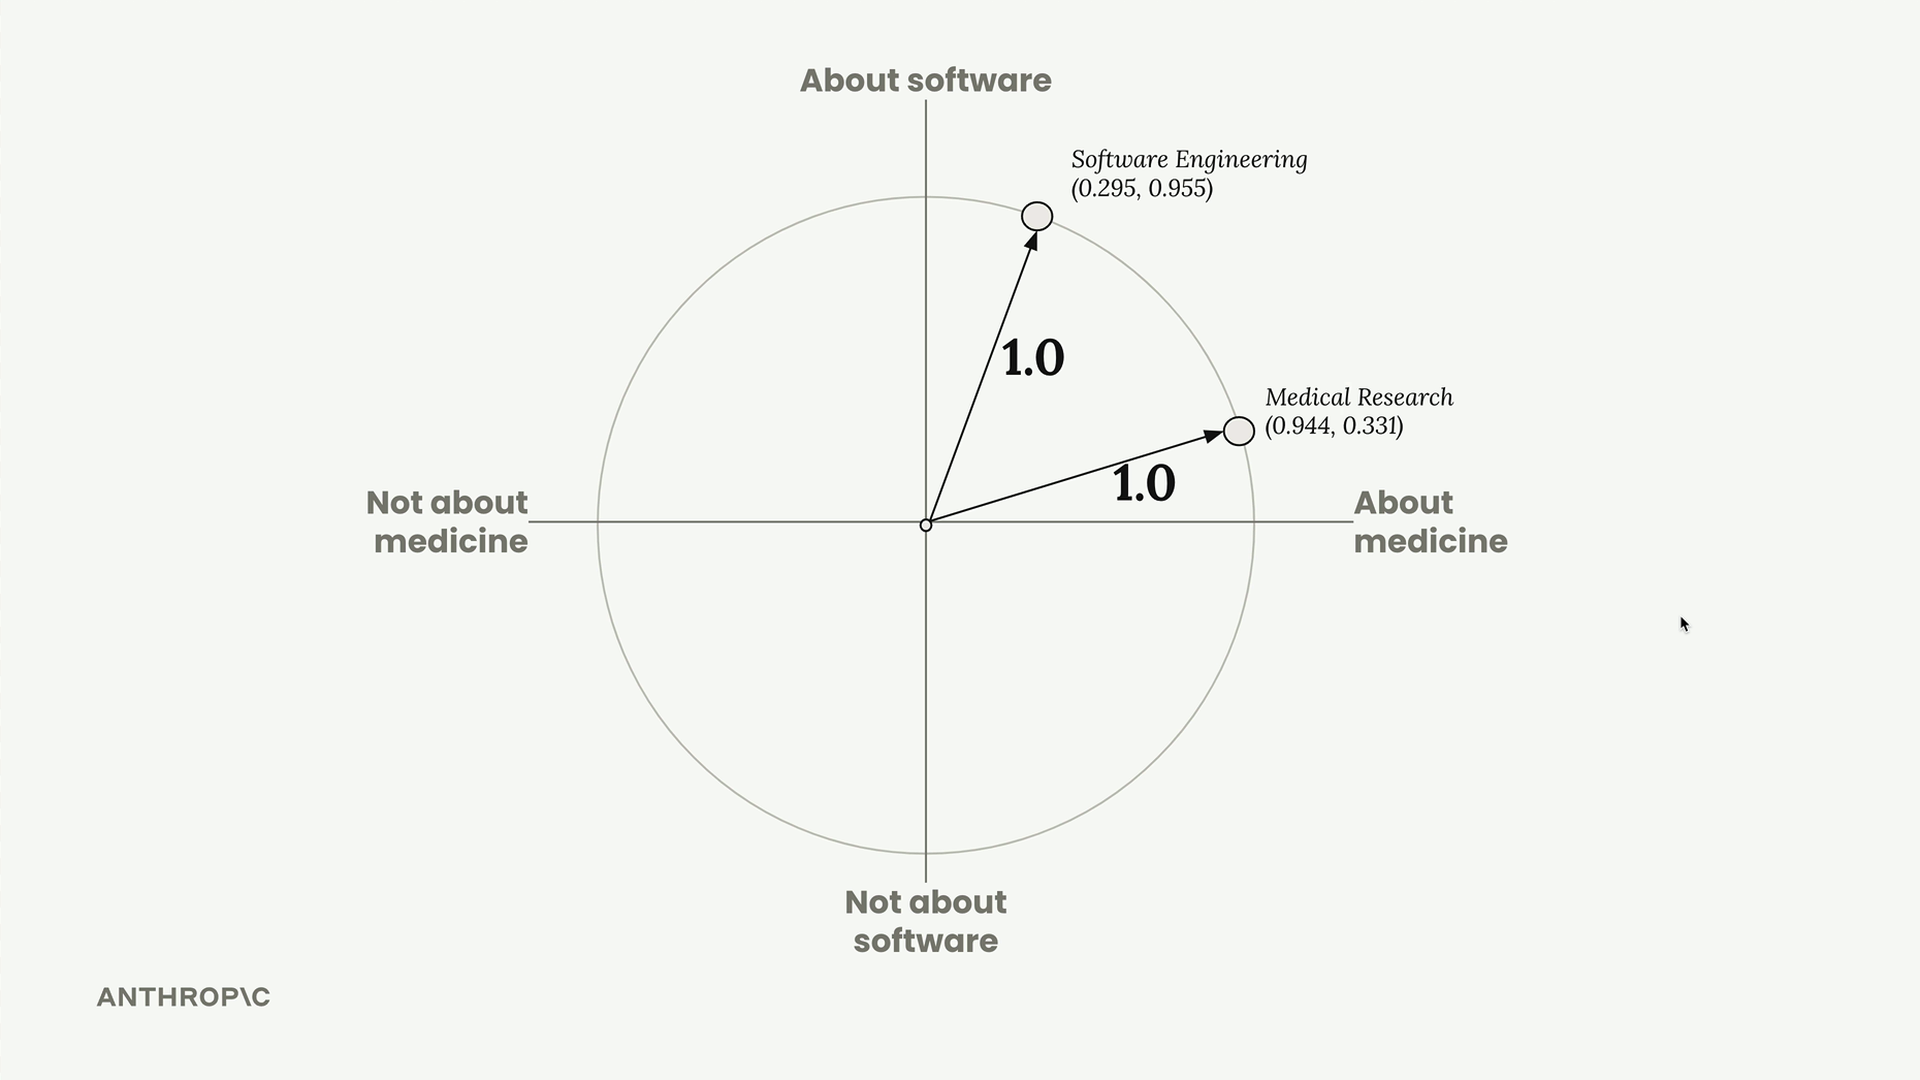
正規化後、私たちの埋め込みは [0.944, 0.331] と [0.295, 0.955] になります。これらを単位円上に可視化すると、各点はちょうど円の縁上に位置します。
ステップ3: ベクトルデータベースに保存する
正規化された埋め込みはベクトルデータベースに保存されます。これは、私たちの埋め込みのような長い数値リストを保存・比較・検索するために最適化された特殊なデータベースです。
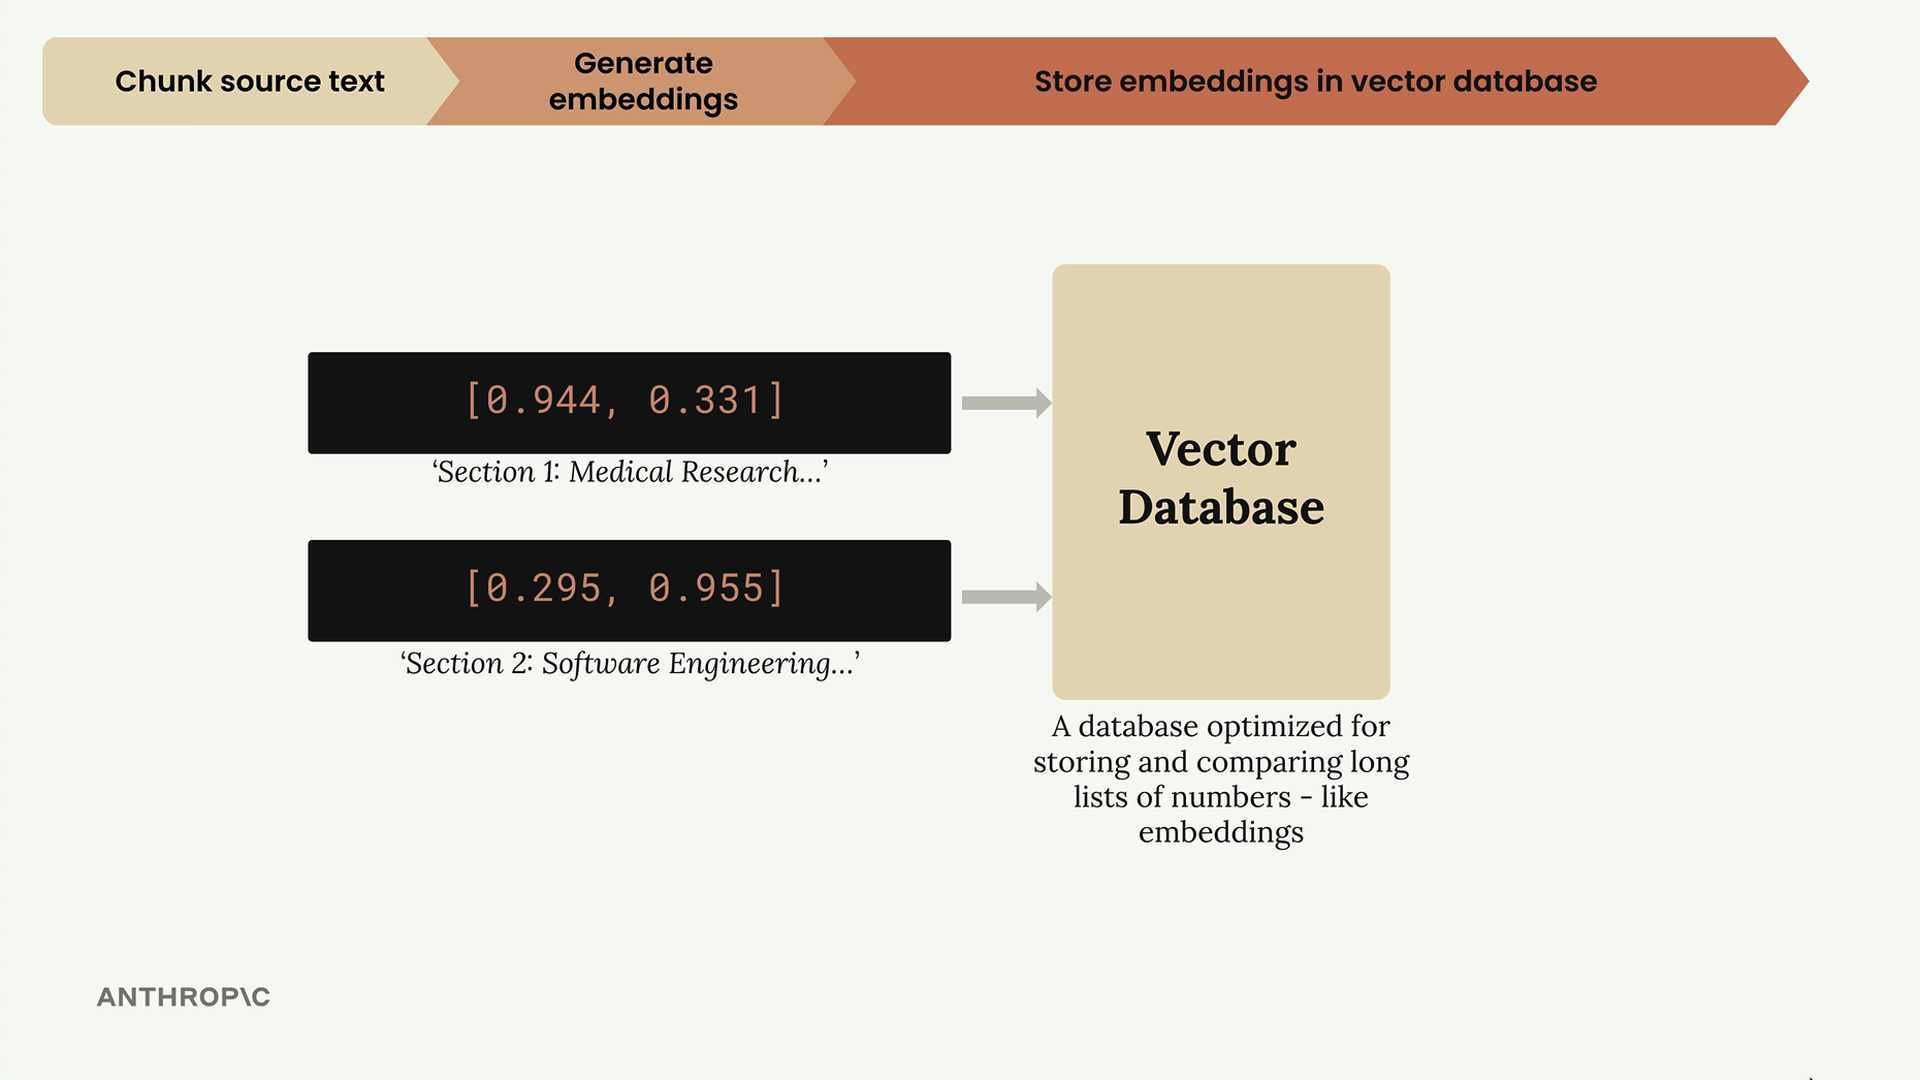
ここで一旦立ち止まりましょう。ここまでの作業はすべて、事前に行われる前処理です。これからは、ユーザーが質問を送信するのを待ちます。
ステップ4: ユーザーのクエリを処理する
ユーザーが「会社について興味があります。特に、今年ソフトウェアエンジニアリング部門は何をしましたか?」といった質問をすると、そのクエリを同じ埋め込みモデルに通します。
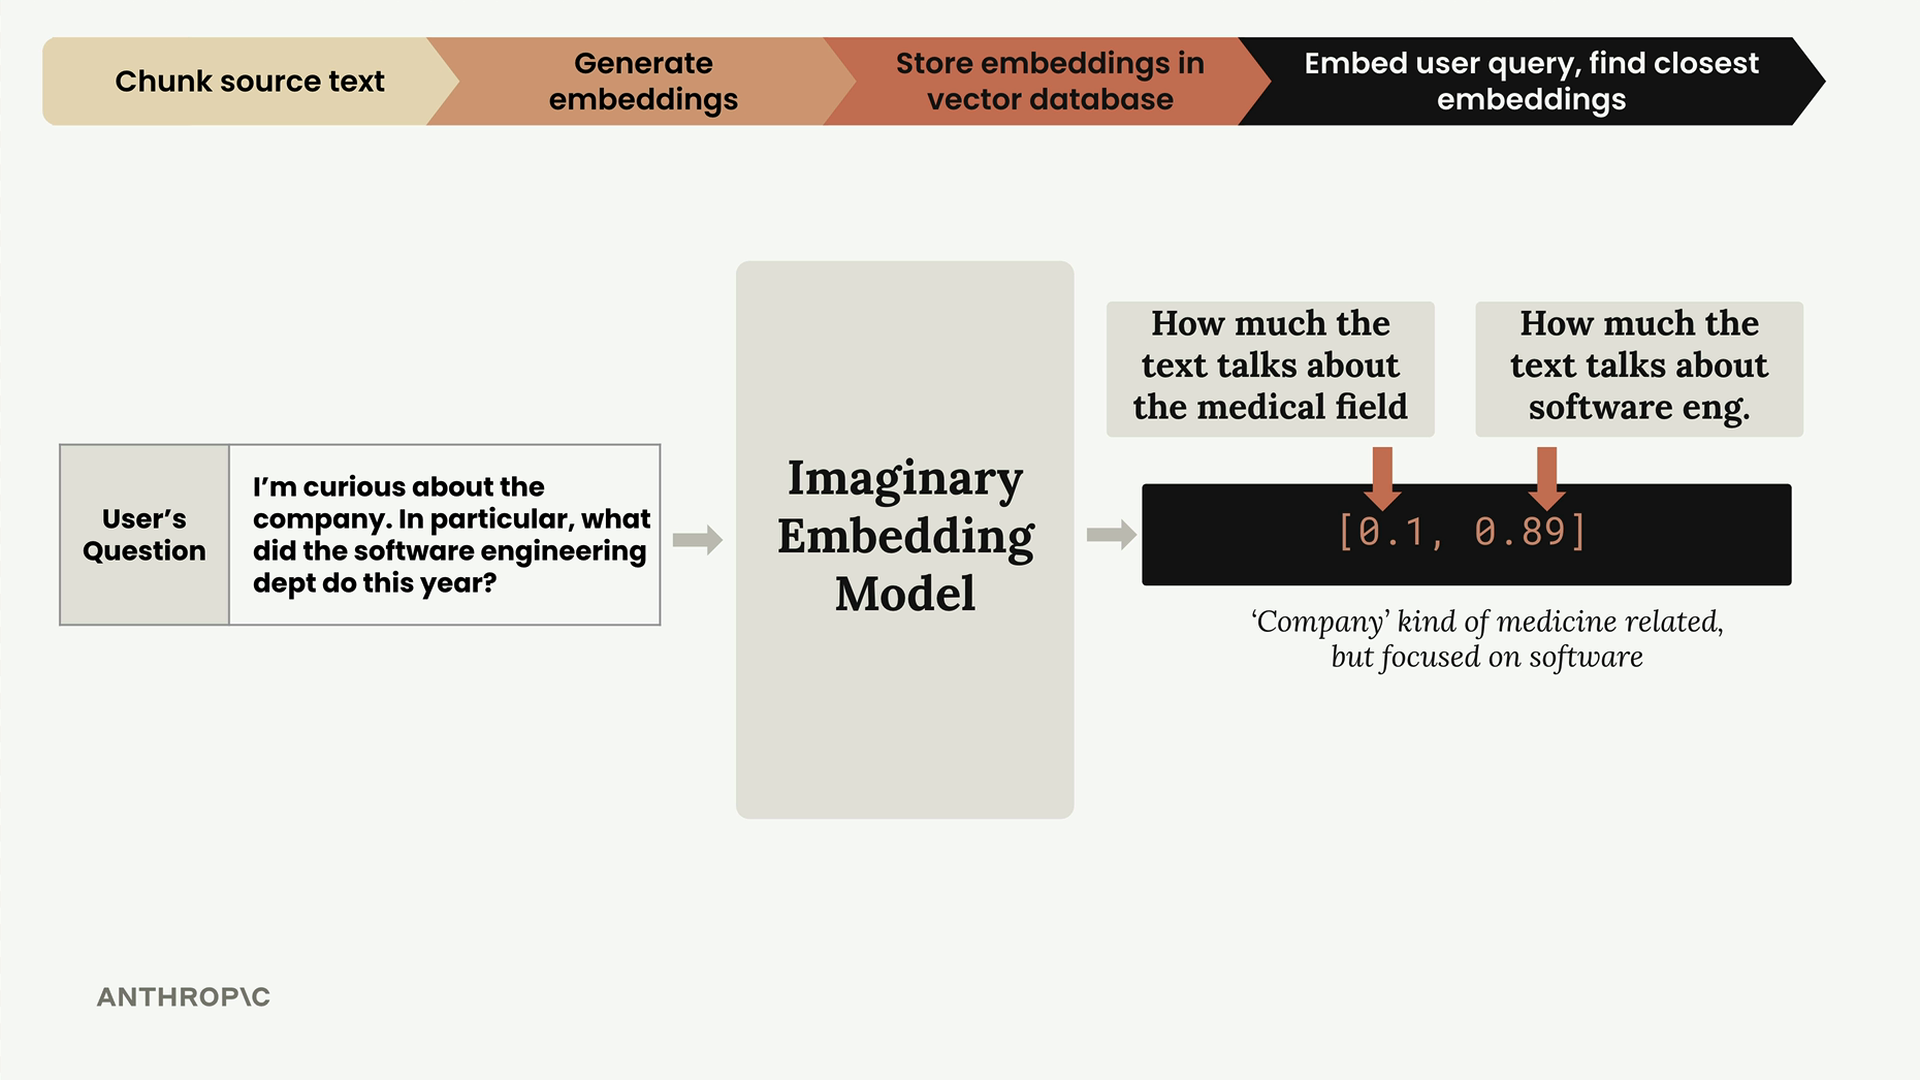
このクエリは [0.1, 0.89] として埋め込まれます - 医学スコアは低く、ソフトウェアエンジニアリングスコアは高くなっています。正規化後は [0.112, 0.993] になります。
ステップ5: 類似する埋め込みを見つける
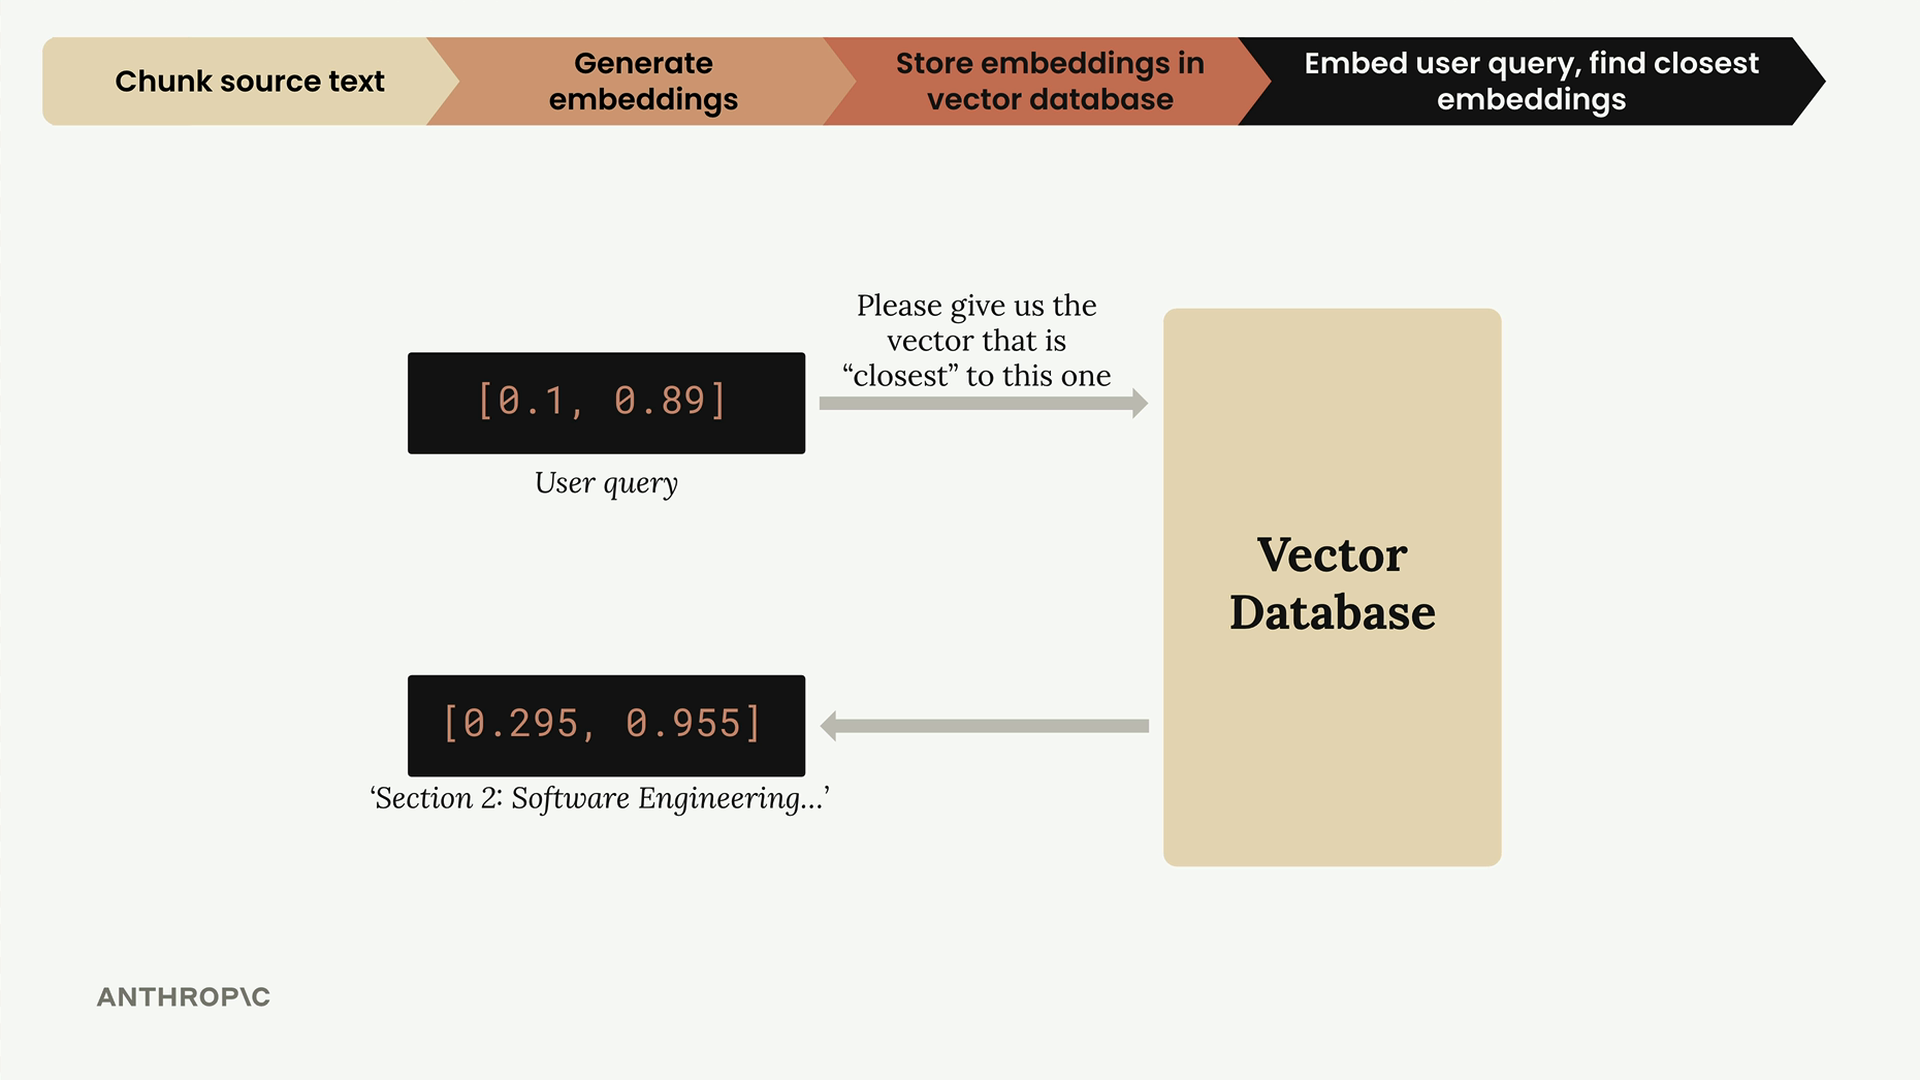
次に、ベクトルデータベースに「このユーザークエリの埋め込みに最も近い保存済みの埋め込みを見つけて」と尋ねます。データベースはソフトウェアエンジニアリングセクションを返します。それが最も類似しているからです。
類似度の仕組み: コサイン類似度
ベクトルデータベースは、どの埋め込みが最も類似しているかを判断するためにコサイン類似度を使用します。これは2つのベクトル間の角度の余弦を測定するものです。
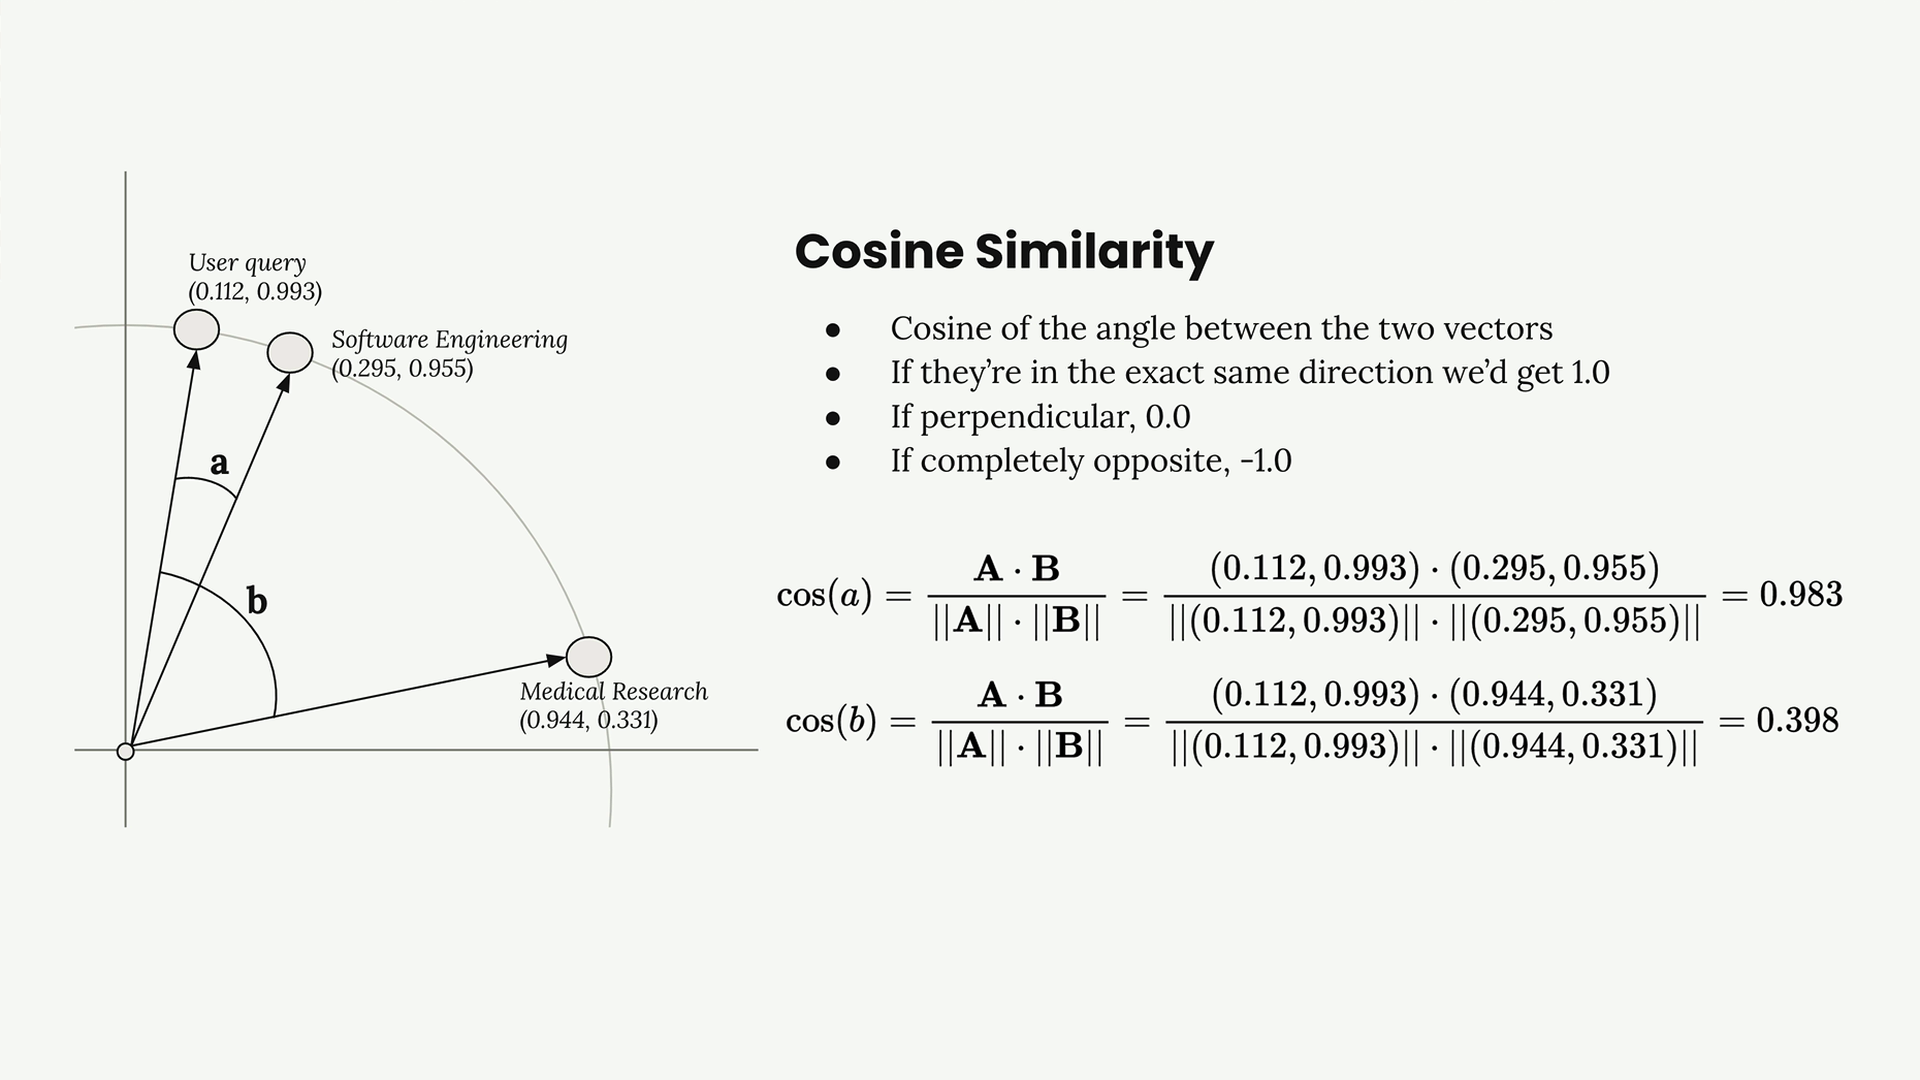
コサイン類似度に関する重要なポイント:
- 結果は -1 から 1 の範囲になります
- 1に近い値は非常に類似していることを意味します
- 0に近い値は直交している(無関係)ことを意味します
- -1に近い値は完全に正反対であることを意味します
この計算には内積の公式を使用します: cos(a) = (A · B) / (||A|| · ||B||)
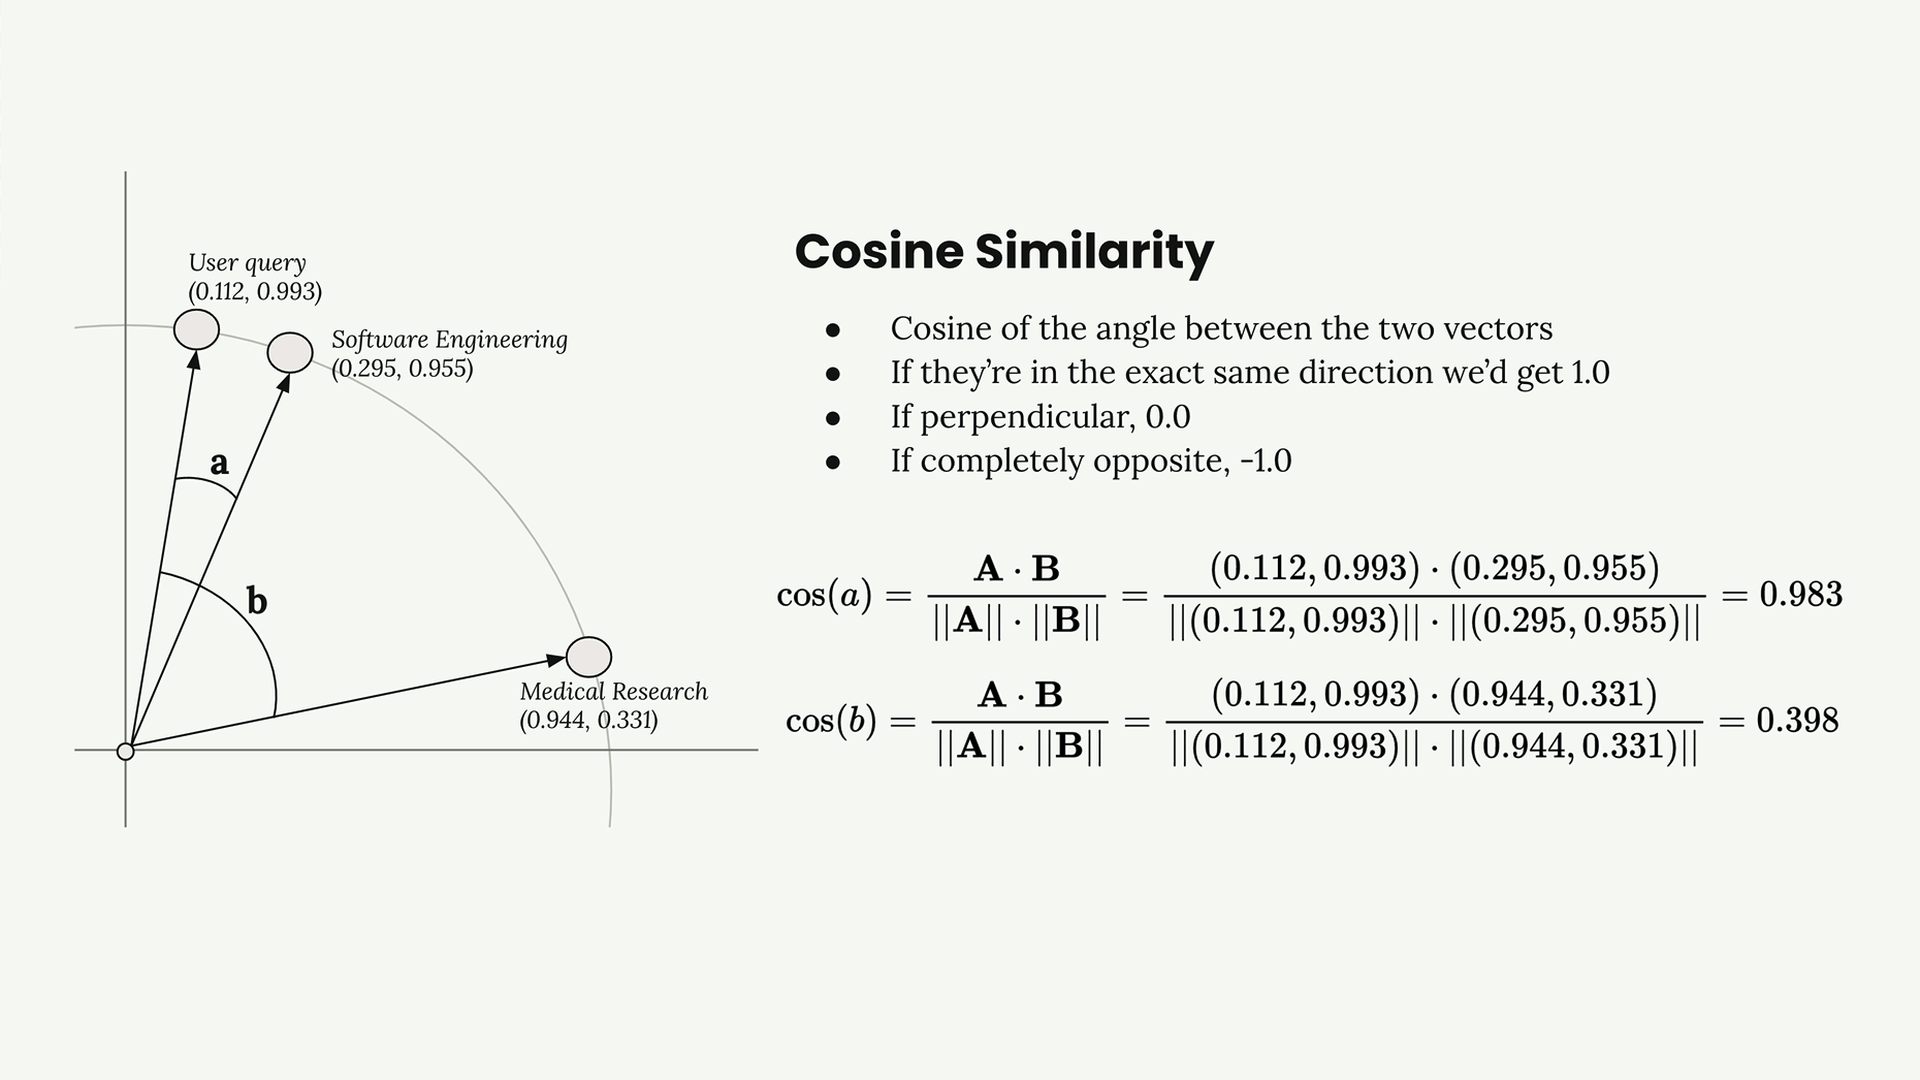
この例では、ユーザークエリはソフトウェアエンジニアリングのチャンクとのコサイン類似度が0.983であるのに対し、医学研究のチャンクとは0.398にすぎません。ソフトウェアエンジニアリングのチャンクが明らかに優れた一致です。
コサイン距離
ベクトルデータベースのドキュメントでは「コサイン距離」という用語をよく目にするでしょう。これは単に 1 - コサイン類似度 であり、次のように解釈しやすい数値を得ることができます。
- 0に近い値は高い類似度を意味します
- 値が大きいほど類似度が低いことを意味します
ステップ6: 最終的なプロンプトを構築する
最後に、ユーザーの質問と見つかった最も関連性の高いテキストチャンクを取り、それらを組み合わせてClaudeへのプロンプトを作成します。
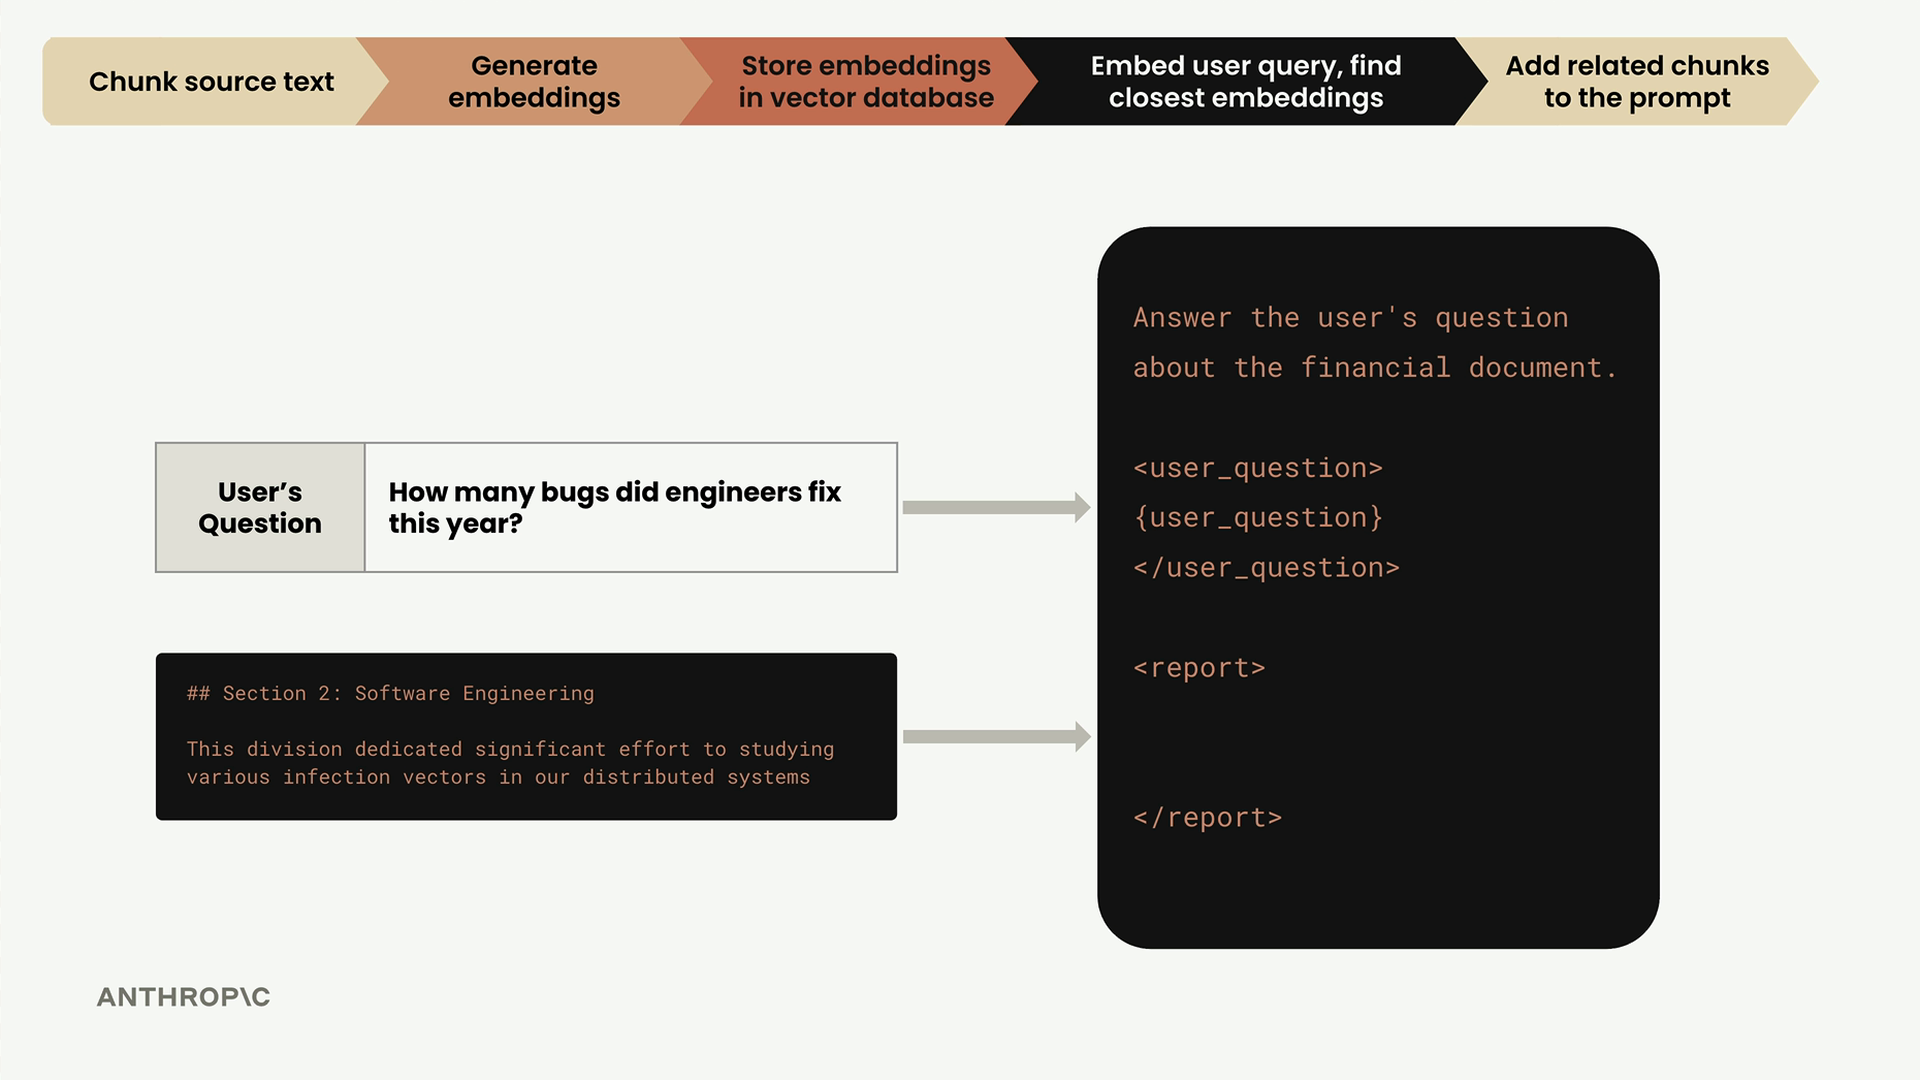
このプロンプトにはユーザーの質問と、ドキュメントから見つけた関連コンテキストの両方が含まれており、Claudeがナレッジベース内の特定の情報に基づいた的確な回答を提供できるようになります。
全体のフロー
以上が、最初から最後までのRAGパイプライン全体です。
- ソースドキュメントをチャンク化する
- 各チャンクの埋め込みを生成する
- 埋め込みをベクトルデータベースに保存する
- ユーザーが質問をしたら、そのクエリを埋め込む
- コサイン類似度を使って最も類似した保存済み埋め込みを見つける
- 関連するチャンクをユーザーの質問とともにプロンプトに追加する
- 拡張されたプロンプトをClaudeに送信して応答を得る
このプロセスとその背後にある数学を理解することで、ベクトルデータベースを効果的に扱い、RAGシステムが期待通りの結果を返さない場合に問題をデバッグする際に役立つでしょう。