コンテキスト検索は、RAGパイプラインの精度を向上させる手法で、根本的な問題を解決します。文書をチャンクに分割すると、各チャンクがより広い文書のコンテキストとのつながりを失ってしまうという問題です。
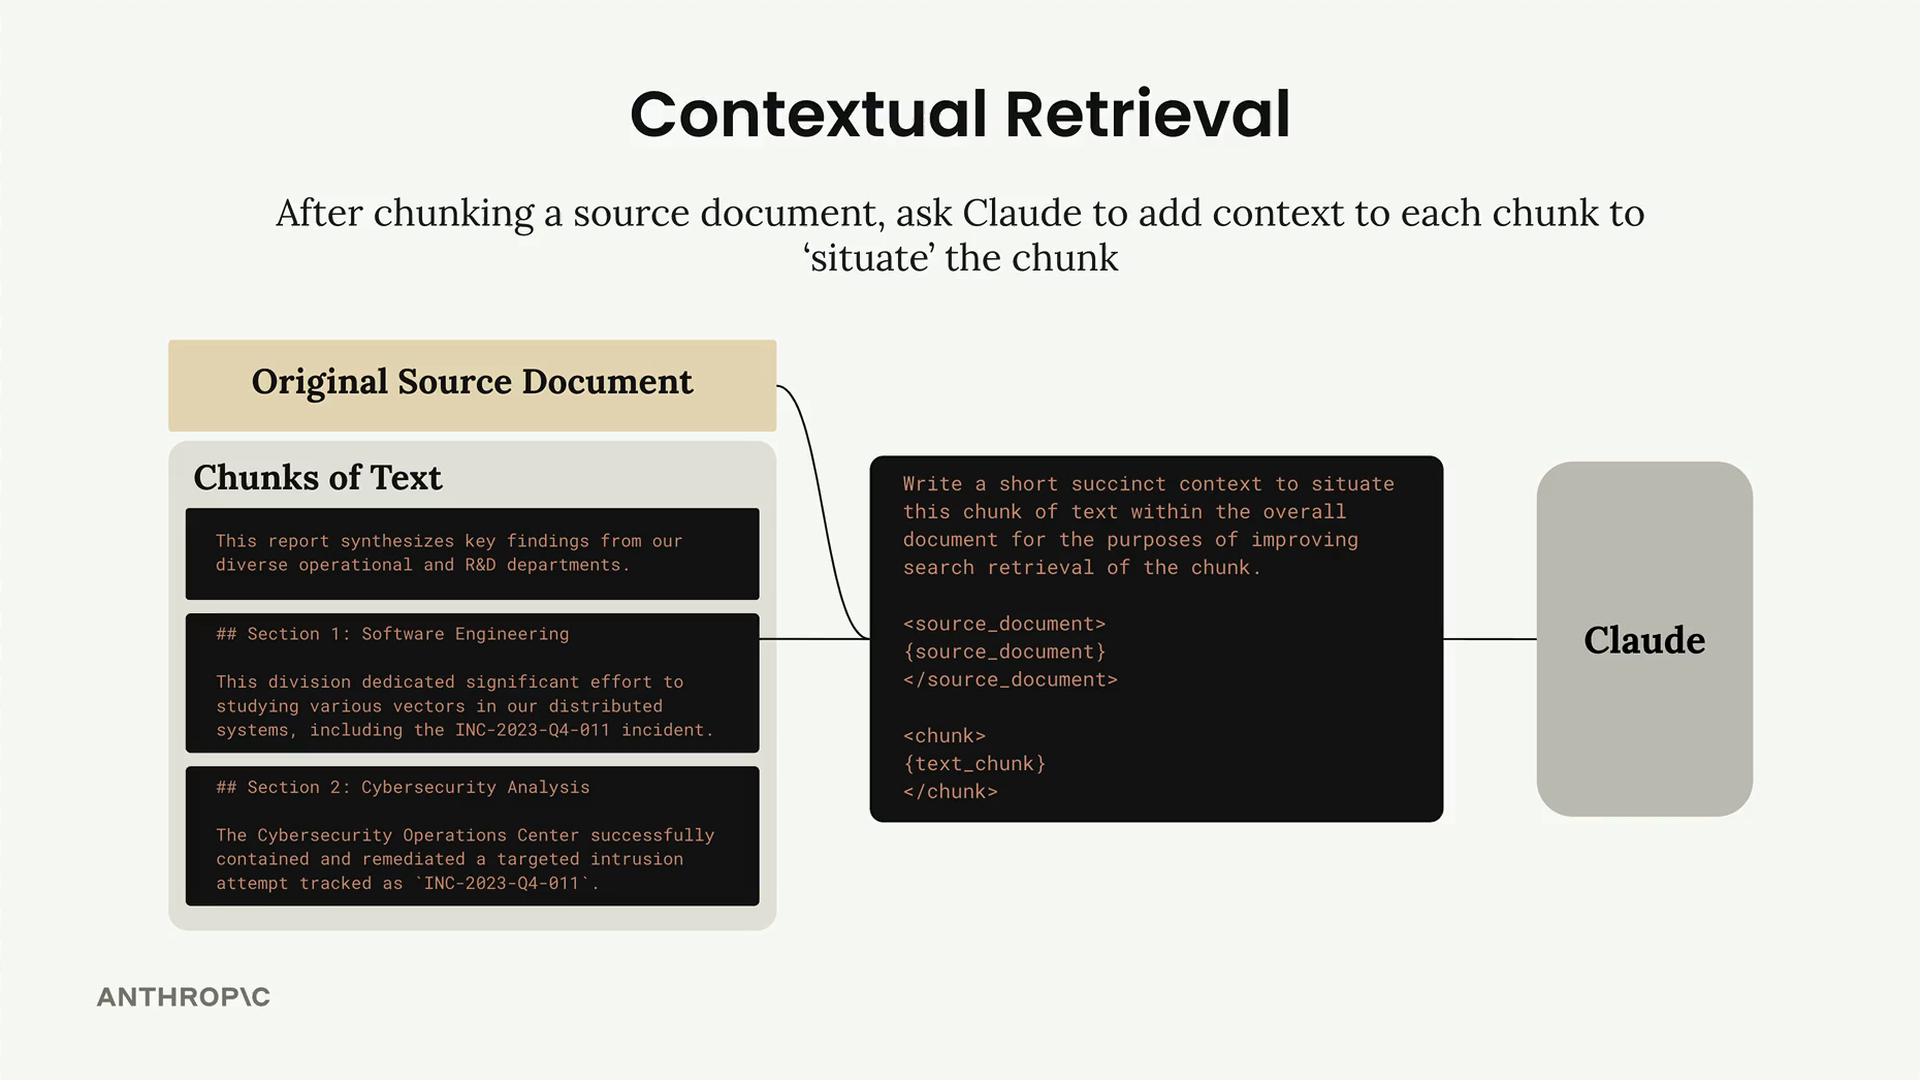
基本的な考え方はシンプルです。ソース文書をチャンクに分割した後、各チャンクをリトリーバー データベースに保存する前に、Claudeにそのチャンクにコンテキストを追加するよう依頼します。この前処理ステップは、各チャンクをより大きな文書の中に「位置づける」のに役立ちます。
仕組み
各テキストチャンクについて、チャンクと元のソース文書の両方を、次のようなプロンプトと共にClaudeに送信します。
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claudeは次のようなコンテキストを生成するかもしれません。「このセクションは、部門横断的なグループに関するより大きなレポートからのものです。INC-2023-04-011への言及が含まれており、これはサイバーセキュリティ分析セクションでも言及されています。」
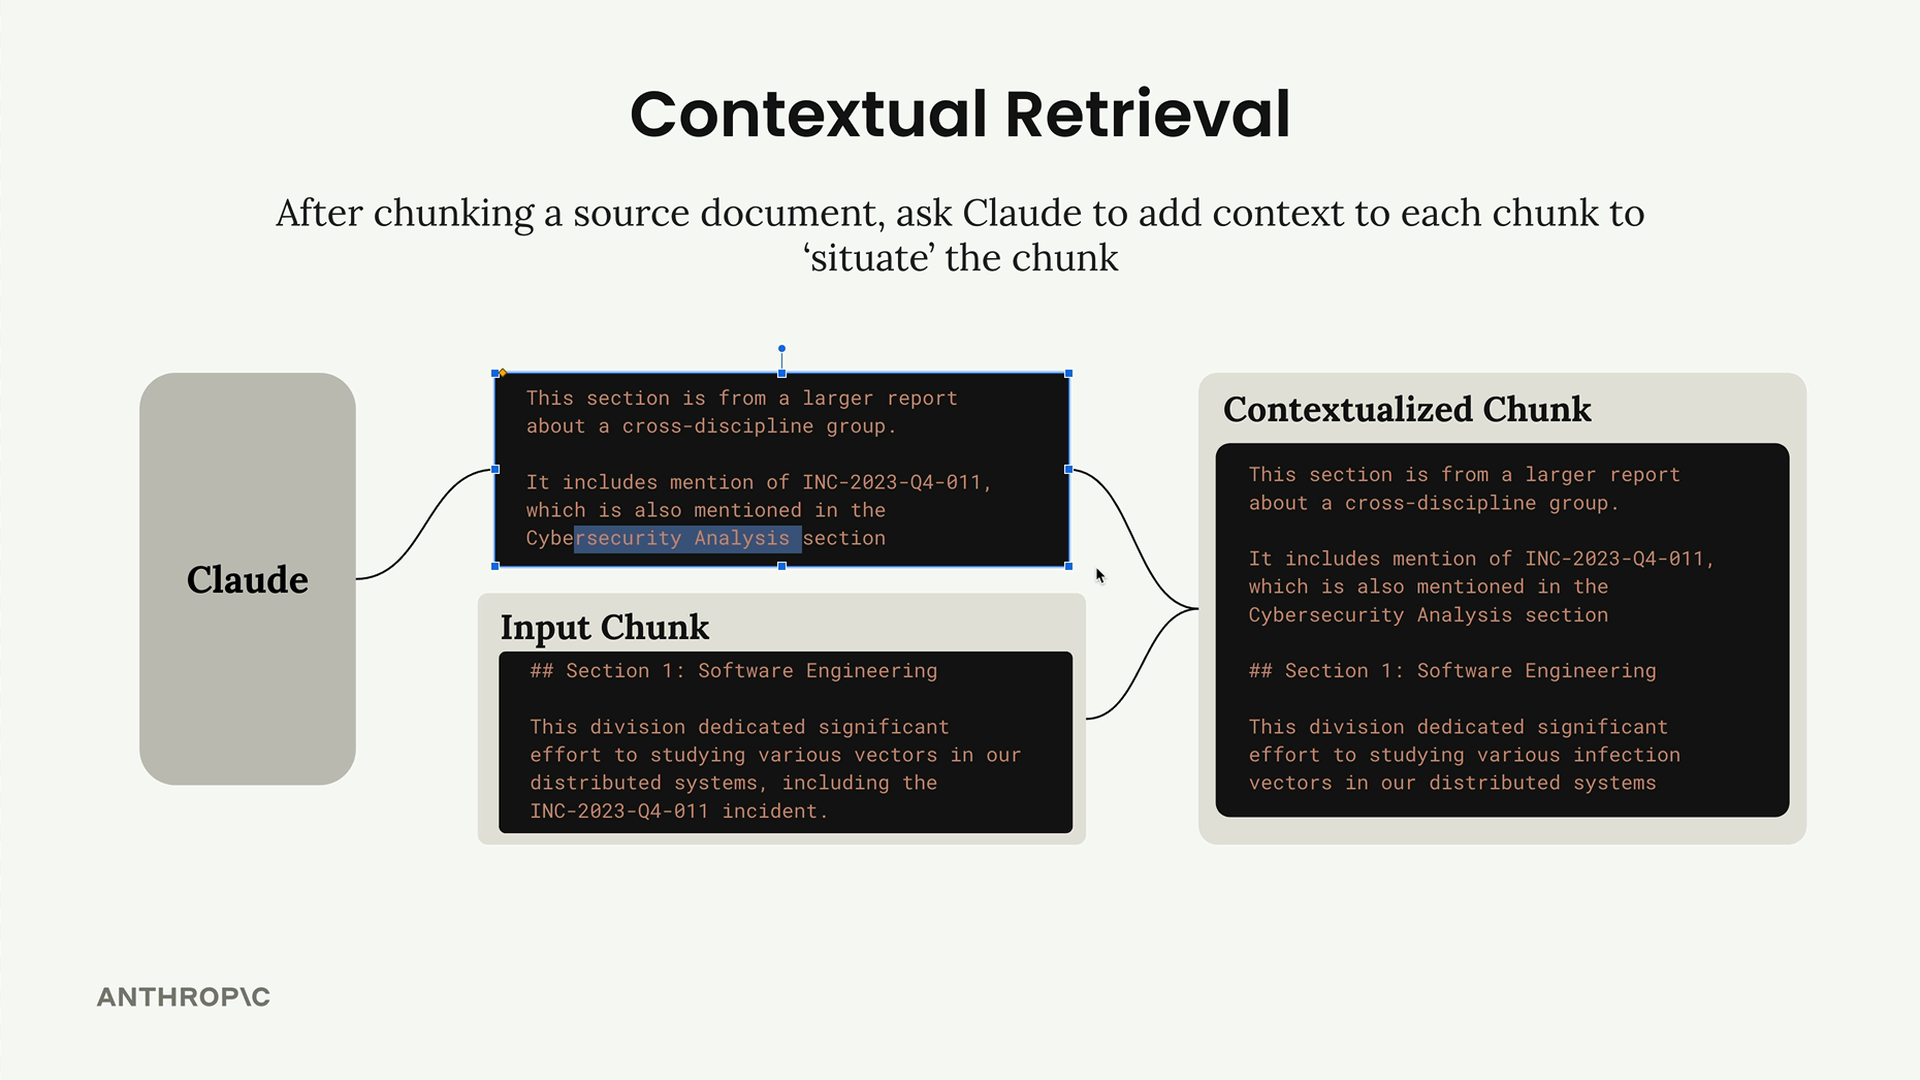
次に、この生成されたコンテキストを元のチャンクテキストと組み合わせて「コンテキスト化されたチャンク」を作成し、ベクトルインデックスおよびBM25インデックスに保存します。
大きな文書を扱う
ソース文書が大きすぎて1つのプロンプトに収まらない場合は、文書全体ではなく、縮小したコンテキストセットを提供できます。
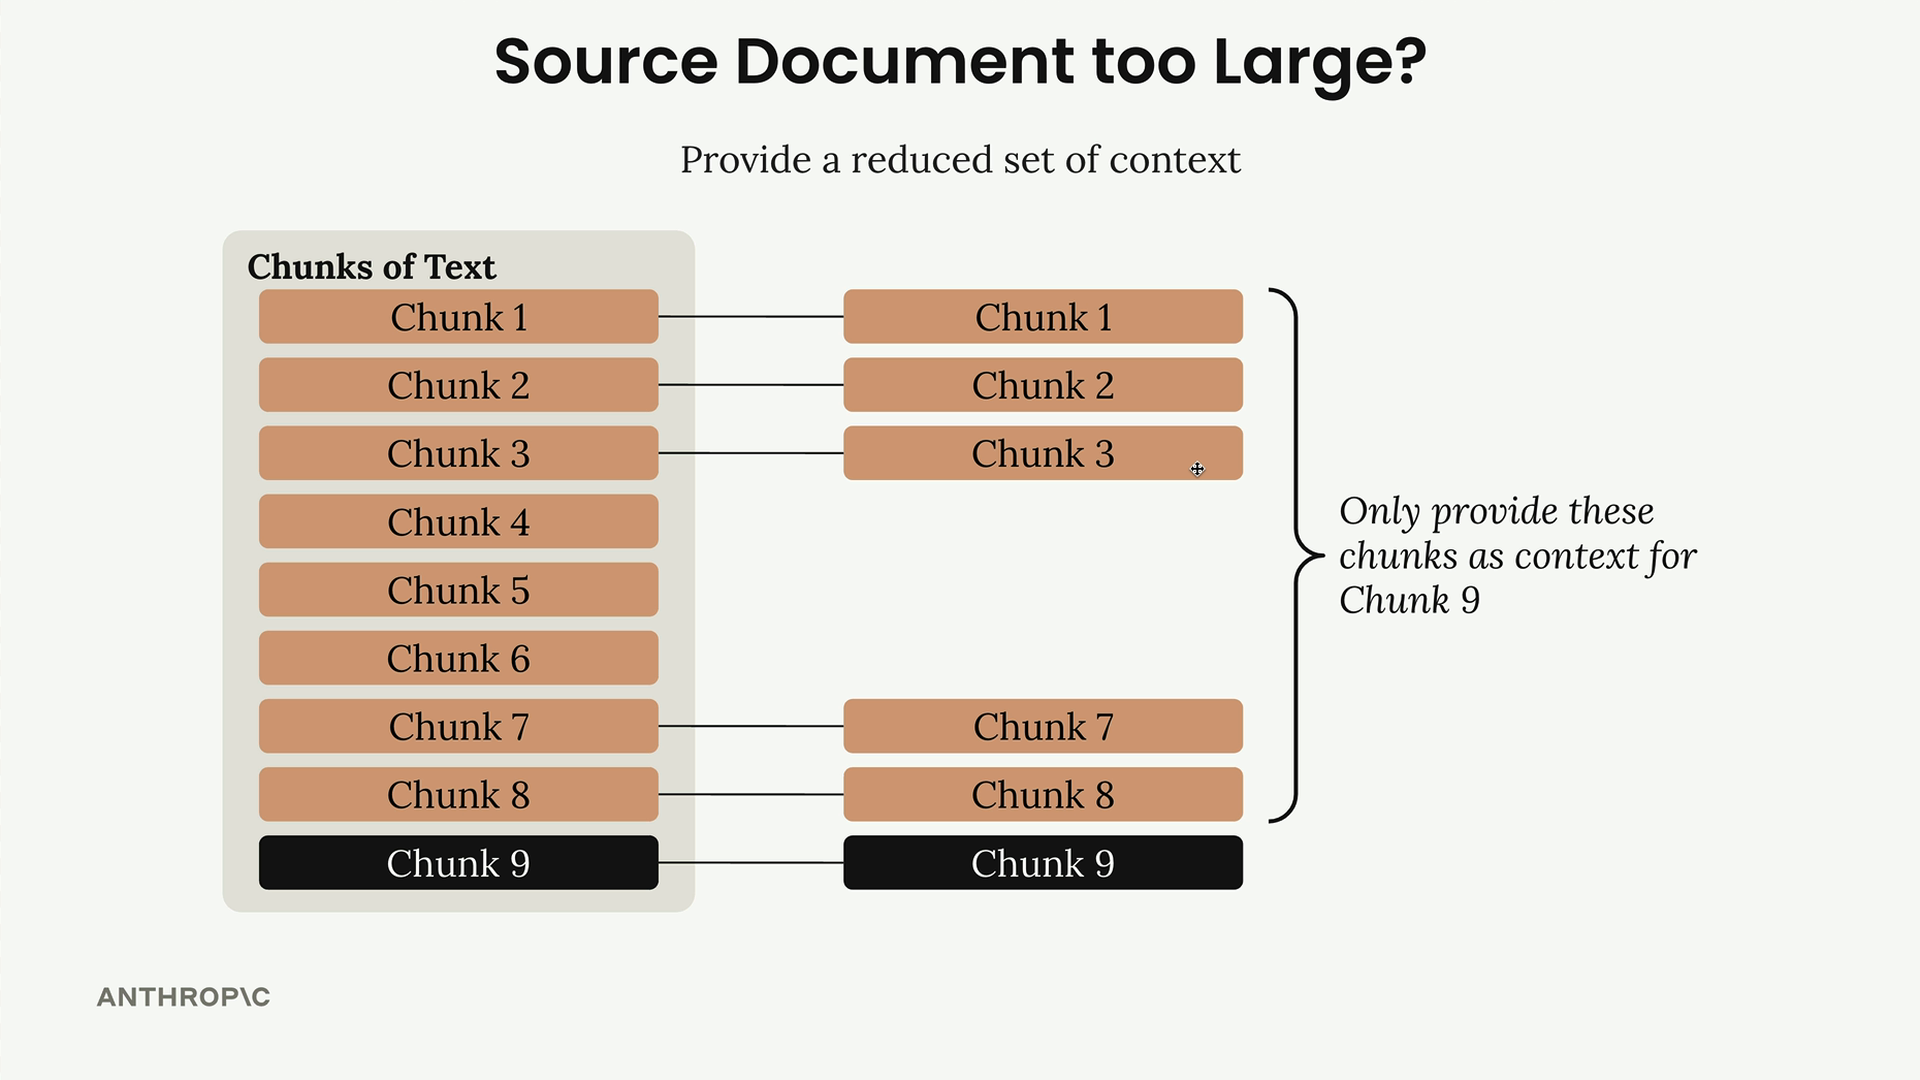
コンテキスト化しようとしている任意のチャンクについて、次のものを含めます。
- 文書の冒頭部分からのいくつかのチャンク(多くの場合、要約や抄録を含む)
- 対象チャンクの直前にあるチャンク(ローカルなコンテキストを提供する)
このアプローチにより、Claudeは文書全体でプロンプトを圧倒することなく、意味のあるコンテキストを生成するのに十分な情報を得られます。
実装例
コンテキスト検索関数の基本的な実装は以下のとおりです。
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
文書のチャンクを処理する際には、各チャンクをループ処理し、コンテキスト化されたバージョンを生成します。
# 各チャンクにコンテキストを追加してから、リトリーバーに追加する
for i, chunk in enumerate(chunks):
    # 開始チャンクと先行チャンクからコンテキストを構築する
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
期待される結果
生成されたコンテキストは、文書の構造と関係性について貴重な情報を提供します。例えば、Claudeはあるチャンクを次のように説明するかもしれません。「年次学際研究レビューのセクション2で、Project Phoenixの安定性の問題を解決するためのソフトウェアエンジニアリングの取り組みについて詳述しています。これは方法論セクションに続き、財務分析セクションに先立つもので、組織全体の10の研究領域を網羅する包括的なレポートの一部をなしています。」
この追加のコンテキストは、検索システムが各チャンクに何が含まれているかだけでなく、それがより大きな文書構造にどのように収まり、他のセクションとどのように関連しているかをよりよく理解するのに役立ちます。シンプルな文書では劇的な改善が見られないかもしれませんが、文書がセクション間で複雑な相互参照や依存関係を持つより複雑なものになるにつれて、コンテキスト検索はますます価値を増していきます。