このウォークスルーでは、実践的な例を使用してRAG(Retrieval-Augmented Generation:検索拡張生成)の完全な実装をデモンストレーションします。サンプルのレポート文書を使用して、ゼロからベクトルデータベースを構築し、RAGワークフローの5つのステップすべてを実行します。
ベクトルデータベースのセットアップ
この実装では、埋め込みの保存と類似性検索の実行を処理するカスタムのVectorIndexクラスを使用します。このクラスは、ベクトルデータベースの操作に必要なコア機能を提供します。
5ステップのRAG実装
ステップ1:セクションごとにテキストをチャンク化する
まず、以前使用したセクションベースのチャンク化アプローチを使用して、ソース文書を読み込み、チャンク化します。
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
これにより、レポートが独立して処理できる論理的なセクションに分割されます。
ステップ2:各チャンクの埋め込みを生成する
次に、リスト内包表記を使用して、すべてのチャンクの埋め込みを作成します。
embeddings = [generate_embedding(chunk) for chunk in chunks]このステップでは複数のAPI呼び出しが発生するため、完了までに時間がかかります。各チャンクは数値ベクトル表現に変換されます。
ステップ3:埋め込みをベクトルデータベースに保存する
次に、ベクトルストアを作成し、埋め込みとそれに関連するテキストの両方を投入します。
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
ここで重要な点は、埋め込みと元のテキストの両方を保存することです。単に数値のリストが返ってくるだけでは役に立ちません。それらの埋め込みに対応する実際のテキストコンテンツが必要です。このメタデータにより、後で意味のある結果を取得できるようになります。
ステップ4:ユーザークエリの埋め込みを生成する
ユーザーが質問をすると、それを同じ埋め込み形式に変換します。
user_embedding = generate_embedding("What did the software engineering dept do last year?")これにより、保存されている埋め込みと比較できる、ユーザーの質問のベクトル表現が作成されます。
ステップ5:関連するチャンクを検索して取得する
最後に、ベクトルストアを検索して、最も類似したコンテンツを見つけます。
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
これにより、コサイン距離スコアとともに最も関連性の高い2つのチャンクが返されます。距離が小さいほど、類似性が高いことを示します。
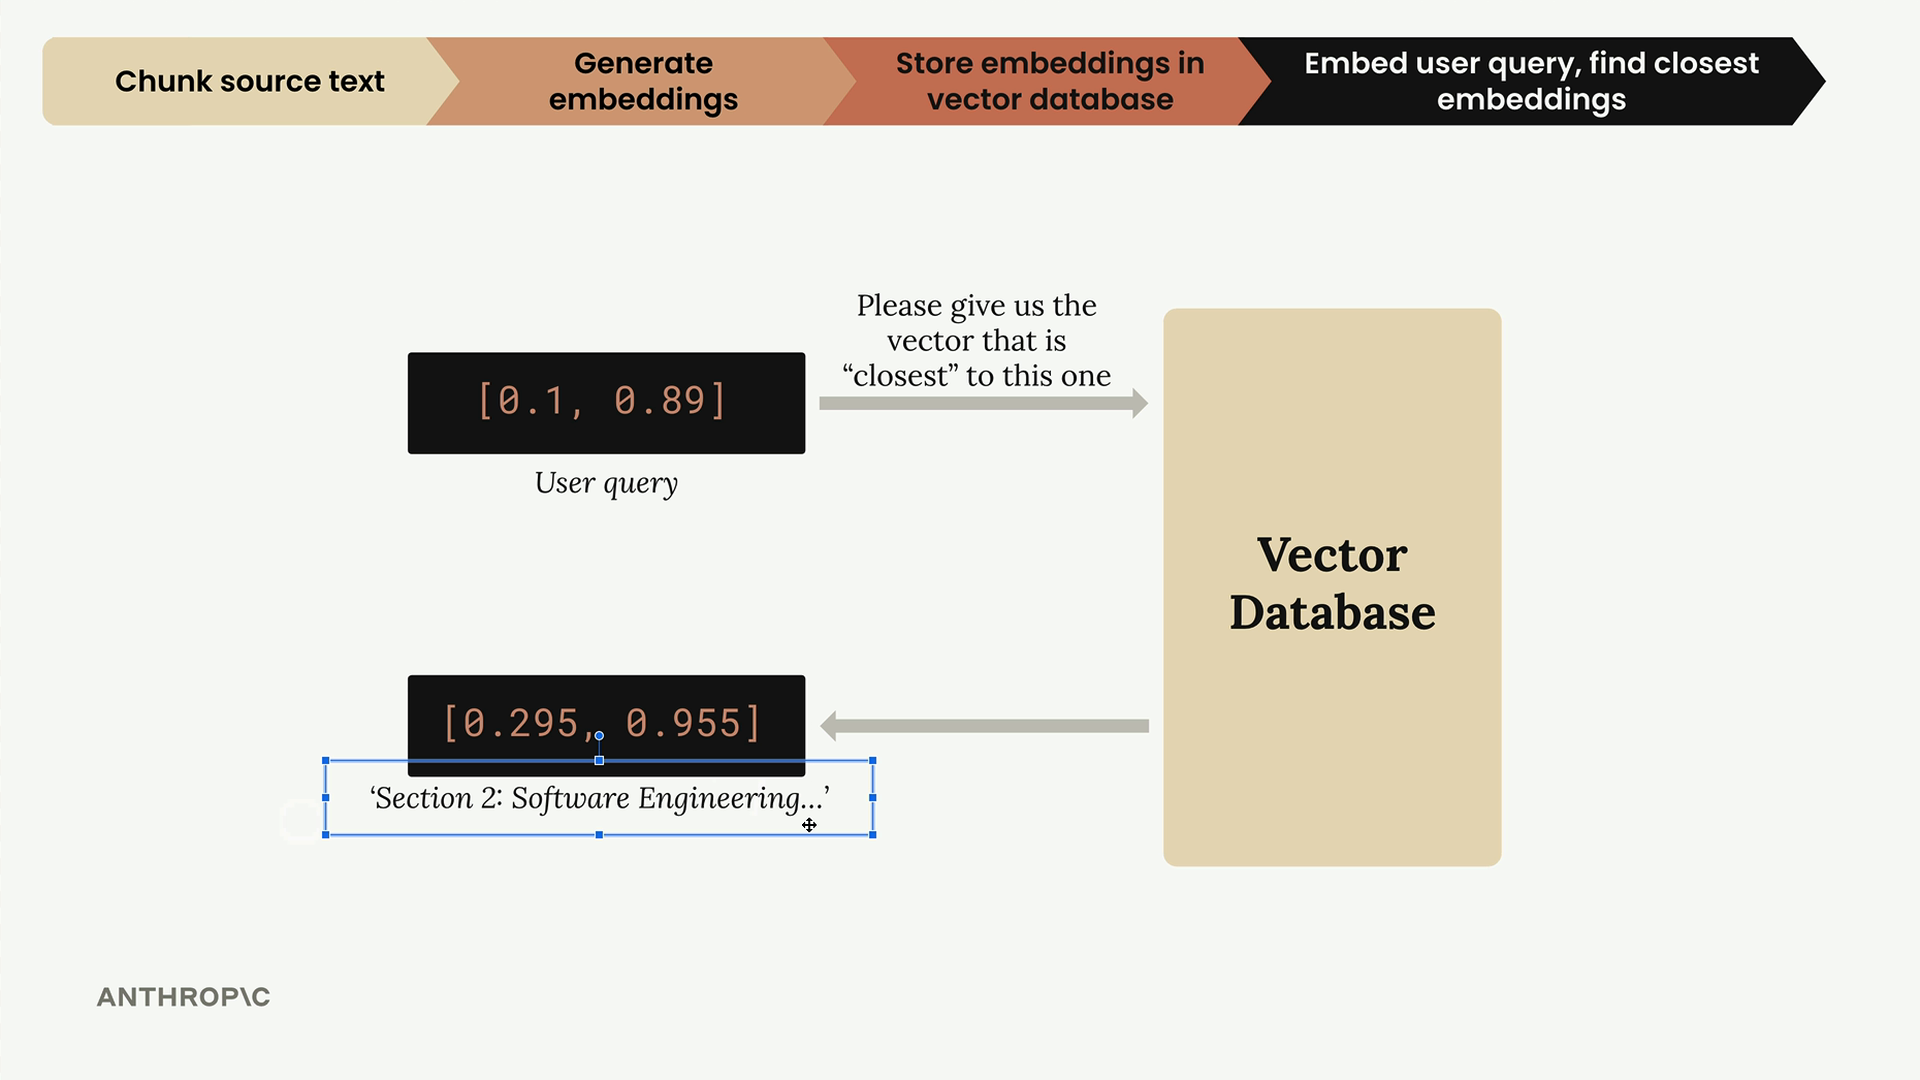
結果の理解
検索結果は関連性に基づいてランク付けされます。この例では、ソフトウェアエンジニアリングのセクションが最も小さい距離(0.71)を示し、最も関連性の高い一致となりました。方法論のセクションは0.72の距離で2番目になりました。
距離メトリックは、システムが各結果の関連性についてどの程度確信を持っているかを理解するのに役立ちます。距離が近いほど、ユーザーのクエリへの一致度が高くなります。
テキストを埋め込みと一緒に保存する理由
重要な設計上の決定は、各埋め込みとともに元のテキストを保存することです。これがなければ、数値の配列しか返ってこず、それでは応答の生成に役立ちません。ソーステキストを含めることで、取得したチャンクをすぐに使用して、言語モデルにコンテキストを提供できます。
これでコアとなるRAGワークフローは完成ですが、実際のシナリオでパフォーマンスを向上させるための追加の最適化や改善点がまだあります。