カスタムのプロンプト評価ワークフローを構築するには、まず明確な目標を設定し、テストデータを生成することから始めます。今回の例では、ユーザーがAWS固有のコード(Python関数、JSON設定、または正規表現のいずれか)を、余分な説明やフォーマットなしで書けるよう支援するプロンプトを構築します。
目標の設定
このプロンプトは、ユーザーのタスク記述を受け取り、次の3種類の出力のいずれかを返す必要があります。
- Pythonコード
- JSON設定
- 正規表現
重要な要件は、レスポンスにヘッダーやフッター、説明を含めず、要求されたコードのみを含めることです。
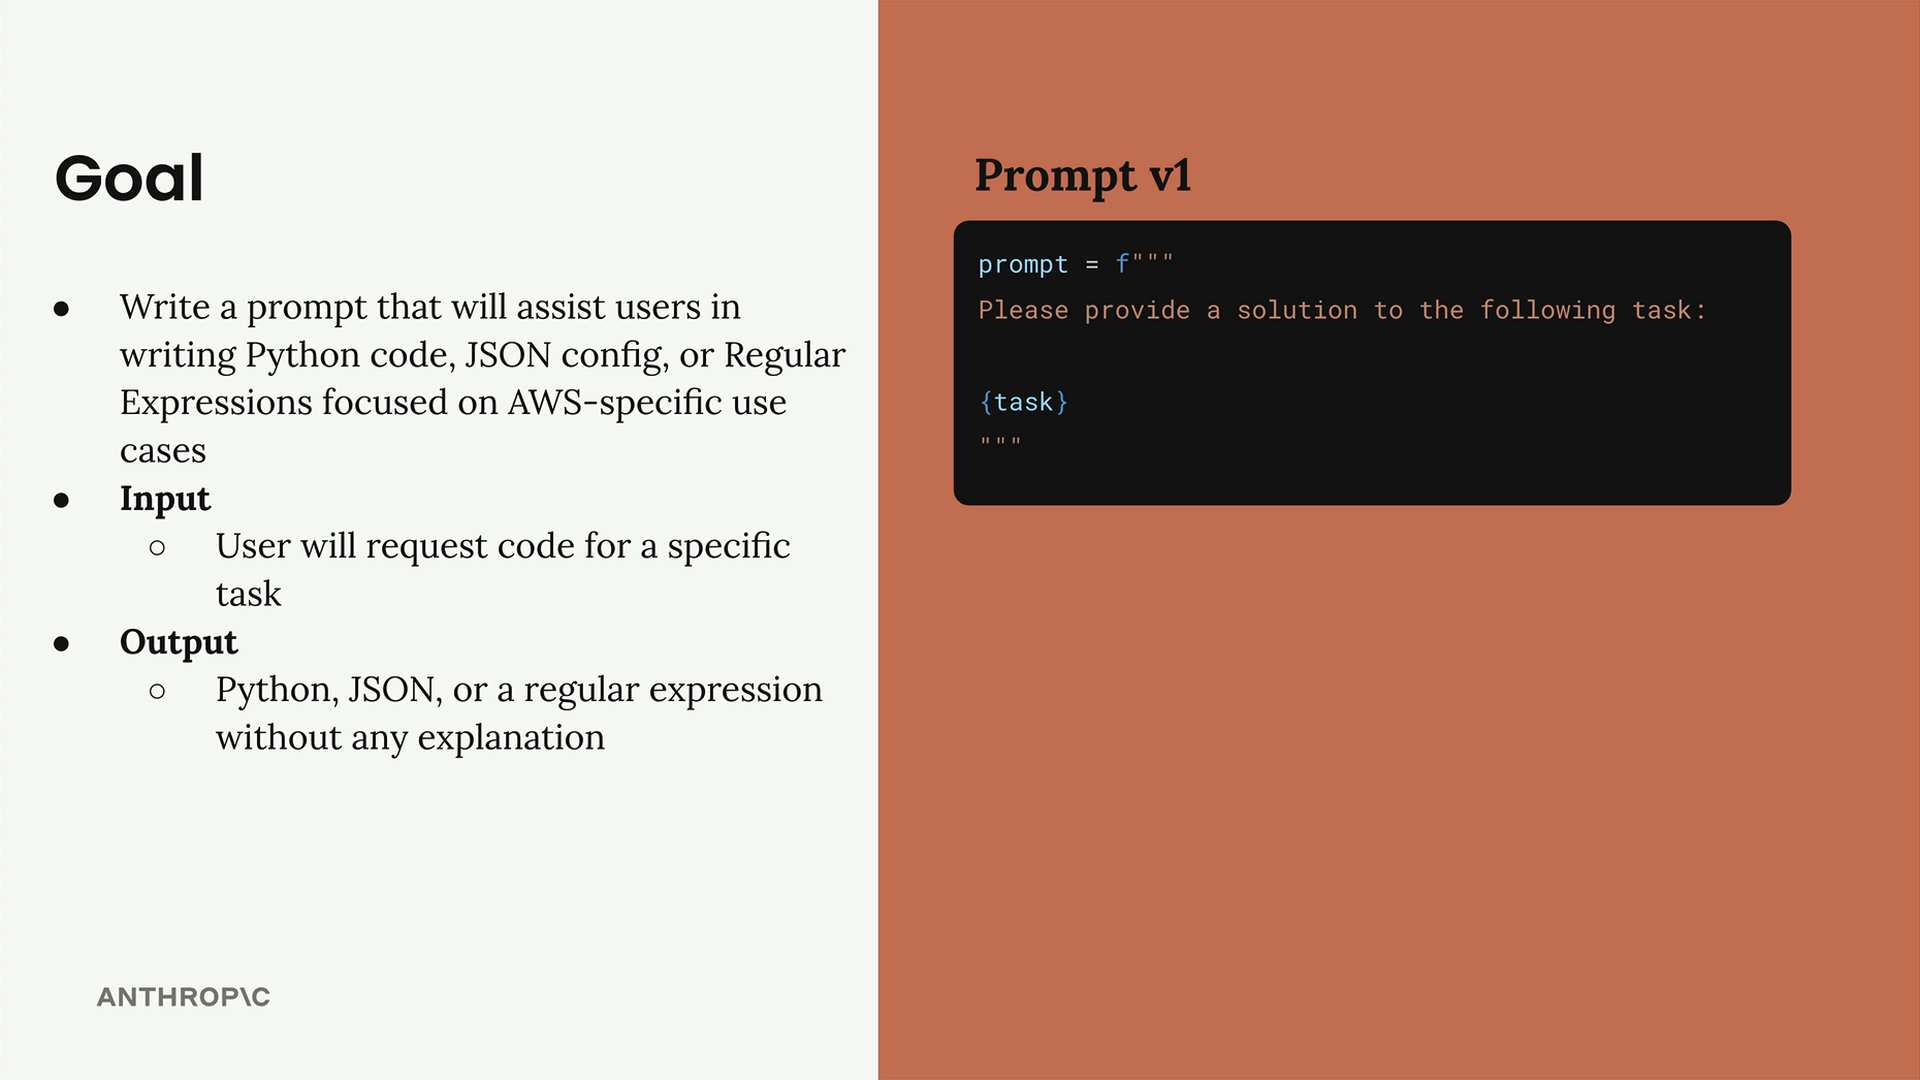
シンプルな最初のバージョンから始めることで、管理しやすさを保てます。最初のプロンプトテンプレートは単純です。「次のタスクへの解決策を提供してください: {task}」
評価データセットの作成
評価データセットには、プロンプトに投入する入力例が含まれます。各テストケースはプロンプトと組み合わされてClaudeに送られ、さまざまなシナリオにおいてプロンプトがどの程度うまく機能するかを確認できます。
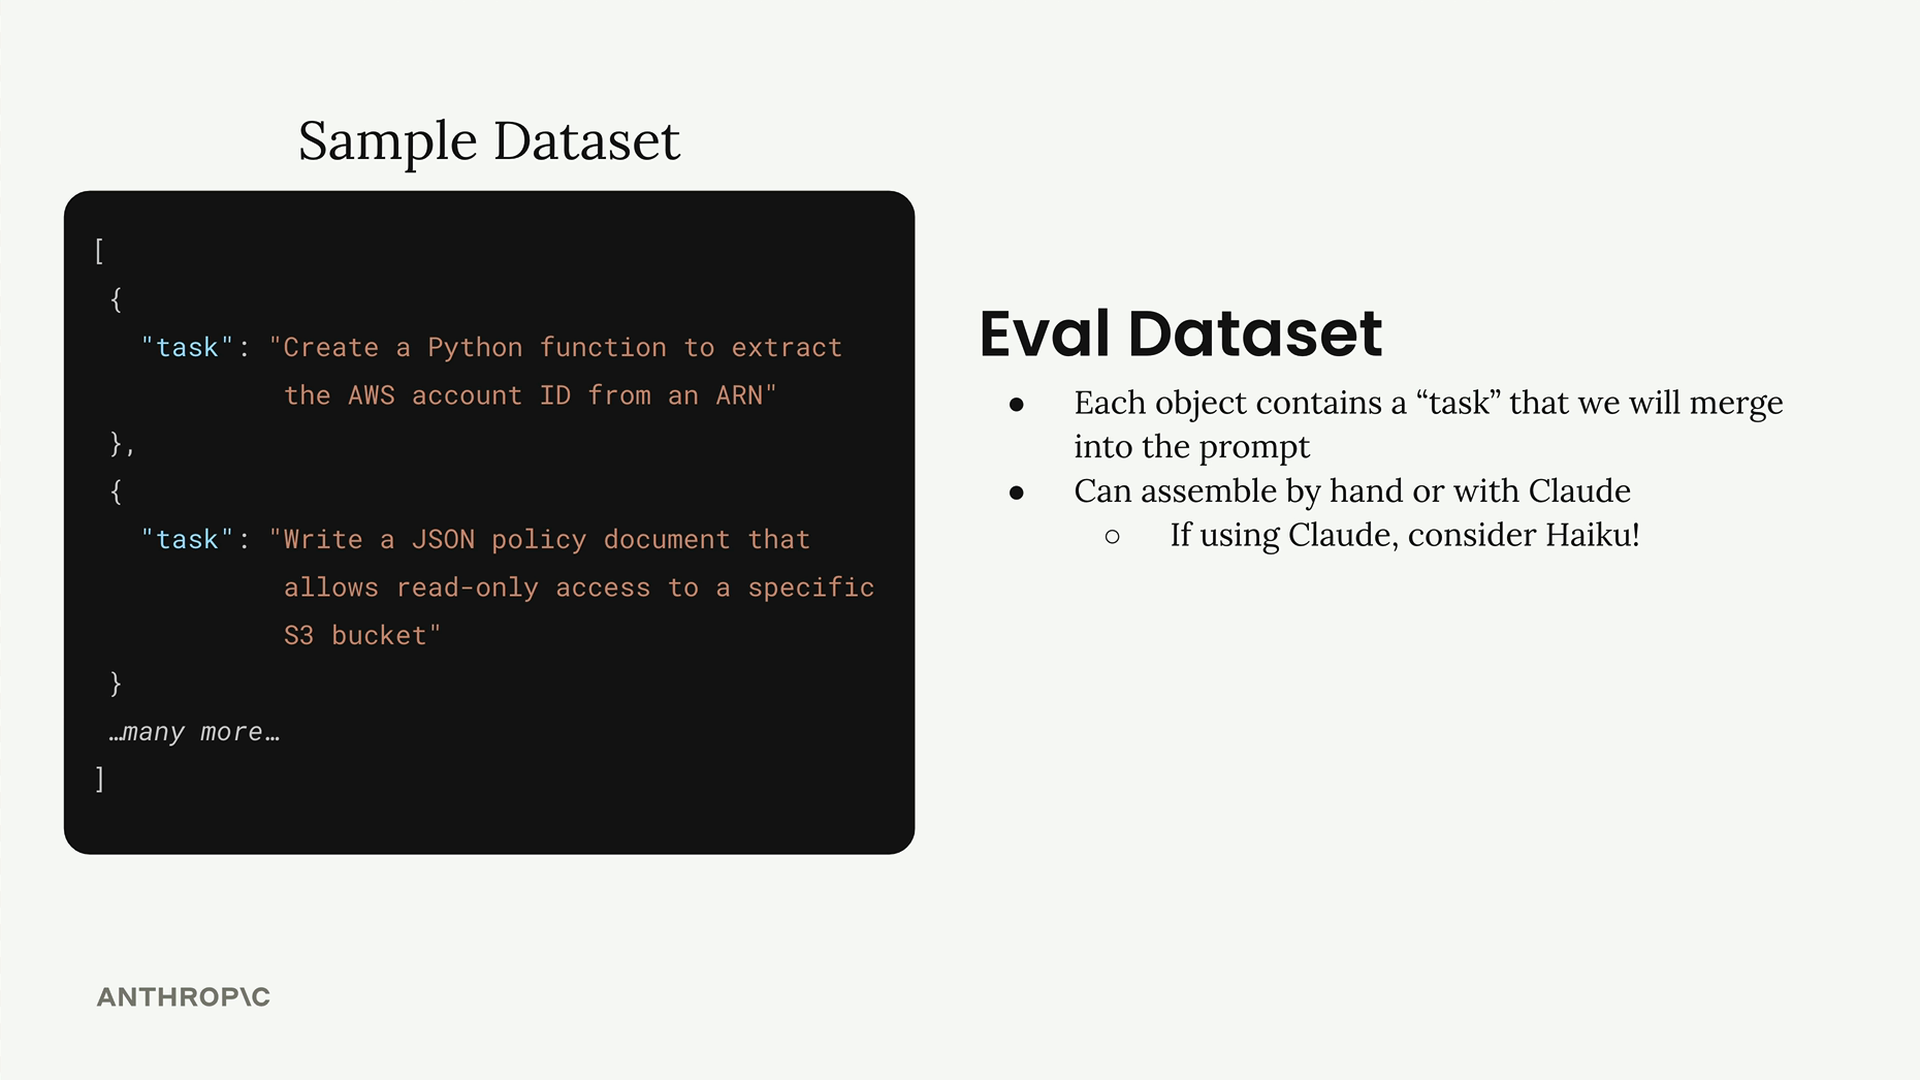
データセットの作成方法は2通りあります。
- 手作業でテストケースを書く
- Claudeを使って自動的に生成する
自動生成の場合、複数のテストケースを生成することになるため、Haikuのような高速なモデルを使うのが理にかなっています。
コードを使ったテストデータの生成
データセット生成関数は、Claudeを使って現実的なテストシナリオを作成します。基本的な構造は次のとおりです。
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
このアプローチでは、事前入力済みのアシスタントメッセージ手法とストップシーケンスを使用して、クリーンなJSONレスポンスを抽出します。アシスタントメッセージは ```json で始まり、閉じの ``` で停止するため、適切にフォーマットされたデータを確実に取得できます。
データセットの保存
生成が完了したら、データセットを保存して、常に再生成する手間を省きましょう。
dataset = generate_dataset()
with open("dataset.json", "w") as f:
    json.dump(dataset, f, indent=2)
生成されたデータセットは、ARNからアカウントIDを抽出する、EC2設定用のJSONスキーマを書く、S3バケット名用の正規表現パターンを作成するといった、現実的なAWSタスクを作り出します。初期開発では3件のテストケースで十分ですが、本番環境での評価には、はるかに多くの、かつバリエーションに富んだ例が必要になります。
この基盤により、特定のユースケースに合った評価データセットを作成するための再現可能なプロセスが得られ、評価の実行とプロンプトのパフォーマンス測定という次のステップに向けた準備が整います。