AIモデルを使ったチャットインターフェースを構築する際、ユーザーは完全な応答を10〜30秒待つのではなく、応答がすぐに表示されることを期待します。converse_stream 関数は、テキストが生成されるたびにストリーミングすることでこの問題を解決し、はるかに優れたユーザー体験を実現します。
ストリーミングの仕組み
応答全体が生成されるのを待つのではなく、ストリーミングは利用可能になり次第、テキストの断片を返送します。処理の流れがどのように変わるかを見てみましょう。
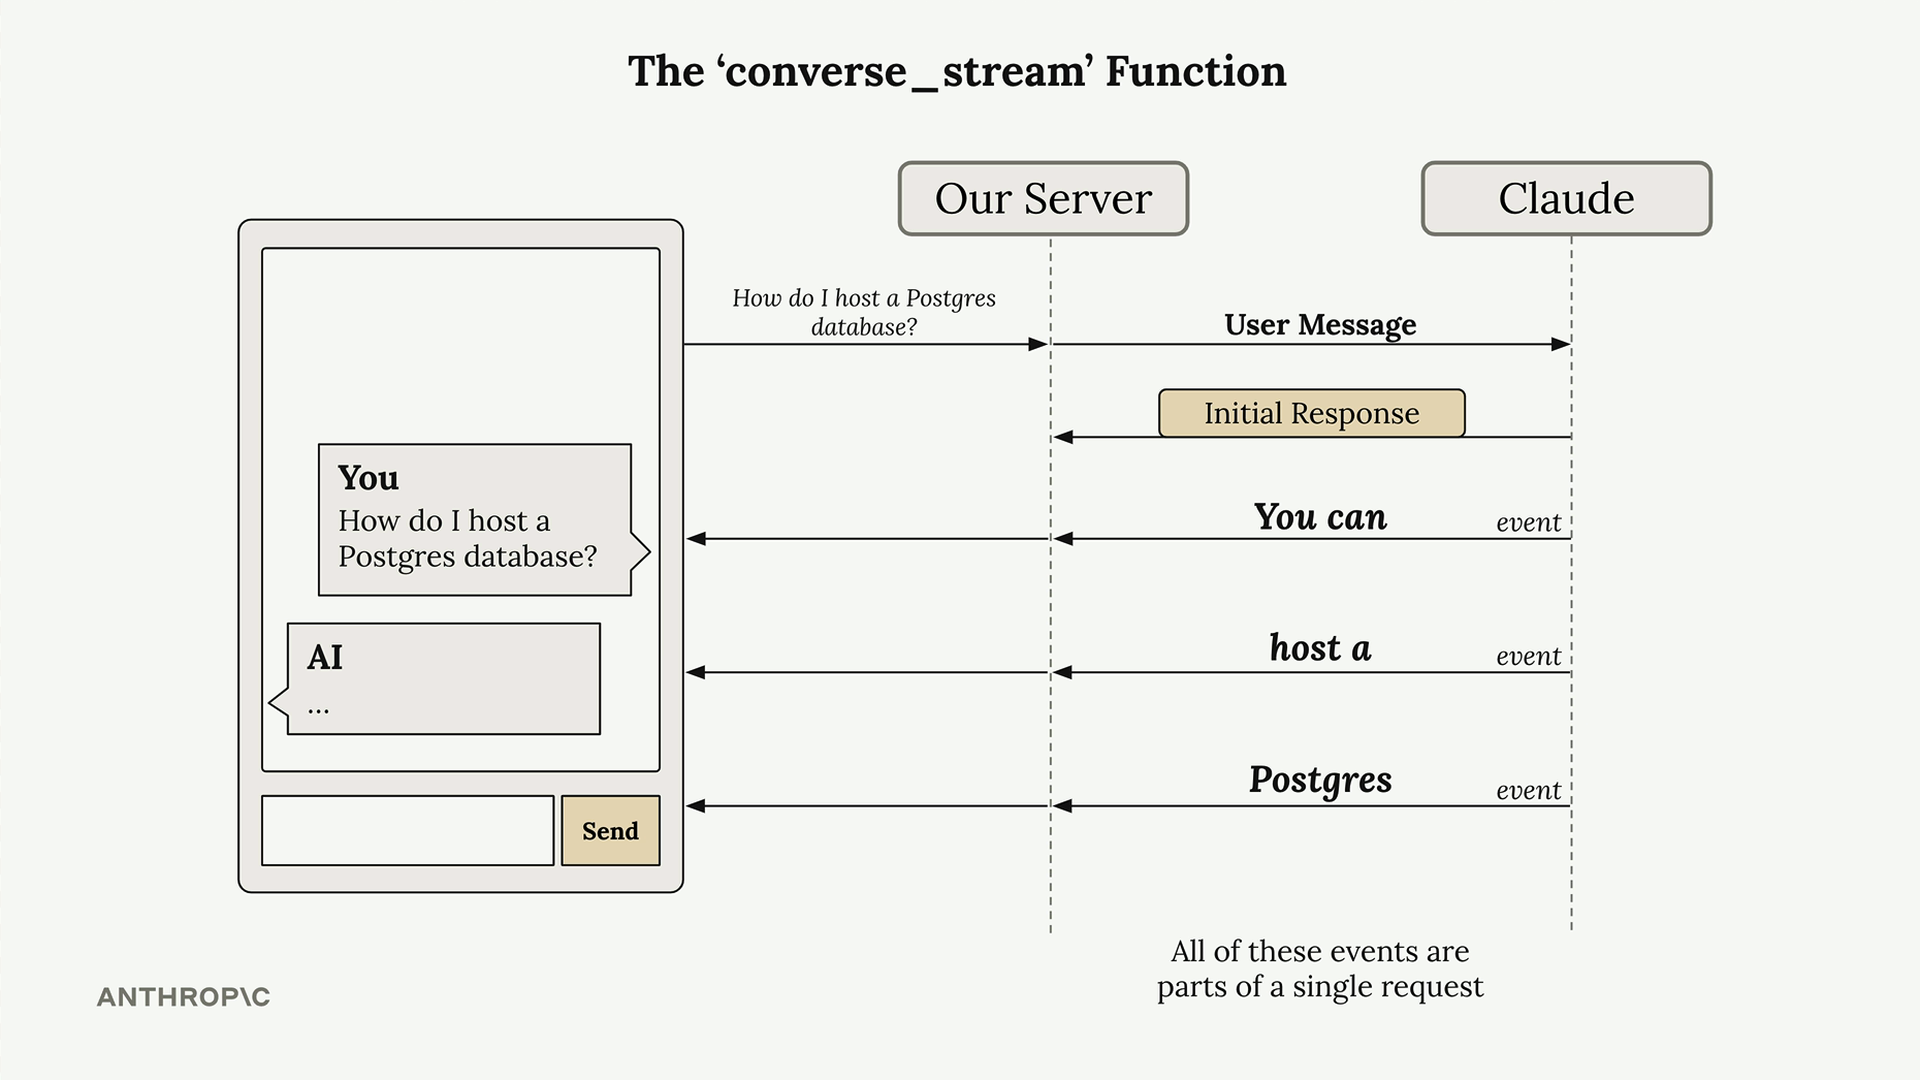
converse_stream を呼び出すと、すぐに stream オブジェクトを含む初期応答が返されます。このストリームはジェネレーターであり、モデルがテキストを生成するたびにイベントを生成します。各イベントには、全体の応答の小さなチャンクが含まれています。
基本的な実装
コード内で converse_stream を使用する方法は次のとおりです。
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

for event in response["stream"]:
    print(event)
これにより、到着したさまざまなイベントがすべて出力されます。応答が一度にすべて届くのではなく、チャンクとして届く様子を確認できます。
ストリームイベントを理解する
ストリームはそれぞれ異なる目的を持つ、いくつかの種類のイベントを生成します。
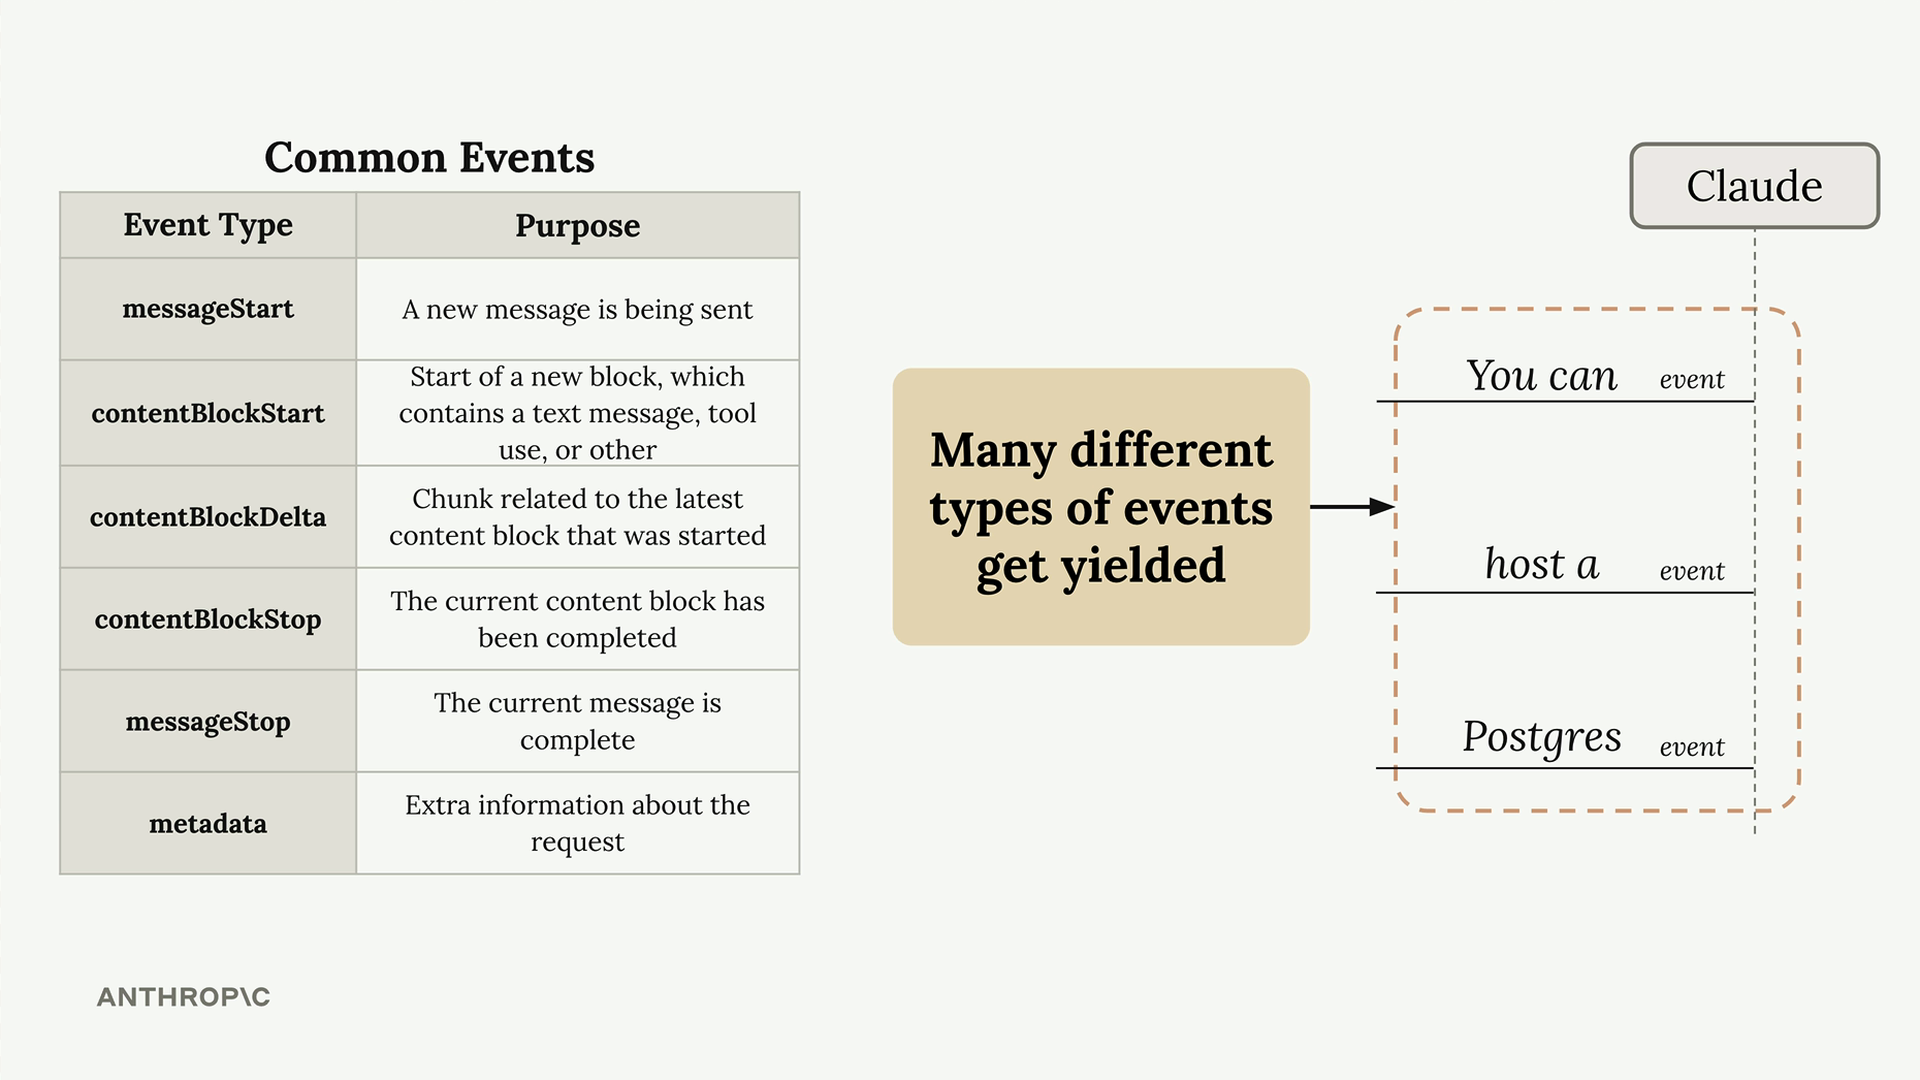
基本的なテキスト生成では、contentBlockDelta イベントだけに注目すれば十分です。これらには、ユーザーに表示したい実際に生成されたテキストチャンクが含まれています。
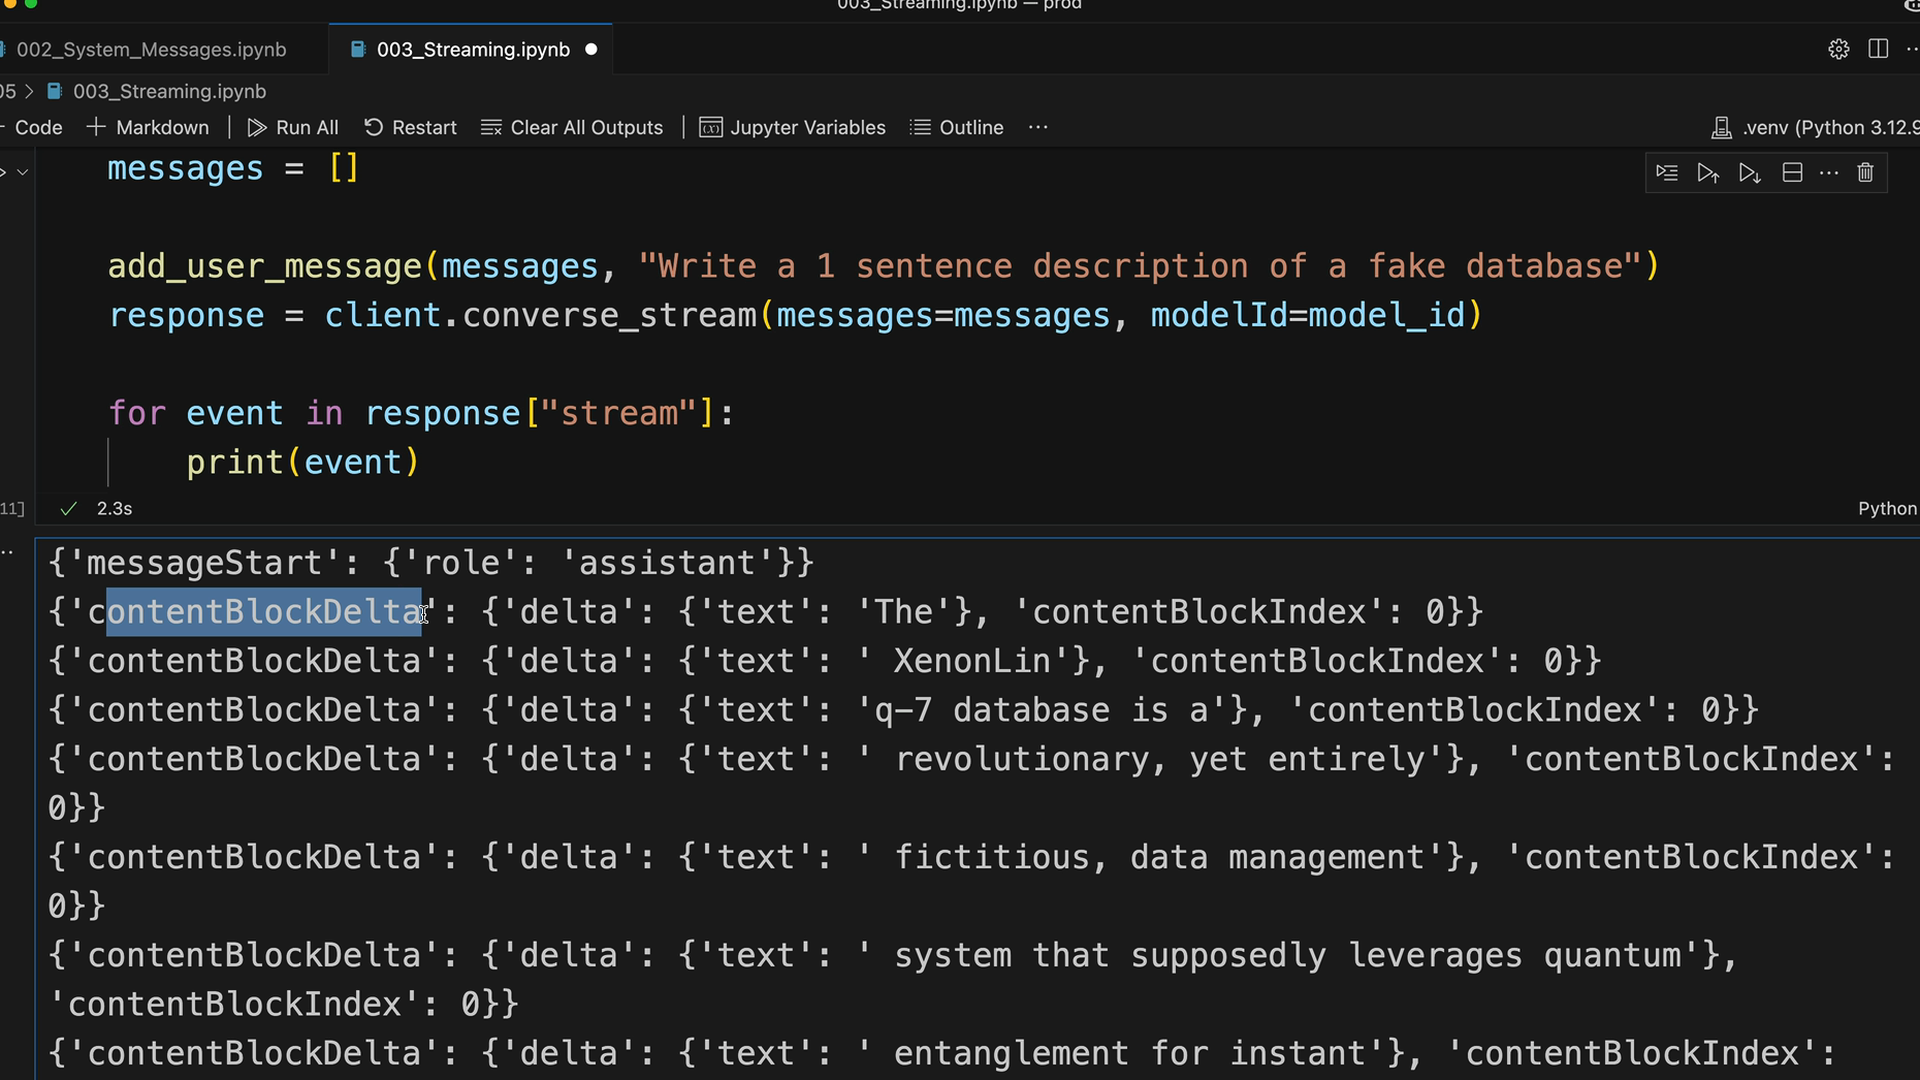
イベントは常に予測可能な順序で到着します。messageStart、テキストを含む複数の contentBlockDelta イベント、その後 contentBlockStop、messageStop、そして最後に metadata です。
テキストの抽出
各チャンクから生成されたテキストだけを取得するには、contentBlockDelta イベントをフィルタリングしてテキストを抽出します。
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
end="" パラメータは、Pythonの print 関数が自動的に追加する改行を取り除き、ストリーミングされるテキストをより自然に見せます。
実際の活用方法
実際のアプリケーションでは、各チャンクを出力する代わりに、通常次のようなことを行います。
- WebSocketsやServer-Sent Eventsを介して各チャンクをフロントエンドに送信する
- UIを更新して、リアルタイムで増えていく応答を表示する
- ストリーミングが完了したら完全なメッセージを保存する
- ストリーミング中に発生する可能性のあるエラーを処理する
このストリーミング方式によって、ユーザー体験は「送信して待つ」から「送信して応答が現れるのを見る」へと変わり、AIを活用したアプリケーションがはるかに応答性が高く、魅力的に感じられるようになります。