典型的なプロンプト評価ワークフローは、プロンプトを客観的に測定・改善するための体系的なアプローチに従います。これらのワークフローを構築する方法は多岐にわたり、オープンソースや有料のツールもさまざまに存在しますが、核となるプロセスを理解することで、小さく始めて必要に応じて規模を拡大できるようになります。
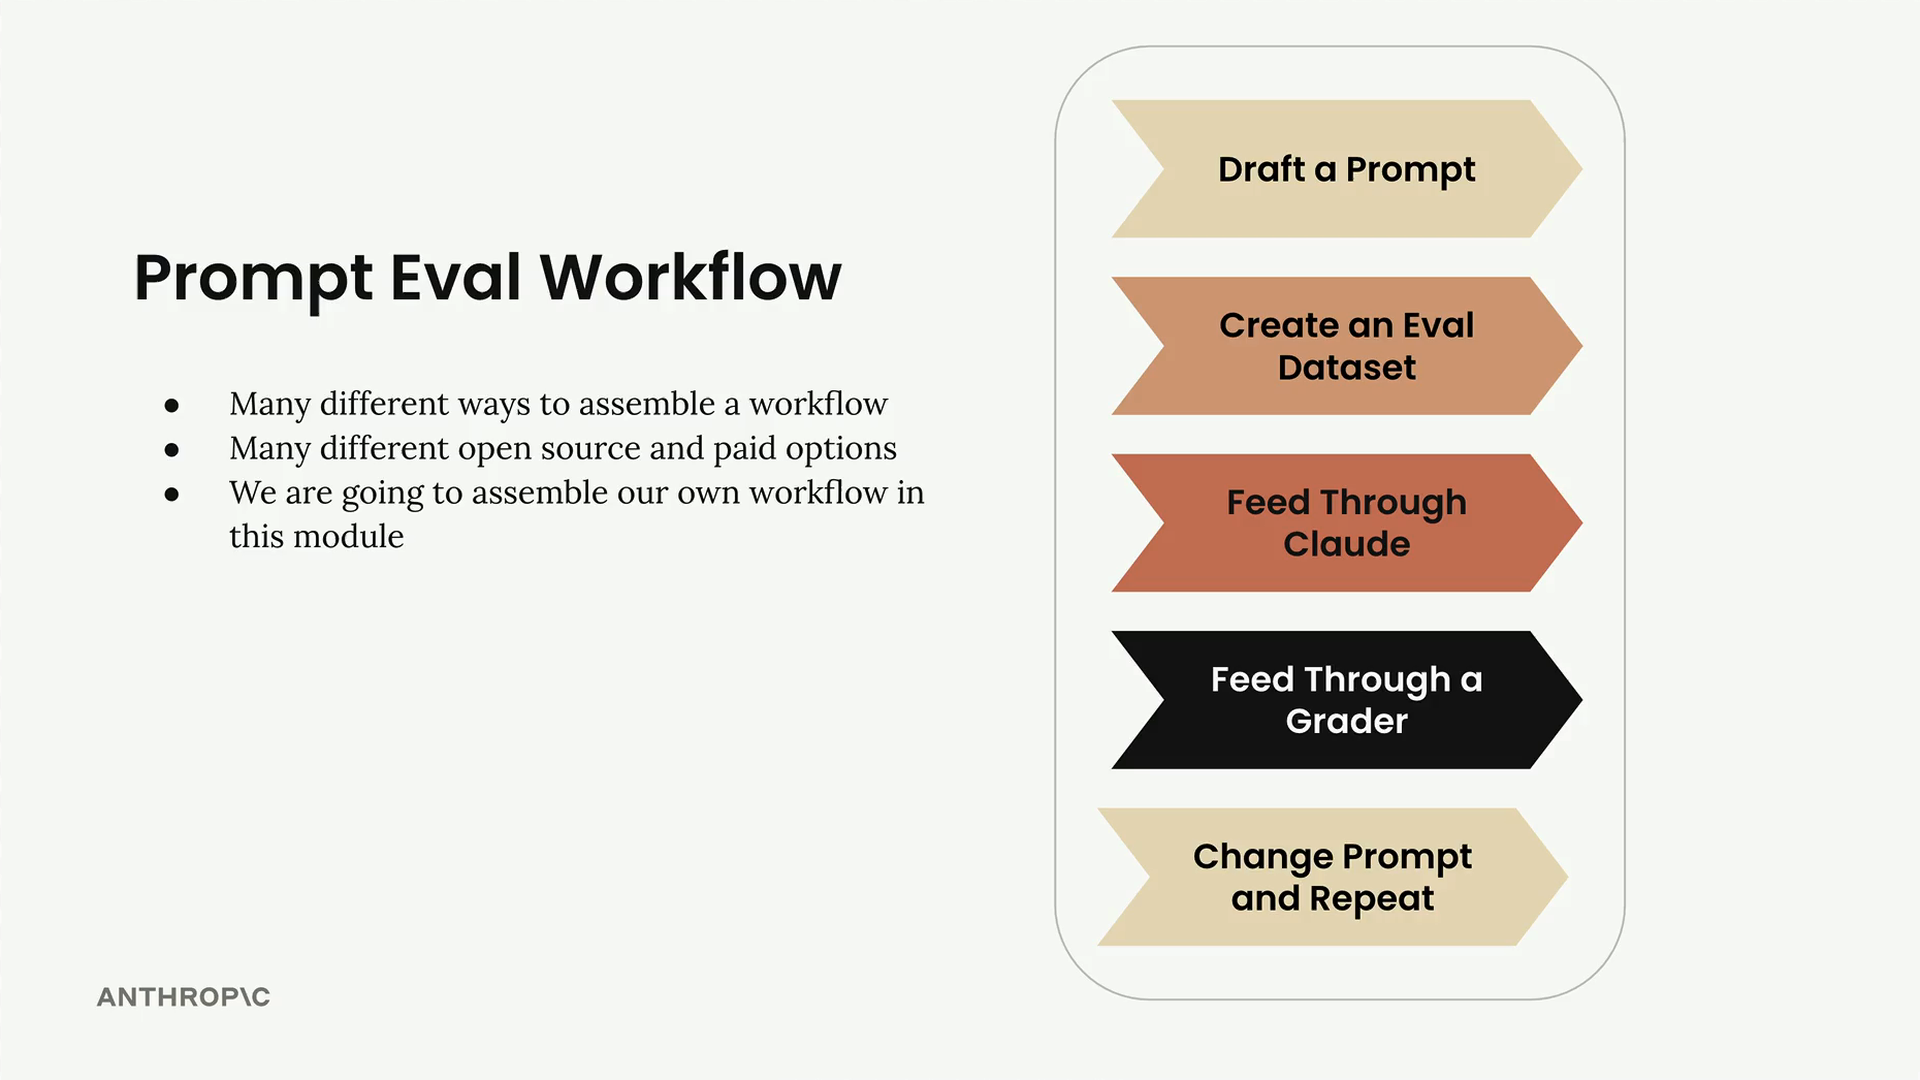
ステップ1:最初のプロンプトを起草する
まず、改善したい基本的なプロンプトを書き出すことから始めます。この例では、シンプルなプロンプト構造を使用します。
prompt = f"""
Please answer the user's question:

{question}
"""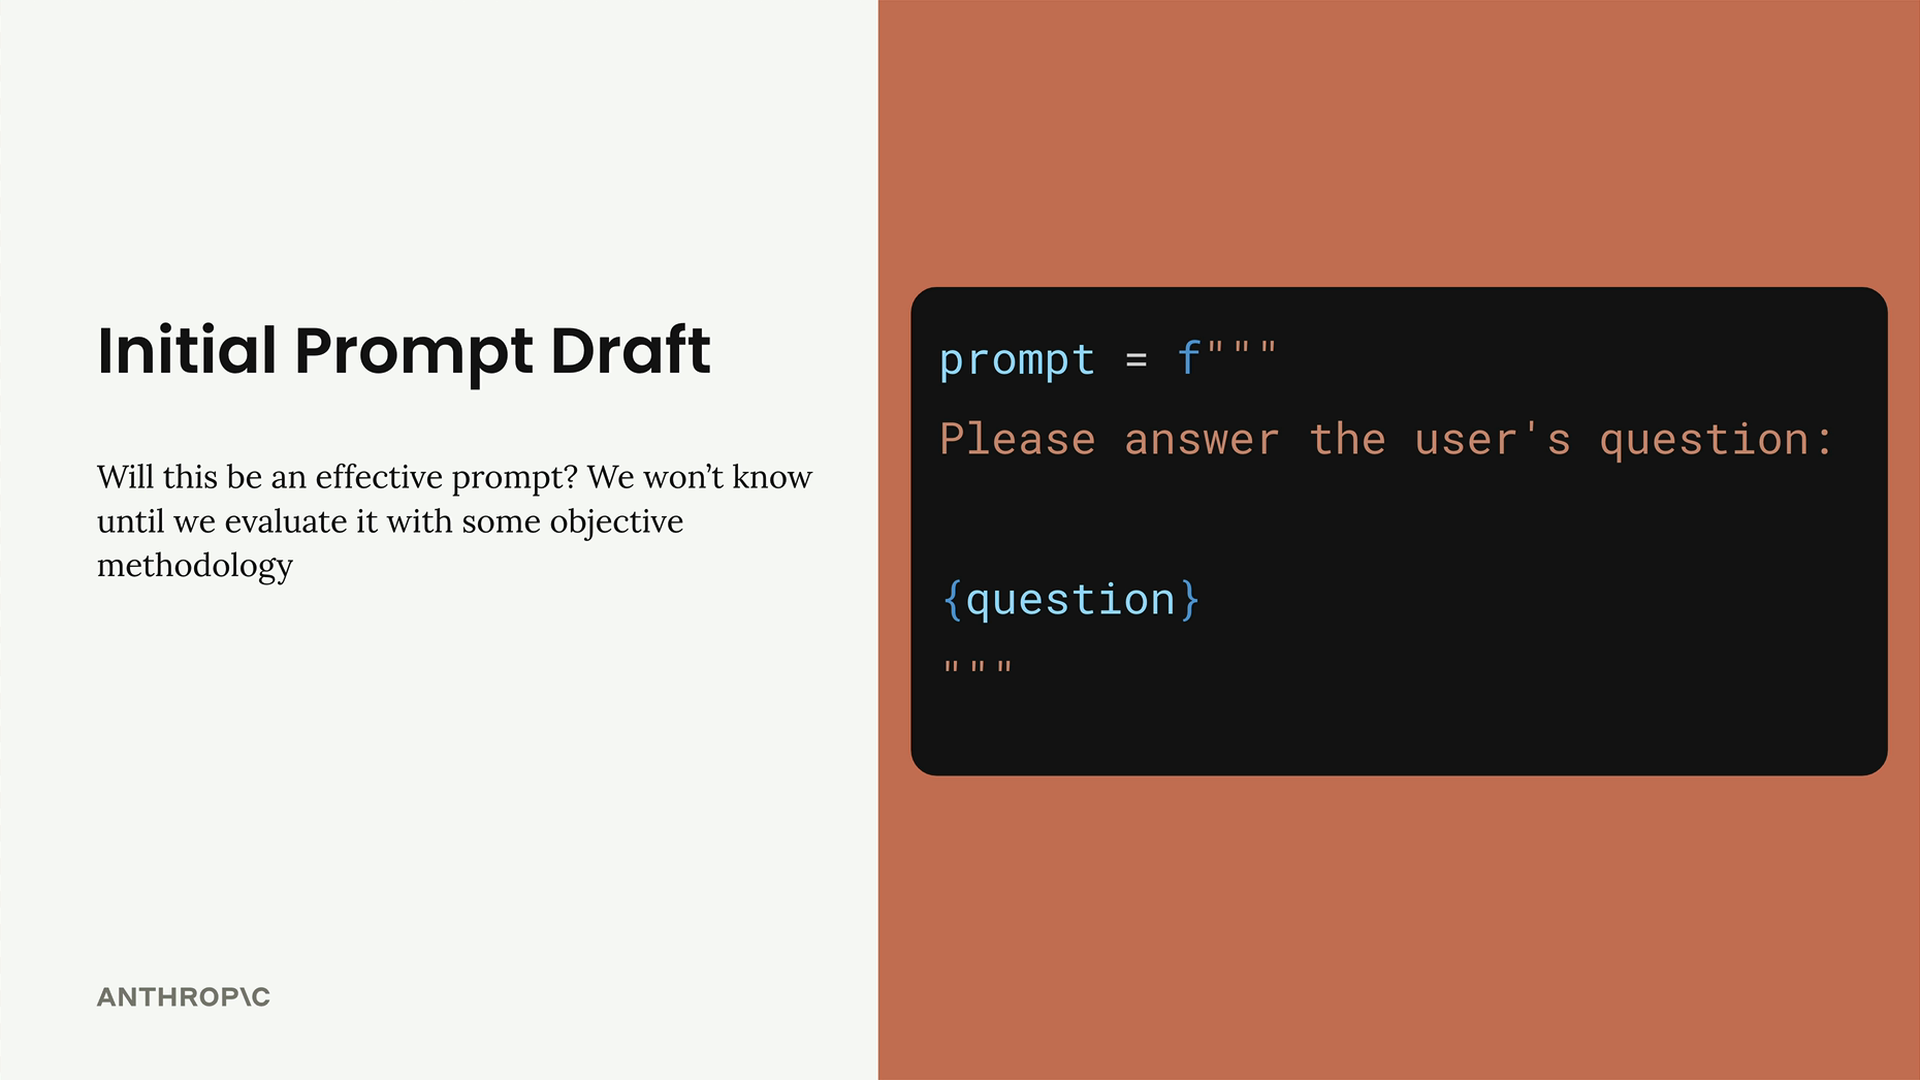
これで作業の出発点となるベースラインが得られます。客観的な方法論で評価してみるまで、それが効果的かどうかはわかりません。
ステップ2:評価データセットを作成する
評価データセットには、プロンプトに投入するサンプル入力が含まれます。今回のプロンプトには入力が1つ(ユーザーの質問)しかないため、テストに使用するさまざまな質問のコレクションが必要になります。
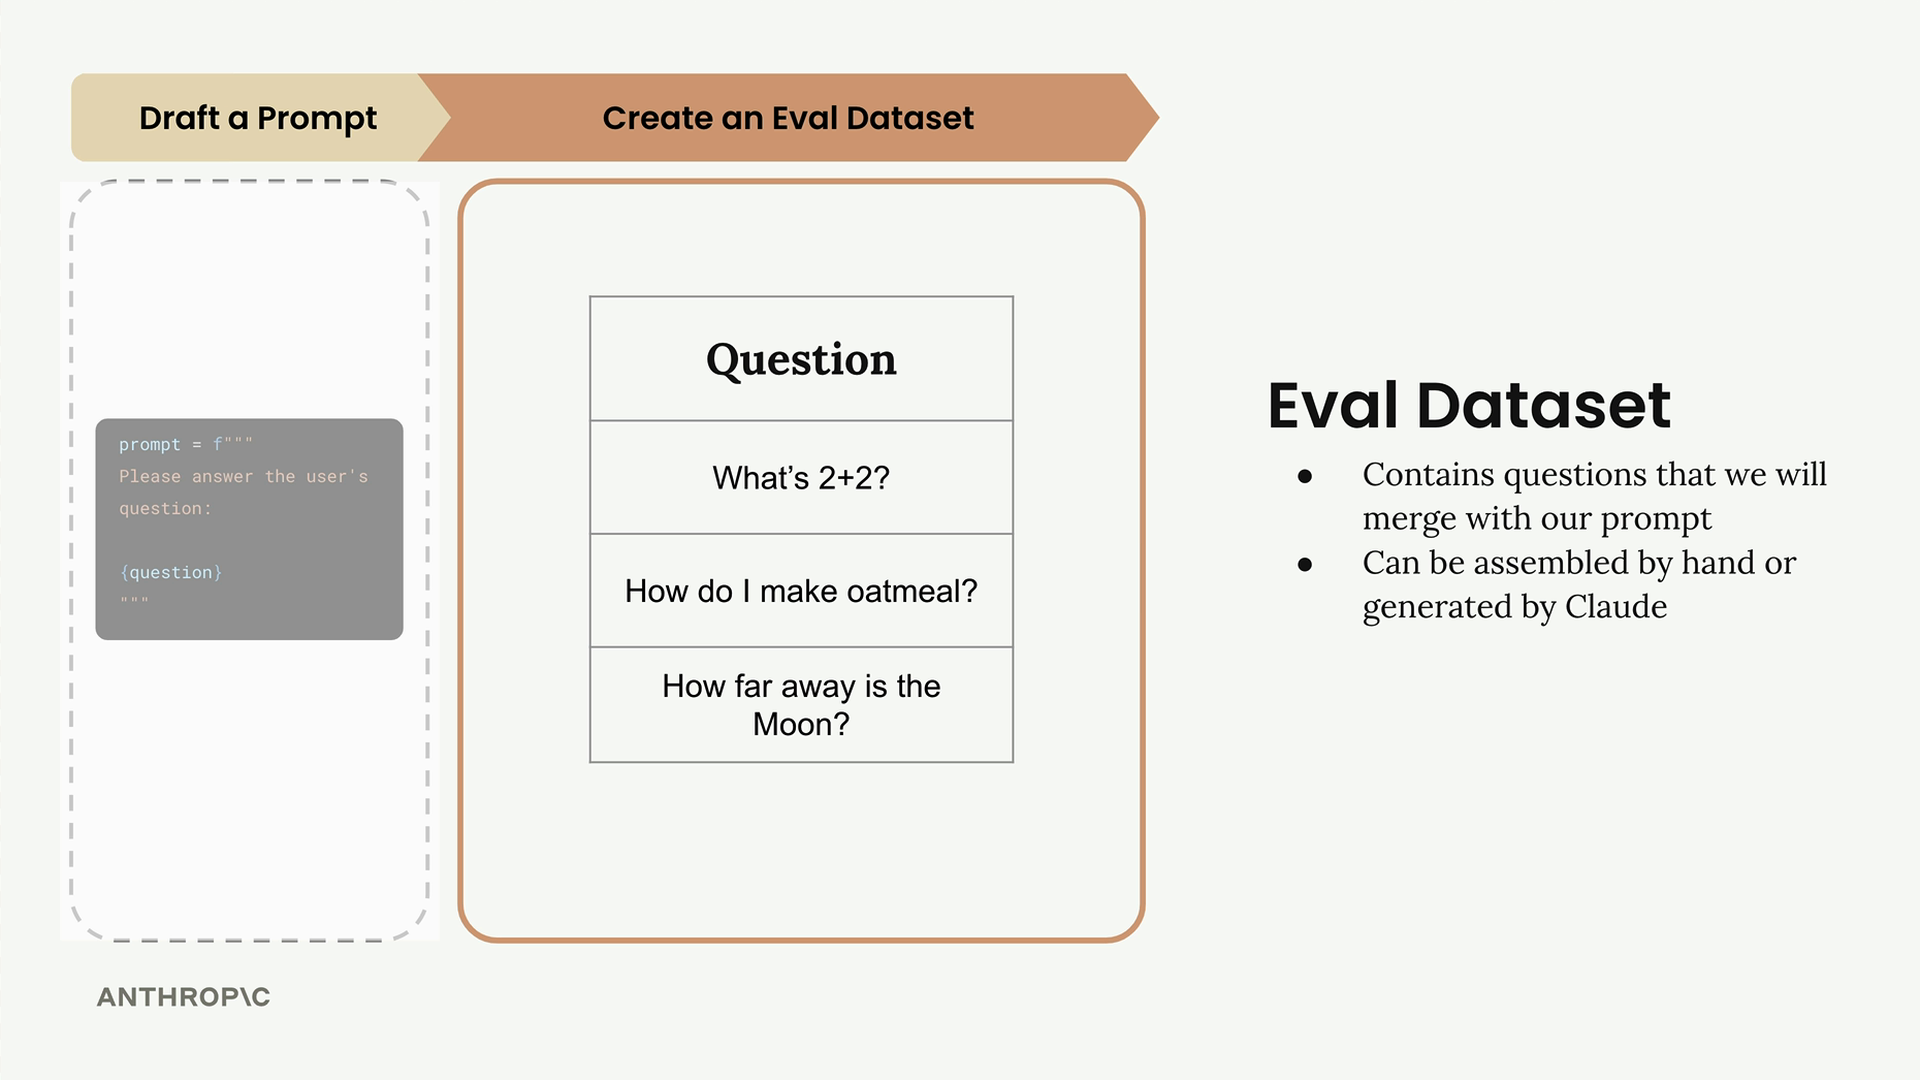
このデータセットには、プロンプトと統合する質問が含まれます。これらのデータセットは手作業で用意することも、Claudeを使って生成することもできます。実際の評価では数十、数百、あるいは数千もの異なるレコードを用いることもありますが、この例では3つの質問から始めます。
- 2+2は何ですか?
- オートミールの作り方は?
- 月はどのくらい離れていますか?
ステップ3:Claudeに通す
データセットから各質問を取り出し、プロンプトテンプレートと統合して完全なプロンプトを作成します。次に、それぞれをClaudeに送信し、応答を収集します。
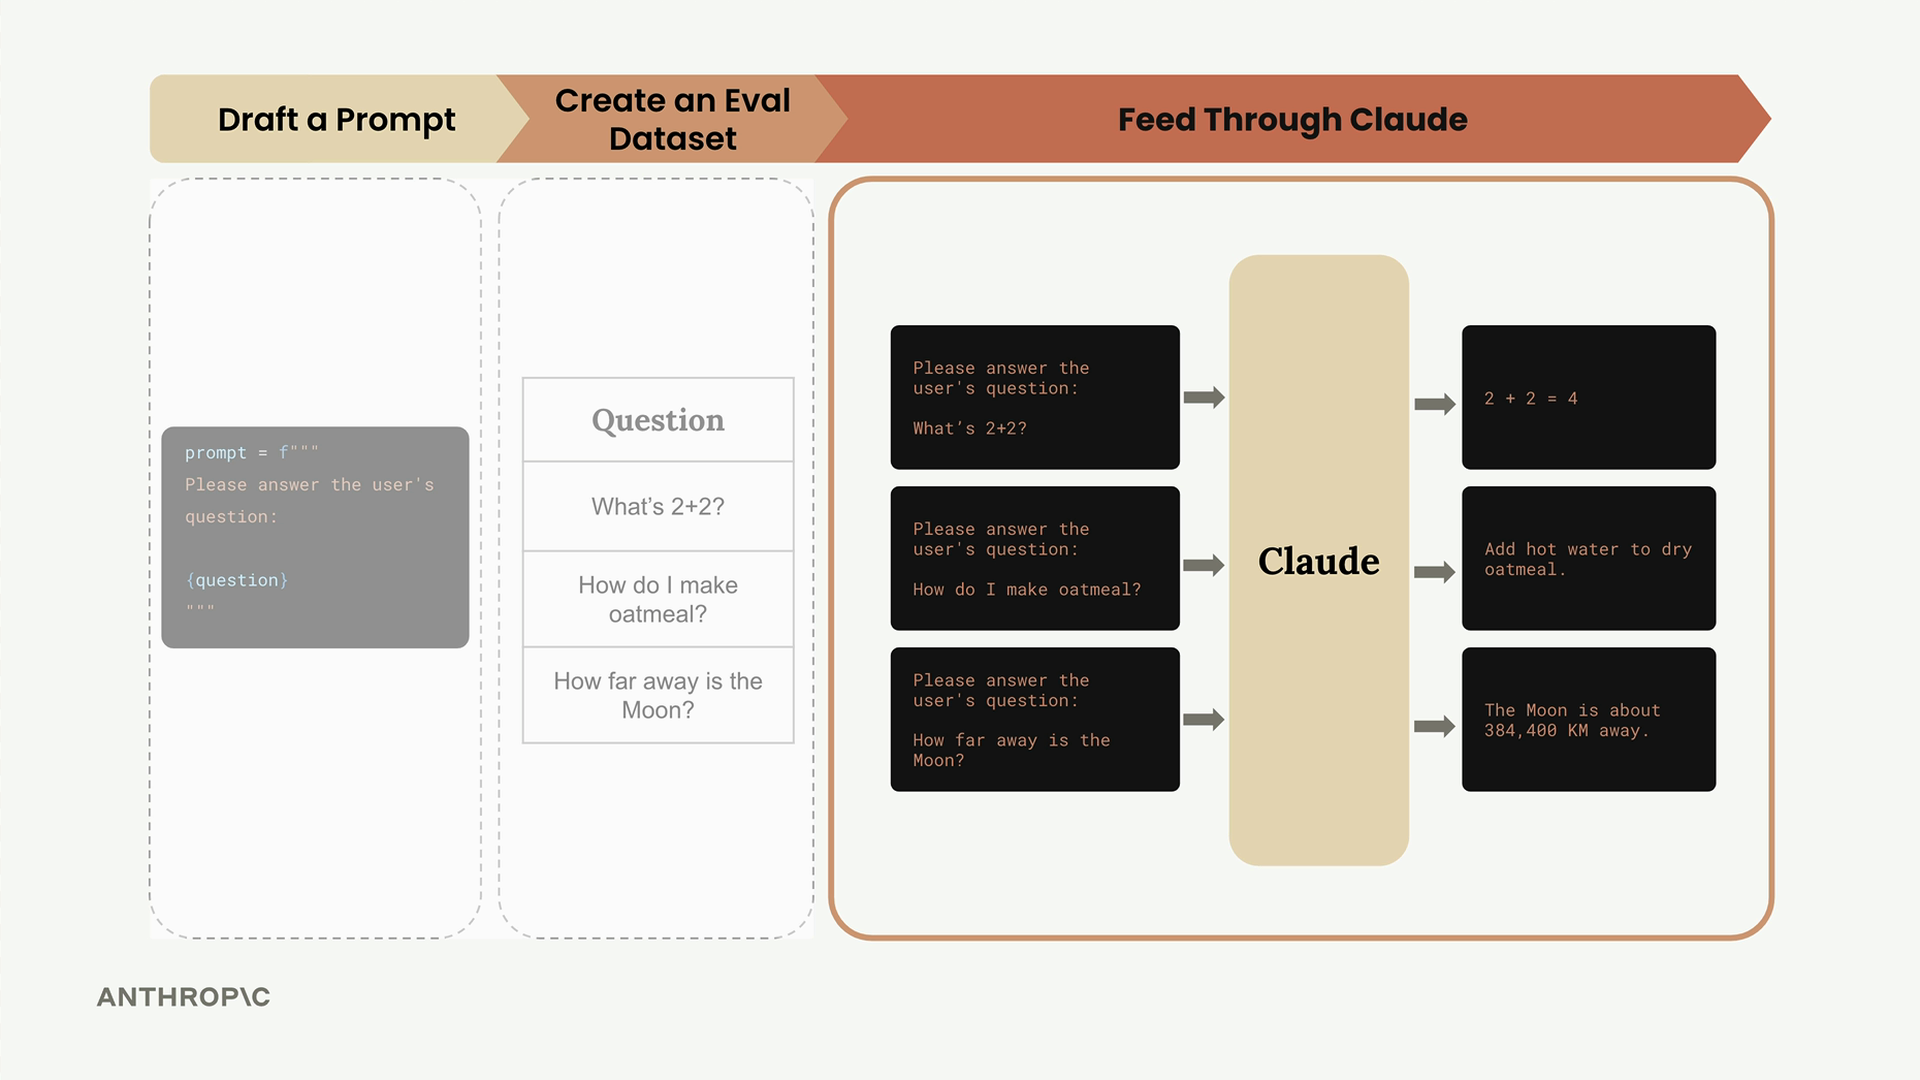
例えば、最初の質問はClaudeが応答できる完全なプロンプトになります。データセット内のすべてのレコードに対してこのプロセスを繰り返し、「2 + 2 = 4」、詳細なオートミールの作り方、月までの距離に関する情報といった応答を得ることになります。
ステップ4:グレーダーに通す
ここで重要なステップが登場します。Claudeの応答を客観的に採点することです。各質問と回答のペアを取り出し、Claudeの応答の品質を評価するグレーダーに投入します。
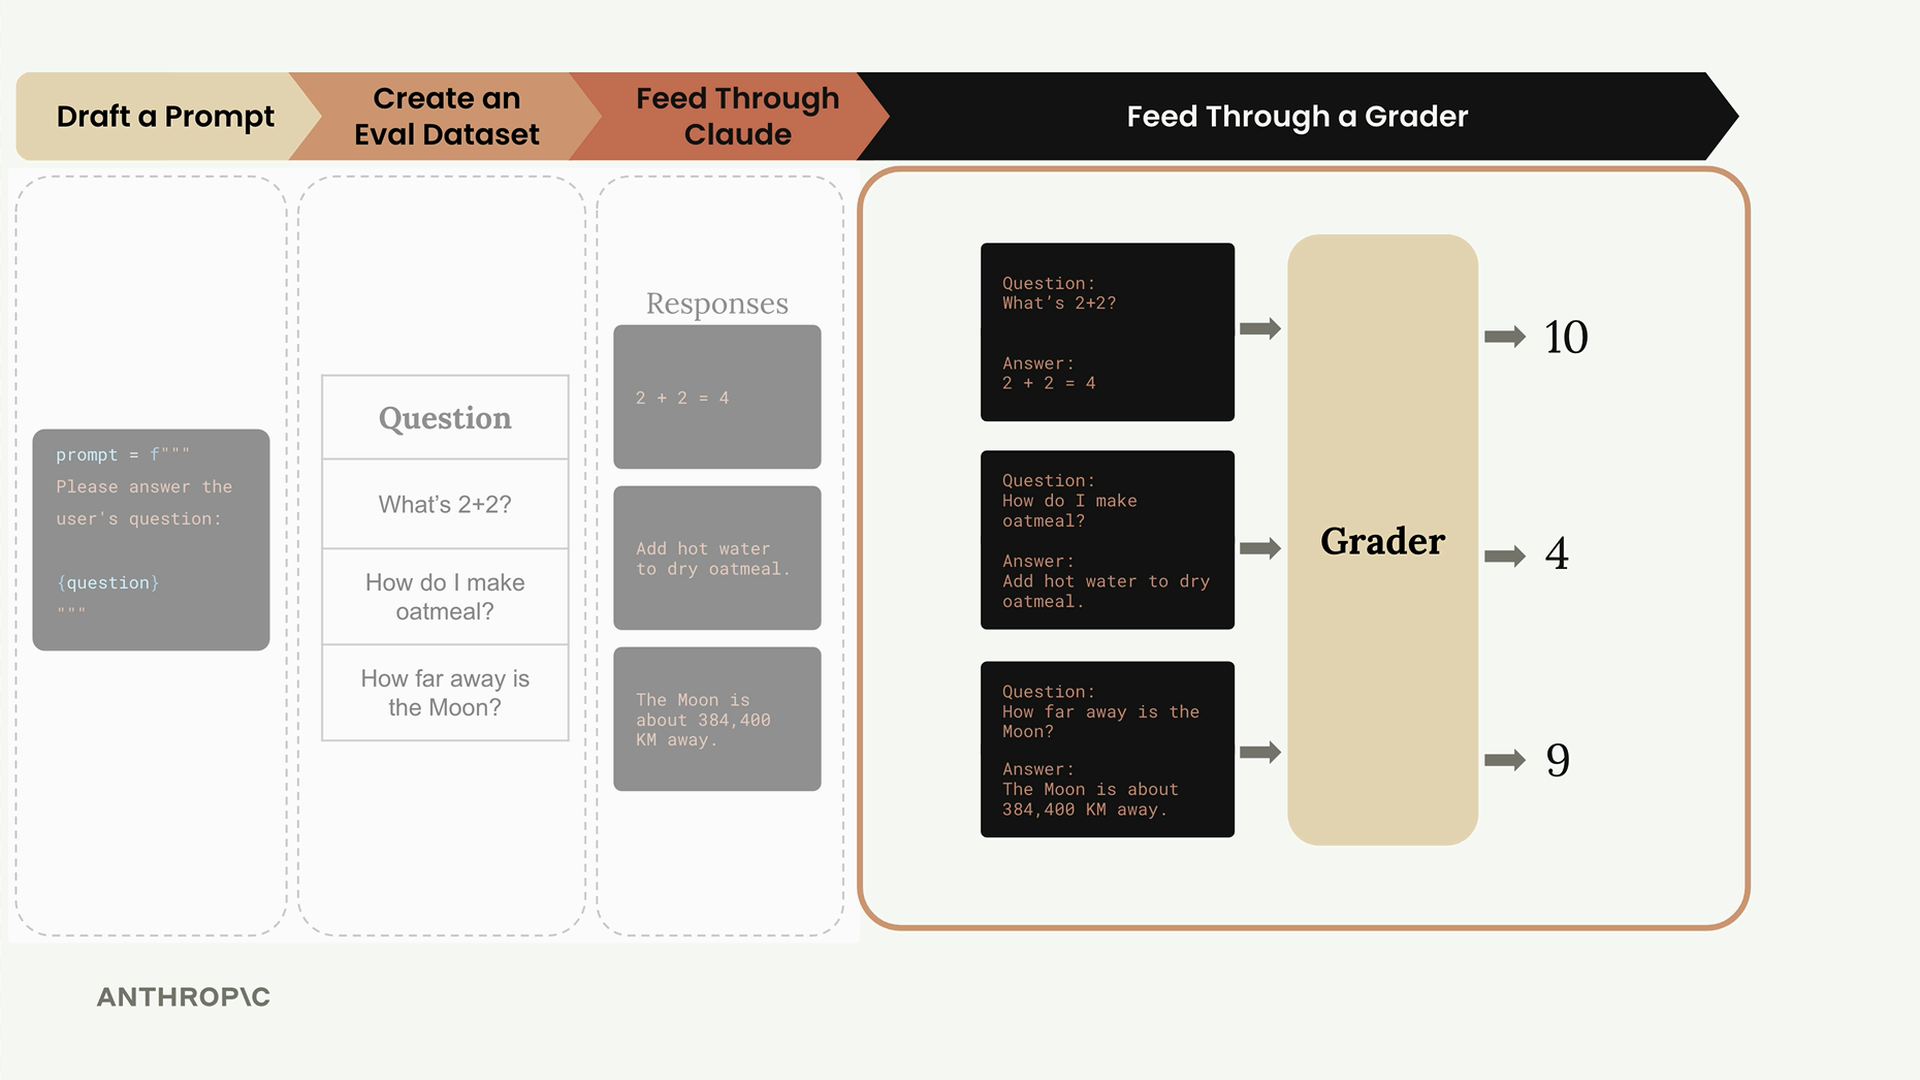
グレーダーは応答の品質に基づいてスコア(通常は1~10)を割り当てます。
- 10 = 完璧な回答で、改善の余地なし
- 4 = 明らかに改善の余地あり
- 1 = 不十分または不正確な回答
この例では、応答はそれぞれ10、4、9と採点されるかもしれません。これらのスコアを平均すると、全体的なパフォーマンス指標が得られます:7.66。
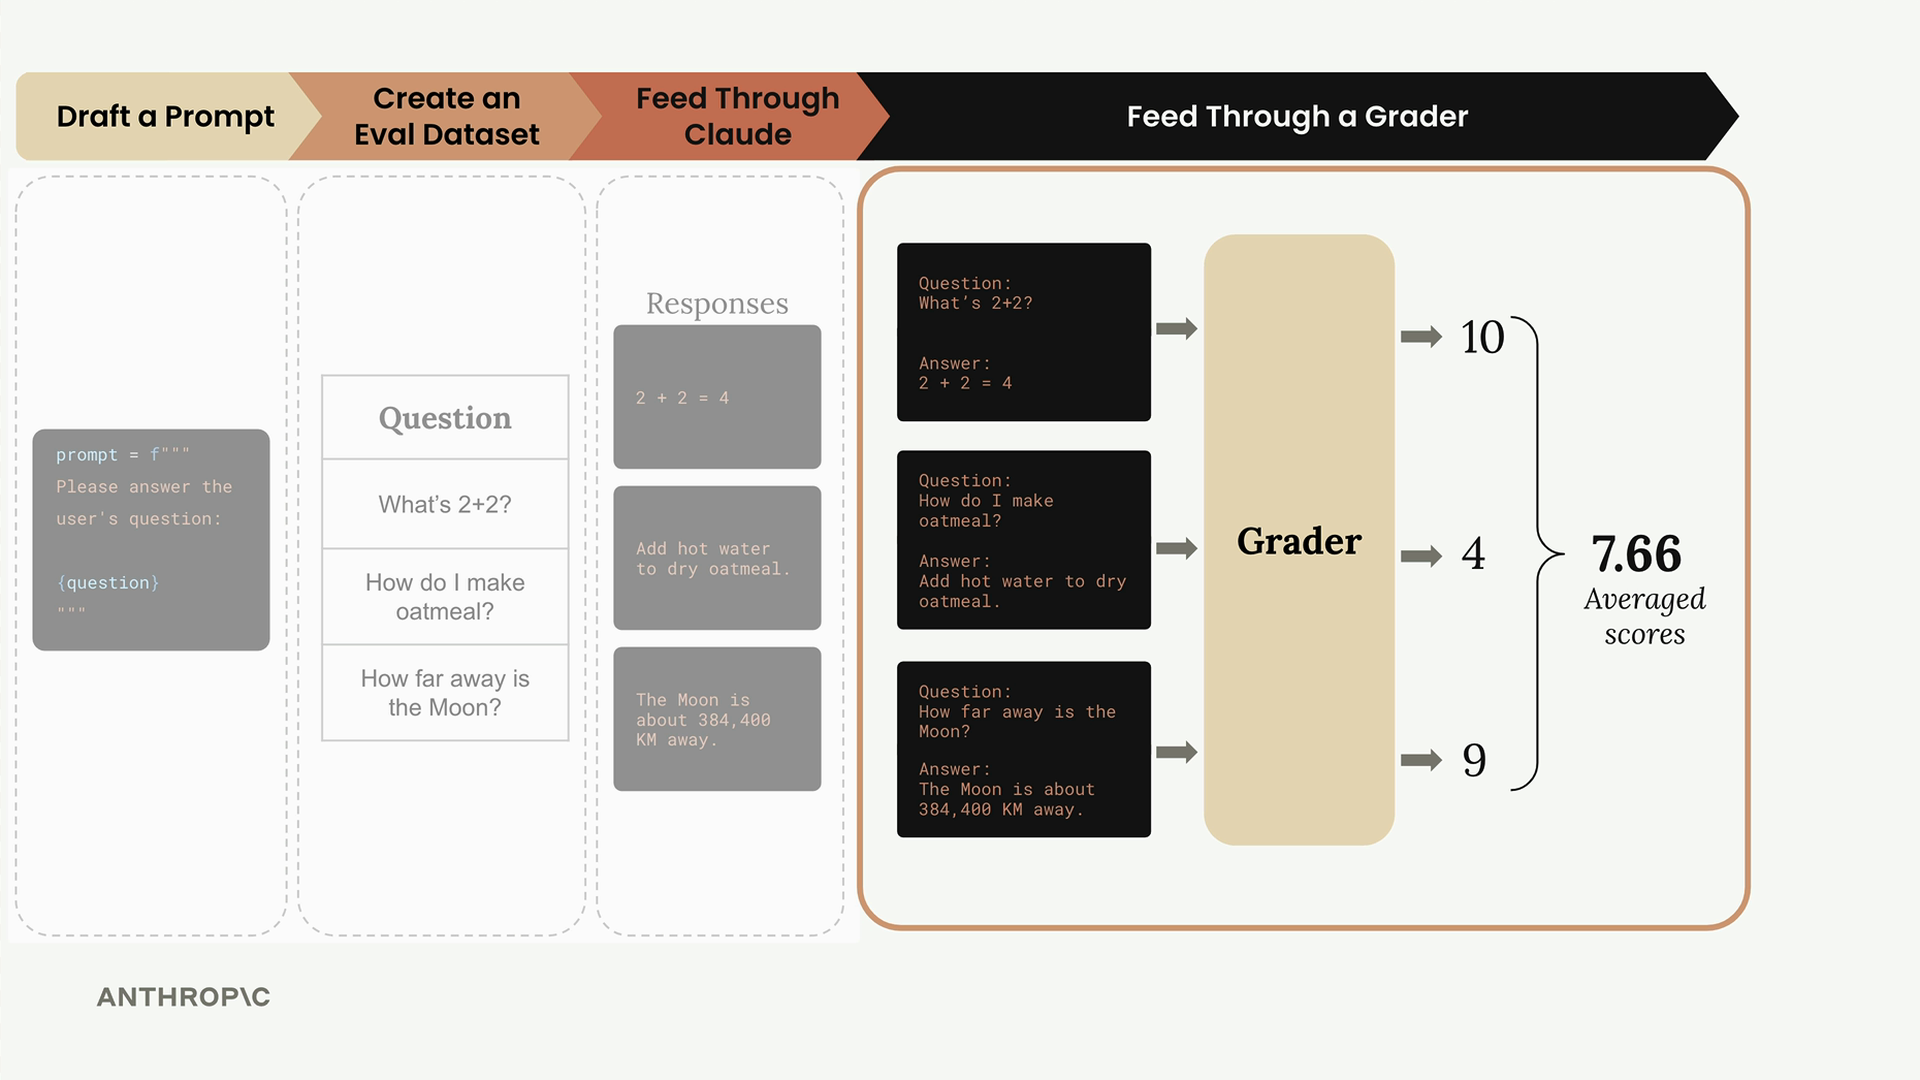
ステップ5:プロンプトを変更して繰り返す
ベースラインのスコアが確立できたので、次はプロンプトを反復改善していきます。より具体的な指示を加えて、Claudeの応答を導いてみましょう。
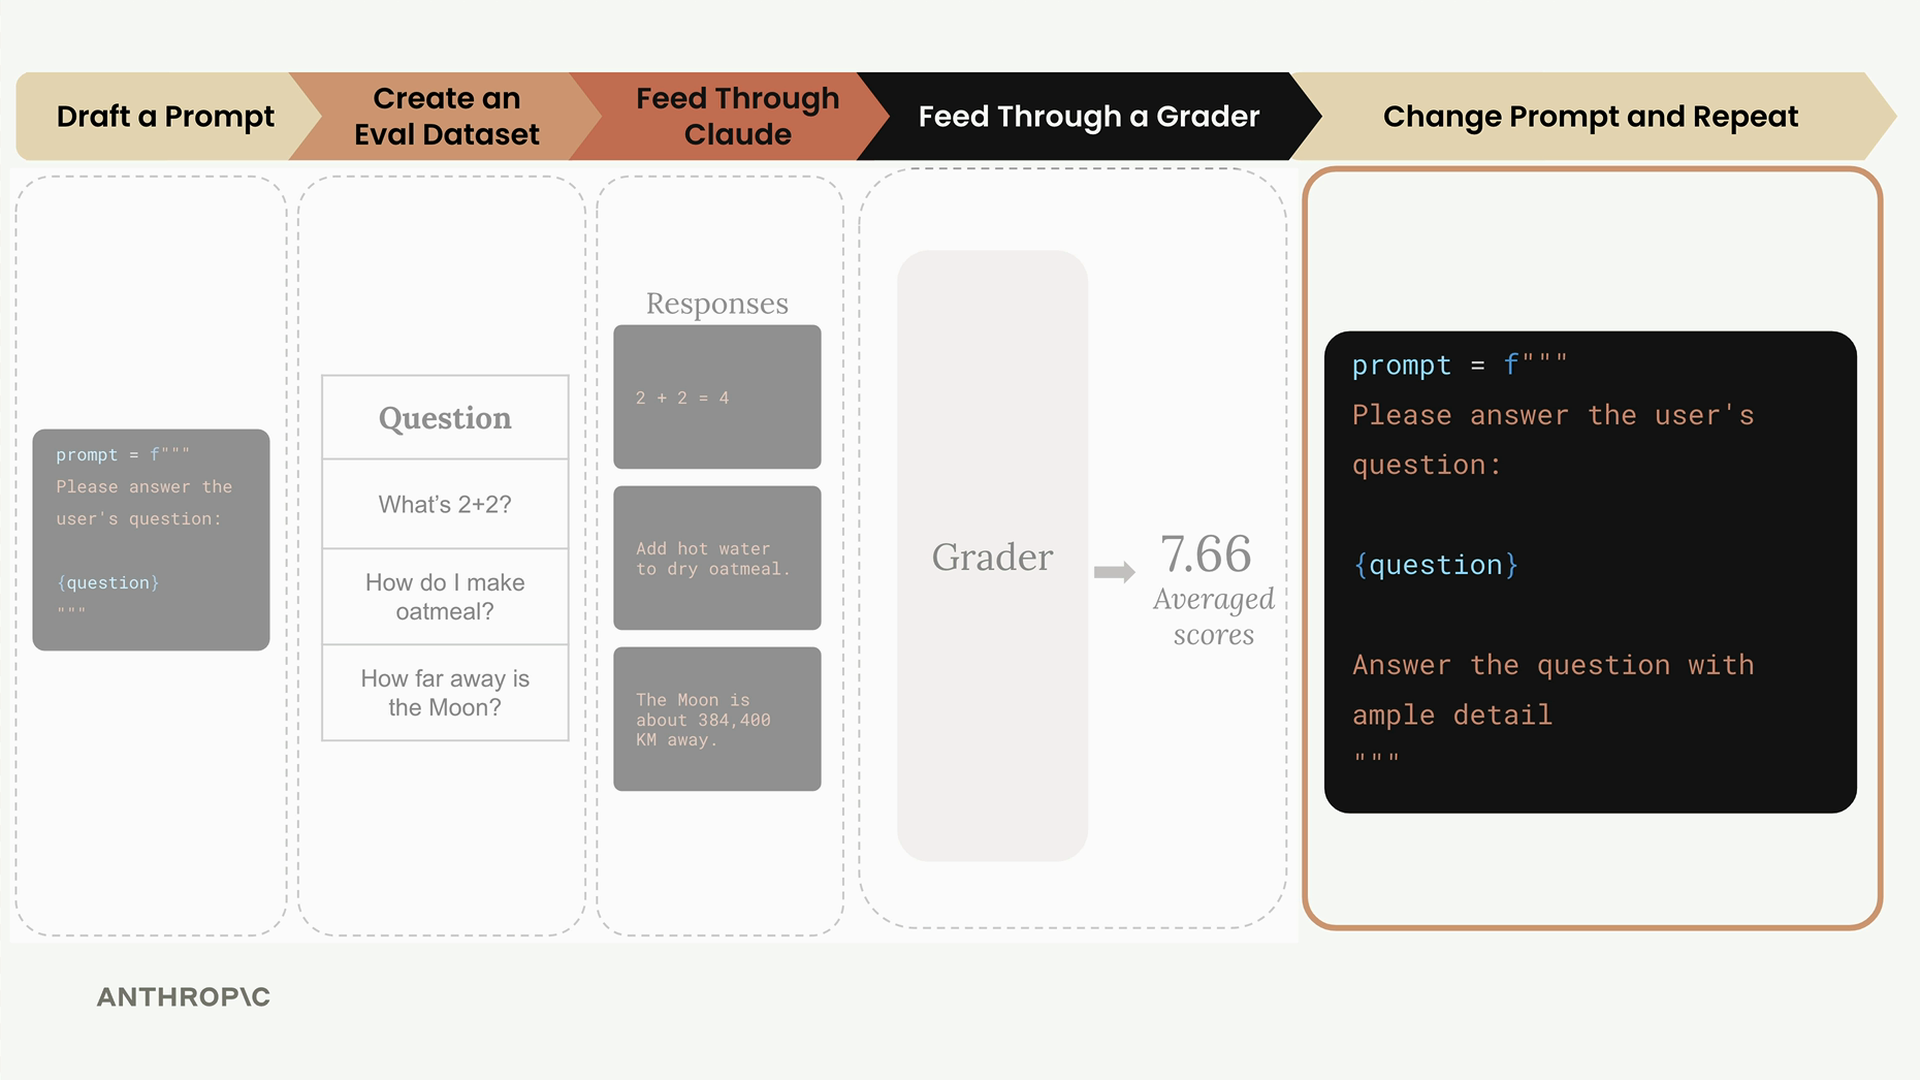
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
この改善版のプロンプトを評価パイプライン全体に再度通します。スコアを比較して、どちらのバージョンがより優れているかを確認します。
プロンプトの採点と反復
このワークフローの力は、各プロンプトバージョンについて客観的な測定値を得られる点にあります。異なる反復間でスコアを比較し、最もパフォーマンスの高いバージョンを使用することも、さらに優れたアプローチを見つけるために反復を続けることもできます。
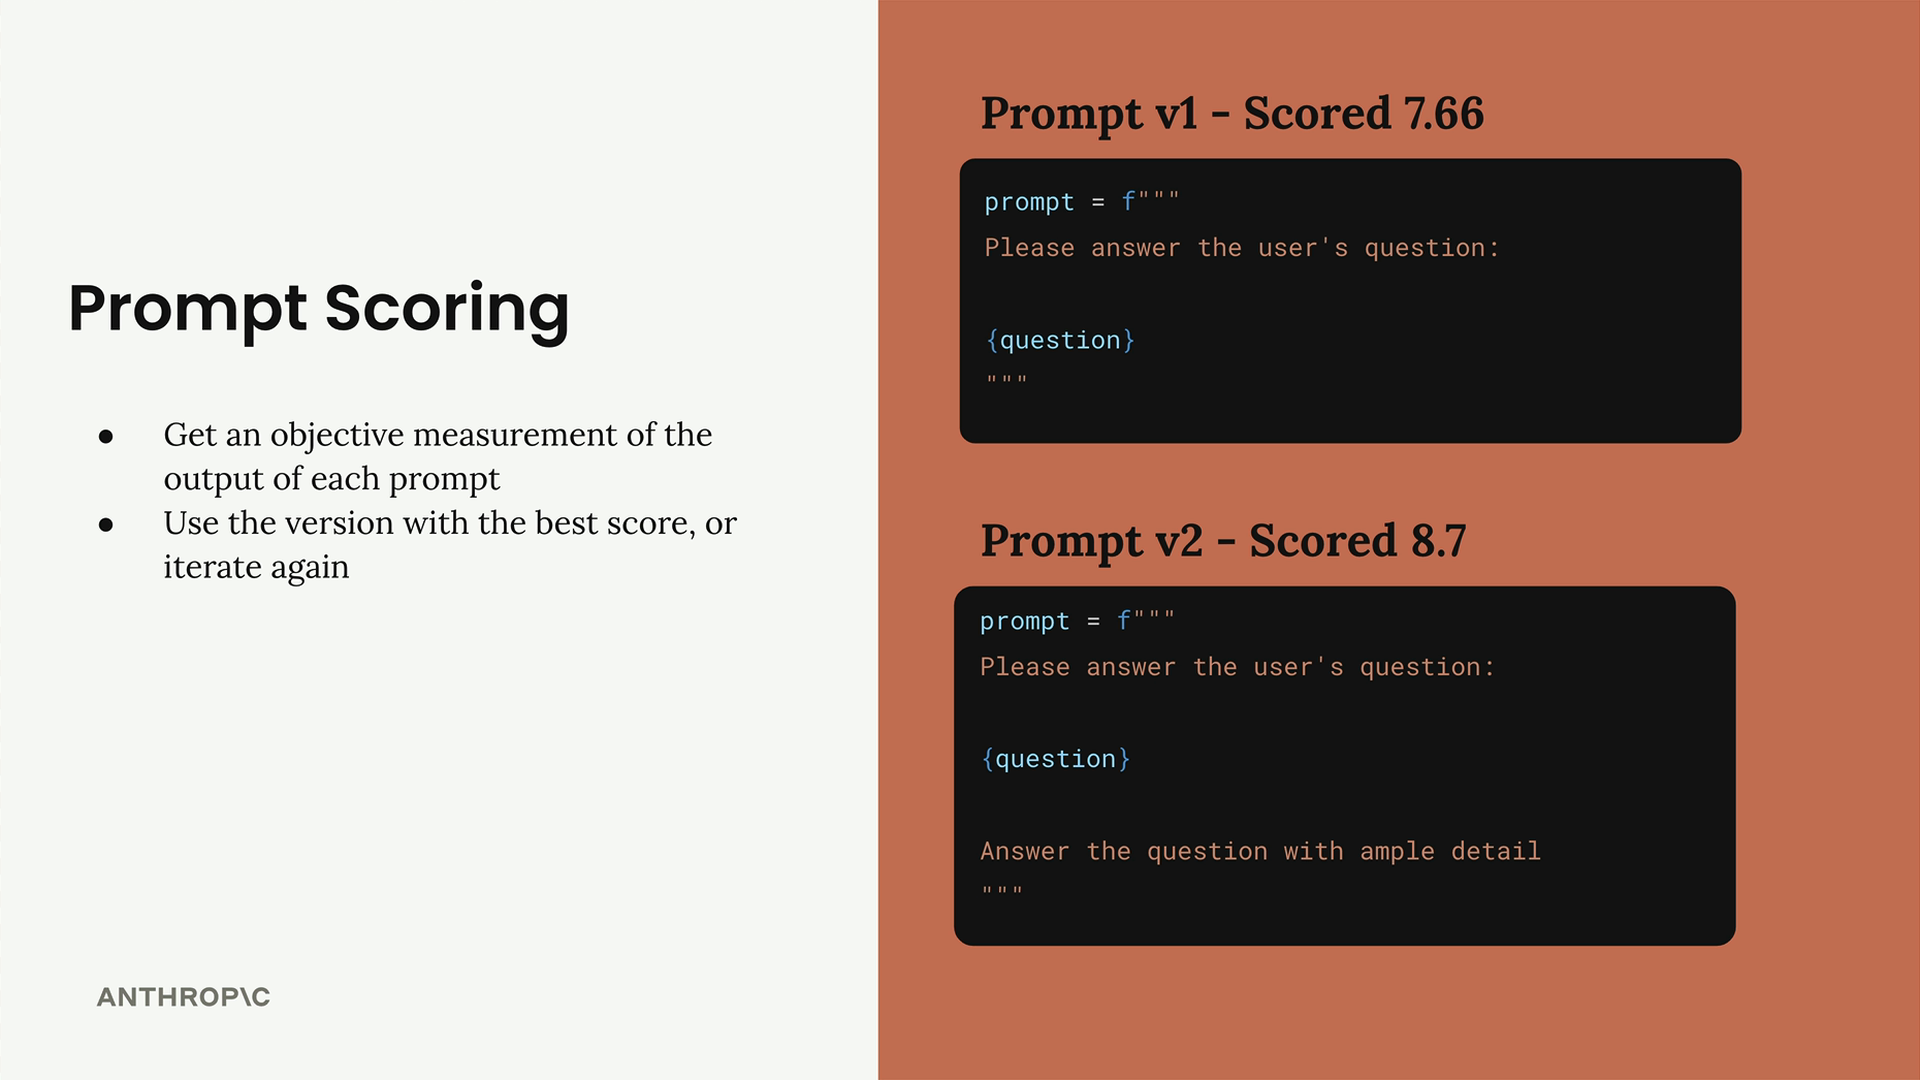
この例では:
- プロンプトv1は7.66点
- プロンプトv2は8.7点
v2の方がスコアが高いことから、「十分な詳細を添えて質問に答えてください」という指示を加えたことで、テストケース全体にわたってプロンプトのパフォーマンスが向上したことがわかります。
この体系的なアプローチにより、主観的な判断に頼るのではなく、プロンプトの改善を客観的に測定する方法が得られます。シンプルな実装から始めて、ニーズの拡大に応じてより高度な評価基準を徐々に追加していくことができます。