コードベースの採点は、モデルの出力が正しい形式に従っているか、有効な構文を持っているかをチェックすることで、プロンプト評価にもう一段階の検証を追加します。これは、モデルにコード、JSON、または正規表現を生成させる場合に特に役立ちます。
コード採点の仕組み
コードグレーダーは、2つの主要な基準を評価します。
- 形式の準拠 - 出力には説明なしで、要求された形式(Python、JSON、または正規表現)のみが含まれているか?
- 有効な構文 - 出力は実際に解析またはコンパイルに成功するか?
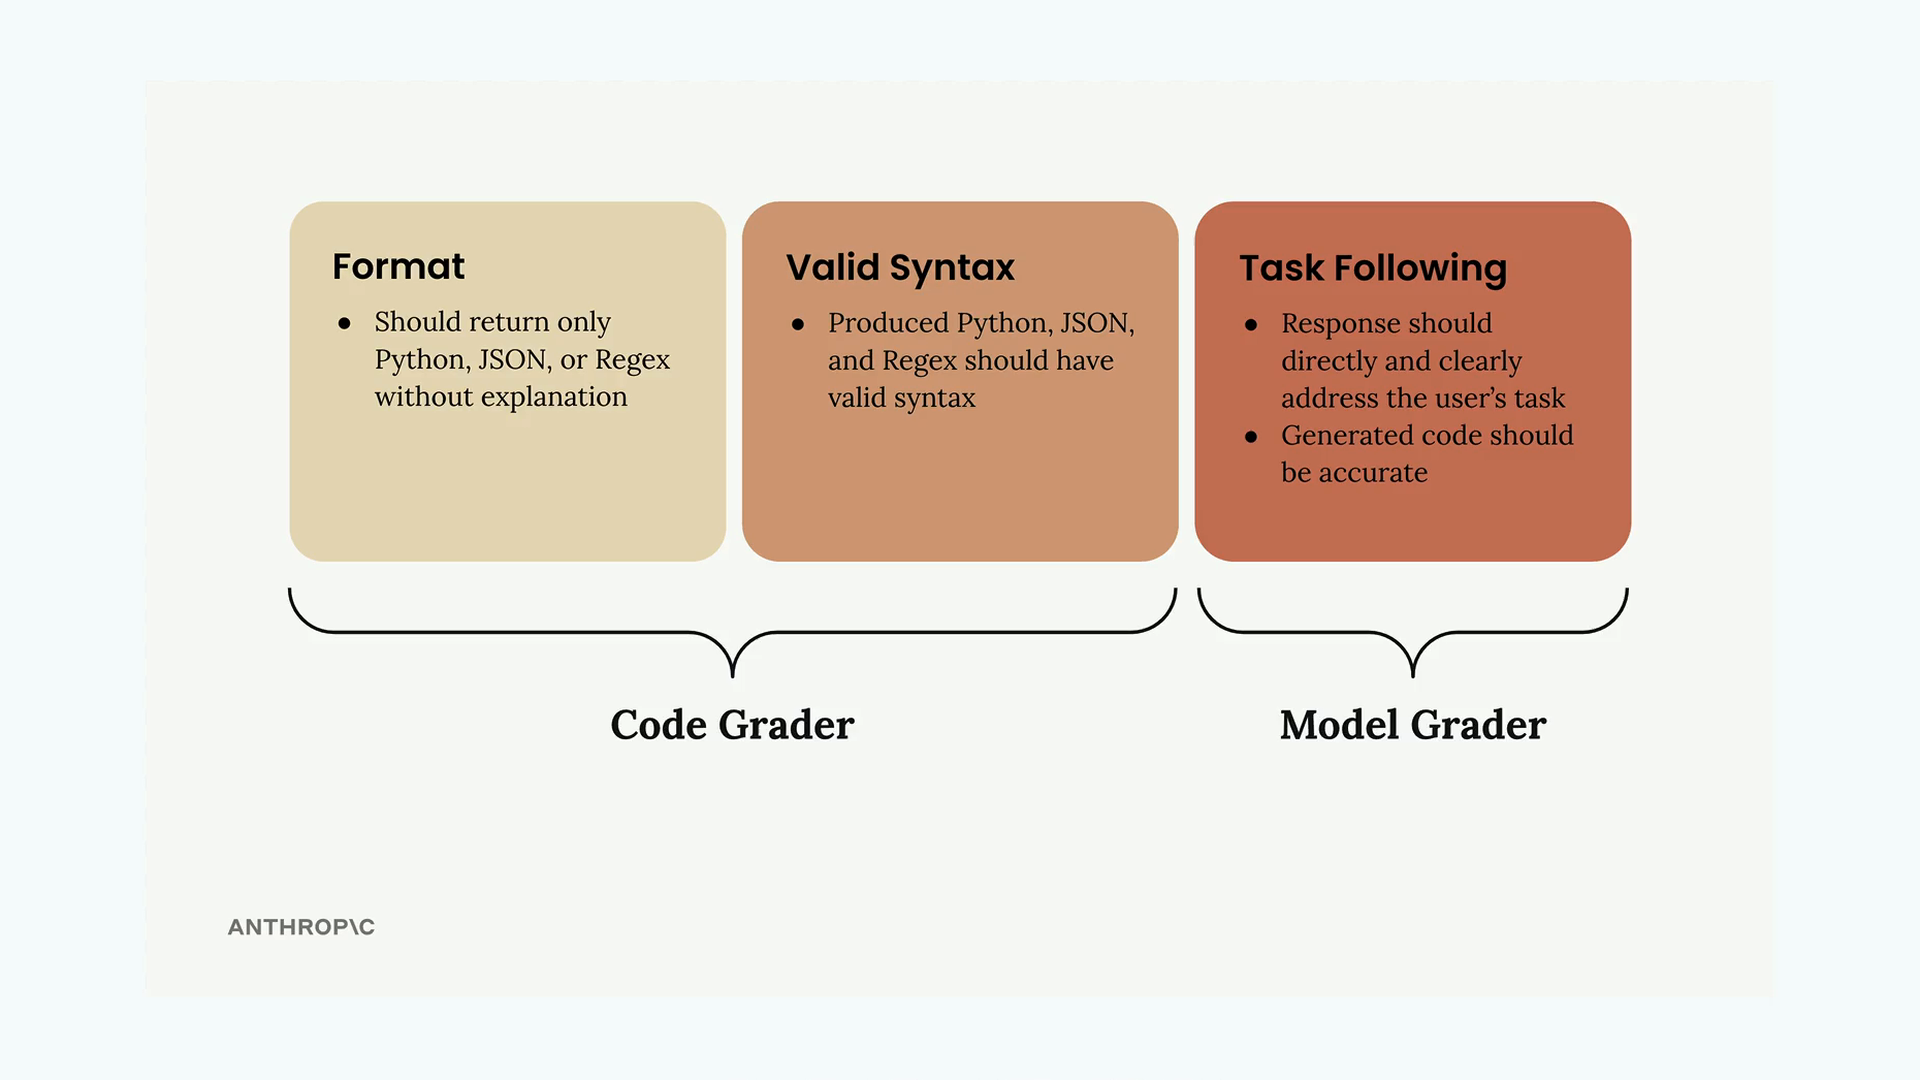
システムは、各形式タイプに対して個別の検証関数を使用します。コードの解析に成功すれば、満点の10点が付与されます。解析がエラーで失敗した場合は、0点が付与されます。
検証関数の設定
さまざまな出力タイプを検証するために、3つのヘルパー関数が必要です。
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
return 0これらの関数は、Pythonの組み込みの解析機能を使用して構文の妥当性をチェックします。json.loads() 関数はJSONを検証し、ast.parse() はPythonの抽象構文木を作成し、re.compile() は正規表現を検証します。
テストケースへの形式情報の追加
テストデータセットには、各タスクに期待される出力形式を指定する必要があります。データセット生成プロンプトを更新して、format フィールドを含めてください。
{
    "task": "Description of task",
    "format": "python"
}
format フィールドには、そのタスクから期待される出力の種類に応じて、"json"、"python"、または "regex" のいずれかが含まれる必要があります。
プロンプトの改善
コードグレーダーからより良い結果を得るために、プロンプトの指示をより具体的にします。
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationクリーンな出力フォーマットを確保するために、コードブロックとストップシーケンスを含む事前入力済みのアシスタントメッセージを使用することもできます。
スコアの統合
まず、各テストケースに一致するバリデーターを選びます。
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
return validate_regex(output)最後のステップは、モデルグレーダーのスコアと構文グレーダーのスコアをマージすることです。シンプルなアプローチとしては、run_test_case の中で両方のスコアの平均を取る方法があります。
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
これにより、(モデルグレーダーによる)コンテンツの品質と(コードグレーダーによる)技術的な正確性の両方に同じ重みが与えられます。この重み付けは、特定のユースケースでどちらがより重要かに応じて調整できます。
結果の解釈
評価を実行すると、生成されたコードの意味的な品質と技術的な正確性の両方を反映した統合スコアが得られます。単独のスコアだけでは多くのことはわからないことを覚えておいてください。本当の価値は、プロンプトの設計を改善していく中でスコアを比較することから生まれます。
このベースラインスコアを使用してプロンプトの改善をテストし、変更が実際により良く、より信頼性の高いコード生成につながっているかどうかを確認してください。