セマンティック検索(ベクトル埋め込み)とレキシカル検索(BM25)の両方が独立して動作するようになったら、次のステップはそれらを統合検索パイプラインに組み合わせることです。このハイブリッドアプローチは、両方の手法の強みを活かして、より正確な結果を提供します。
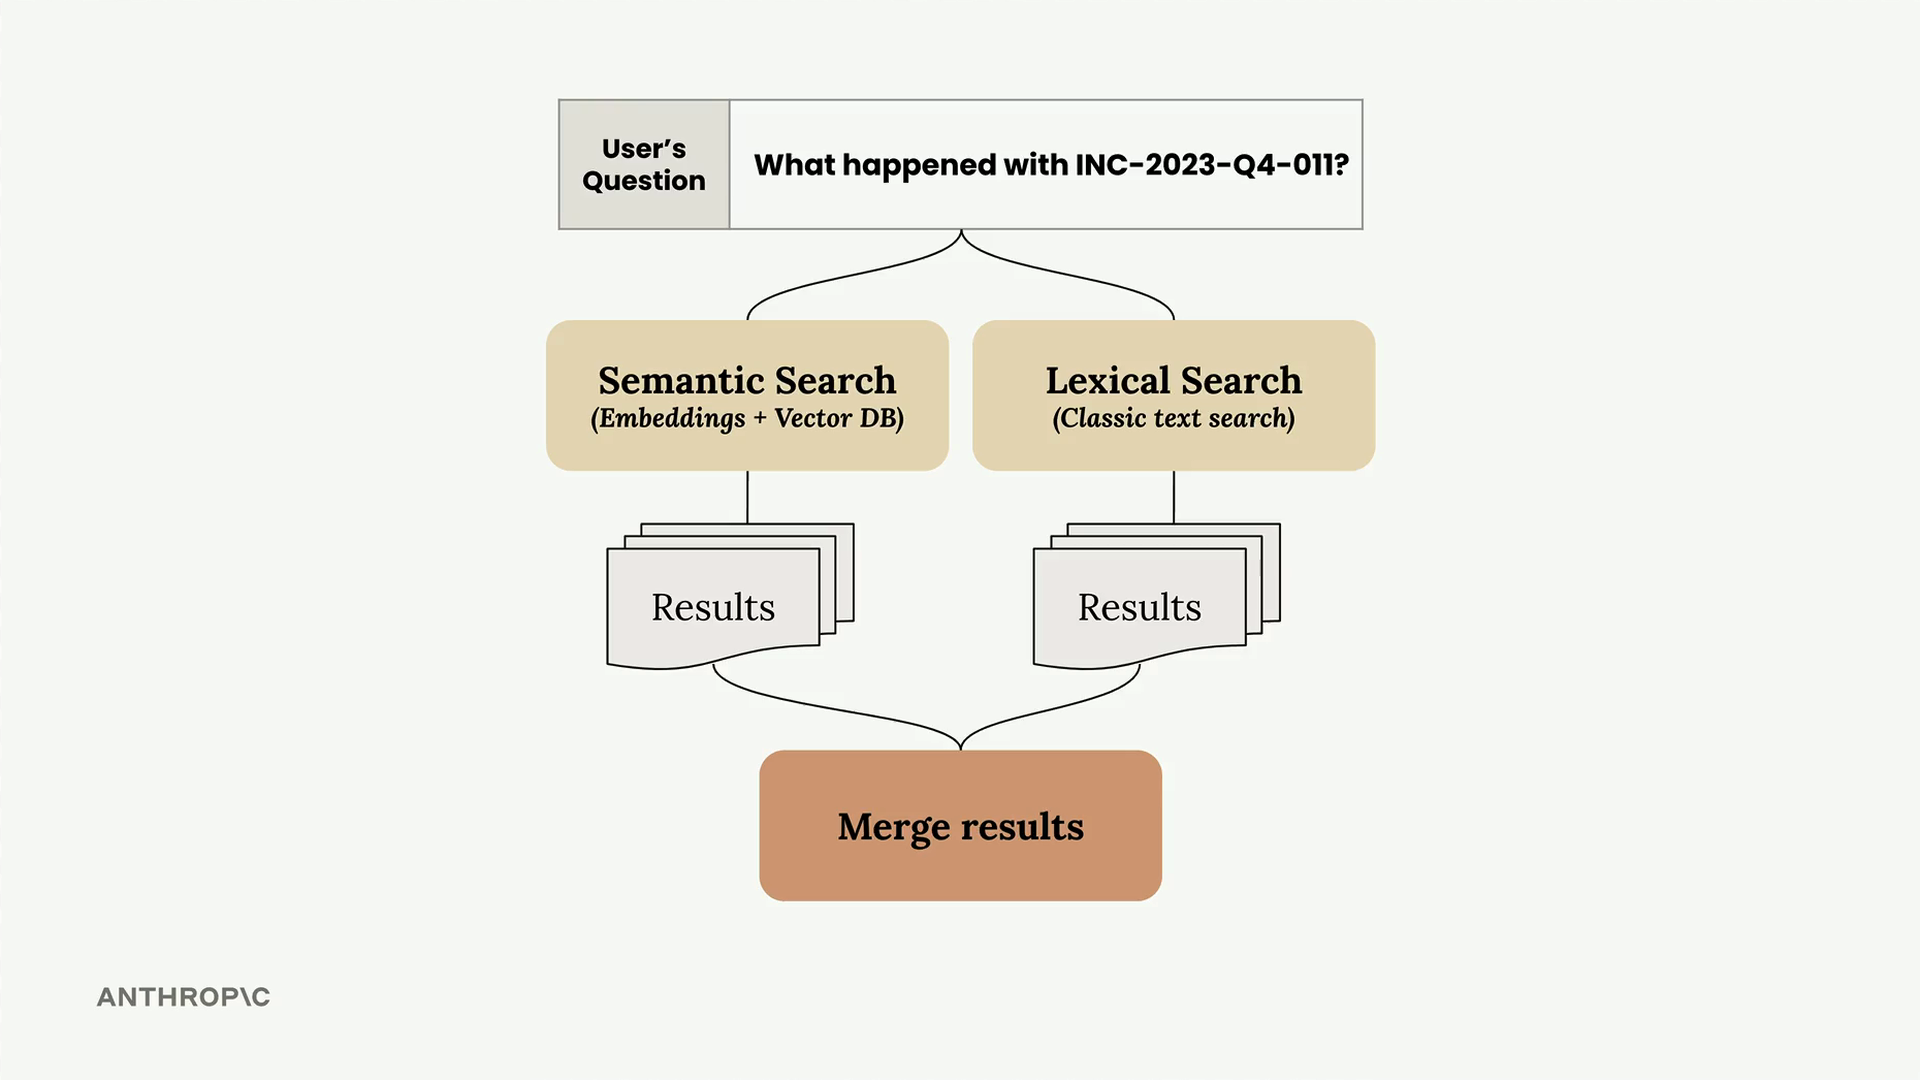
統一インターフェースの構築
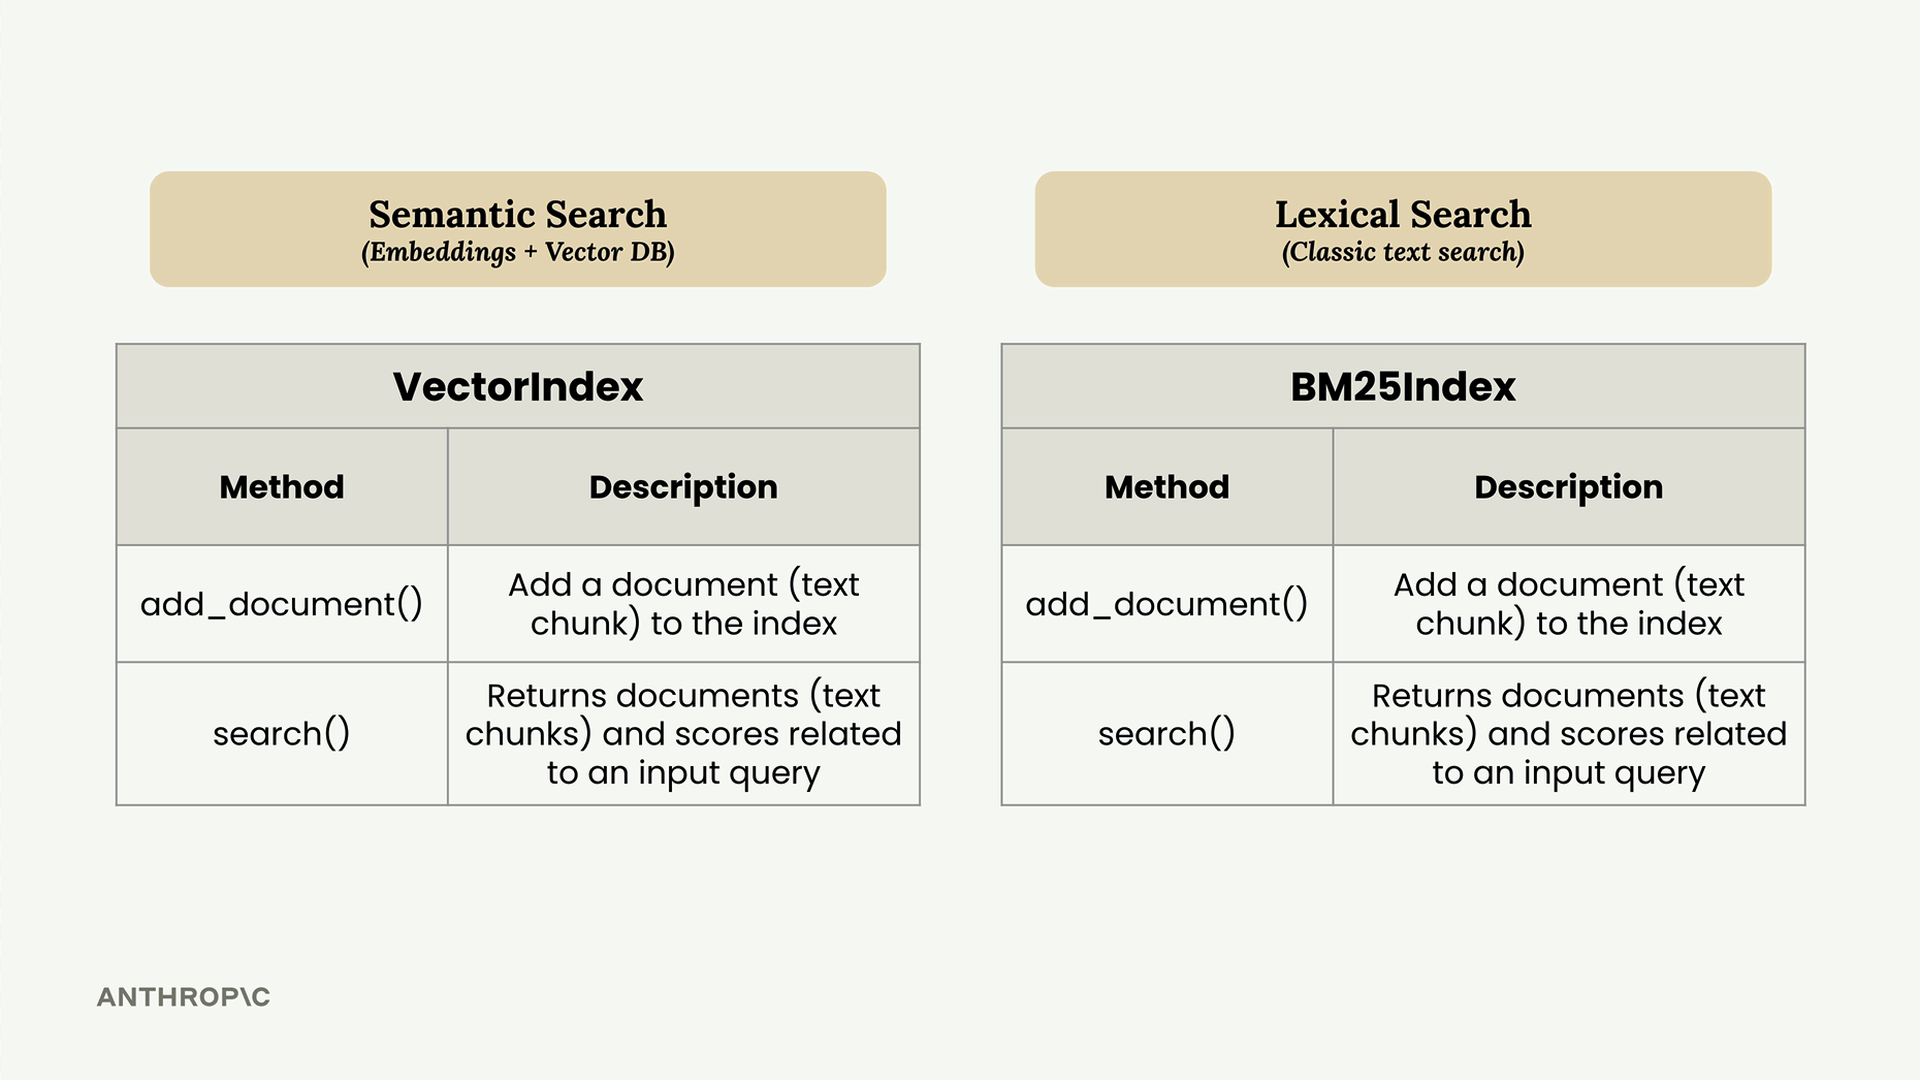
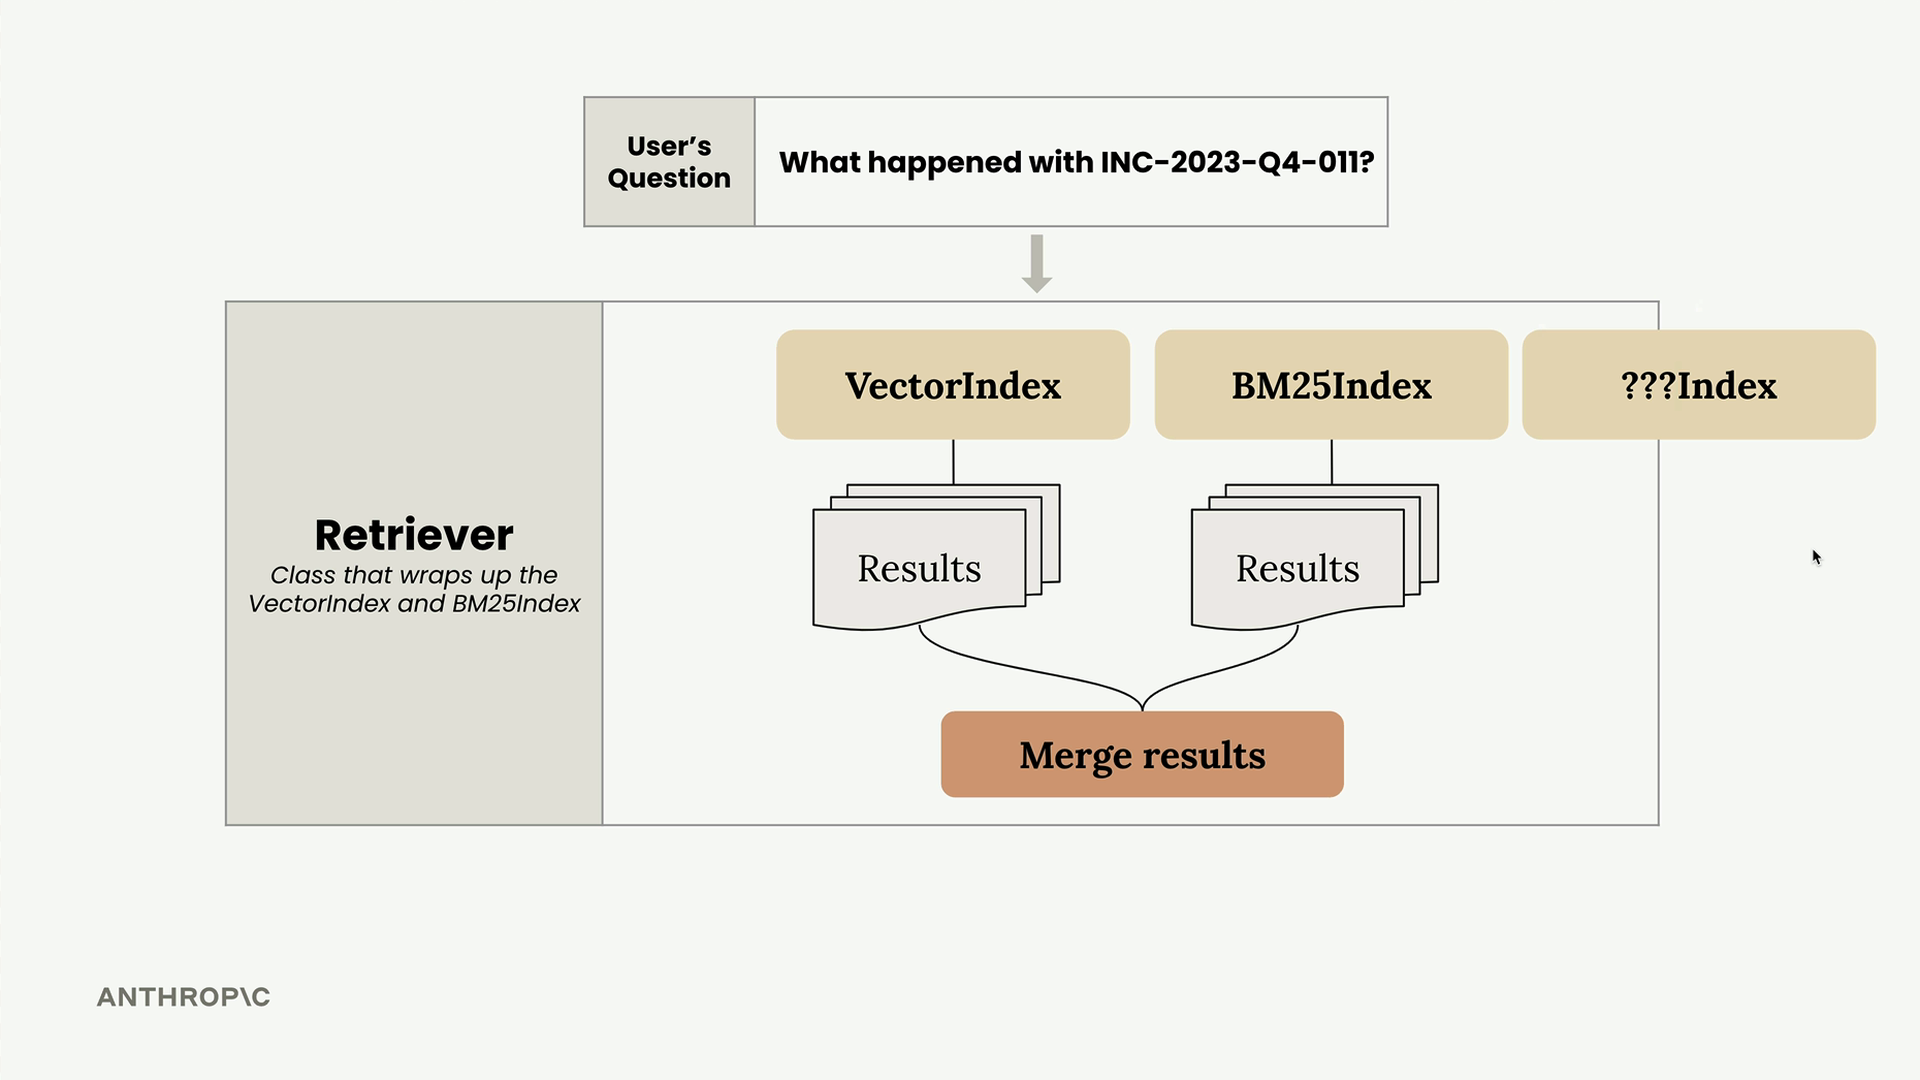
両方の検索実装はほぼ同一のAPIを共有しており、どちらもadd_document()メソッドとsearch()メソッドを持っています。この一貫性により、両方のアプローチを調整する単一のRetrieverクラスにラップすることが容易になります。
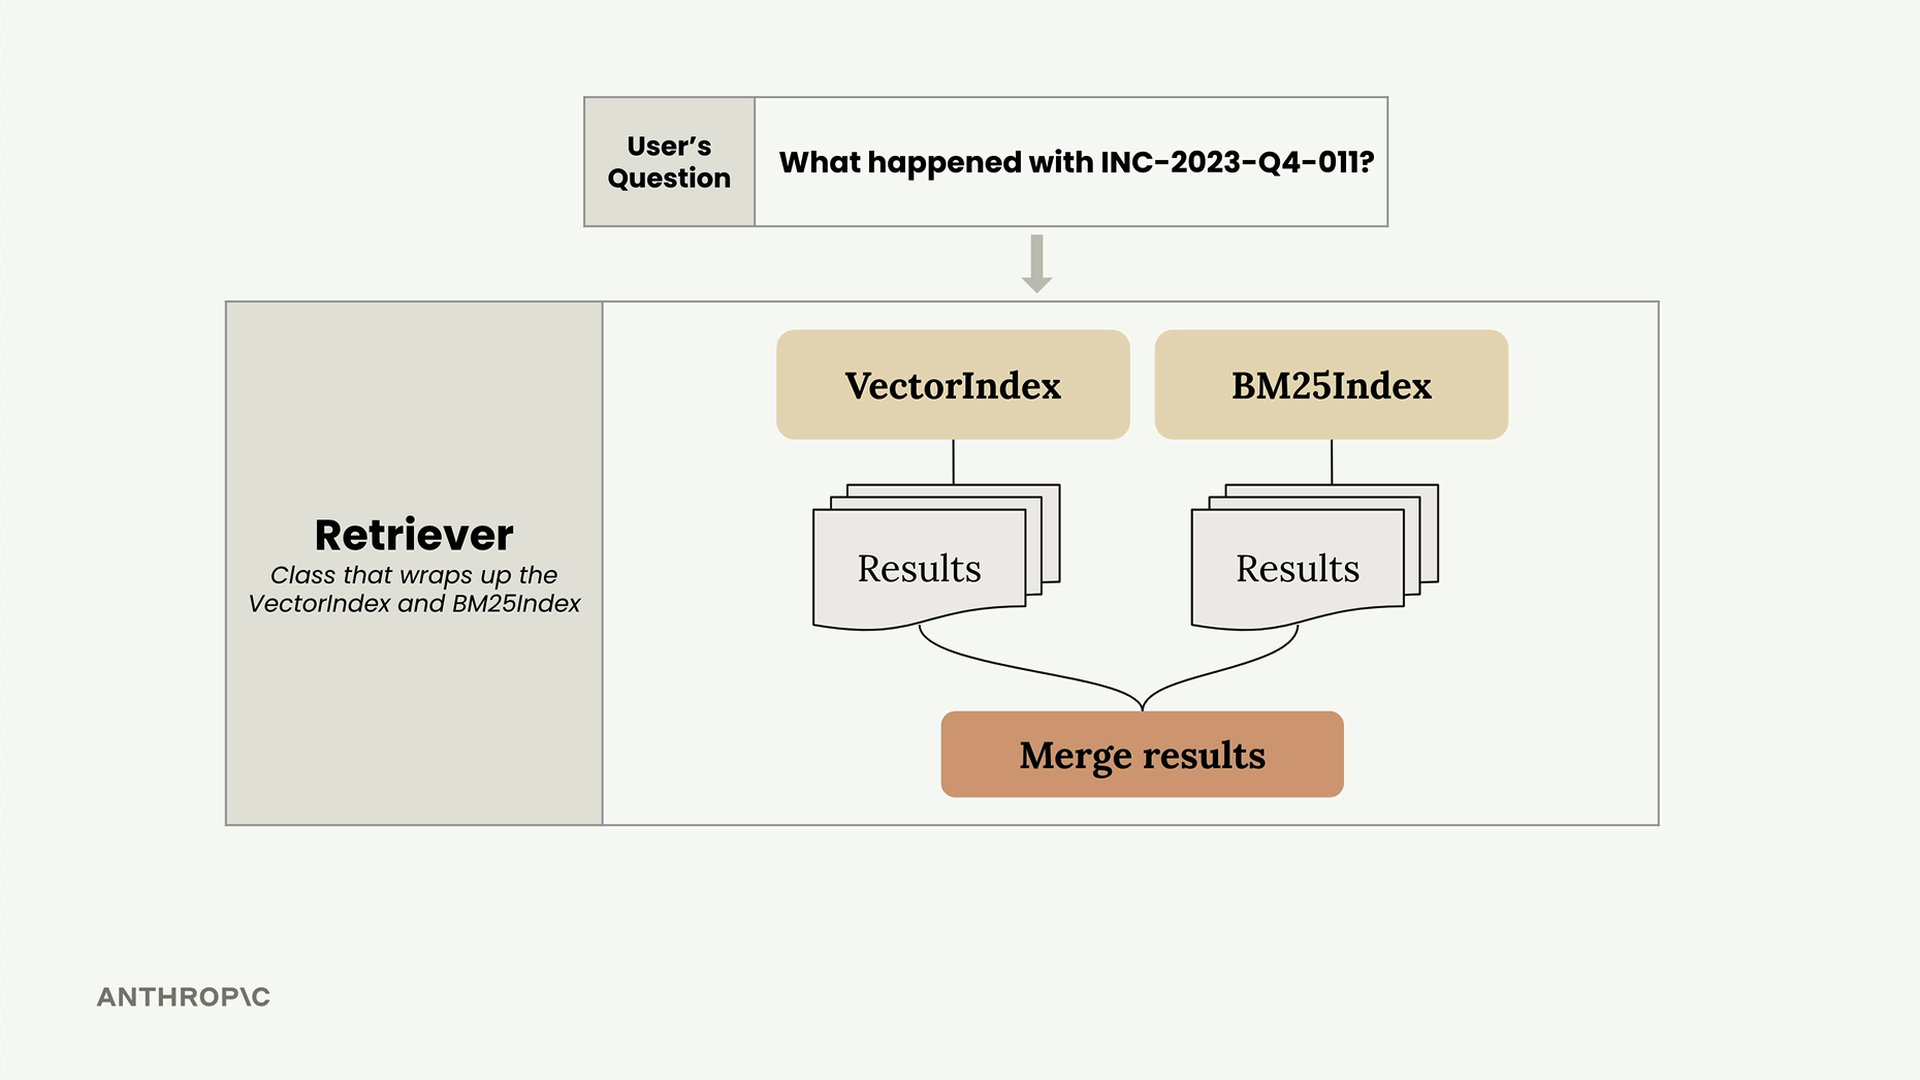
Retrieverはコーディネーターとして機能し、以下を行います。
- ユーザーの質問を受け取る
- それをVectorIndexとBM25Indexの両方に転送する
- 両方のシステムから結果を収集する
- ランキングアルゴリズムを使用して結果をマージする
Reciprocal Rank Fusion
課題は、異なる検索方法からの結果をマージすることにあります。各システムは異なるスコアリングメカニズムで結果を返すため、単純にスコアを直接組み合わせることはできません。代わりに、Reciprocal Rank Fusion(RRF)と呼ばれる手法を使用します。
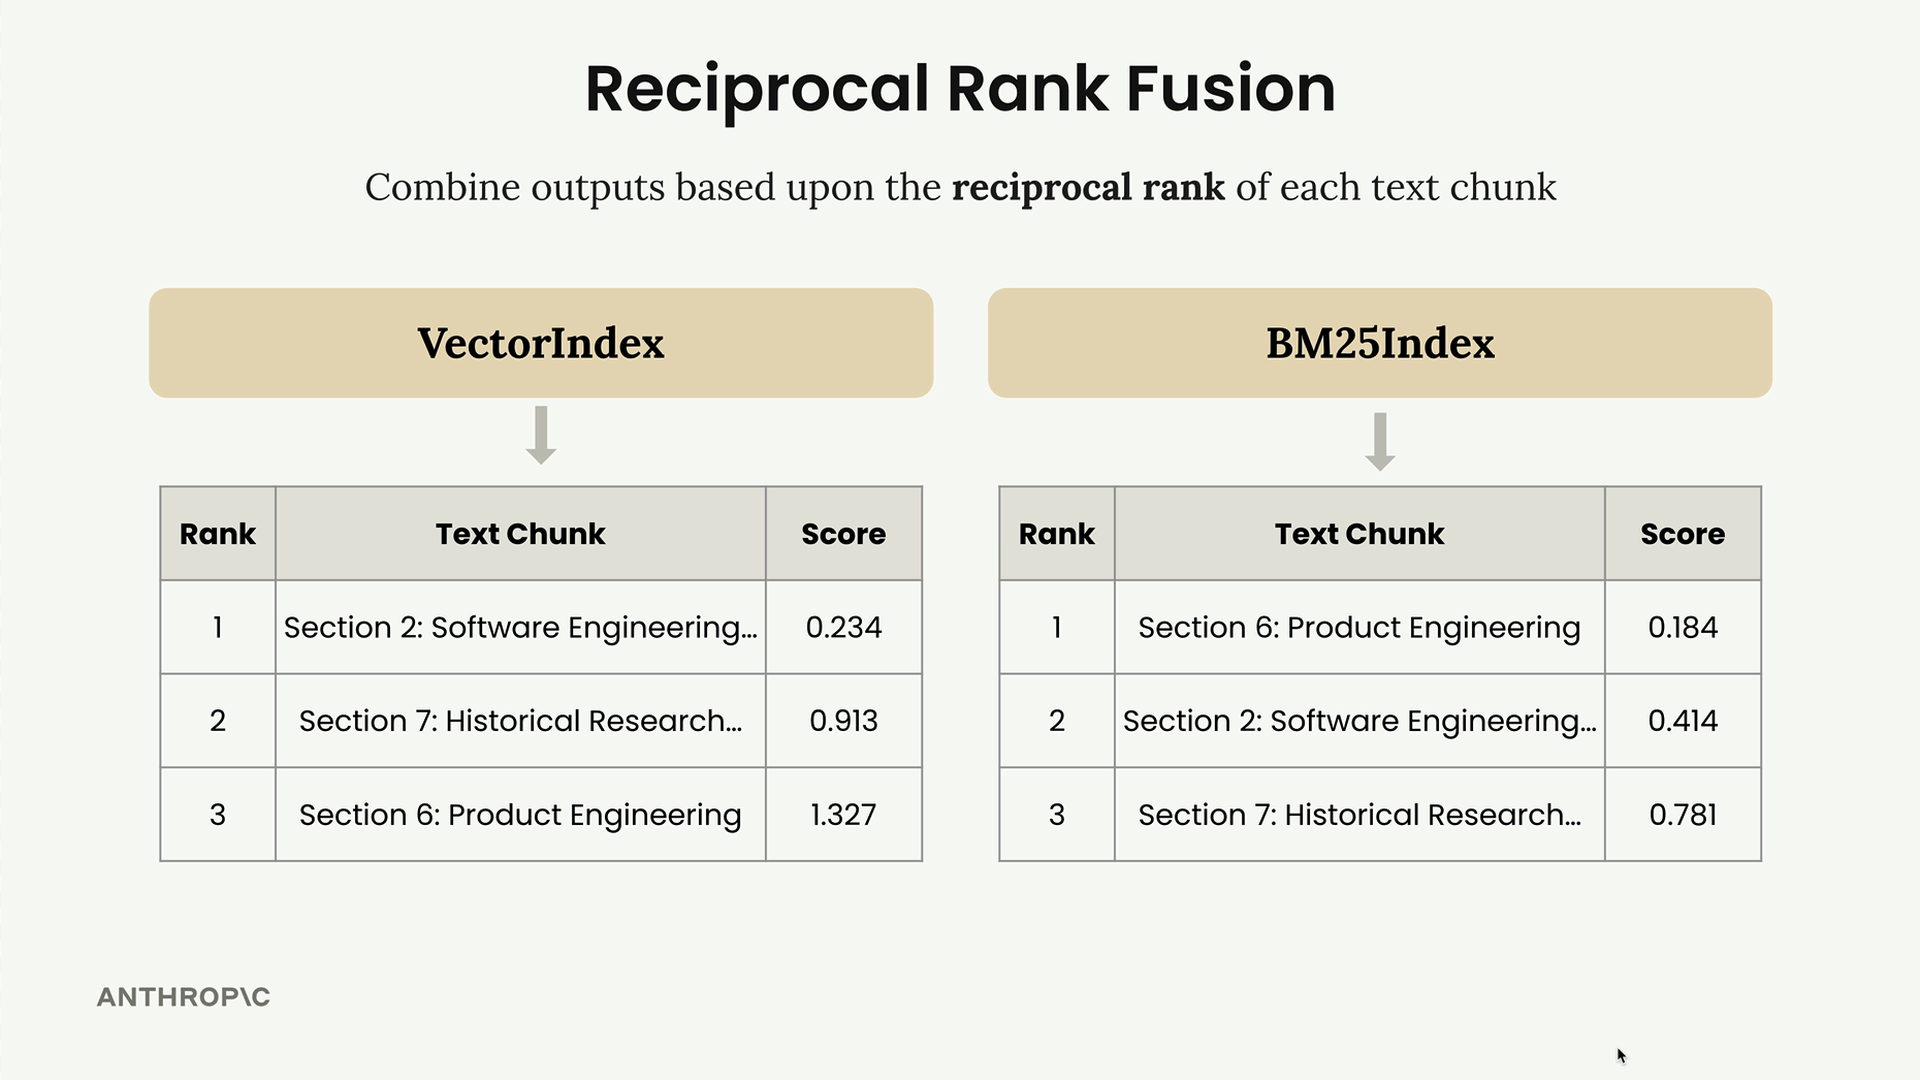
RRFがどのように機能するか、実践的な例で見てみましょう。VectorIndexがSection 2、Section 7、Section 6の順にランク付けした結果を返したとします。一方、BM25IndexはSection 6、Section 2、Section 7を返します。
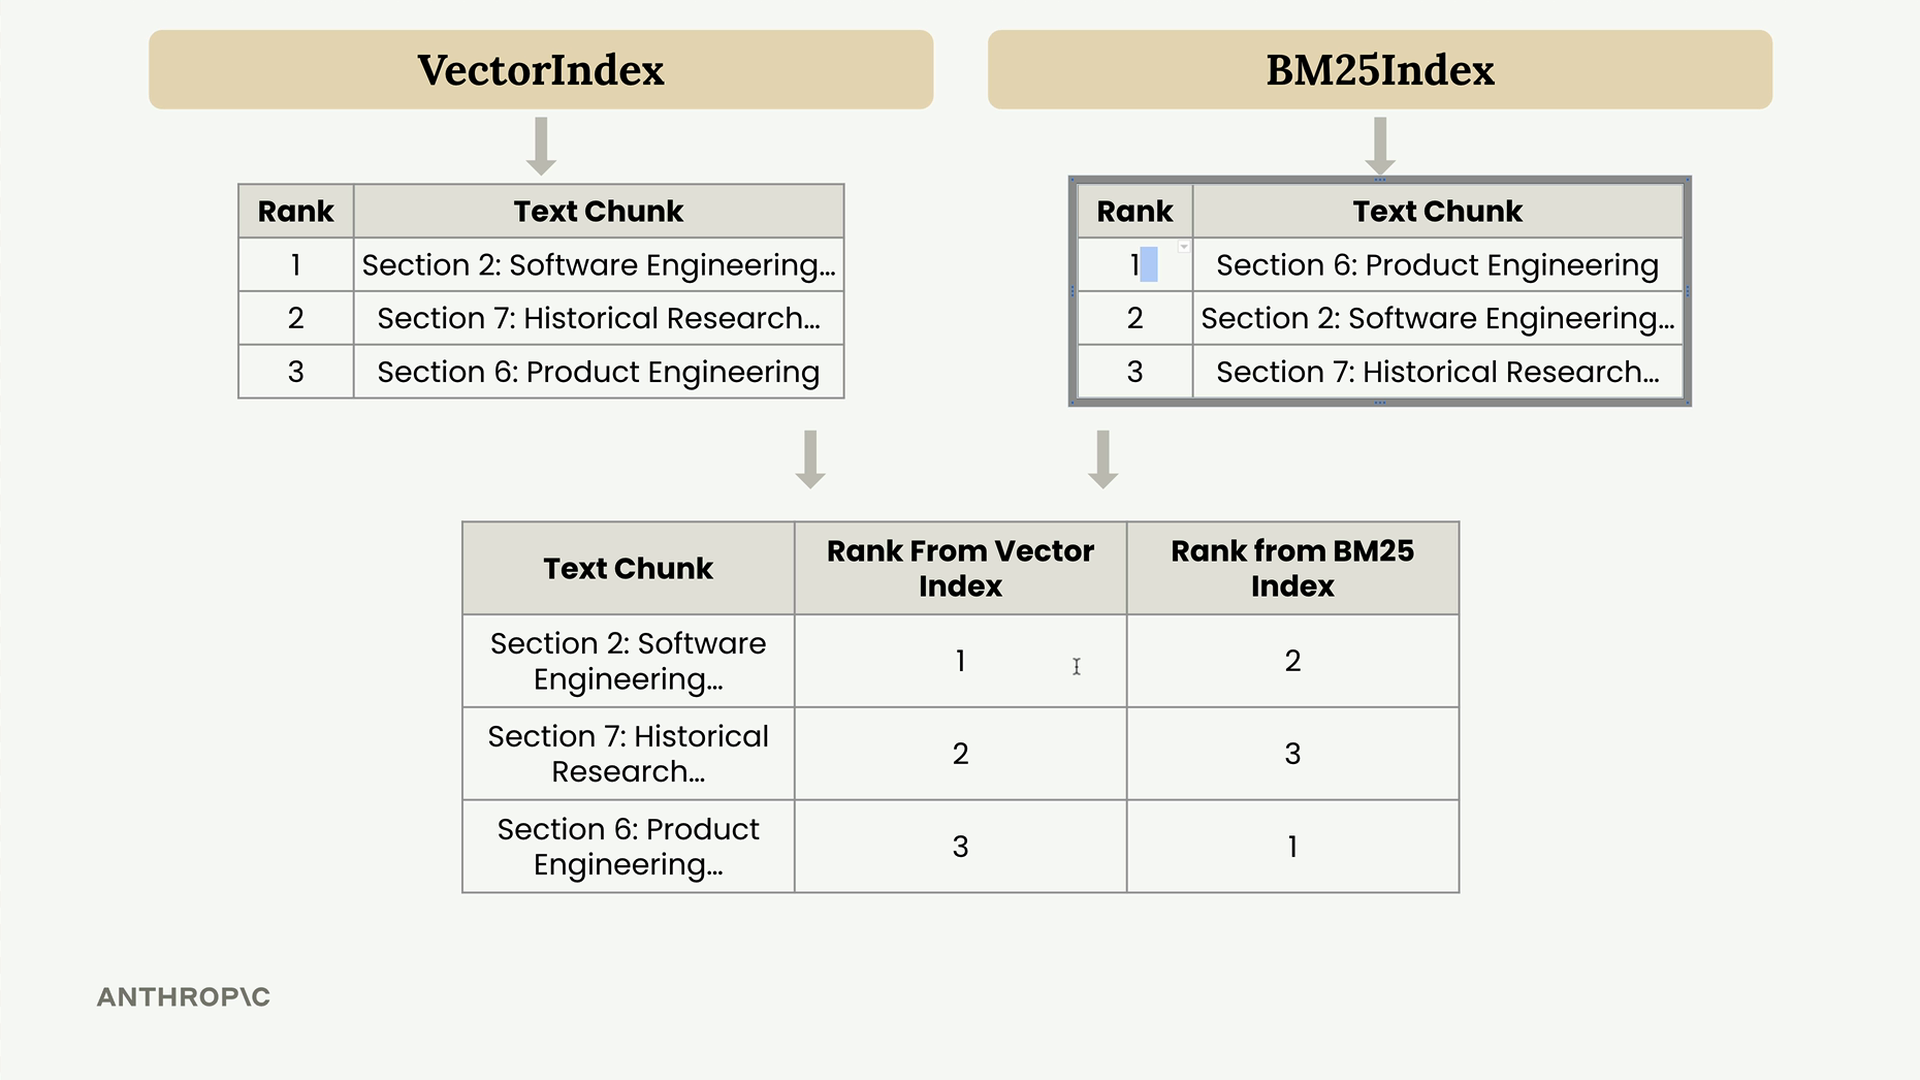
これらの結果をマージするために、各テキストチャンクの両システムにおけるランクを示す結合テーブルを作成します。
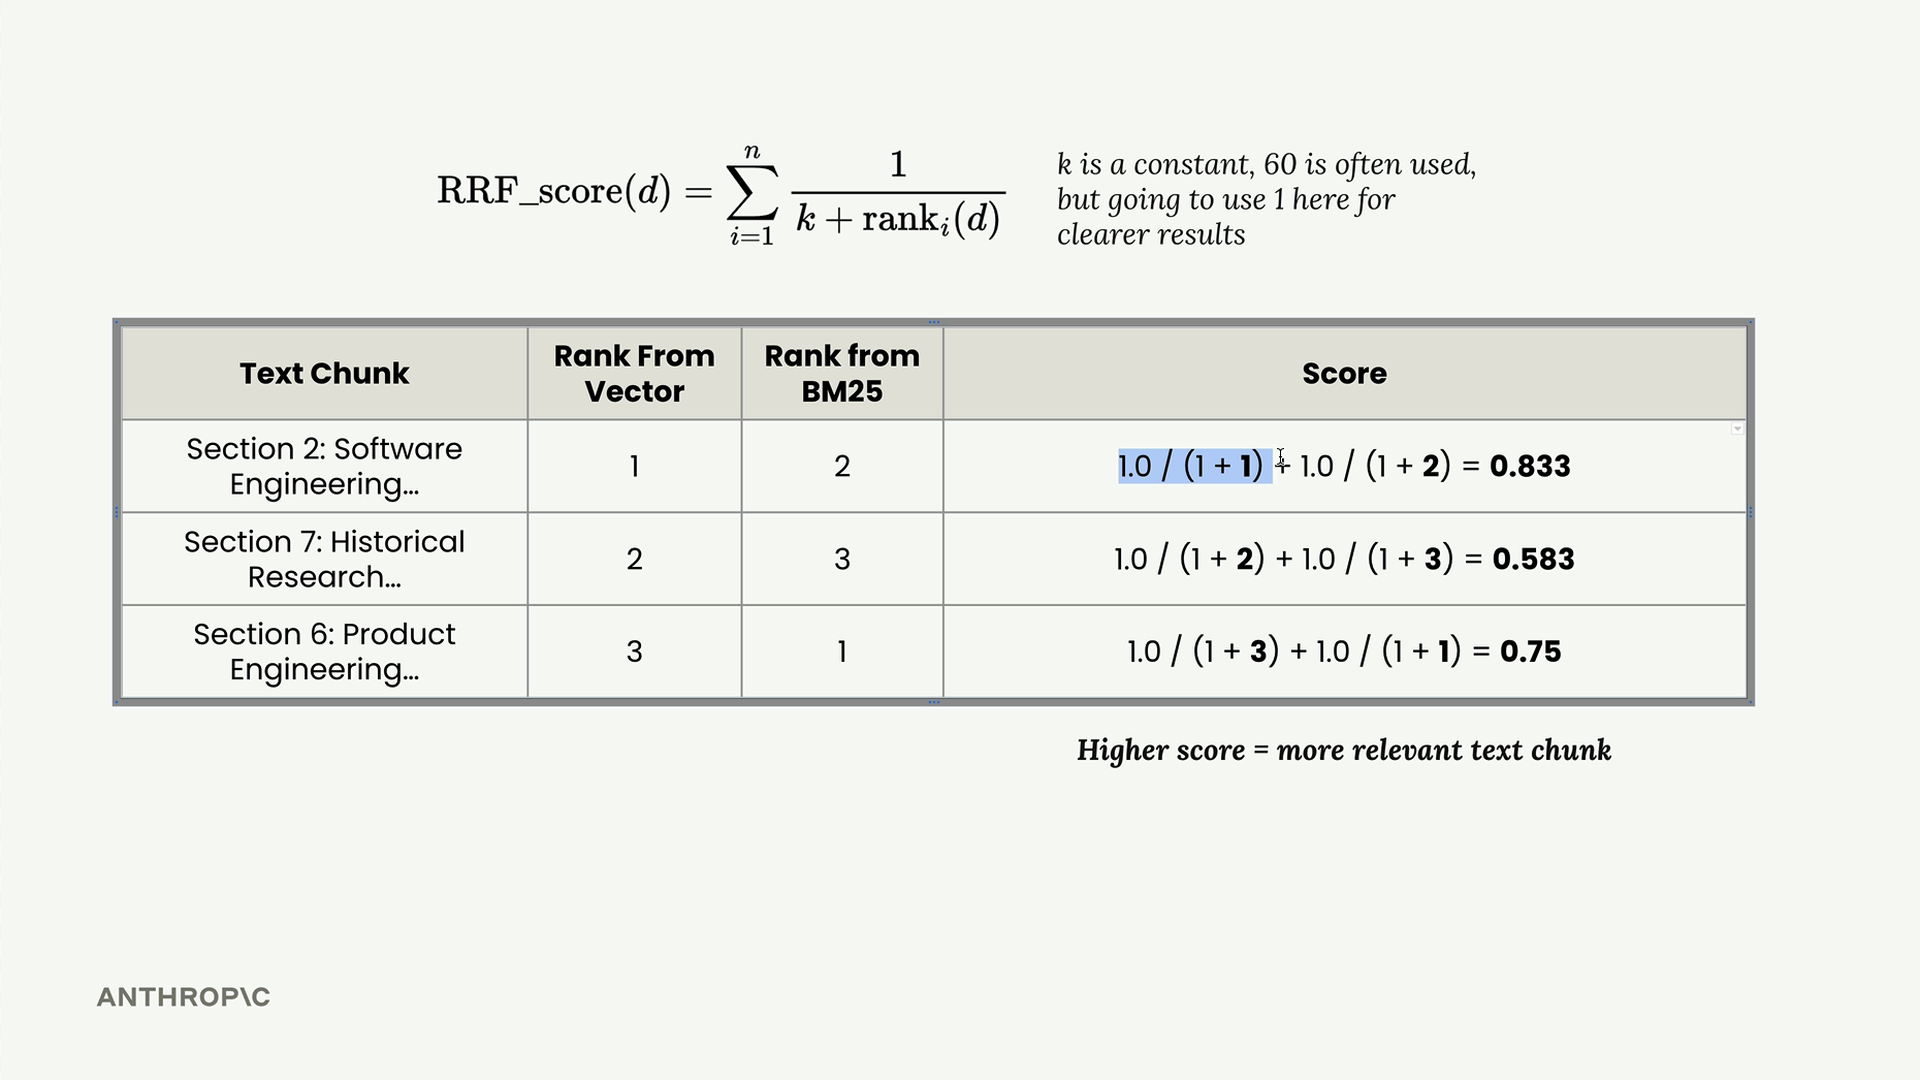
RRFの式は各ドキュメントのスコアを次のように計算します。
RRF_score(d) = Σ(1 / (k + rank_i(d)))ここでkは定数(通常は60ですが、より明確な結果を得るには1でもうまく機能します)であり、rank_i(d)はi番目のランキングシステムにおけるドキュメントdのランクです。
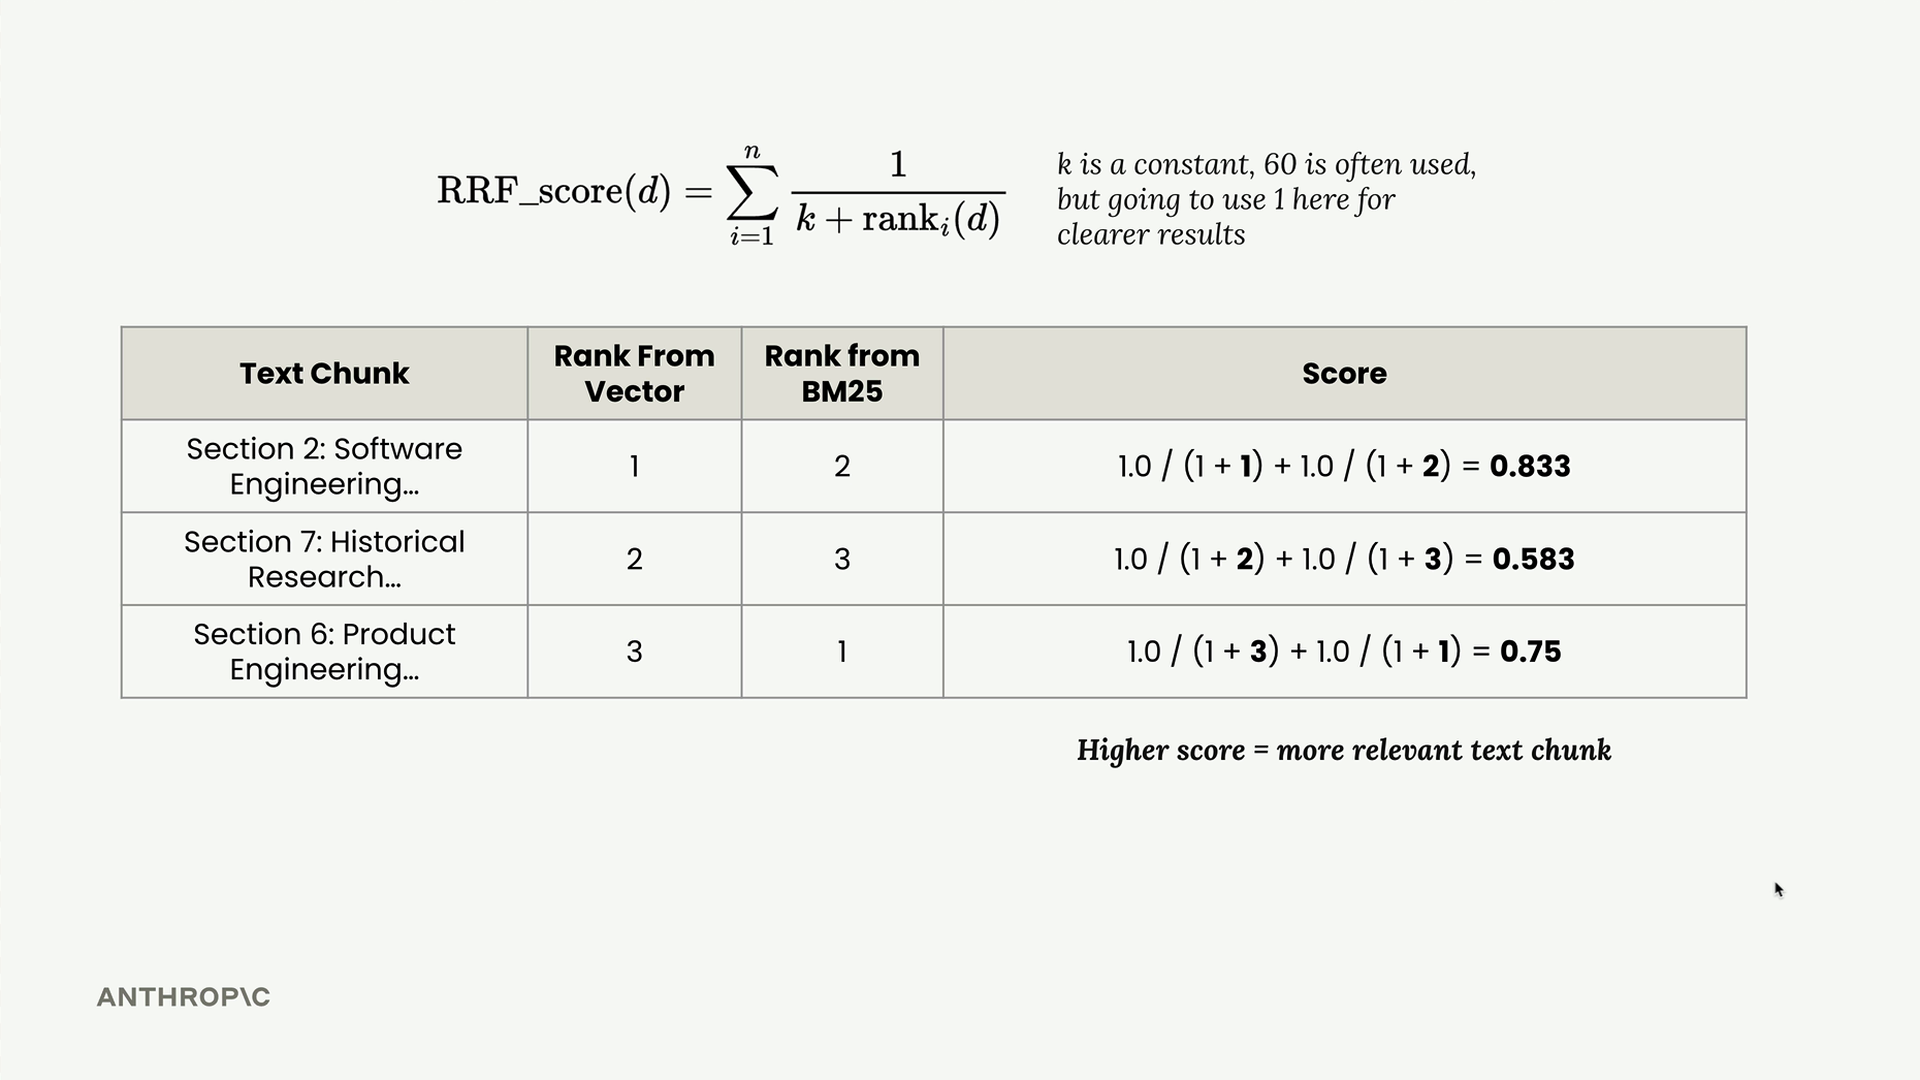
各テキストチャンクについて、次のように計算します。
- Section 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- Section 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- Section 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
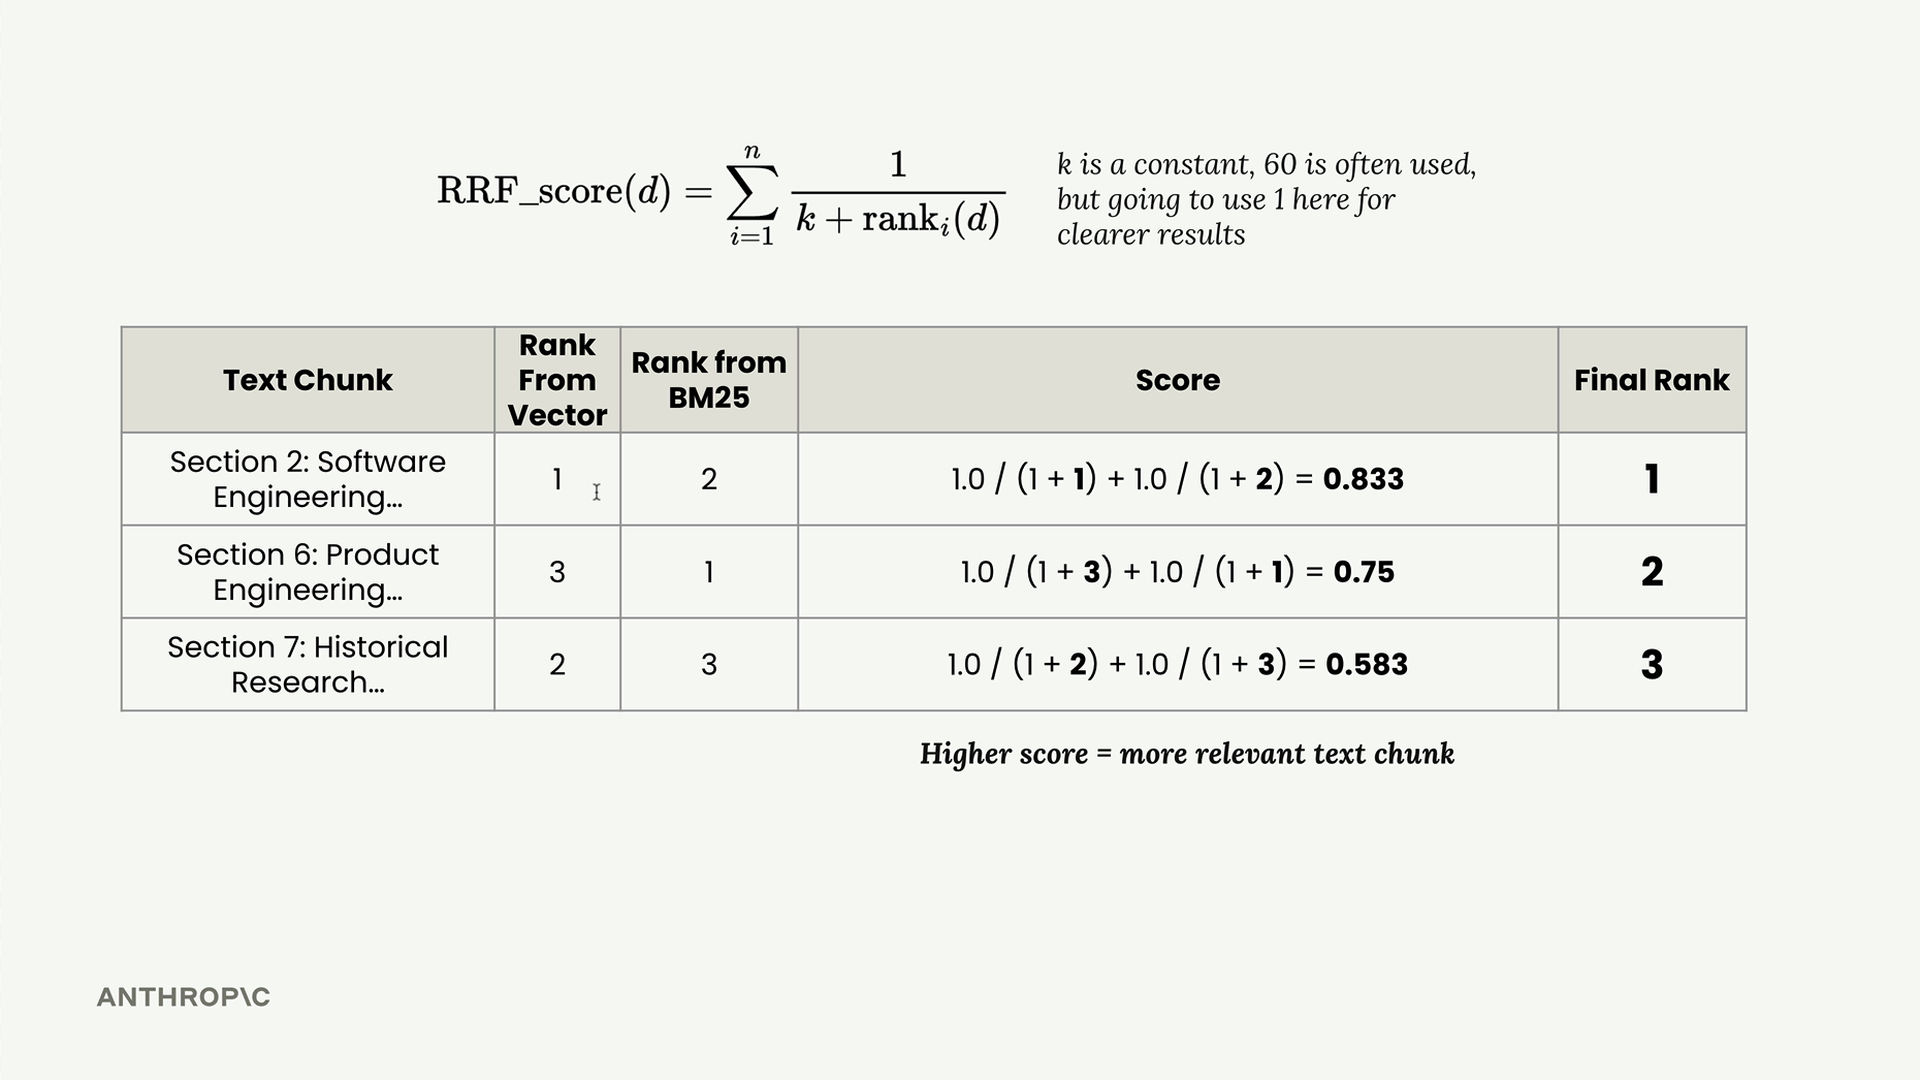
スコアでソートすると、最終的なランキングはSection 2(1位)、Section 6(2位)、Section 7(3位)になります。
実装
Retrieverクラスの実装は単純明快です。
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # すべてのインデックスから結果を取得
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # システム間でドキュメントの順位を追跡
                # RRF式を適用
                # マージしてソート済みの結果を返す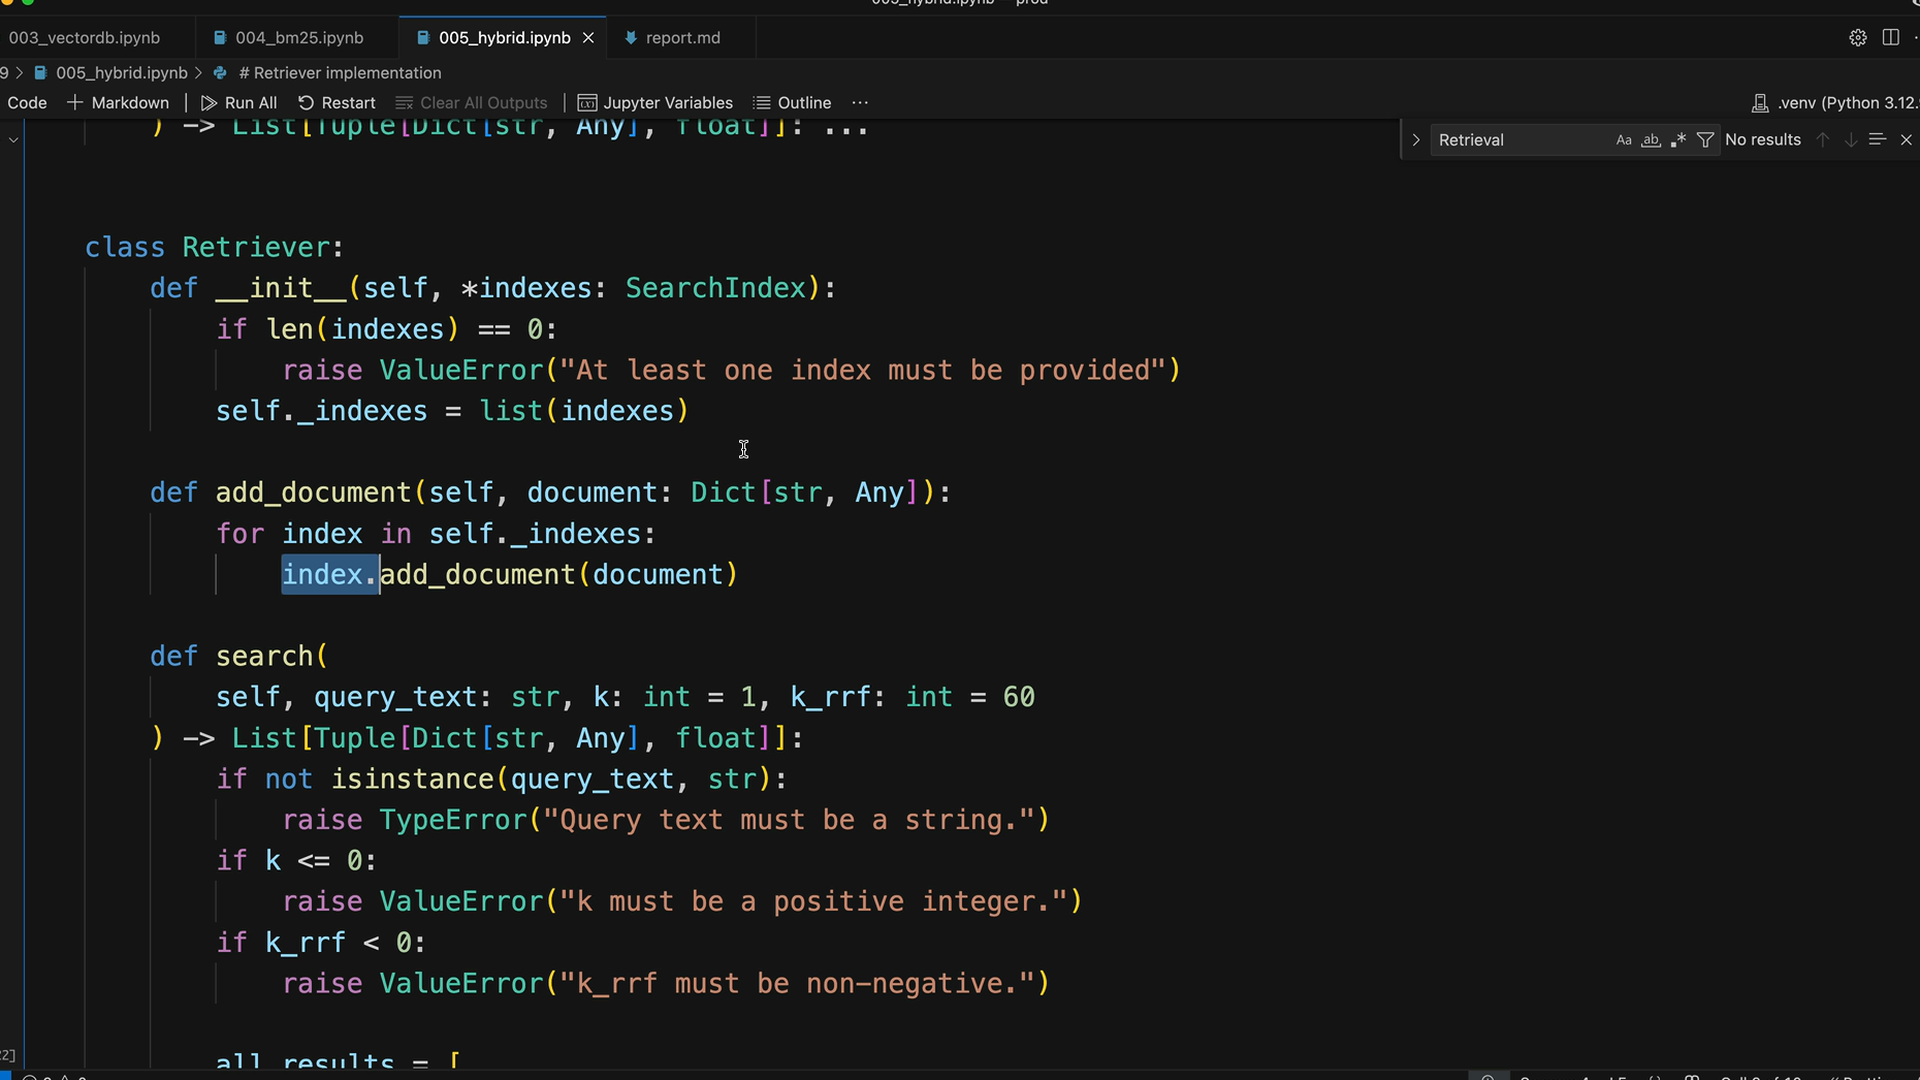
重要な洞察は、RRFアルゴリズムが、単一のスコアリング方法に依存するのではなく、各ドキュメントがすべての検索システムにわたってどれだけうまく機能するかを考慮することで、統一されたランキングを作成するということです。
ハイブリッドアプローチのテスト
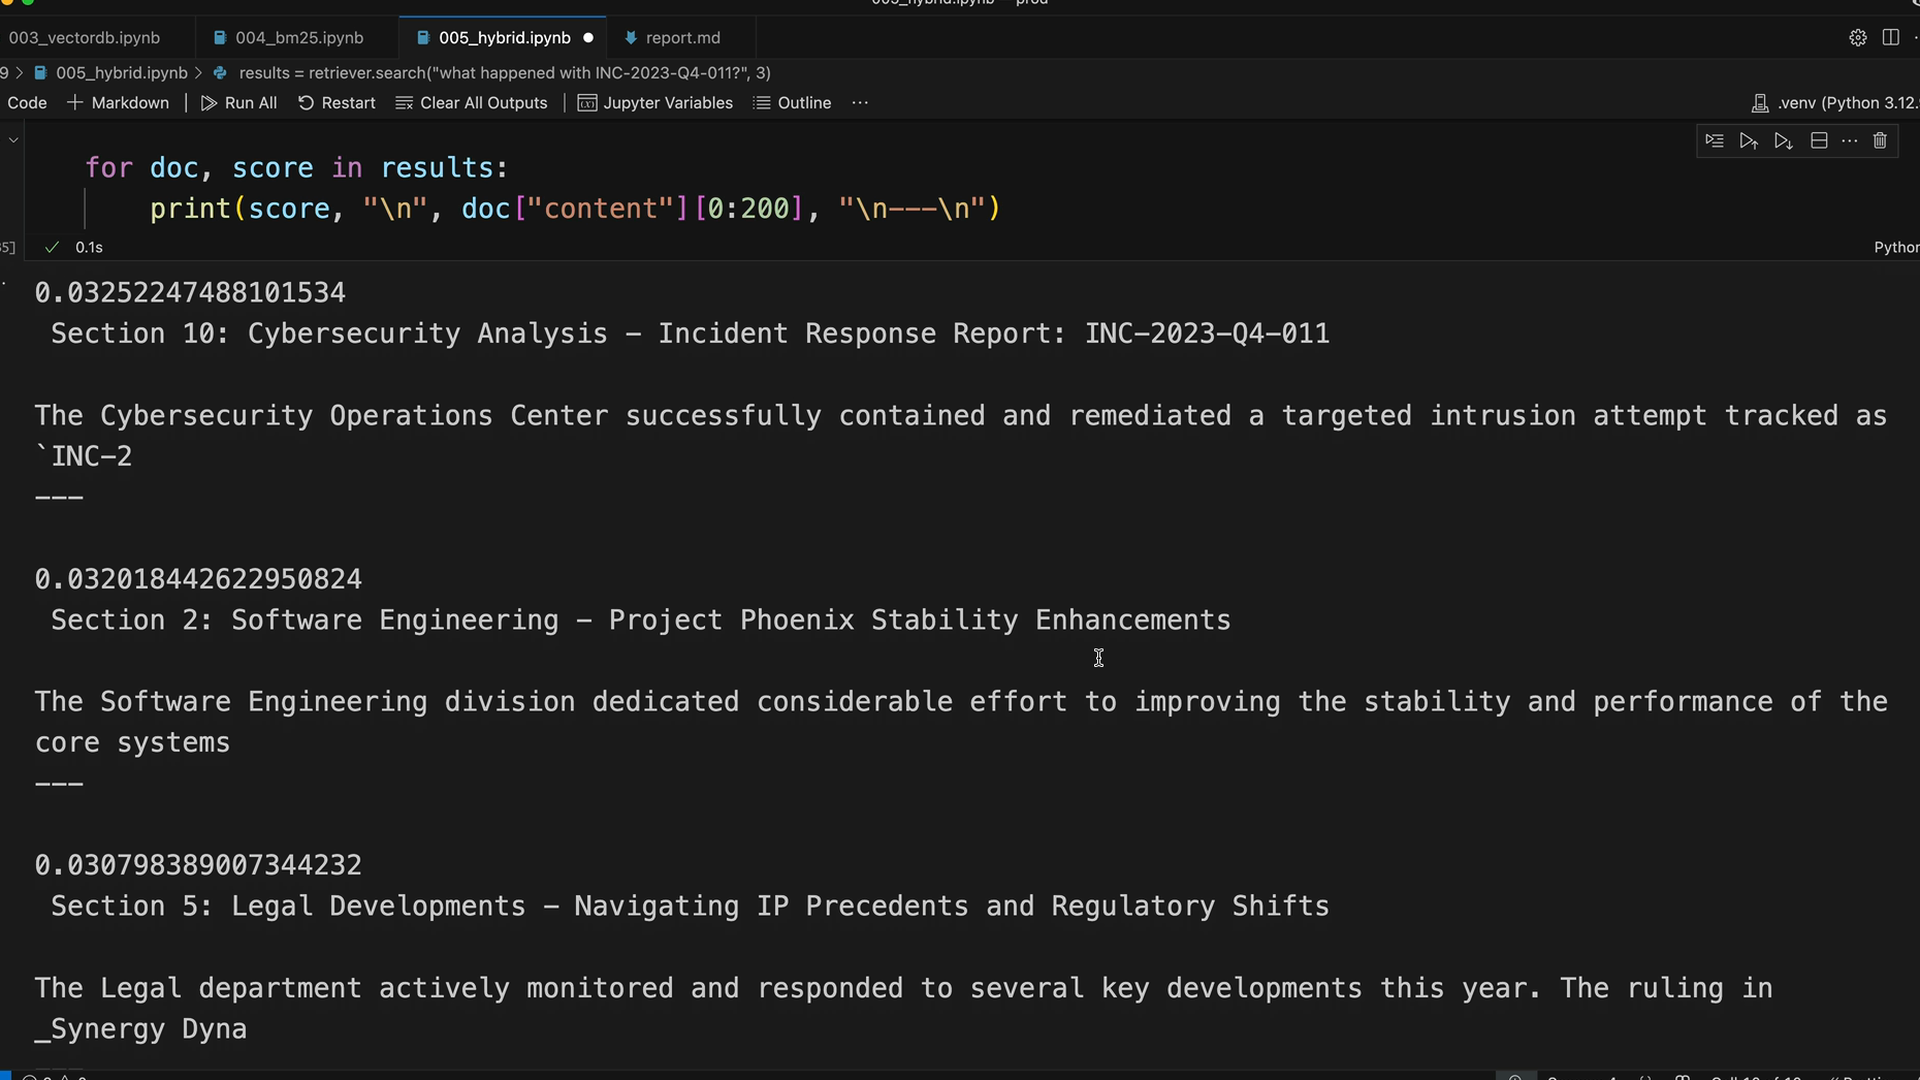
「what happened with INC-2023-Q4-011?」のようなクエリでテストすると、ハイブリッドアプローチはどちらか一方の方法だけよりも大幅に優れた結果をもたらします。純粋なベクトル検索から予期しない結果を得る代わりに、最も関連性の高いサイバーセキュリティインシデントレポートが最初に得られ、その後に関連するソフトウェアエンジニアリングのコンテンツが続きます。
拡張性
この設計の美しさは、そのモジュール性にあります。各検索インデックスが同じインターフェース(add_document()とsearch())を実装しているため、新しい検索手法をシステムに簡単に追加できます。それが異なる埋め込みモデルであれ、専門ドメイン検索であれ、その他の検索技術であれ、確立されたAPIに従っている限り、ハイブリッドパイプラインにシームレスに統合されます。
このハイブリッド検索アプローチは、ベクトル検索のセマンティックな理解とレキシカル検索の正確なキーワードマッチングを組み合わせ、数学的に健全なRRFランキングアルゴリズムによってすべてを統一することで、検索精度における大幅な改善を表しています。