RAGパイプラインを構築していると、セマンティック検索だけでは必ずしも最良の結果が返されるとは限らないことにすぐ気づくでしょう。セマンティック検索が見逃してしまうような、正確なキーワード一致が必要になる場合があります。その解決策は、BM25と呼ばれる手法を使ってセマンティック検索と語彙検索を組み合わせることです。
セマンティック検索だけの問題点
例えば、「INC-2023-Q4-011」のような特定のインシデントIDをドキュメント内で検索しているとします。この正確な用語は関連するセクションに複数回登場しますが、セマンティック検索は意味的に類似しているように見えるだけで、実際には必要な特定の情報を含んでいない無関係なセクションを返してしまうことがあります。
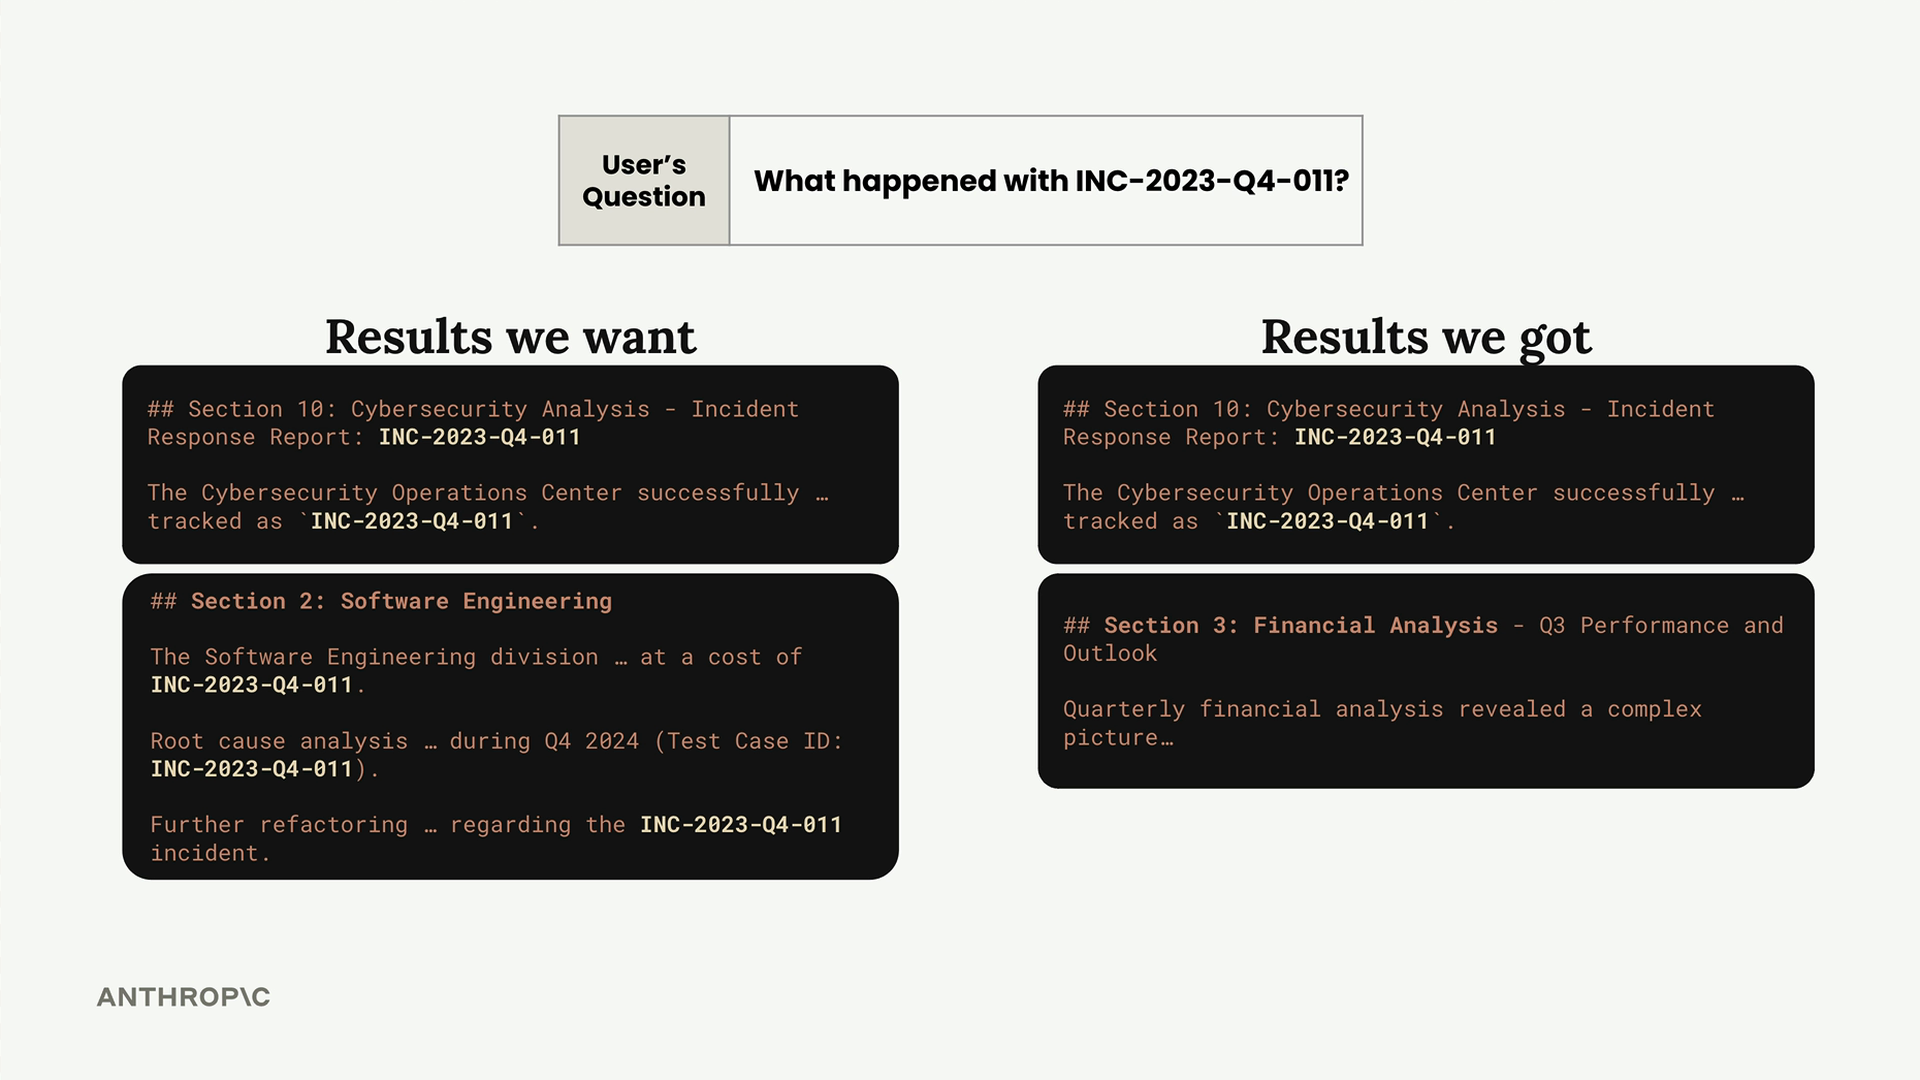
これは、セマンティック検索が正確なテキスト一致ではなく意味に焦点を当てているために起こります。正確なキーワード一致が必要な場合には、別のアプローチが必要です。
ハイブリッド検索戦略
解決策は、セマンティック検索と語彙検索の両方を並行して実行し、その結果をマージすることです。これにより、両方の長所を得ることができます。
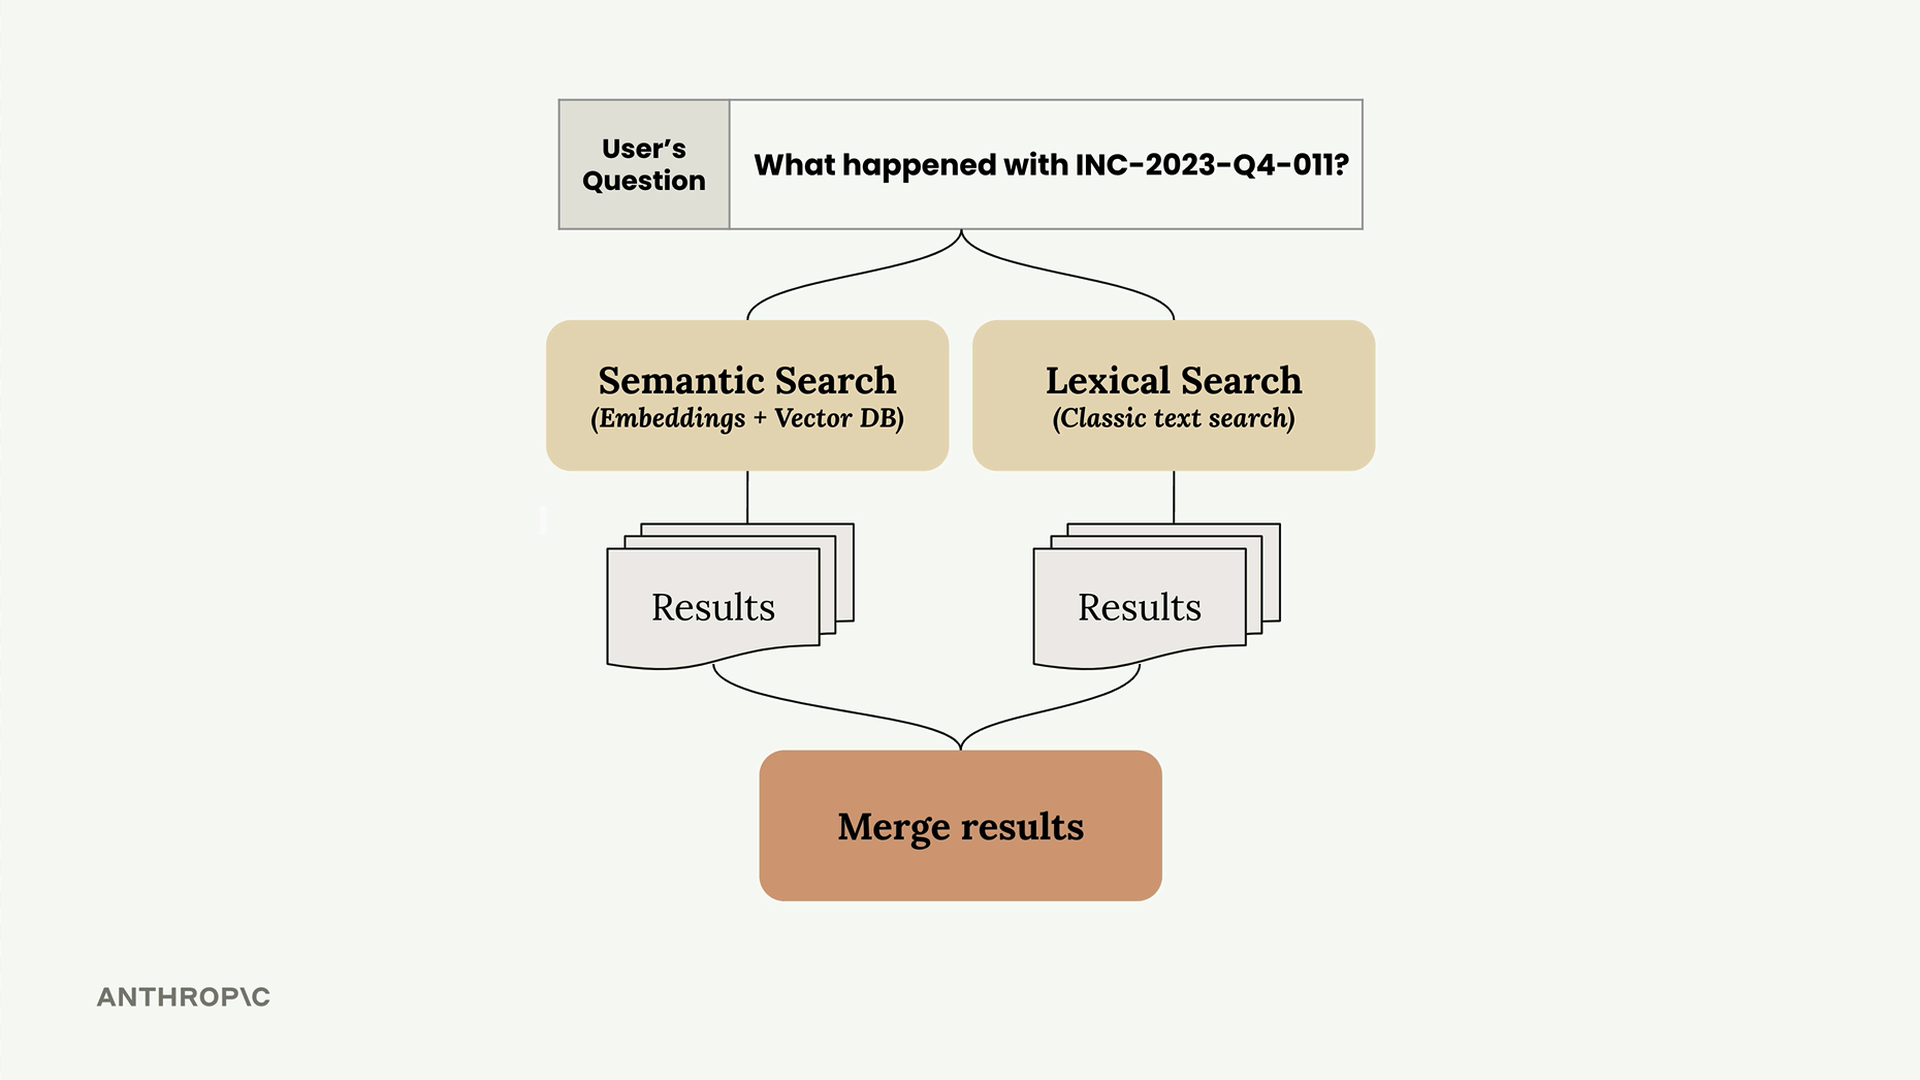
- セマンティック検索 - 埋め込みを使用して概念的に関連するコンテンツを見つける
- 語彙検索 - 従来のテキスト検索を使用して正確なキーワード一致を見つける
- マージされた結果 - 両方のアプローチを組み合わせて、全体的な関連性を向上させる
BM25の仕組み
BM25(Best Match 25)は、RAGパイプラインにおける語彙検索で人気のあるアルゴリズムです。検索クエリを処理する手順は次のとおりです。
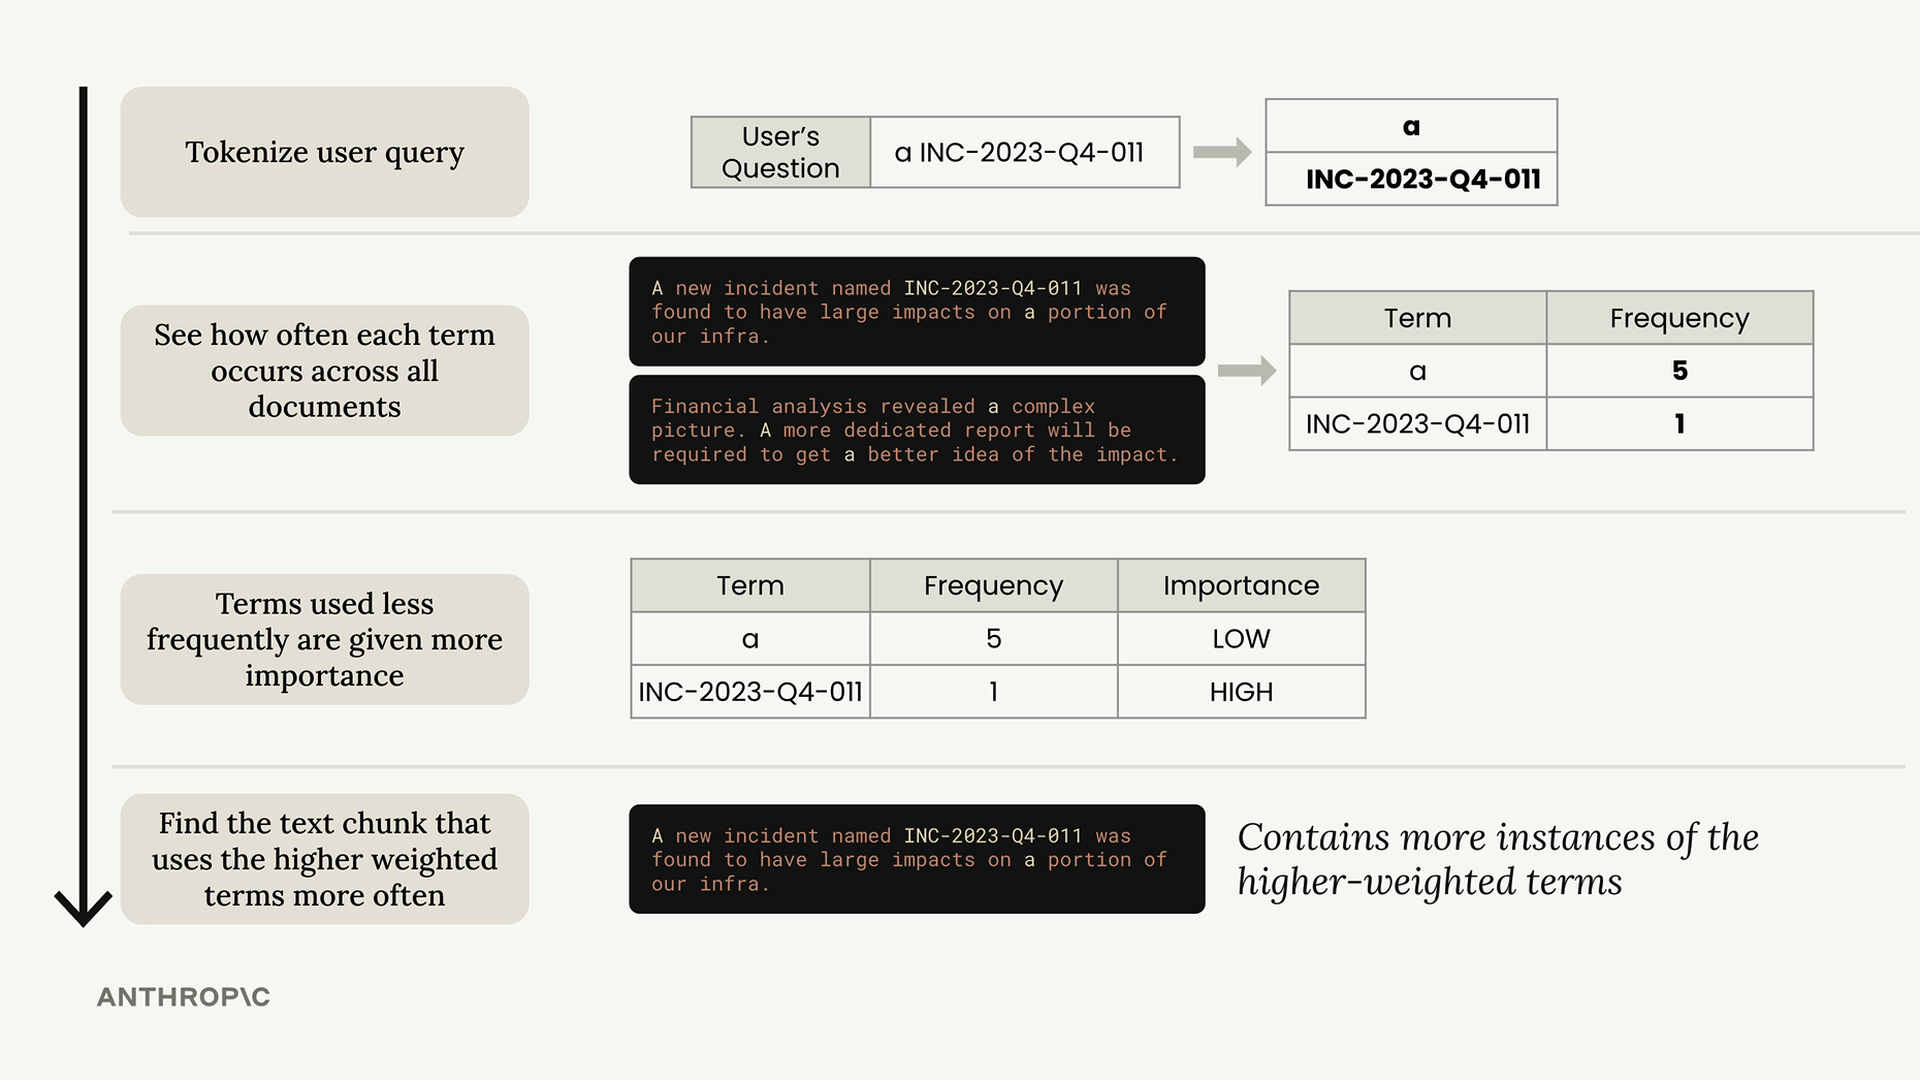
このアルゴリズムは、次の主要なステップに従います。
- クエリをトークン化する - ユーザーの質問を個々の用語に分解する
- 用語の出現頻度を数える - 各用語がすべてのドキュメント全体でどれくらいの頻度で出現するかを調べる
- 希少性によって用語に重み付けする - 使用頻度が低い用語ほど重要度スコアが高くなる
- ドキュメントをスコアリングする - より重み付けの高い用語のインスタンスをより多く含むテキストチャンクを見つける
ここで重要なのは、「INC-2023-Q4-011」のような希少な用語は、「a」や「the」のような一般的な単語よりも検索の関連性においてはるかに重要であるということです。
BM25検索の実装
BM25検索システムのセットアップ方法は次のとおりです。
# BM25ストアを作成する
store = BM25Index()

# ストアにドキュメントを追加する
for chunk in chunks:
    store.add_document({"content": chunk})

# ストアを検索する
results = store.search("What happened with INC-2023-Q4-011?", 3)BM25の実装は、add_document()とsearch()メソッドを備え、ベクトルストアと似たAPIを維持しています。この一貫性により、両方のシステムを一緒に使いやすくなります。
より良い検索結果
セマンティック検索だけでは失敗したのと同じクエリをBM25で実行すると、はるかに良い結果が得られます。このアルゴリズムは、正確なインシデントIDを含むセクションを正しく優先し、意味的には関連しているかもしれないが探している特定の用語を含まないセクションよりも上位にランク付けします。
検索結果は、ファイナンシャルアナリシスのような無関係なコンテンツを返すのではなく、実際にそのインシデントについて論じているソフトウェアエンジニアリングのセクションとサイバーセキュリティのセクションを適切に表面化するようになります。
次のステップ
セマンティック検索と語彙検索の両方のシステムが独立して動作するようになったので、次のステップはその結果をマージすることです。このハイブリッドアプローチにより、埋め込みによる意味的理解とキーワード一致の精度を組み合わせることができ、RAGパイプラインにとってより堅牢な検索体験を実現できます。