これまでに構築したハイブリッド検索アプローチはうまく機能していますが、まだ改善すべき点がいくつか残っています。特定の用語で検索したり略語を使用したりすると、結果が完全に正しい順序で並ばないことがあります。例えば、「エンジニアリングチームはINC-2023-Q4-011についてどのような対応をしましたか?」と尋ねた場合、ソフトウェアエンジニアリングのセクションの方がその特定のクエリに関連性が高いにもかかわらず、サイバーセキュリティのセクションが最初に返されることがあります。
LLMベースの再ランキング
再ランキングは、ベクトルインデックスとBM25インデックスの結果をマージした後に行われる、もう一つの後処理ステップです。コンセプトはシンプルです。検索結果を取得し、ユーザーの質問との関連性に基づいて並べ替えるようClaudeに依頼します。
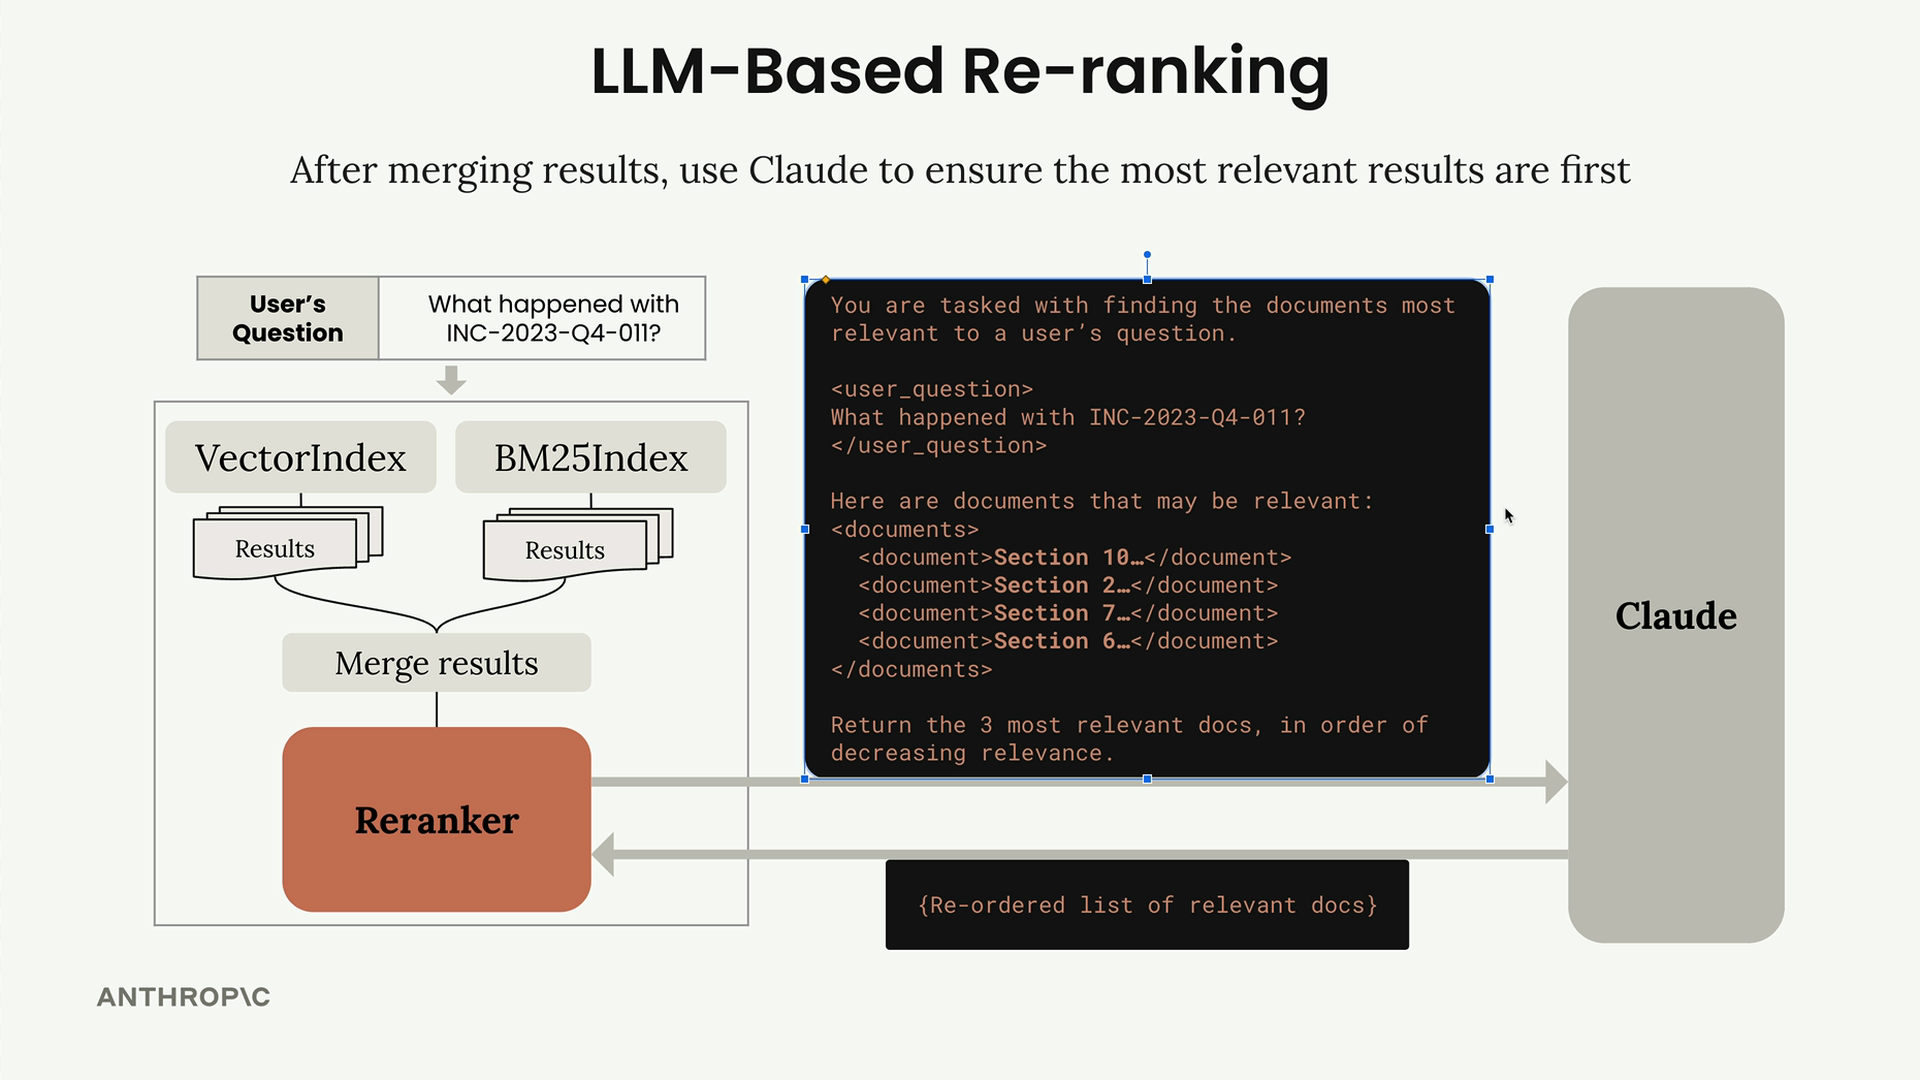
このプロセスの仕組みは次のとおりです。
- いつも通りハイブリッド検索(ベクトル + BM25)を実行する
- 結果を以前と同様にマージする
- マージした結果を再ランカー関数に渡す
- 再ランカーが特定のプロンプトとともにすべてをClaudeに送信する
- Claudeが最も関連性の高いドキュメントの並べ替えられたリストを返す
システムプロンプト
再ランキング用のプロンプトは、明確かつ具体的であるように設計されています。ユーザーの質問と関連性がありそうなすべてのドキュメントをClaudeに提供し、その上でシンプルなタスクを依頼します。それは、関連性が高い順に最も関連性の高いドキュメントを返すというものです。
典型的なプロンプトの構造は次のようになります。
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.効率性に関する考慮事項
Claudeにテキストチャンク全体を返すよう依頼するのは非効率的です。大量のテキストをClaudeがコピーし終えるのを待つことになってしまいます。代わりに、各テキストチャンクにあらかじめ一意のIDを割り当てておきます。そして、ClaudeにはそれらのIDだけを正しい順序で返すよう依頼します。
このアプローチの方がはるかに高速です。なぜなら、Claudeはドキュメントのセクション全体をコピーする代わりに、["1p5g", "51n3", "ab83"] のようなシンプルなリストを返すだけで済むからです。
実装
再ランカー関数は、最初のハイブリッド検索の後にリトリーバーによって自動的に呼び出されます。基本的な構造は次のとおりです。
def reranker_fn(docs, query_text, k):
    # IDを付与してドキュメントを整形
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # ユーザーの質問とドキュメントを含むプロンプトを作成
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # Claudeの応答を取得し、ドキュメントIDを解析
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
結果
「エンジニアリングチームはINC-2023-Q4-011についてどのような対応をしましたか?」といったクエリで再ランカーをテストすると、より関連性の高い結果が上位に表示されるはずです。Claudeは文脈を理解しており、エンジニアリングチームに関するクエリに対しては、単にそのインシデントに言及しているだけの他のセクションよりもソフトウェアエンジニアリングのセクションを優先すべきだと識別できます。
トレードオフは明確です。再ランキングはClaudeの応答を待つ必要があるためレイテンシが増加しますが、Claudeの文脈理解と関連性の把握を活用することで検索精度を大幅に向上させます。