評価用データセットが準備できたので、次はコアとなる評価パイプラインを構築します。これには、各テストケースを取得し、プロンプトと結合し、Claudeに送信して、結果を採点するという一連の作業が含まれます。
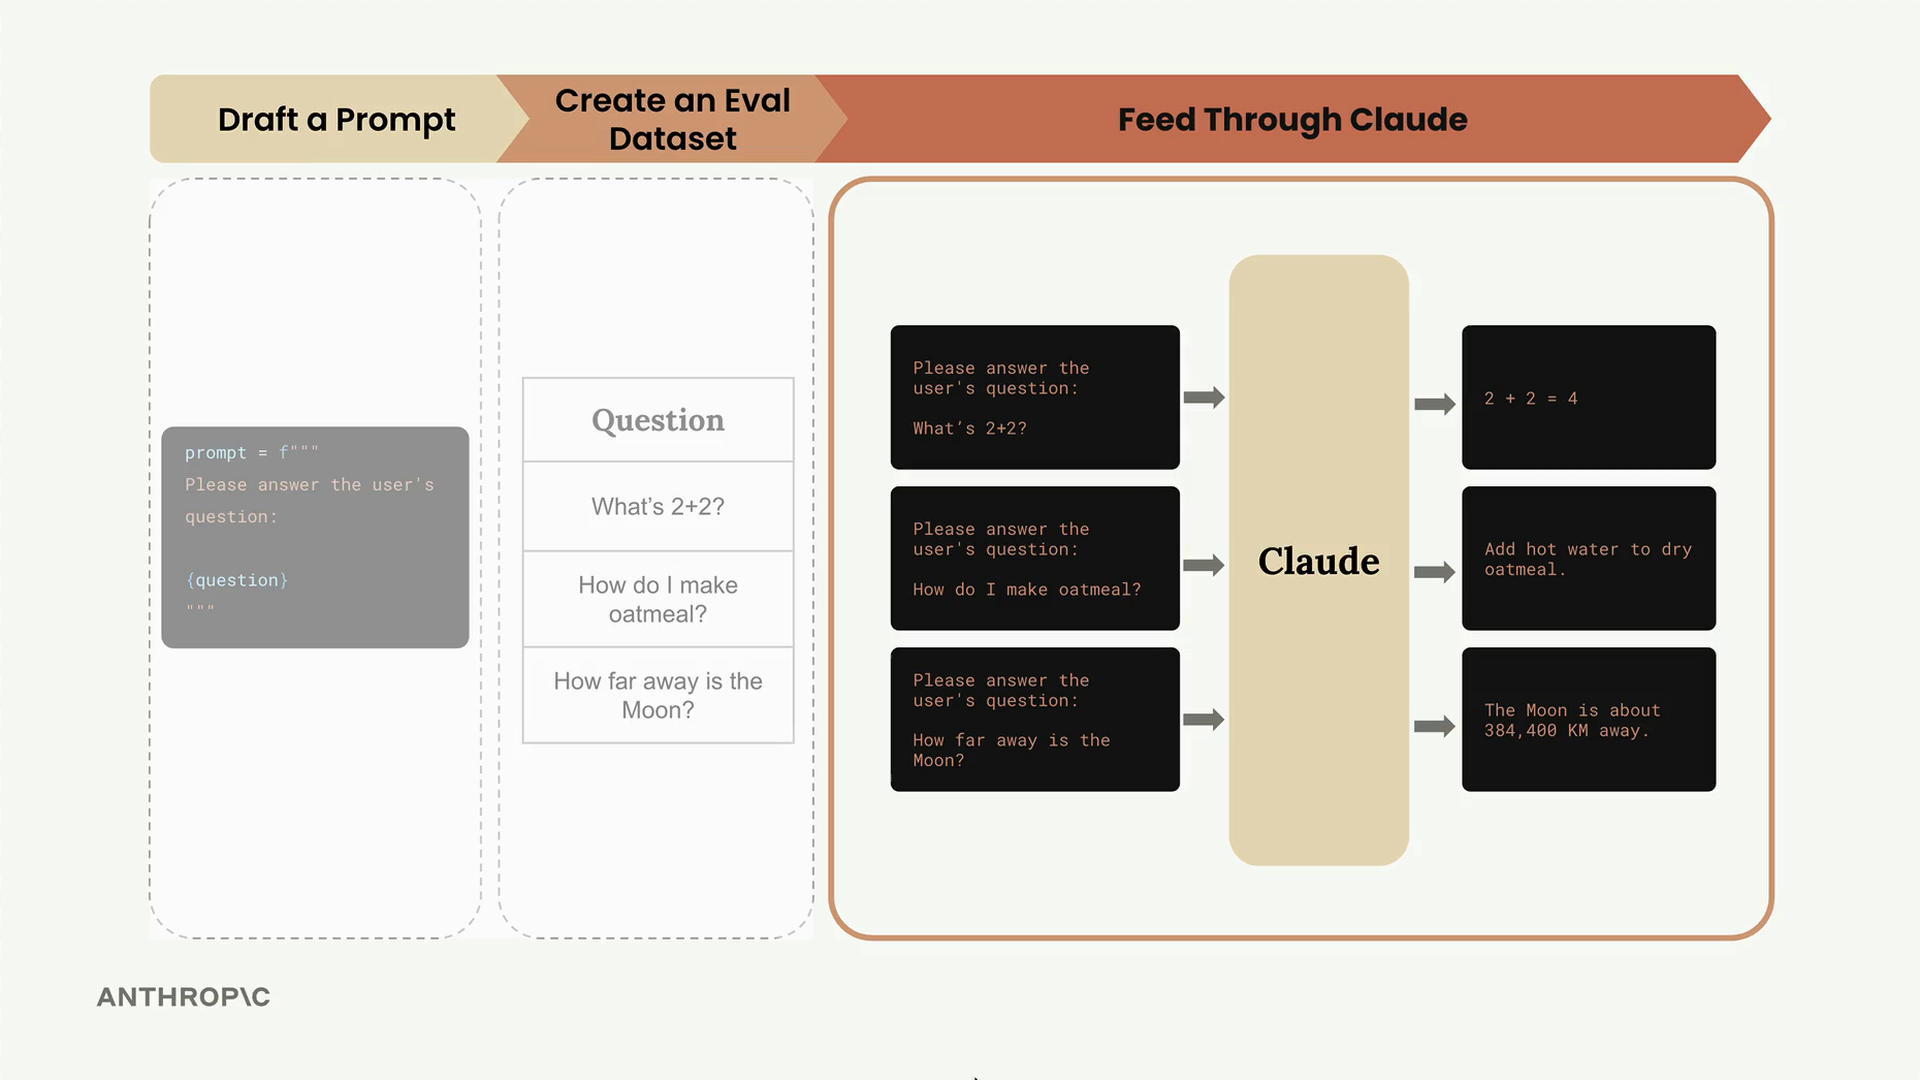
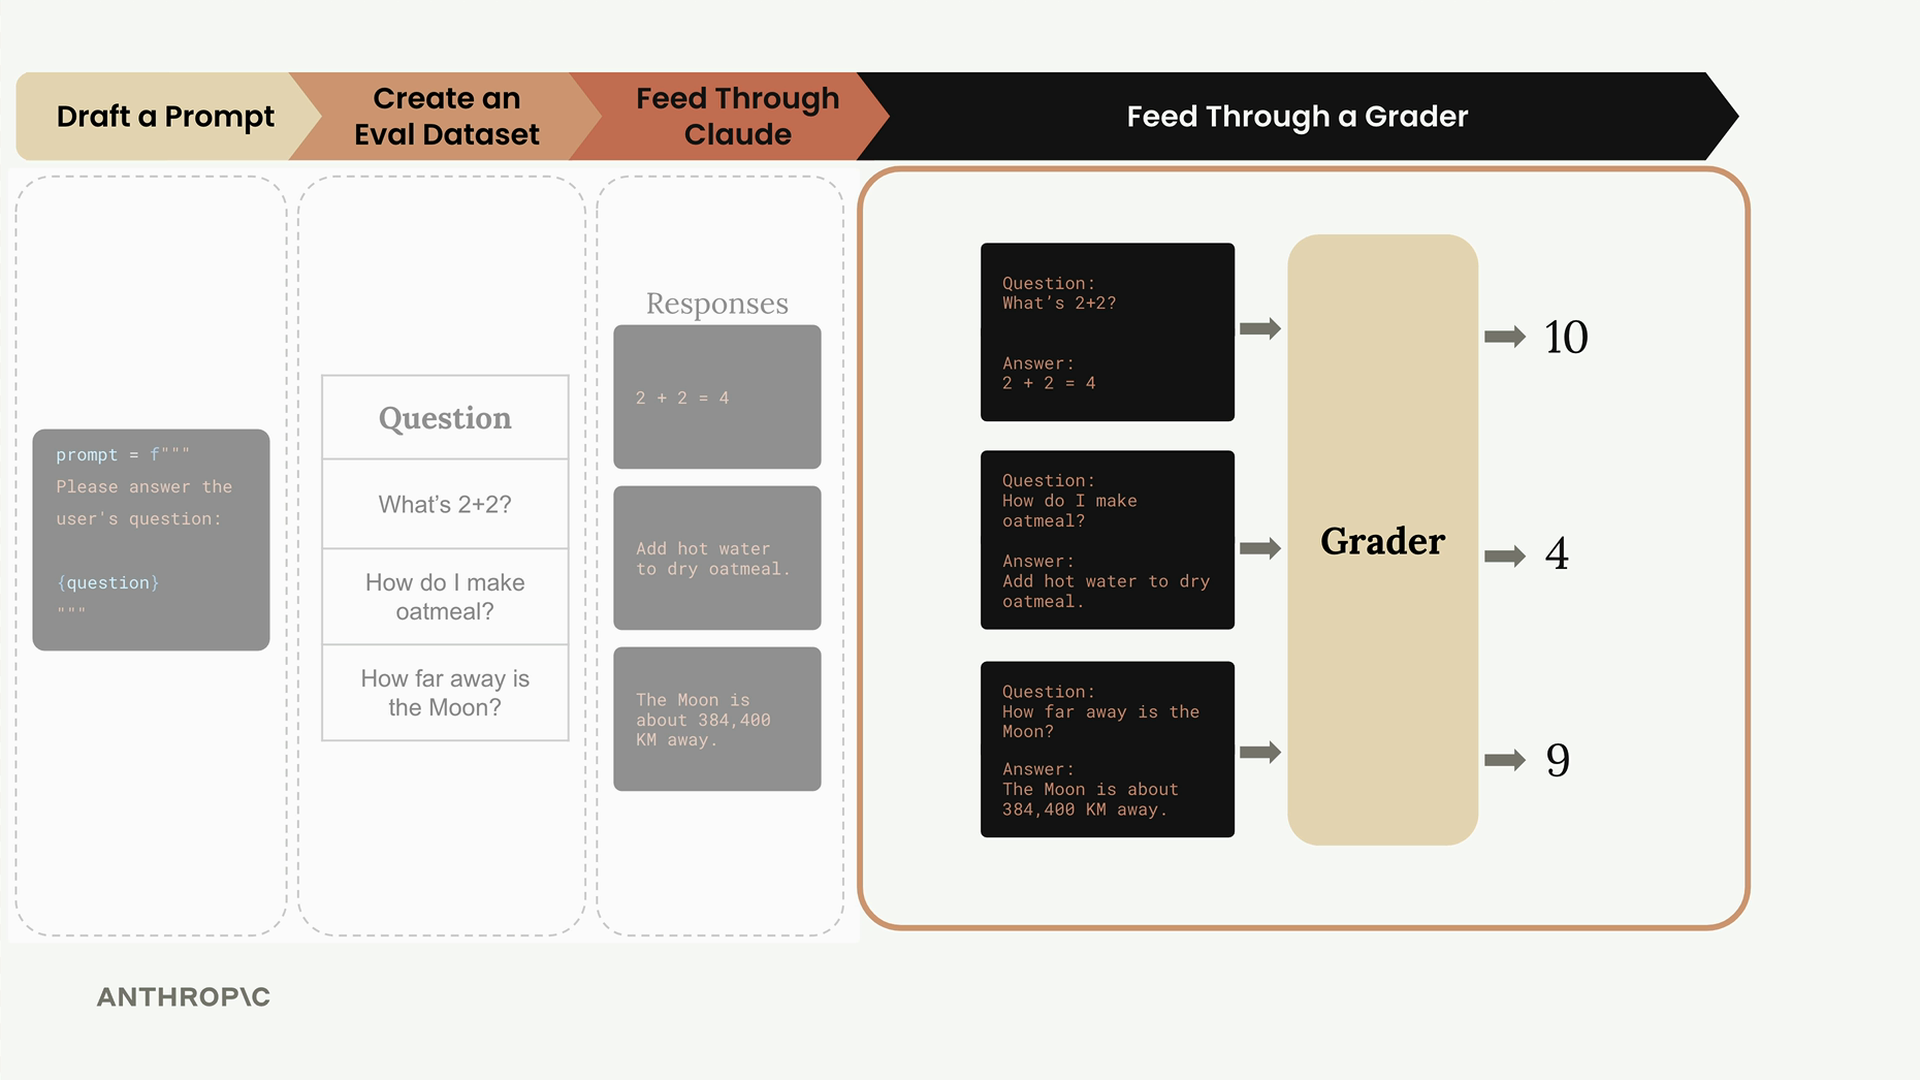
評価プロセスは明確なワークフローに従います。テストケースのデータセットを取得し、それぞれをプロンプトテンプレートと組み合わせ、Claudeに送信して処理し、グレーダーシステムを使って出力を評価します。
コア関数の構築
評価パイプラインは、それぞれ特定の役割を持つ3つの主要な関数で構成されています。まずは最もシンプルな関数、すなわち個々のプロンプト実行を処理する関数から始めましょう。
run_prompt 関数
この関数はテストケースを受け取り、それをプロンプトテンプレートと結合します。
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
現時点では、プロンプトを極めてシンプルに保っています。フォーマットに関する指示は一切含めていないため、Claudeは必要以上に冗長な出力を返す可能性が高くなります。評価プロセスを繰り返し改善していく中で、この点は後ほど修正していきます。
run_test_case 関数
この関数は、1つのテストケースの実行と結果の採点をまとめて制御します。
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - 採点
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
現時点では、ハードコードされたスコア10を使用しています。採点ロジックについては、今後のセクションでかなりの時間をかけて扱いますが、このプレースホルダーによって、パイプライン全体の構造をテストすることができます。
run_eval 関数
これは、データセット全体を処理するメインのオーケストレーターです。
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
この関数は、データセット内のすべてのテストケースをループ処理し、それぞれを処理して、すべての結果を1つのリストにまとめます。
評価の実行
評価パイプラインを実行するには、データセットを読み込み、メイン関数を呼び出します。
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
初回実行時は、ある程度時間がかかると想定してください。Claude Haikuを使用していても、データセット全体の処理には30秒以上かかることがあります。最適化の手法については後ほど取り上げますが、今のところは辛抱強く待つことが大切です。
結果の確認
評価が完了したら、フォーマットされたJSON出力で結果を確認できます。
print(json.dumps(results, indent=2))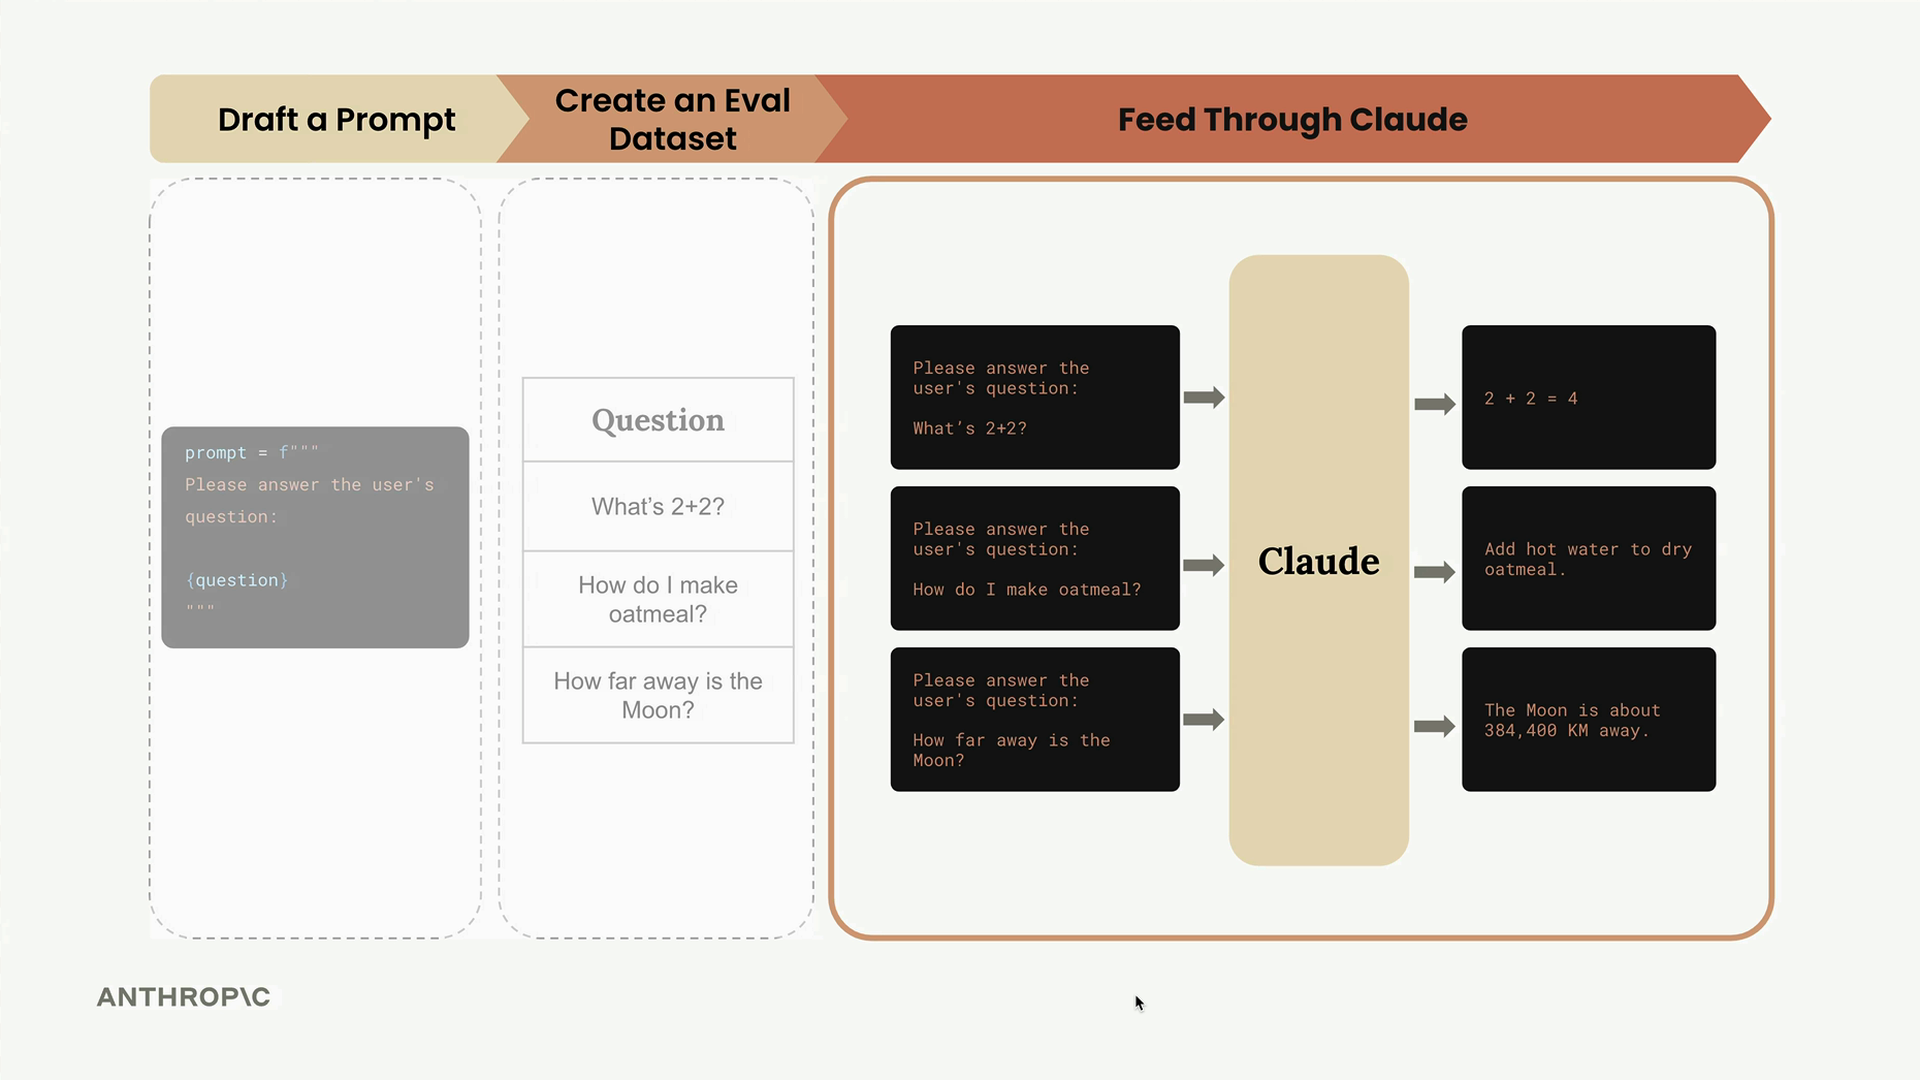
結果の構造には、オブジェクトの配列が含まれており、各オブジェクトは1つのテストケースの実行結果を表しています。そこには、Claudeの出力(フォーマットの制約がないため、かなり冗長になりがちです)、元のテストケース定義、そしてスコアが確認できます。
これまでに達成したこと
ここまでで、コアとなる評価パイプラインの実装に成功しました。できるようになったことは以下の通りです。
- データセットからテストケースを取得する
- それらをプロンプトテンプレートと結合する
- Claudeから応答を取得する
- すべての結果を収集して整理する
足りていないのは、賢い採点の仕組みです。現時点では、すべての応答に固定のスコアを割り当てているだけです。次のステップは、Claudeの出力が実際に正しいかどうかを評価できるグレーダーを構築することであり、そこにこそ評価システムの真の高度さが発揮されます。
このパイプライン構造はシンプルに見えるかもしれませんが、これはほとんどのAI評価システムが基盤としている構造そのものです。複雑さが生じるのは採点ロジックとプロンプトの最適化の部分であり、テスト実行の基本的なオーケストレーション自体にはありません。