拡張思考は、最終的な応答を生成する前に、モデルが複雑な問題を推論する時間を与えるClaudeの高度な機能です。Claudeの内面の独白のようなものだと考えてください。あなたの問題にステップバイステップでどのように取り組んでいるかを見ることができます。
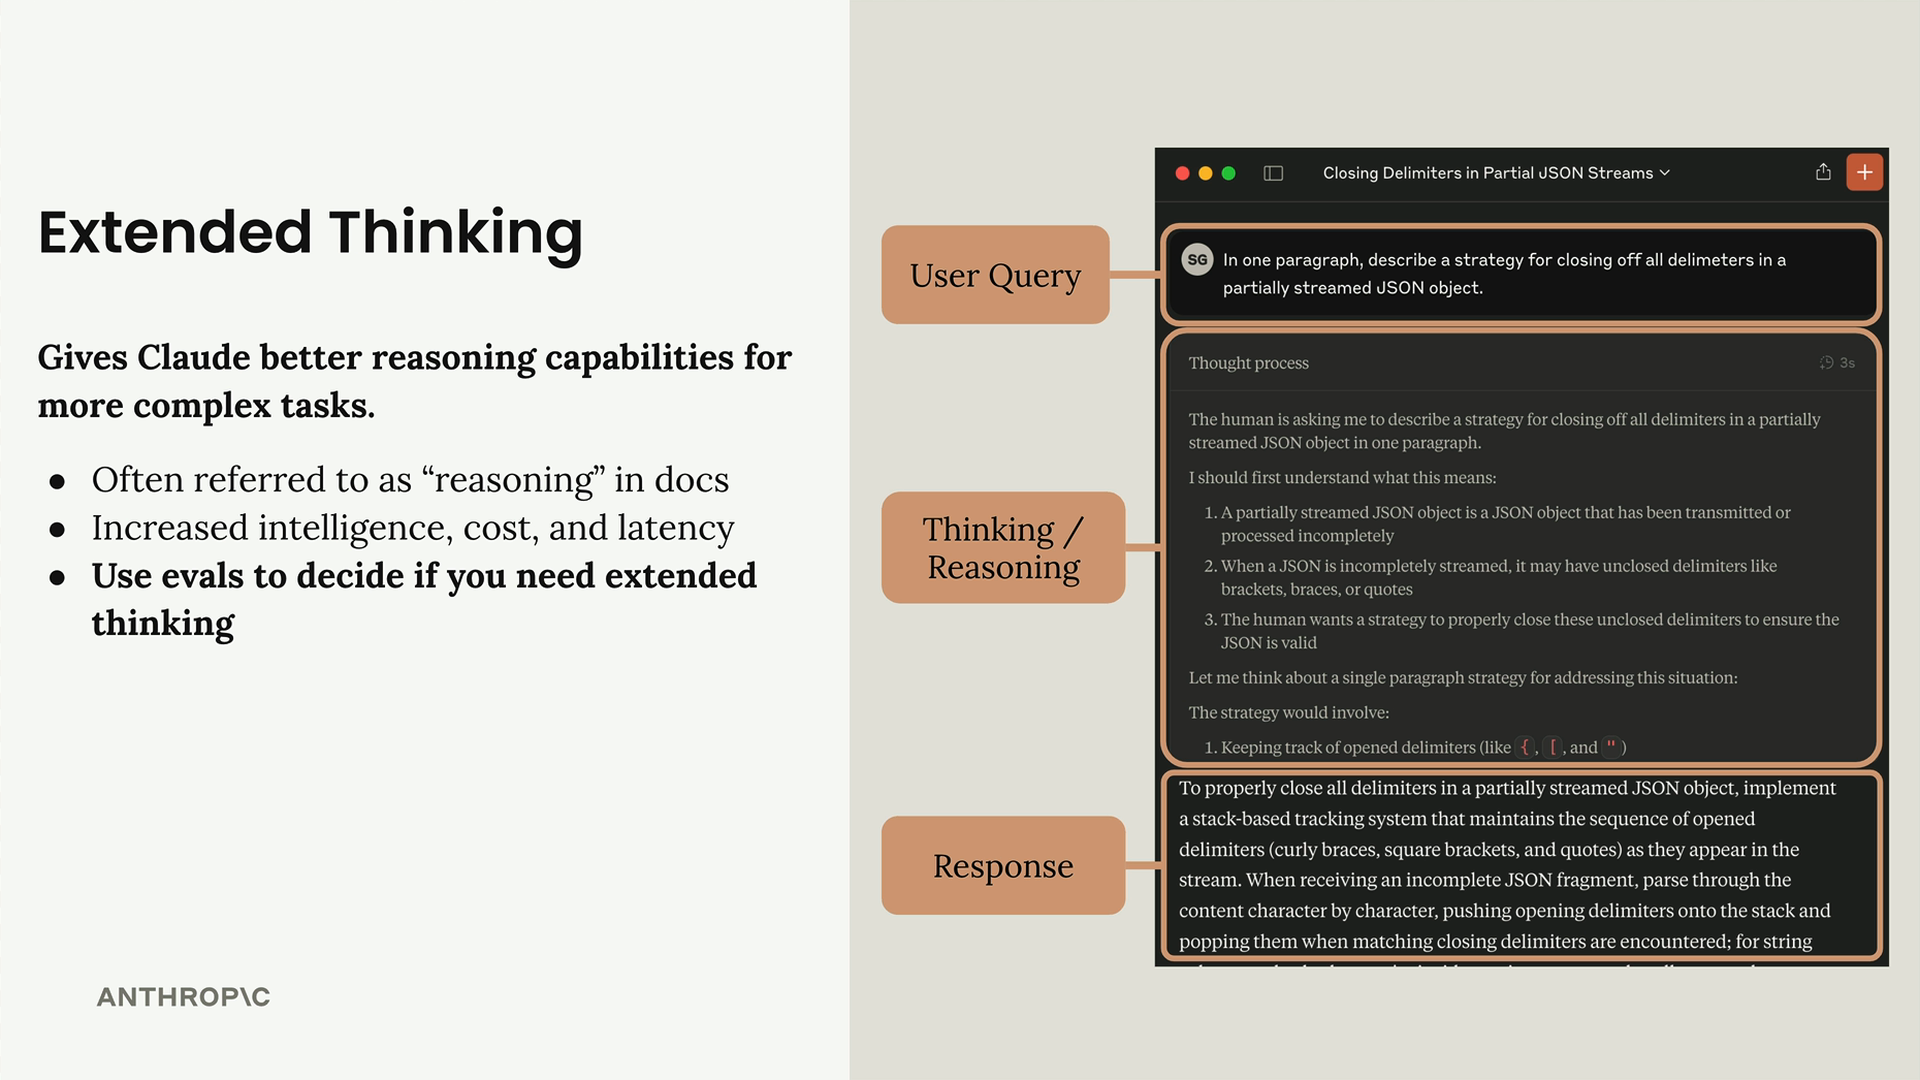
拡張思考の仕組み
拡張思考を有効にすると、Claudeの応答は1つではなく2つの部分で構成されるようになります。
- 推論コンテンツ部分 - Claudeの内部的な思考プロセス
- テキスト部分 - 実際に求めていた最終的な応答
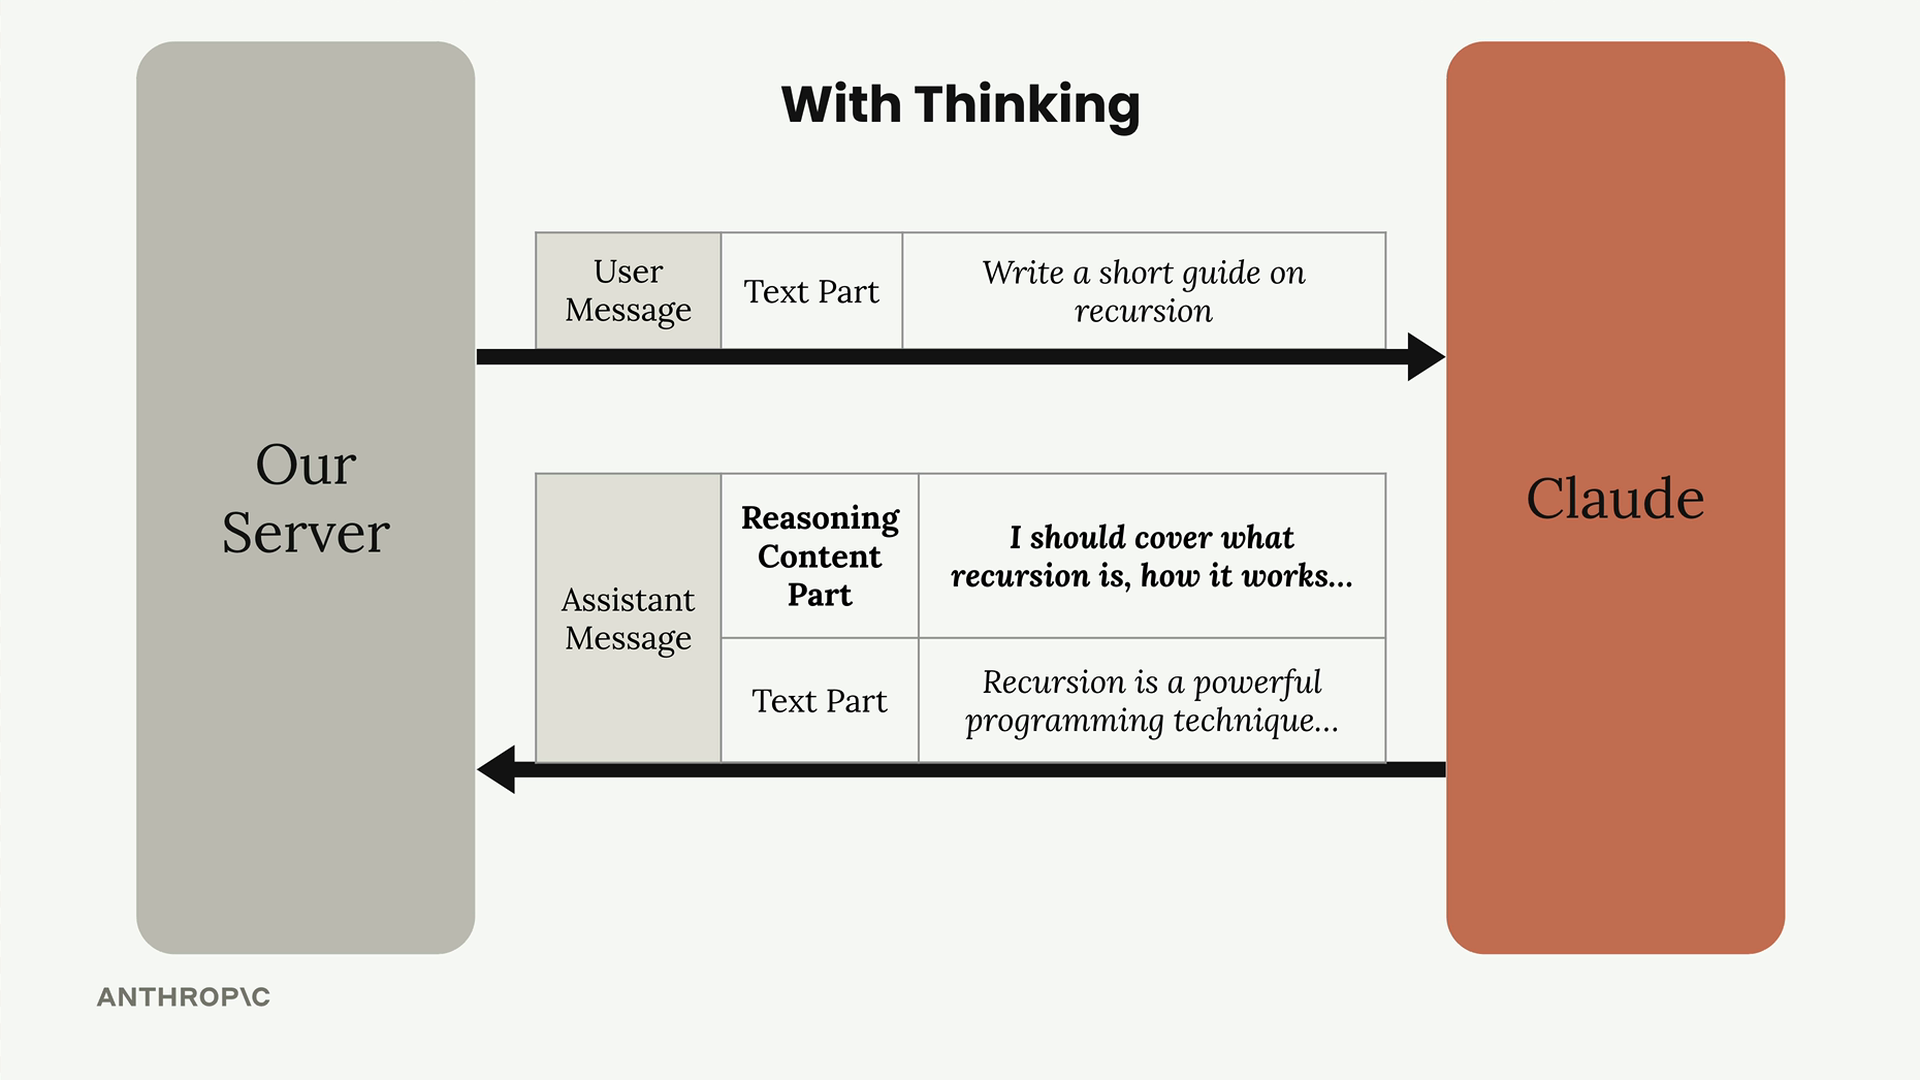
推論コンテンツを見れば、Claudeがあなたの問題をどのように分解し、何を検討し、最終的な答えにどのようにたどり着いたかが正確にわかります。この透明性は、複雑なタスクを理解しデバッグする上で非常に価値があります。
検討すべきトレードオフ
拡張思考には明確な利点とコストがあります。
- 複雑なタスクにおける精度の向上
- コストの増加 - すべての思考トークンに対して料金が発生します
- レイテンシの増加 - 思考には時間がかかります
判断のポイントはシンプルです。評価を活用してください。すでにプロンプトを最適化済みであるにもかかわらず、必要な精度が得られていない場合、それが拡張思考を検討する価値がある時です。
署名システム
すぐに気づく重要な点の1つは、推論コンテンツに付与される暗号署名です。
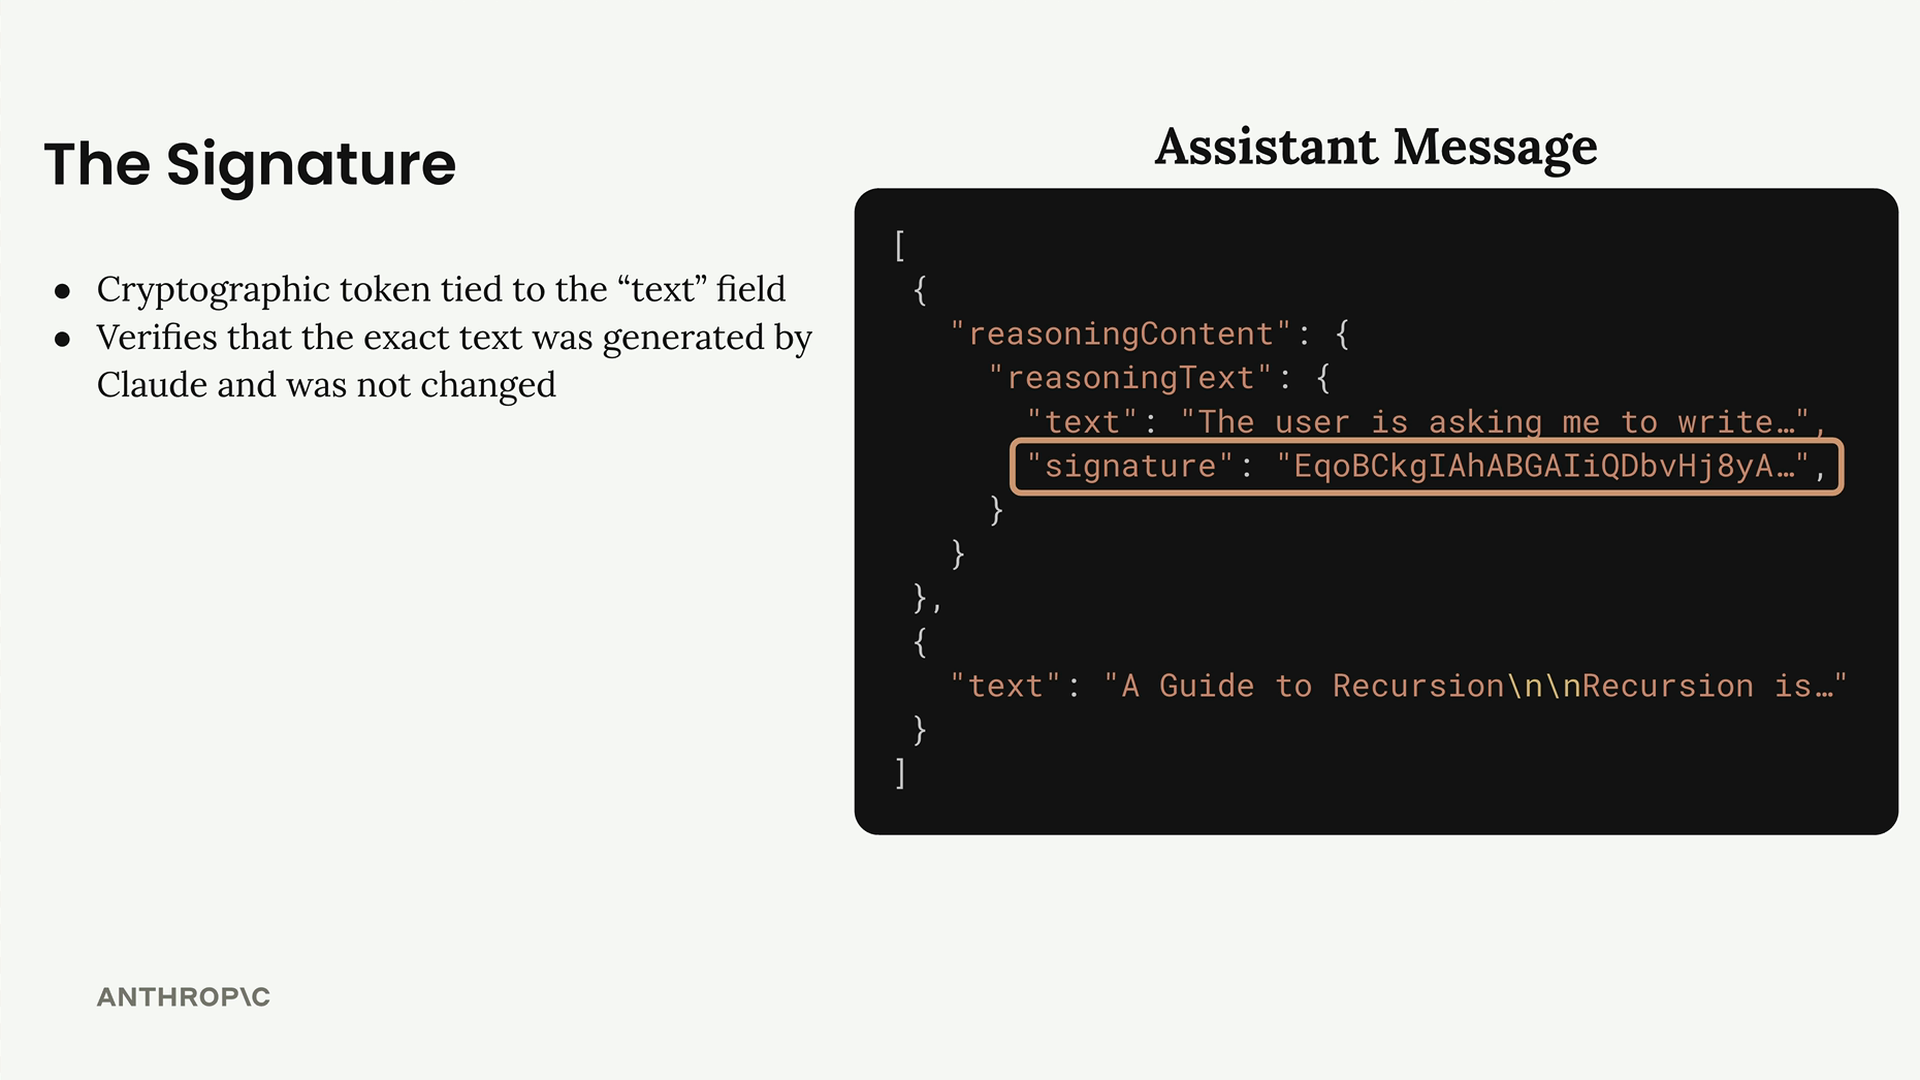
この署名により、思考テキストを改変できないことが保証されます。後続の会話でClaudeの以前の推論を含めたい場合、署名がそのコンテンツが改ざんされていないことを検証します。これにより、改変された推論テキストから生じ得る安全性の問題を防ぐことができます。
編集済み(Redacted)コンテンツ
Claudeの思考が安全性システムによってフラグを立てられることがあります。この場合、読み取り可能な思考テキストの代わりにredactedContentフィールドを受け取ります。
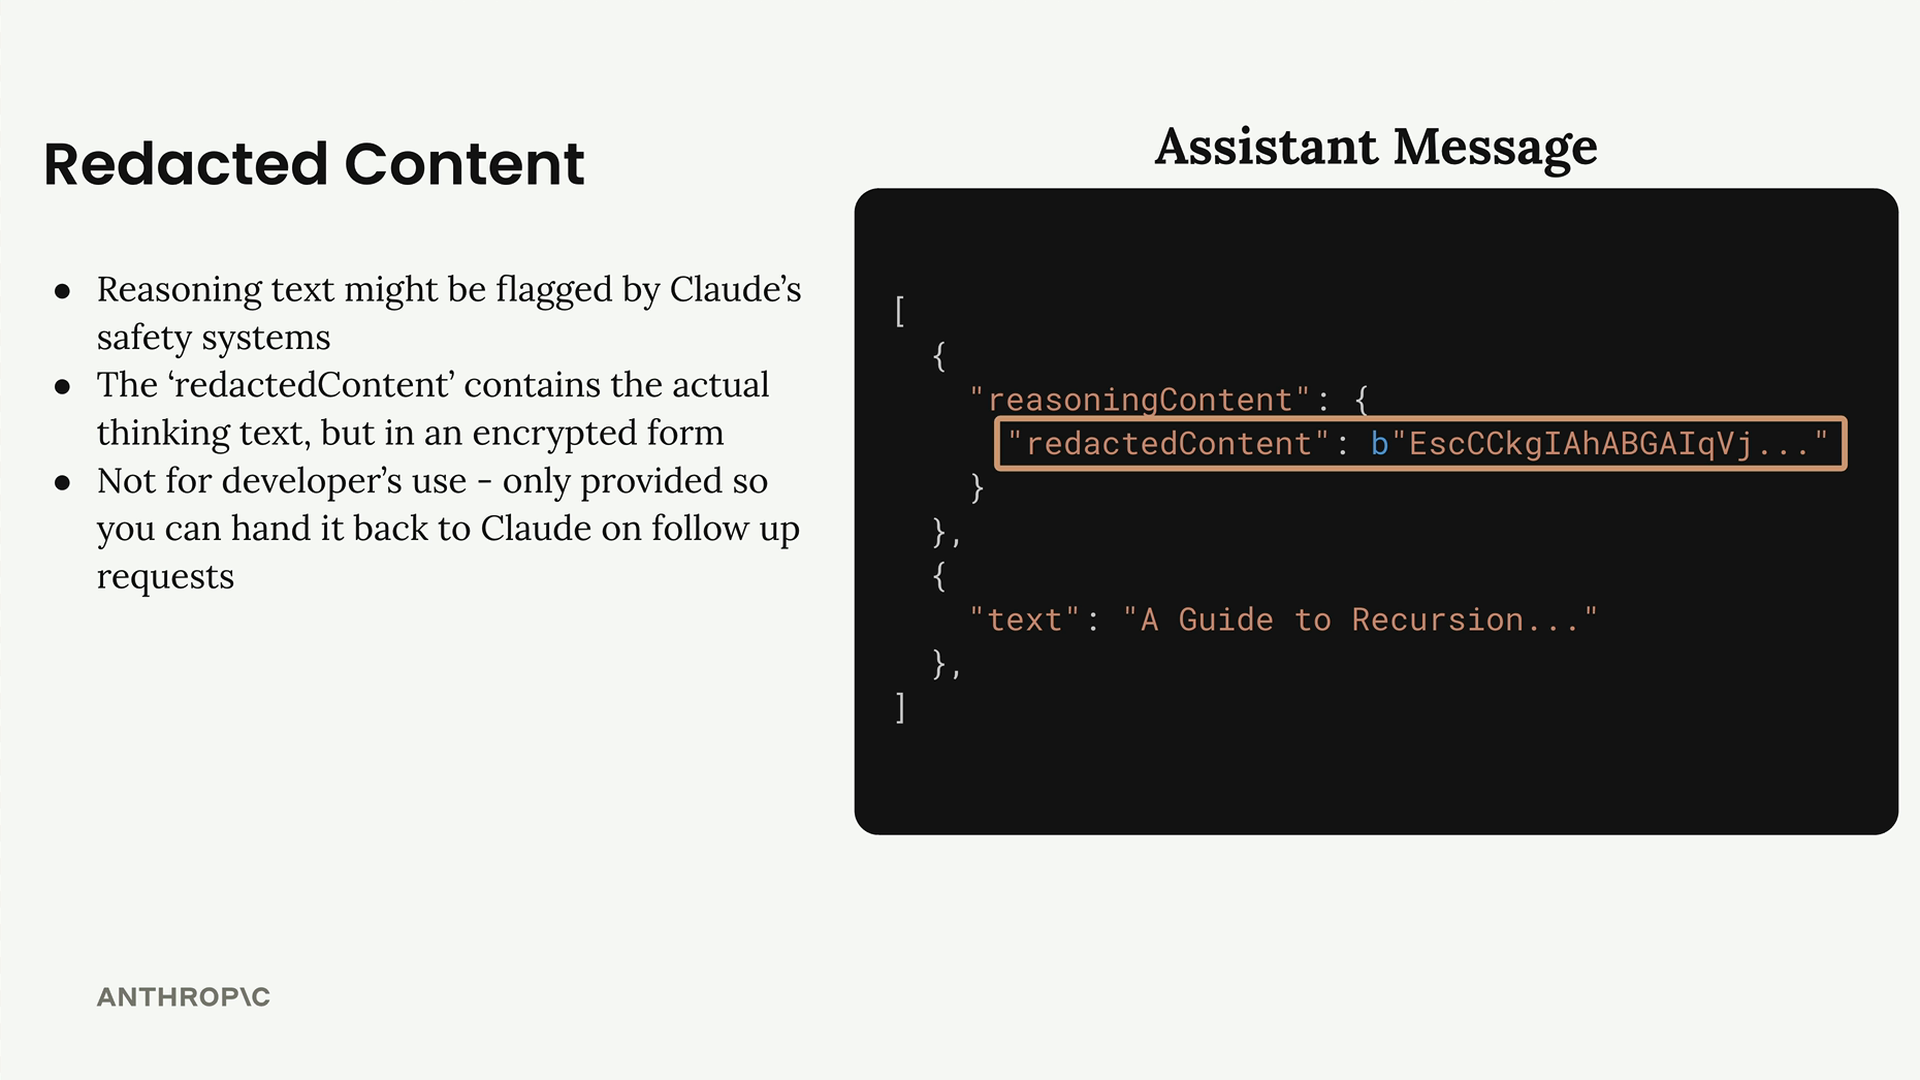
編集済みコンテンツは暗号化されていますが、それでも機能します。後続の会話にそのまま渡すことで、コンテキストを失うことなく利用できます。単に開発者であるあなたには読めないだけです。
実装
Claude Opus 5やClaude Sonnet 5のような現在のClaudeモデルでは、思考は適応的思考(adaptive thinking)として動作し、デフォルトでオンになっています。Claudeはリクエストごとに必要な推論量を自ら判断し、トークンバジェットを管理する必要はありません。これらのモデルは、指定しない限り推論テキストを省略するため、それを確認したい場合はdisplayをsummarizedに設定してください。
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}適応的思考がオンの場合、単純な質問にはすぐに答えが返ってくることが多く、難しい質問にはより多くの推論時間がかけられます。Claudeがどの程度思考するかを誘導するには、適応的思考とeffortパラメータを組み合わせることができます。effortレベルは、Claudeの思考配分に対する緩やかなガイダンスとして機能し、本来手動で管理するトークンバジェットの代わりとなります。
以前に拡張思考を使用したことがある場合は、手動設定が段階的に廃止されつつあることに注意してください。budget_tokensを伴うthinking.type: "enabled"はClaude Opus 4.6およびClaude Sonnet 4.6では非推奨となっており、Claude Opus 4.7以降のモデル(Claude Opus 5やClaude Sonnet 5を含む)ではサポートされておらず、そのようなリクエストは400エラーで拒否されます。代わりにeffortパラメータを伴うthinking.type: "adaptive"を使用してください。
適応的思考をサポートしないモデル
Claude 4.5モデル(Claude Haiku 4.5、Claude Sonnet 4.5、Claude Opus 4.5)およびそれ以前のモデルは適応的思考をサポートしていません。これらのモデルでは、手動のトークンバジェットを使って拡張思考を有効にします。
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}thinking_budgetは、Claudeが推論に費やせるトークン数を制御します。最小値は1024トークンですが、複雑な問題にはより多くが必要になる場合があります。Claudeに関する他のすべてと同様に、評価を活用してユースケースに適したバジェットを見つけてください。
更新されたchat関数は次のようになります。
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
実装のテスト
拡張思考を扱うアプリケーションを構築する際には、通常の推論コンテンツと編集済みコンテンツの両方のシナリオをテストしたいところです。実は、Claudeに強制的に編集済みコンテンツを返させる特別なテスト文字列があります。これは、コードが両方のケースを正しく処理できることを確認するのに役立ちます。
拡張思考について最も重要な教訓は、それを使用するかどうかの判断は常にデータに基づくべきだということです。まず評価を実行し、プロンプトを最適化し、複雑なタスクで必要な精度を得るためにさらなる後押しが必要な場合にのみ拡張思考を検討してください。その規律は、シンプルな習慣に支えられています。より高い能力に手を伸ばす前に、「良い」とはどういう状態かを決めておくことです。タスクに必要な精度がわかっていれば、推測するのではなく、拡張思考がそのコストに見合うかどうかを判断できます。
練習:適応的思考を自分で動かしてみる
適応的思考は、それが判断を下す様子を観察することで最も理解しやすくなります。これまでchat関数を構築してきたコードの中で、それを有効にしてください。
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}次に、この同じ設定で2つのリクエストを送信してください。まず、すでに答えを知っている簡単な事実に関する質問をしてください。次に、自分の仕事から得た複数ステップの分析問題のような、本当に難しい質問をしてください。適応的思考をサポートしないモデルで作業している場合は、前のセクションの手動のbudget_tokens設定で思考を有効にし、同じ2つのリクエストを実行してください。
思考が何をしたかを確認する
フラグを設定しただけでは、リクエストが受理されたことが証明されるに過ぎません。次のチェックによって、思考が実際に何をしたのかがわかります。
- 思考が実行されたことを確認する。 各応答には、テキストだけでなく、推論コンテンツと最終テキストの2つの部分が含まれるようになっているはずです。唯一の例外は、先ほど見た編集済みコンテンツです。
redactedContentフィールドは、思考は実行されたがテキストが暗号化されていることを意味します。 - 推論コンテンツを読む。 それが単に質問を言い換えているだけでなく、本当にその質問について推論しているかを確認してください。これは、後で複雑なタスクをデバッグする際に頼ることになるのと同じ透明性です。
- 2つのリクエストを比較する。 単純な質問はたいていすぐに、わずかな推論とともに返ってきますが、難しい質問には目に見えて多くの推論が費やされます。その違いこそ、適応的思考があなたに代わって配分を判断している証です。
- コストを見極める。 すべての思考トークンに対して料金が発生するため、難しい質問への答えが、思考なしで得られる答えより優れているかを確認してください。それを判断するのはあなたの評価であり、推論テキストが表示されること自体はその代わりにはなりません。
このレッスンから持ち帰っておくべき行動はこれです。新しいタスクで拡張思考を有効にするたびに、いくつかの代表的なリクエストで推論コンテンツを読み、設定を維持するかどうかを決める前に評価を再実行してください。