テキストチャンキングは、RAG(Retrieval Augmented Generation)パイプラインを構築する上で最も重要なステップの1つです。ドキュメントをどのように分割するかは、システム全体の品質に直接影響します。チャンキング戦略が不適切だと、プロンプトに無関係なコンテキストが挿入され、AIがまったく見当違いの回答をしてしまう原因になります。
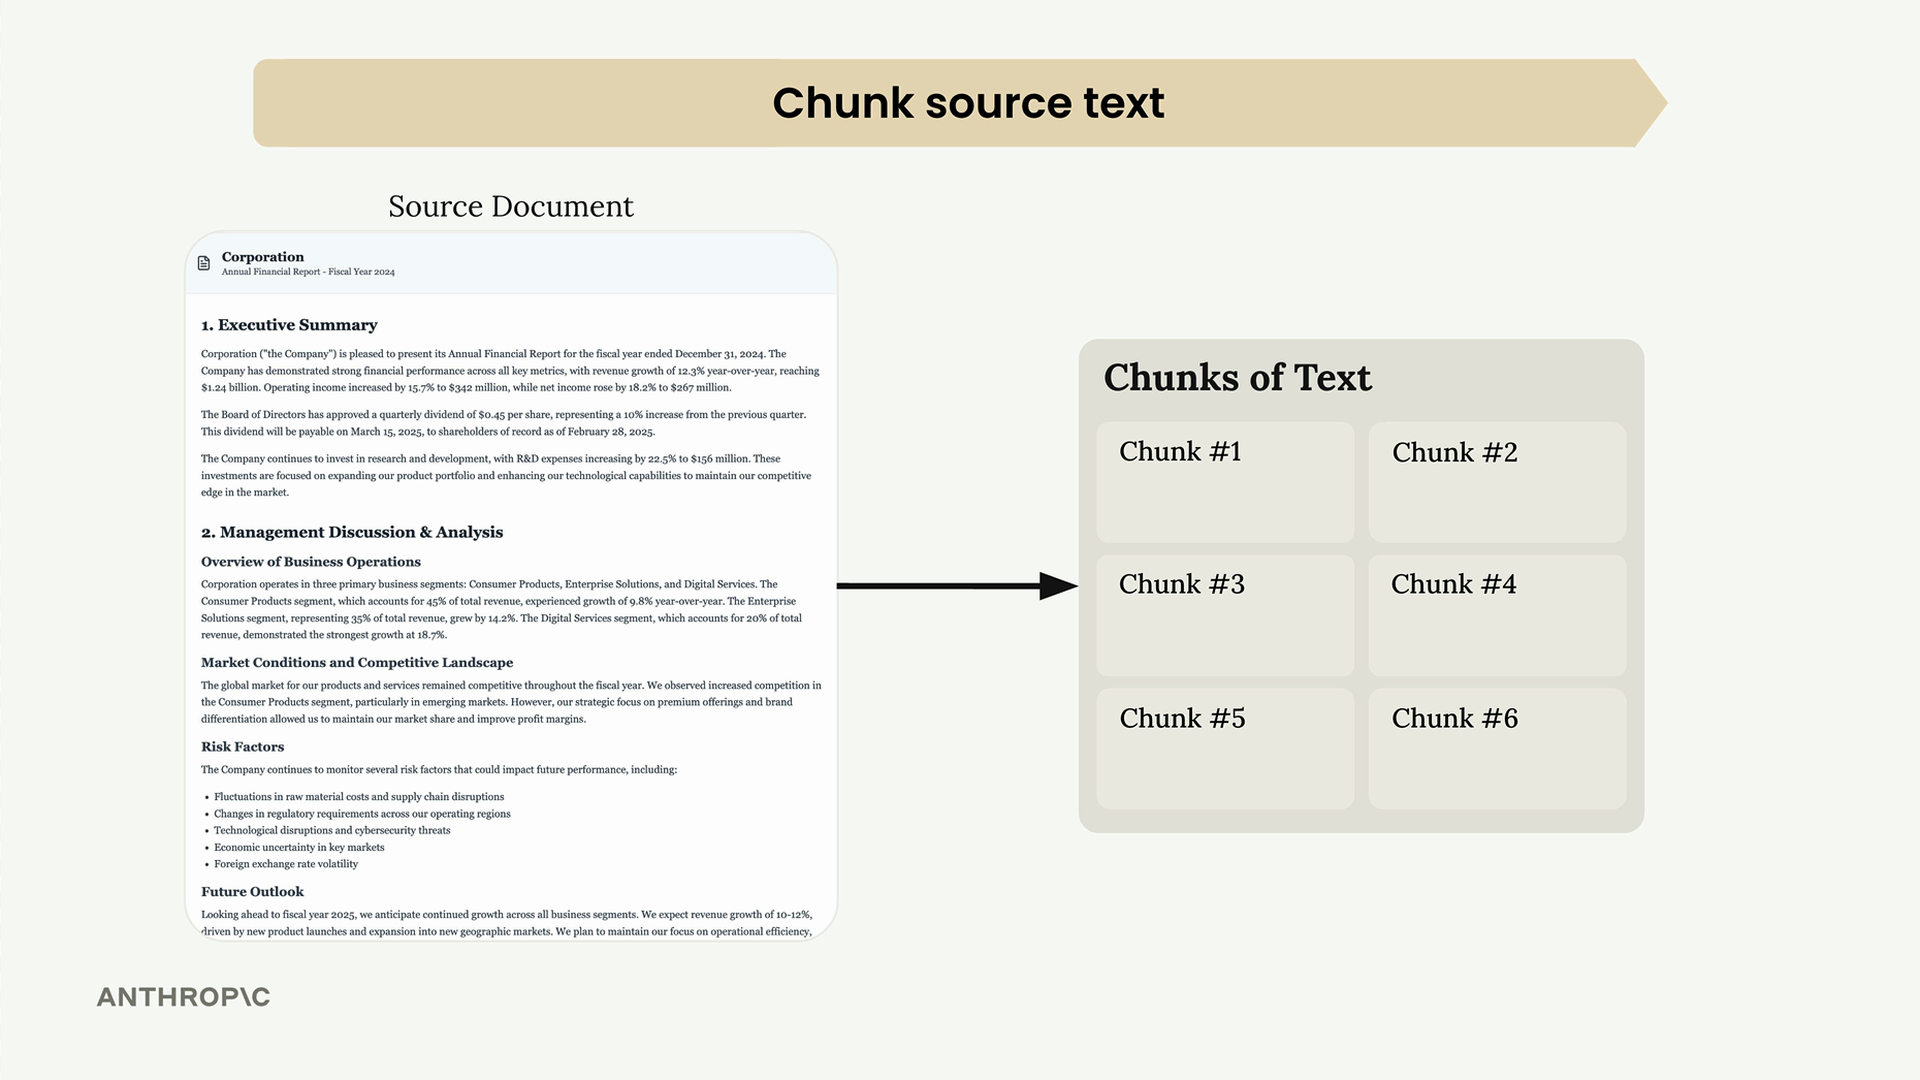
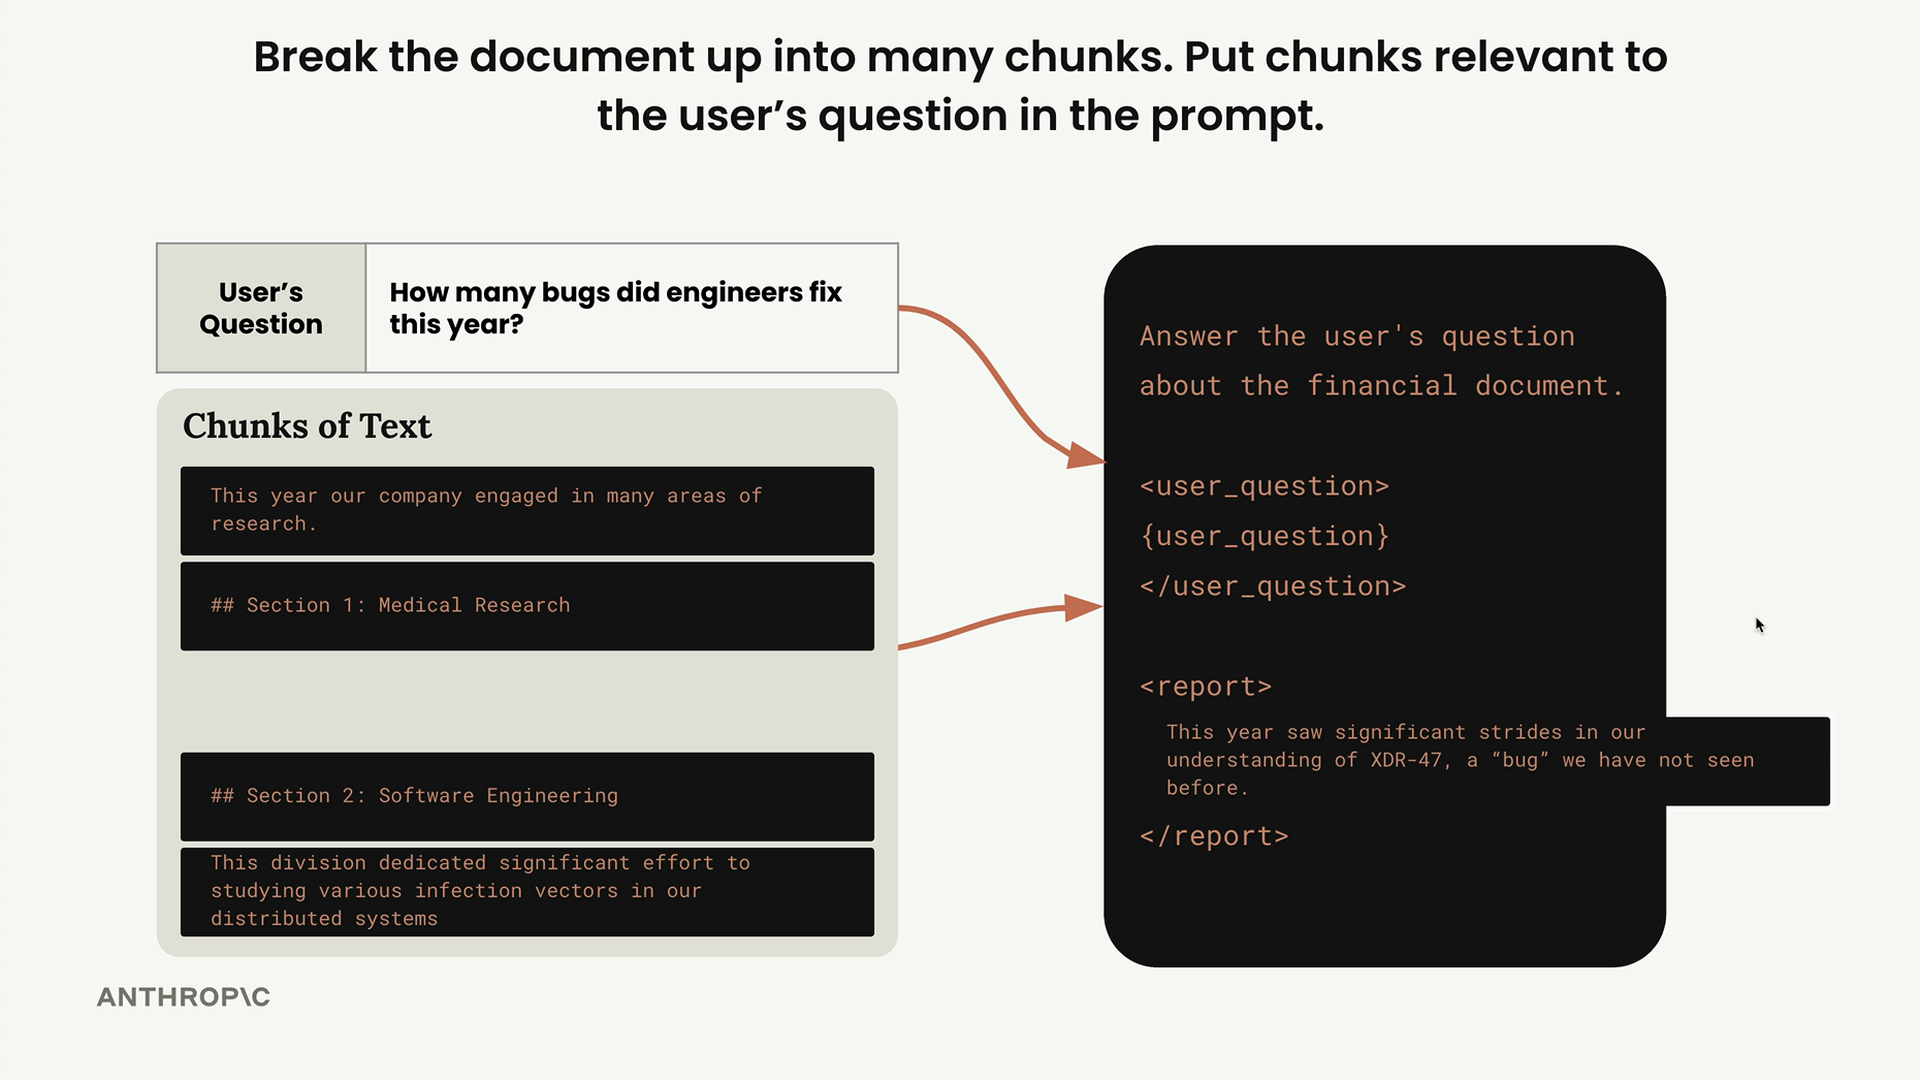
次の例を考えてみましょう。医療研究とソフトウェアエンジニアリングに関するセクションを持つドキュメントがあるとします。チャンキングが不適切だと、「今年エンジニアは何件のバグを修正しましたか?」と尋ねたユーザーは、医療研究セクションがたまたま別の文脈で「bug」という単語を含んでいたというだけの理由で、ソフトウェアエンジニアリングではなく医療研究に関する情報を受け取ってしまう可能性があります。
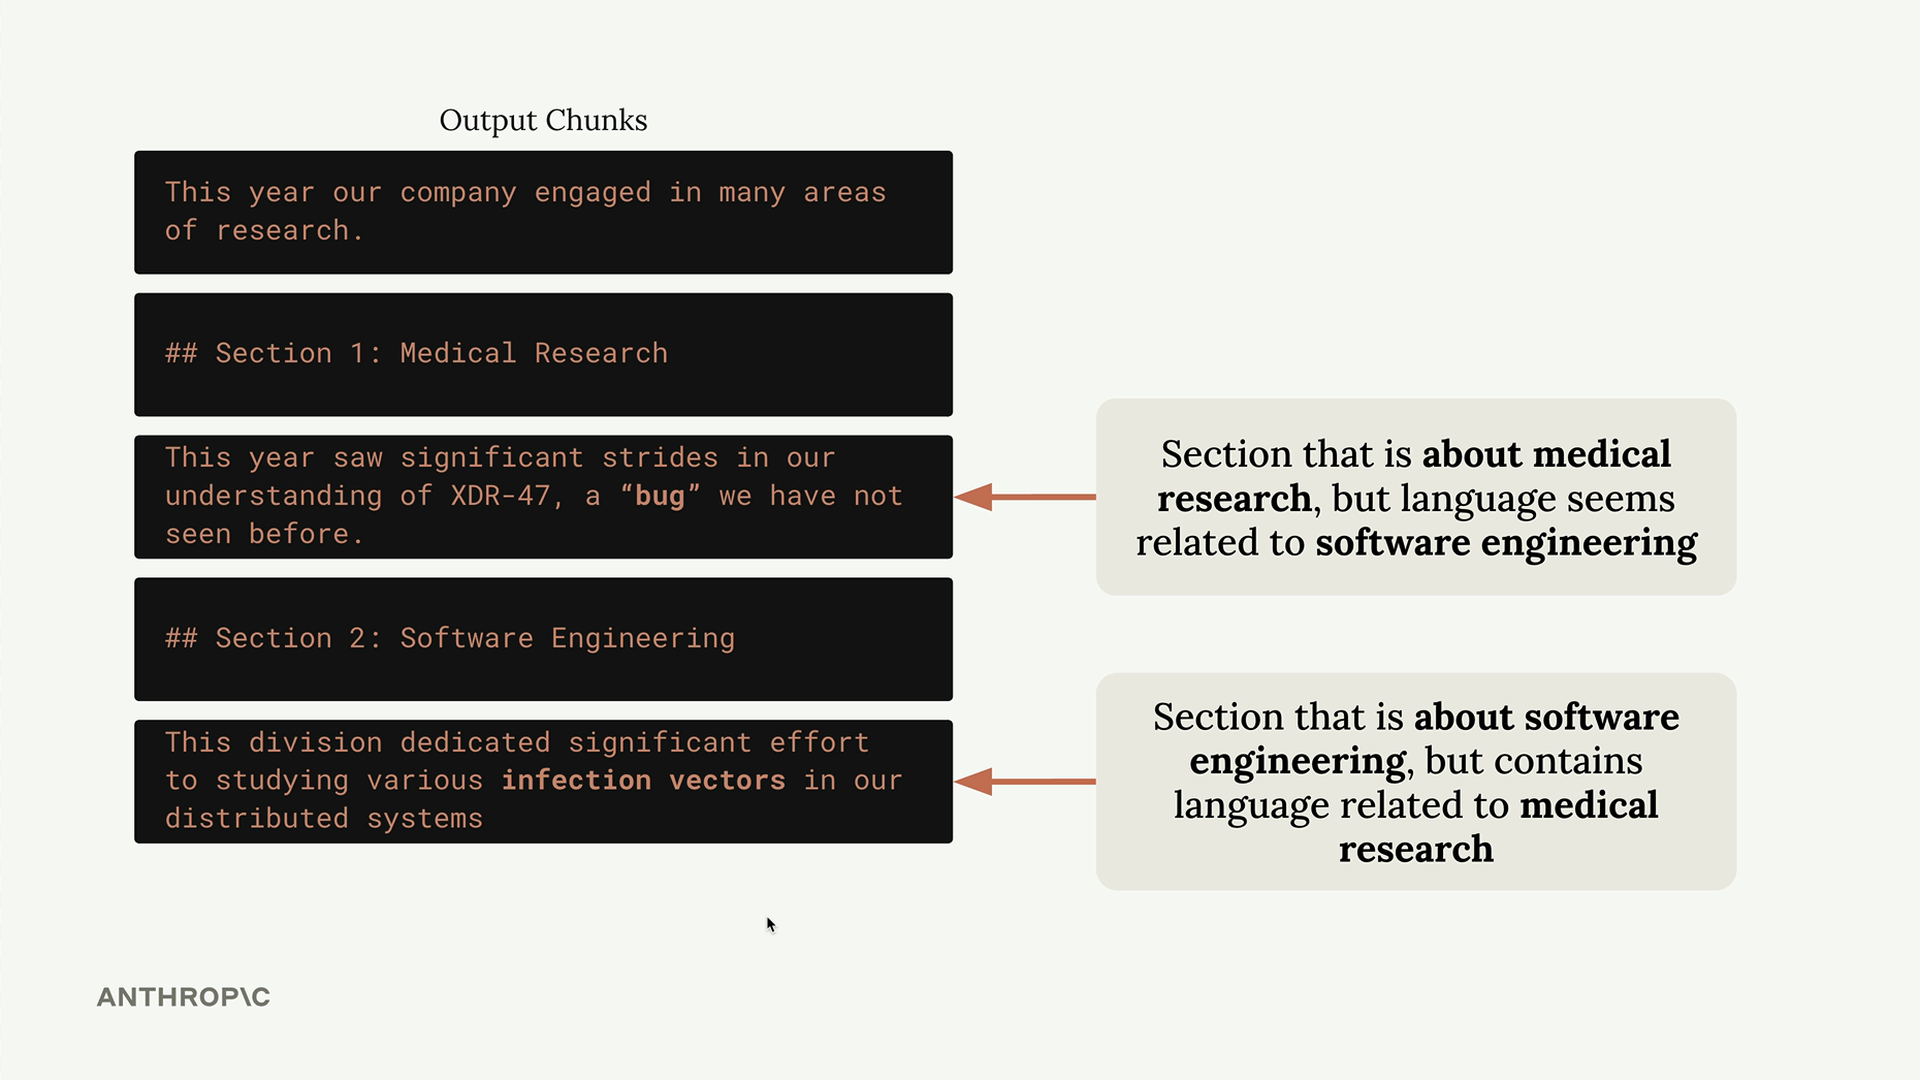
この例は、チャンキング戦略がいかに重要であるかを示しています。目標は、意味的なまとまりを維持し、取得された際に有用なコンテキストを提供できるチャンクを作成することです。
3つの主要なチャンキング戦略
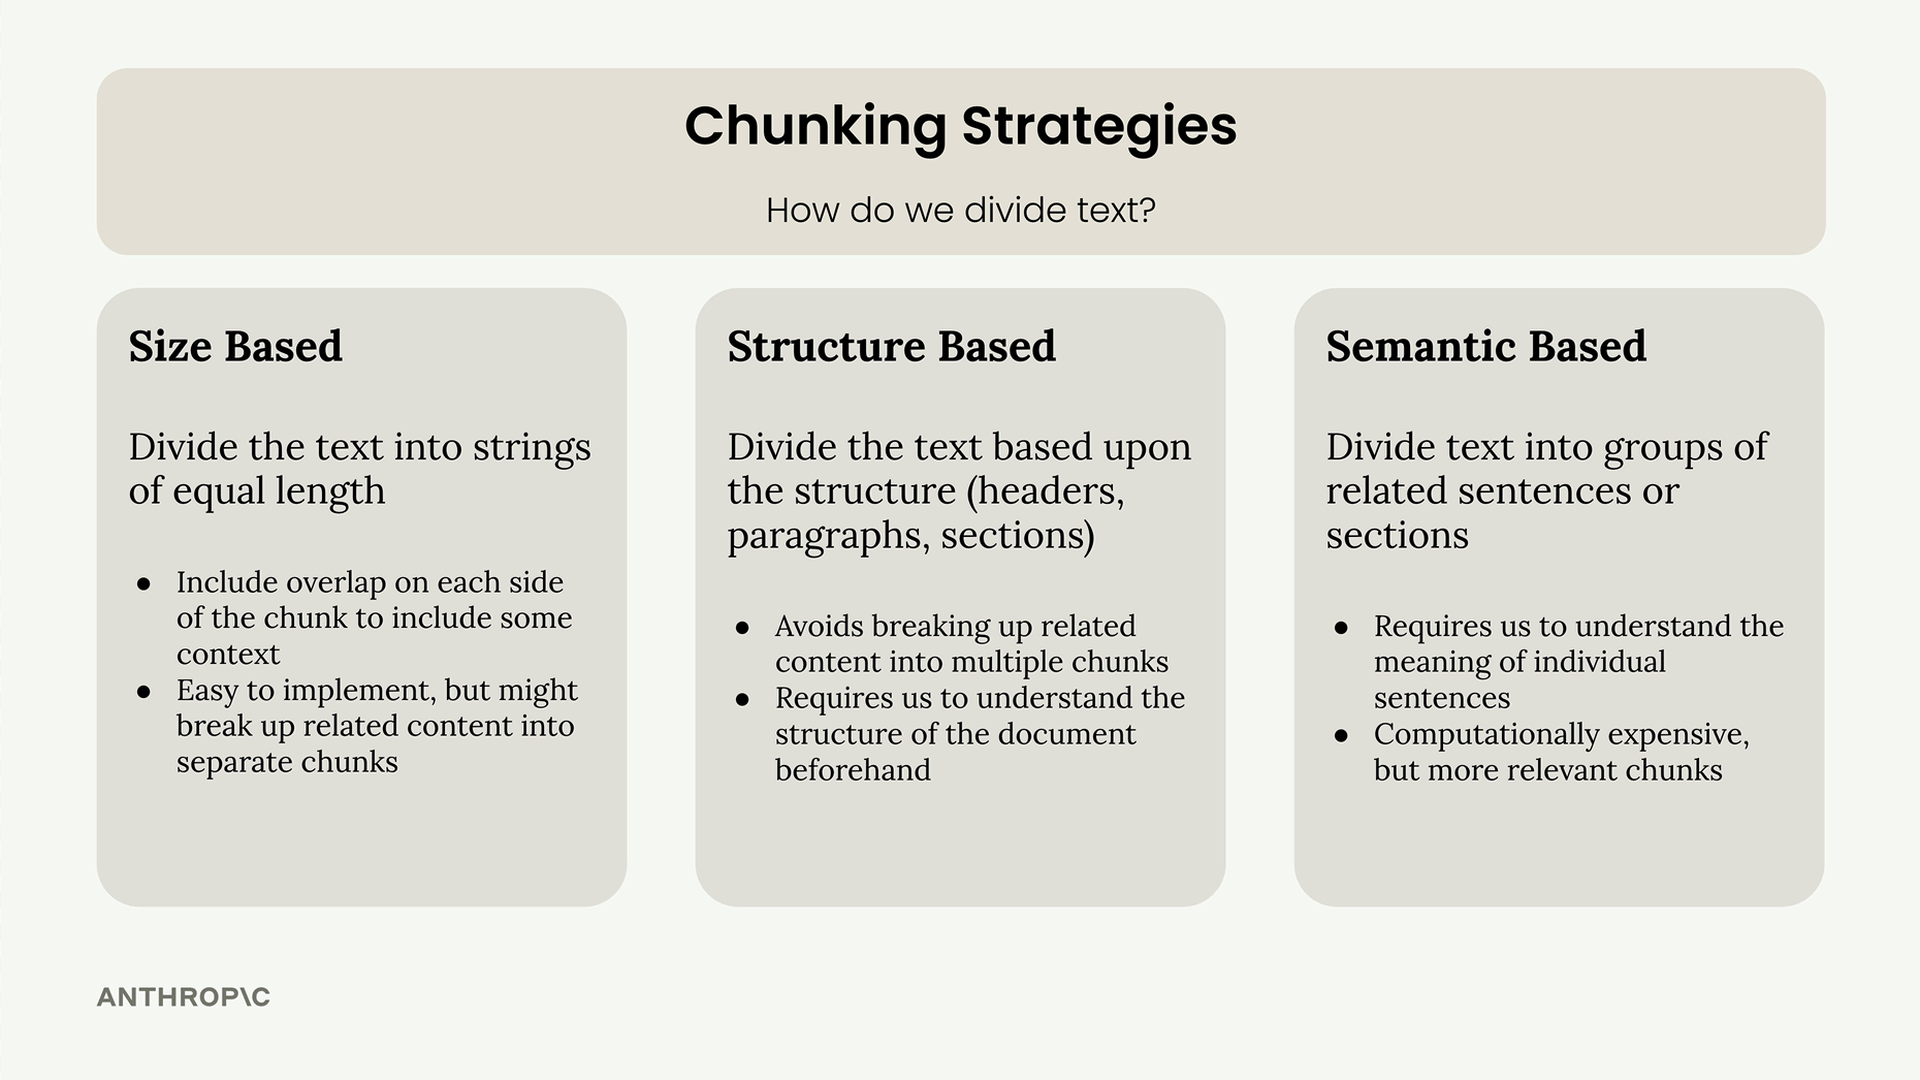
テキストをチャンクに分割するための主要なアプローチは3つあります。
- サイズベース: テキストを等しい長さの文字列に分割する
- 構造ベース: ドキュメントの構造(見出し、段落、セクション)に基づいて分割する
- セマンティックベース: NLP技術を使用して関連する文や セクションをグループ化する
サイズベースのチャンキング
サイズベースのチャンキングは最も単純なアプローチです。ドキュメントを、文字数または単語数がほぼ等しいチャンクに単純に分割します。実装が簡単で、さまざまなドキュメントタイプに対して確実に機能します。
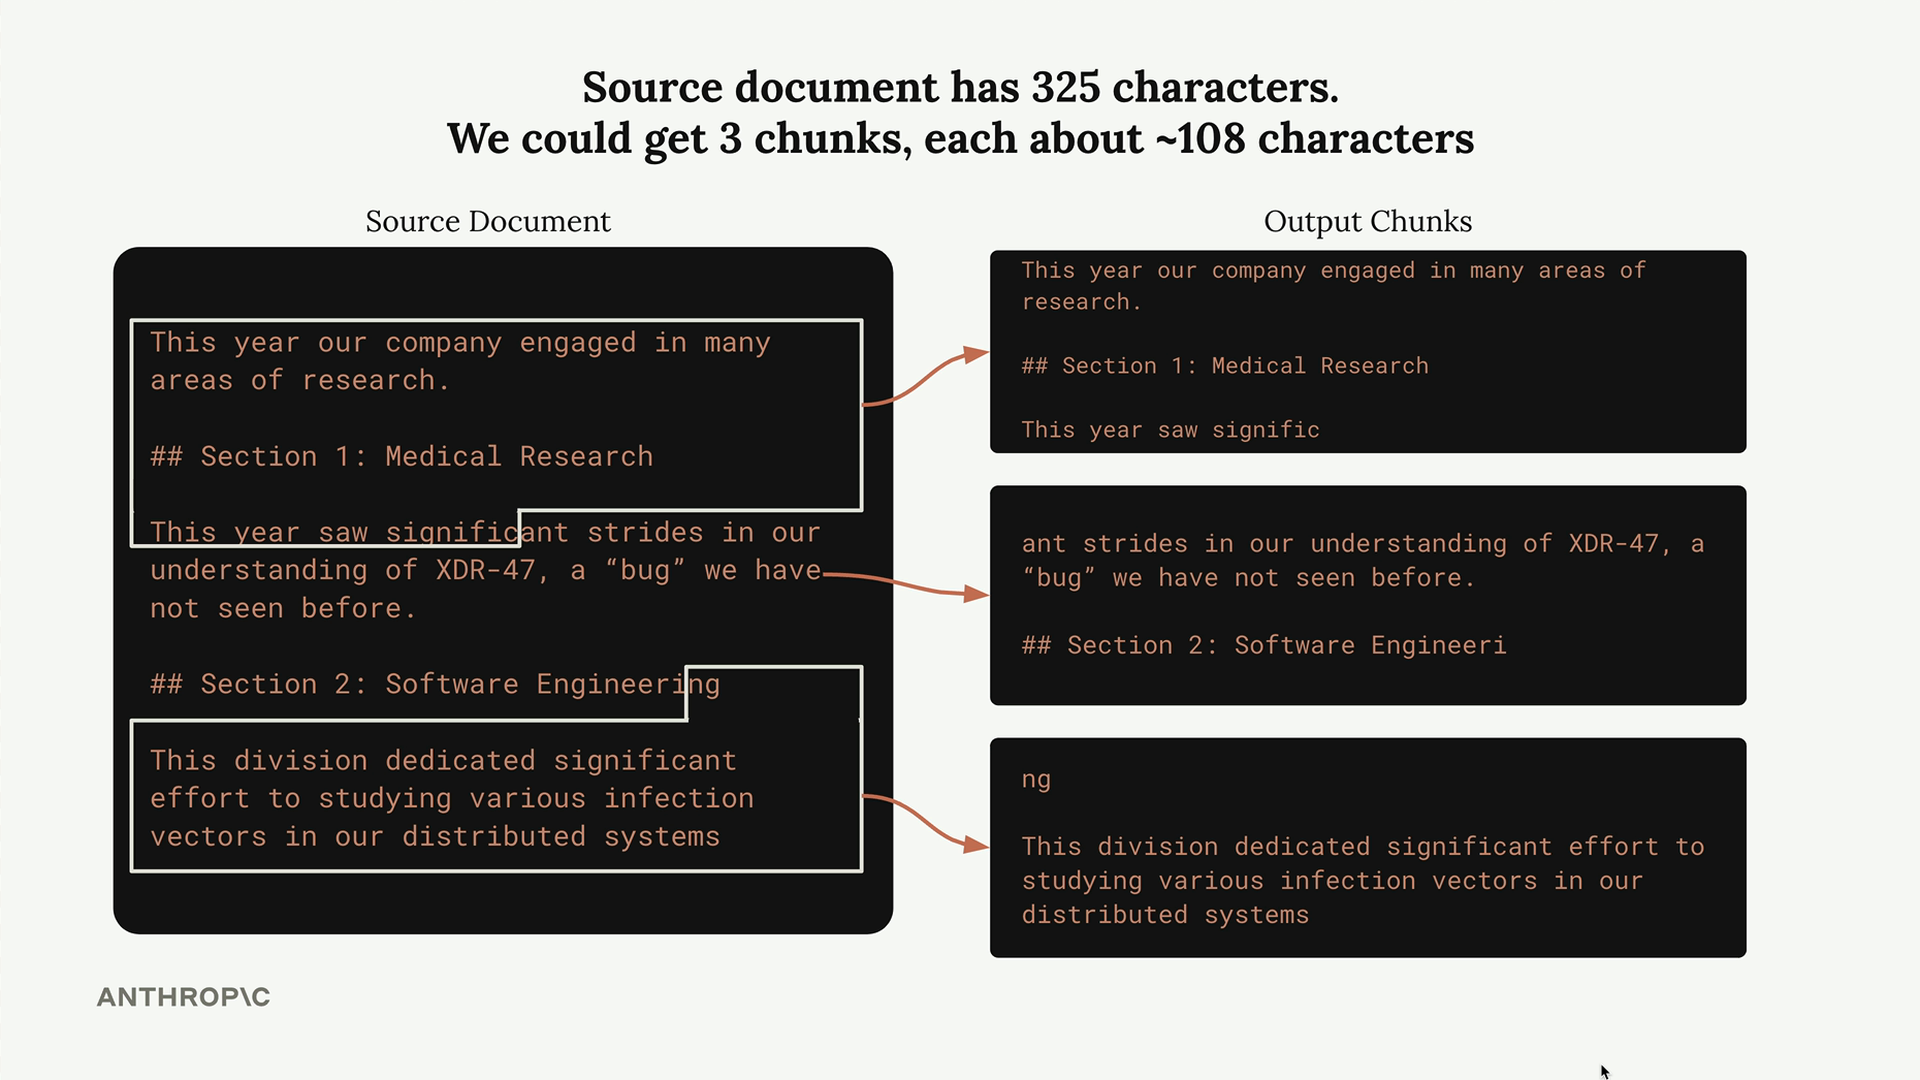
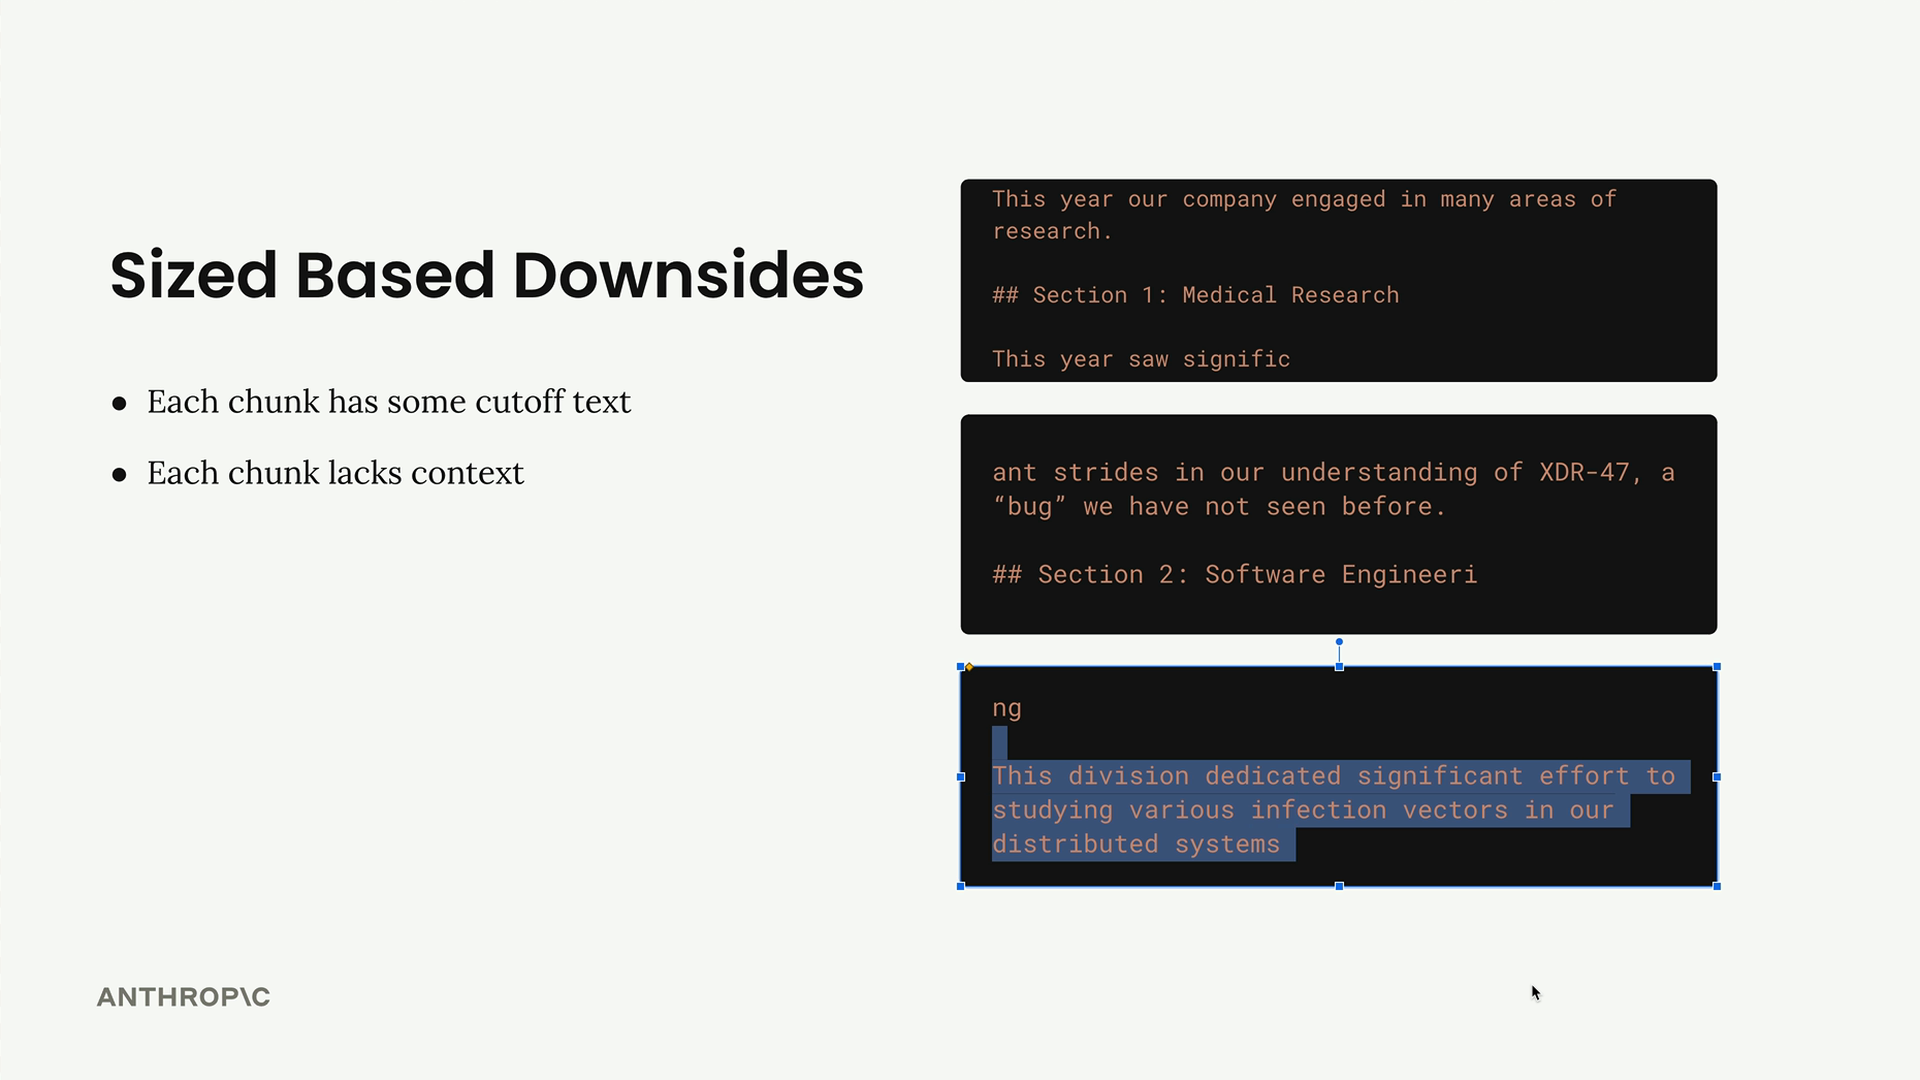
ただし、このアプローチには明確な欠点があります。
- 単語が文の途中で切れてしまう
- チャンクが周囲のテキストから重要なコンテキストを失う
- 関連するコンテンツが複数のチャンクにまたがって分割される可能性がある
オーバーラップの追加
このコンテキストの問題に対処するため、オーバーラップ戦略を実装できます。各チャンクは隣接するチャンクから一部の文字を含むようにし、追加のコンテキストを提供するとともに、チャンクの境界で重要な情報が失われないようにします。
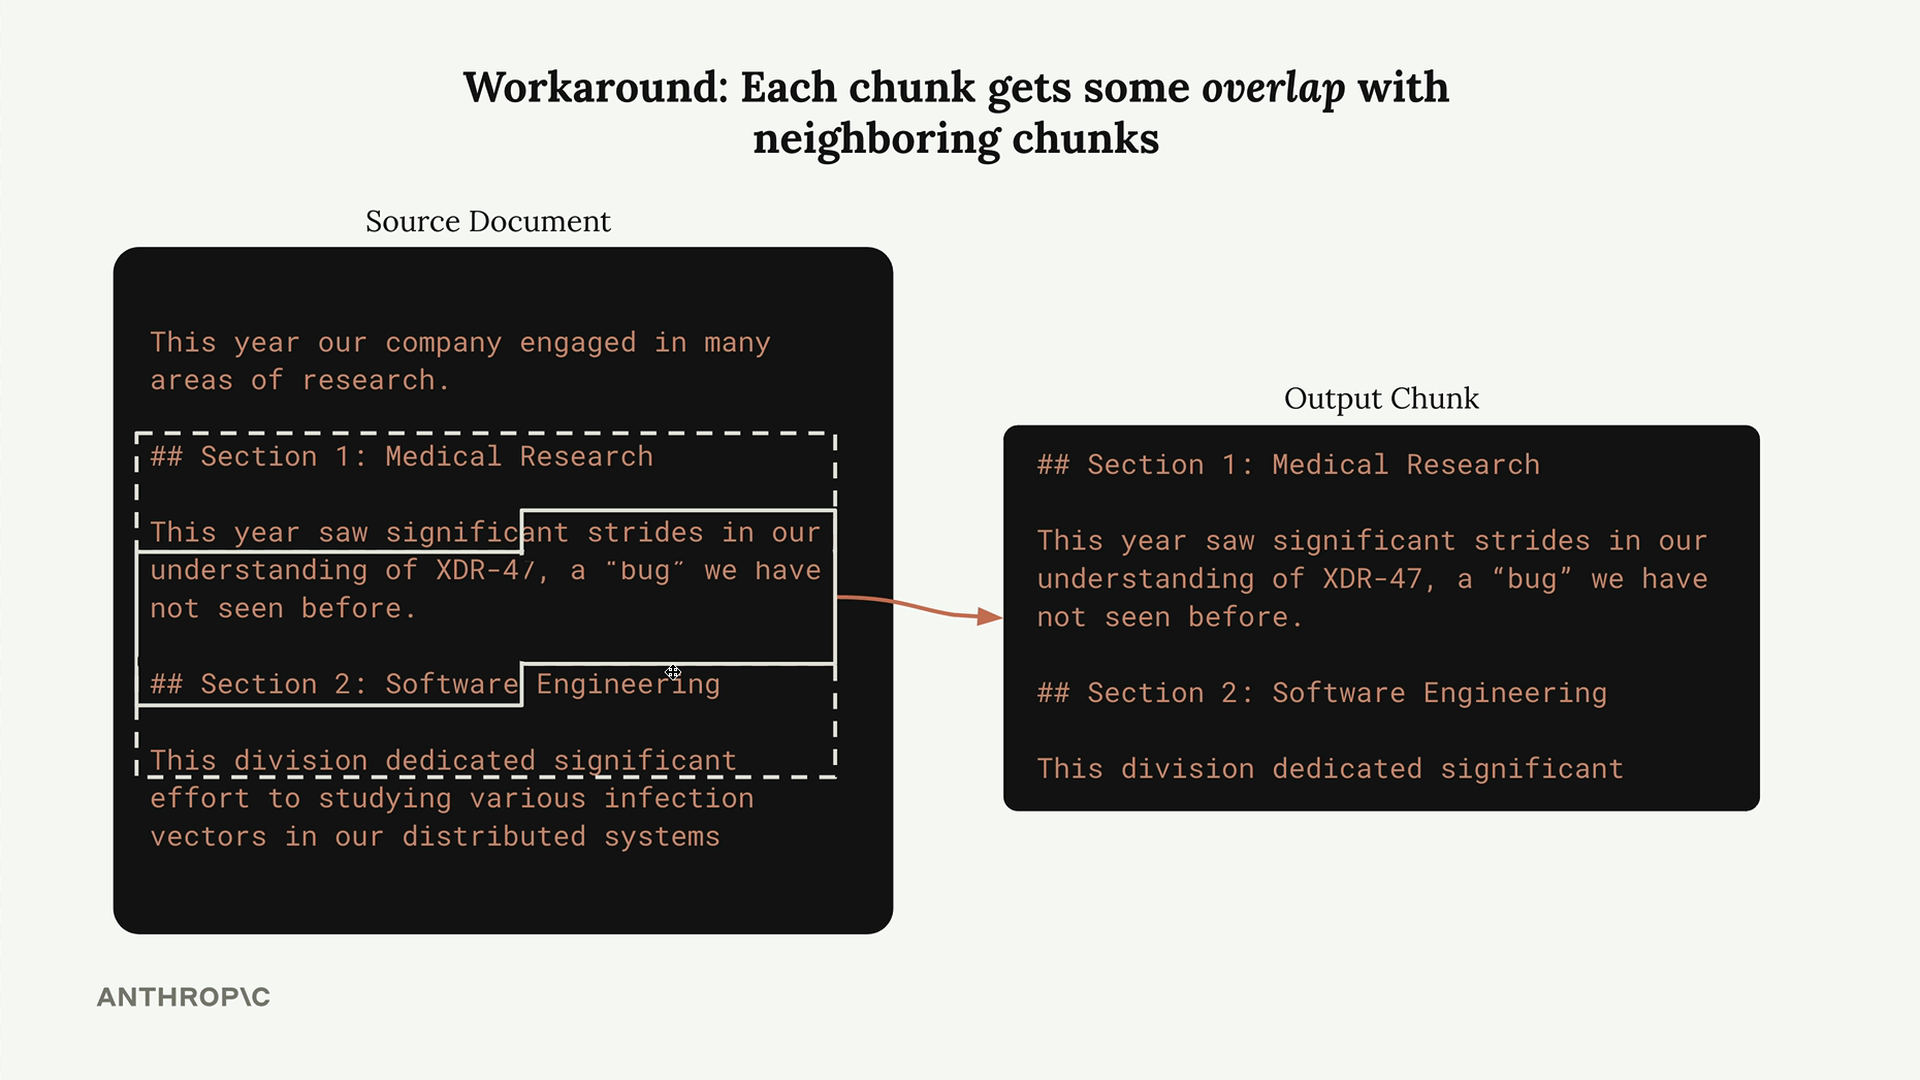
これによりある程度の重複が生じますが、各チャンクが得られるコンテキストの改善を考えれば、このトレードオフは通常その価値があります。
構造ベースのチャンキング
ドキュメントが一貫したフォーマット(明確な見出しを持つmarkdownなど)を持っている場合、構造ベースのチャンキングは優れた結果を生み出すことができます。見出しなどの構造的な要素で分割し、ドキュメントの自然な構成に沿ったチャンクを作成します。
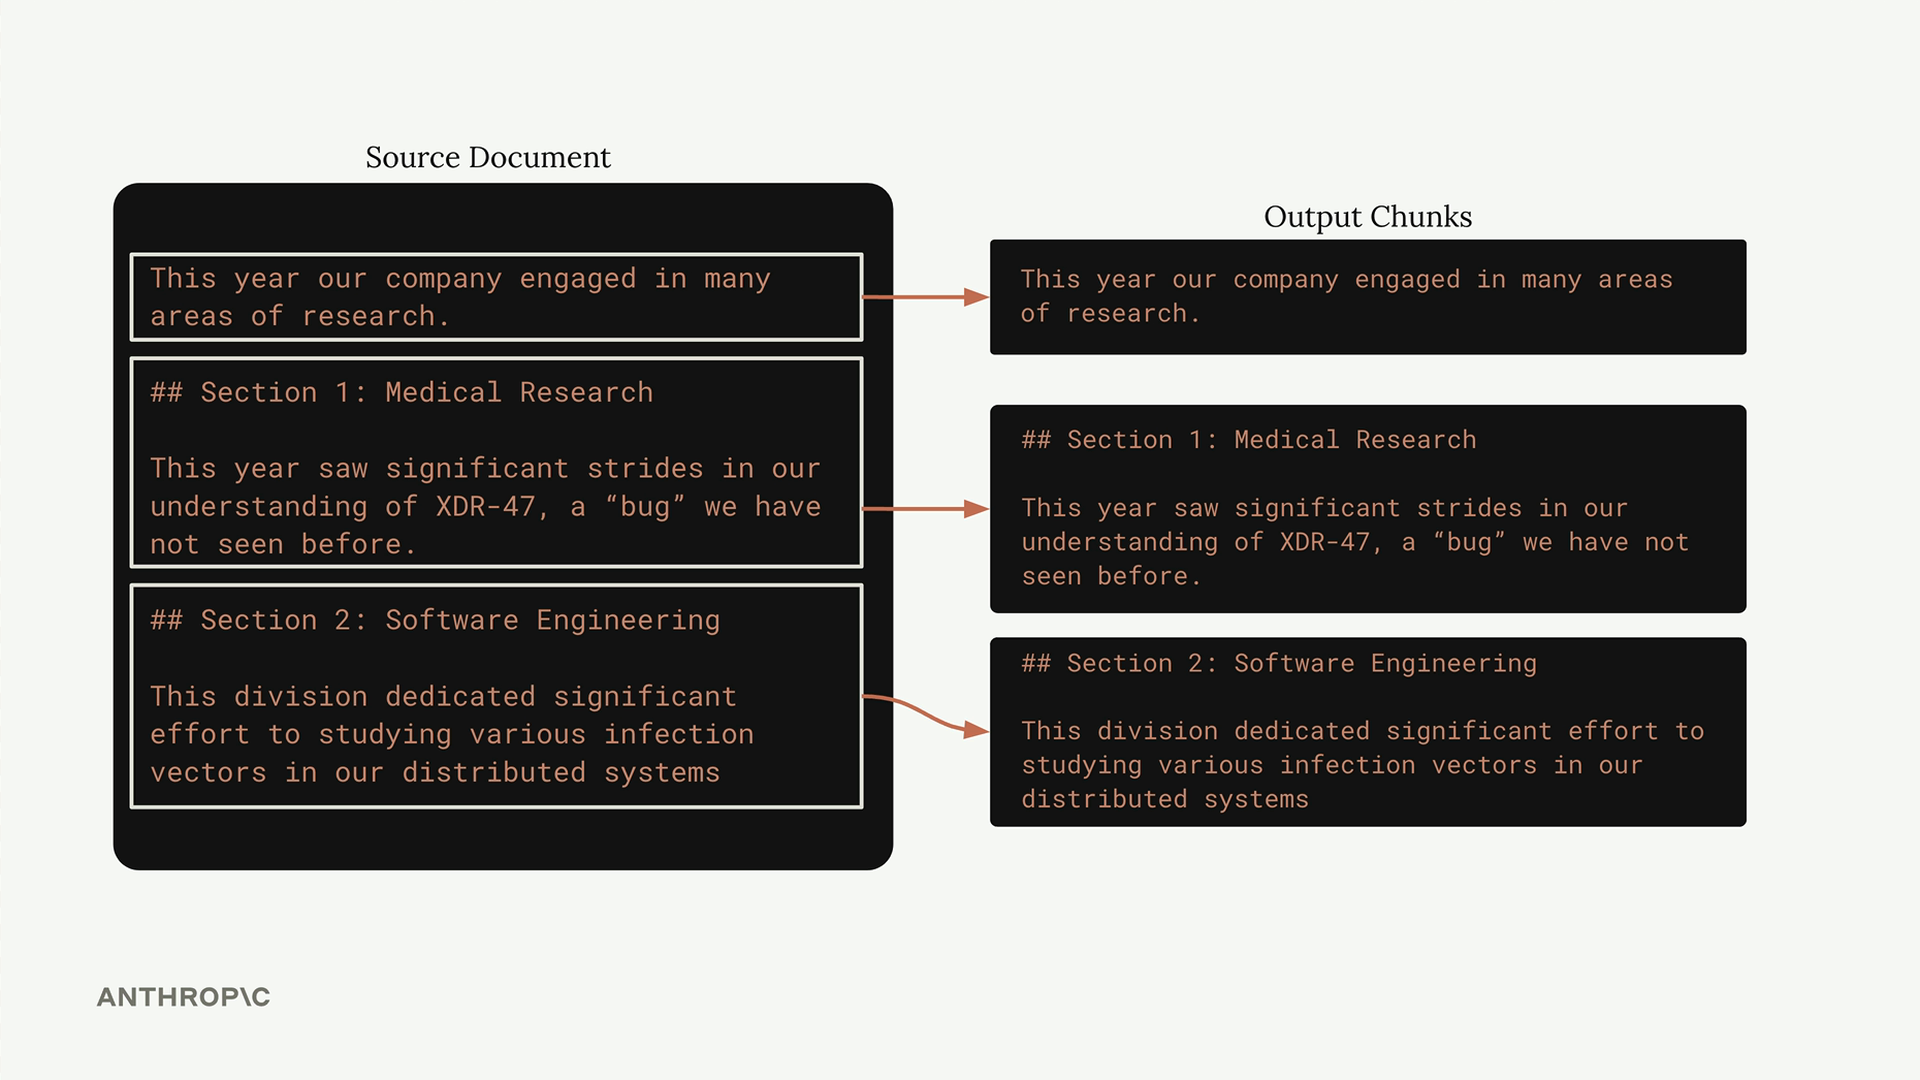
これはよくフォーマットされたドキュメントに対しては見事に機能しますが、ドキュメント構造に関する保証が必要です。プレーンテキストファイルや、フォーマットが一貫していないドキュメントには確実には機能しません。
実装例
実装できる3つの実用的なチャンキング関数を紹介します。
文字ベースのチャンキング
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
文ベースのチャンキング
import re

def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
セクションベースのチャンキング
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
適切な戦略の選択
チャンキング戦略の選択は、完全にあなたの具体的なユースケースに依存します。
- 文字ベース: 最も信頼性の高いフォールバックで、どのようなドキュメントタイプにも対応できる
- 文ベース: 文章に対してコンテキストと意味のバランスが良い
- セクションベース: 構造化されたドキュメントがある場合に優れた結果が得られる
フォーマットの保証がないユーザーがアップロードしたドキュメントに対しては、文字ベースのチャンキングがしばしば最も安全な選択肢です。よく構造化された社内ドキュメントに対しては、セクションベースのチャンキングがより優れた結果をもたらすことがあります。文ベースのチャンキングはほとんどの文章に対してうまく機能しますが、予期しない形でピリオドを使用するコードや技術文書では苦戦することがあります。
チャンキングはしばしば反復的なプロセスであることを覚えておいてください。まずシンプルなアプローチから始め、特定のドキュメントとユースケースでテストし、そしてRAGシステムから得られる結果の品質に基づいて改良していきましょう。