Retrieval Augmented Generation(RAG)は、大きなドキュメントをより小さな断片に分割し、質問ごとに最も関連性の高いチャンクだけをClaudeに渡すことで、大規模なドキュメントを扱いやすくする技術です。800ページにも及ぶ財務報告書全体をモデルに押し付ける代わりに、RAGを使えば特定の質問に答えるために重要なセクションだけを抽出できます。
大きなドキュメントが抱える問題
巨大なドキュメントがあり、それについてClaudeに具体的な質問をしたい場合、基本的な課題に直面します。それは、制限に達したりパフォーマンスを低下させたりすることなく、適切な情報をどうやってClaudeに渡すかということです。
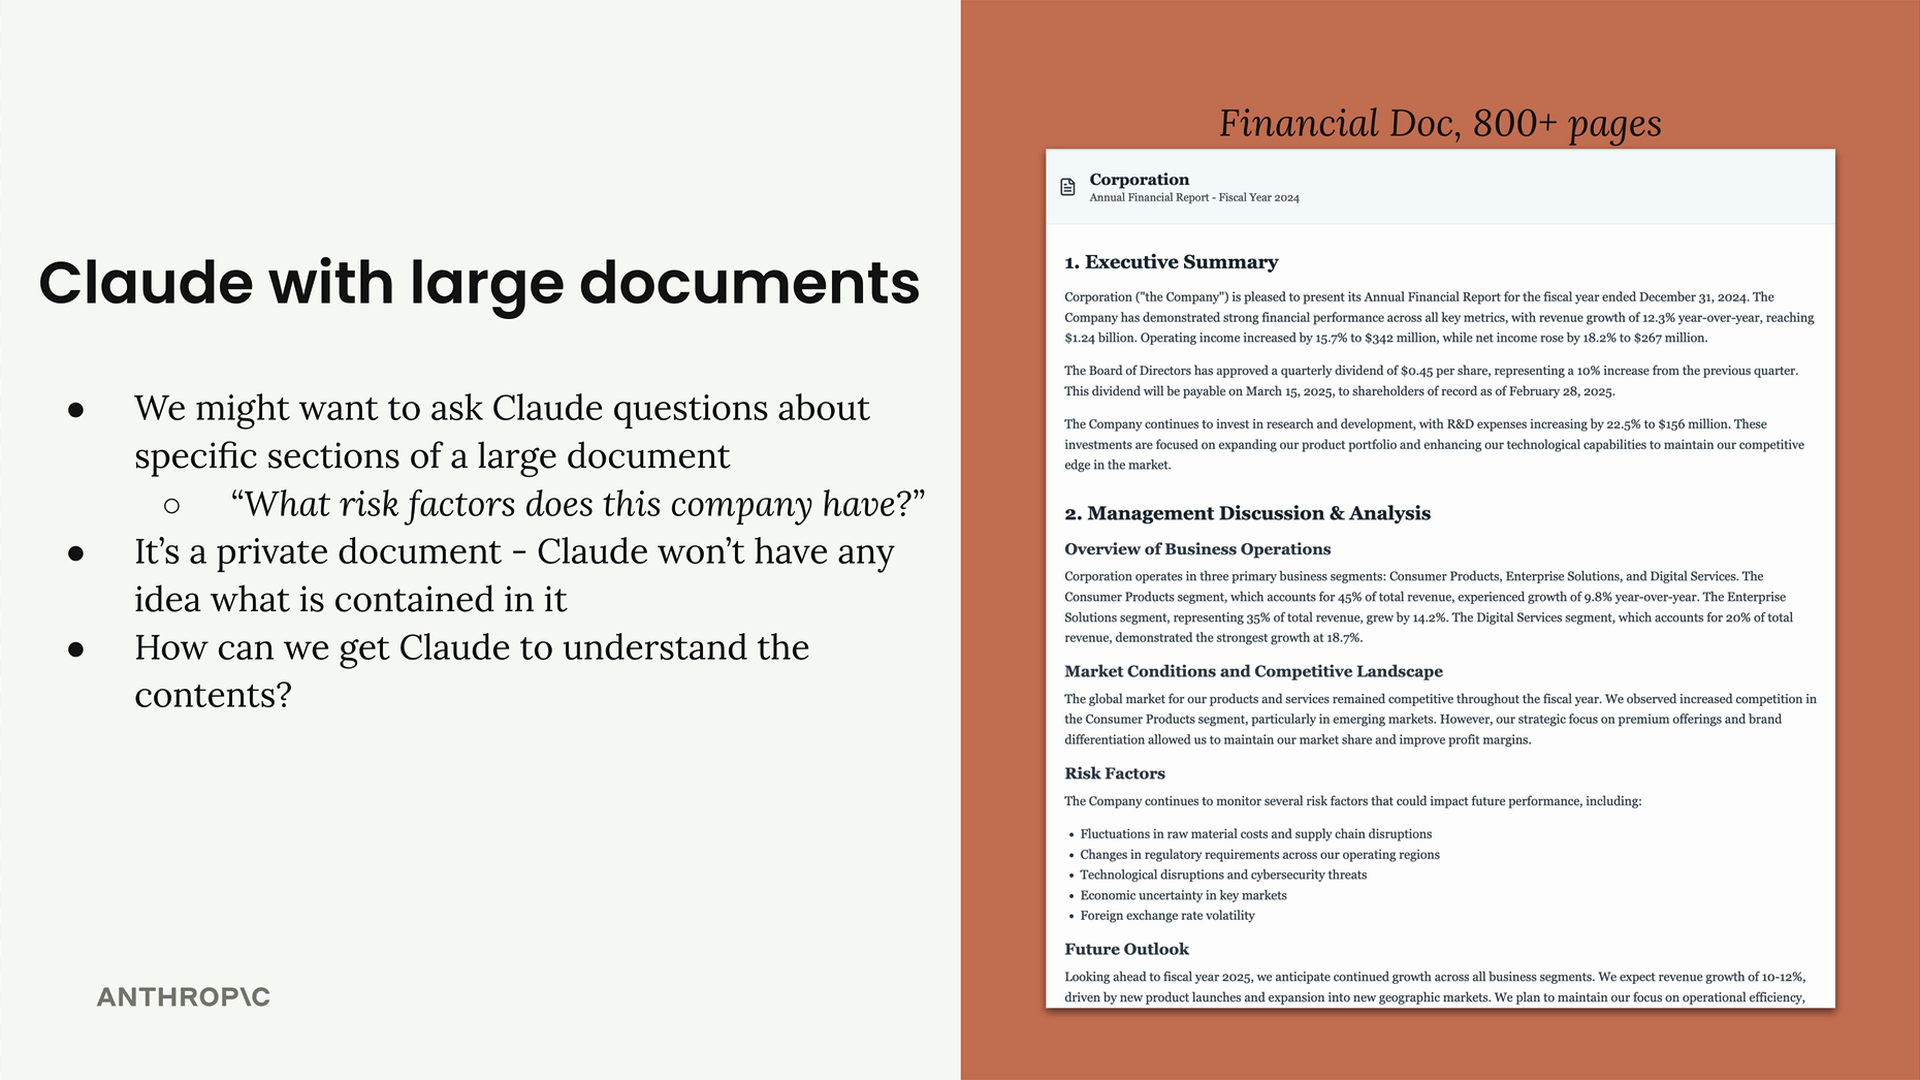
長大な財務ドキュメントについて「この会社にはどのようなリスク要因がありますか?」と尋ねる場合を考えてみましょう。ドキュメントには答えが含まれていますが、Claudeはあなたを助けるために関連するコンテンツにアクセスする必要があります。
オプション1: プロンプトにすべてを含める
シンプルな方法は、ドキュメントからすべてのテキストを抽出し、それを1つのプロンプトに詰め込むことです。
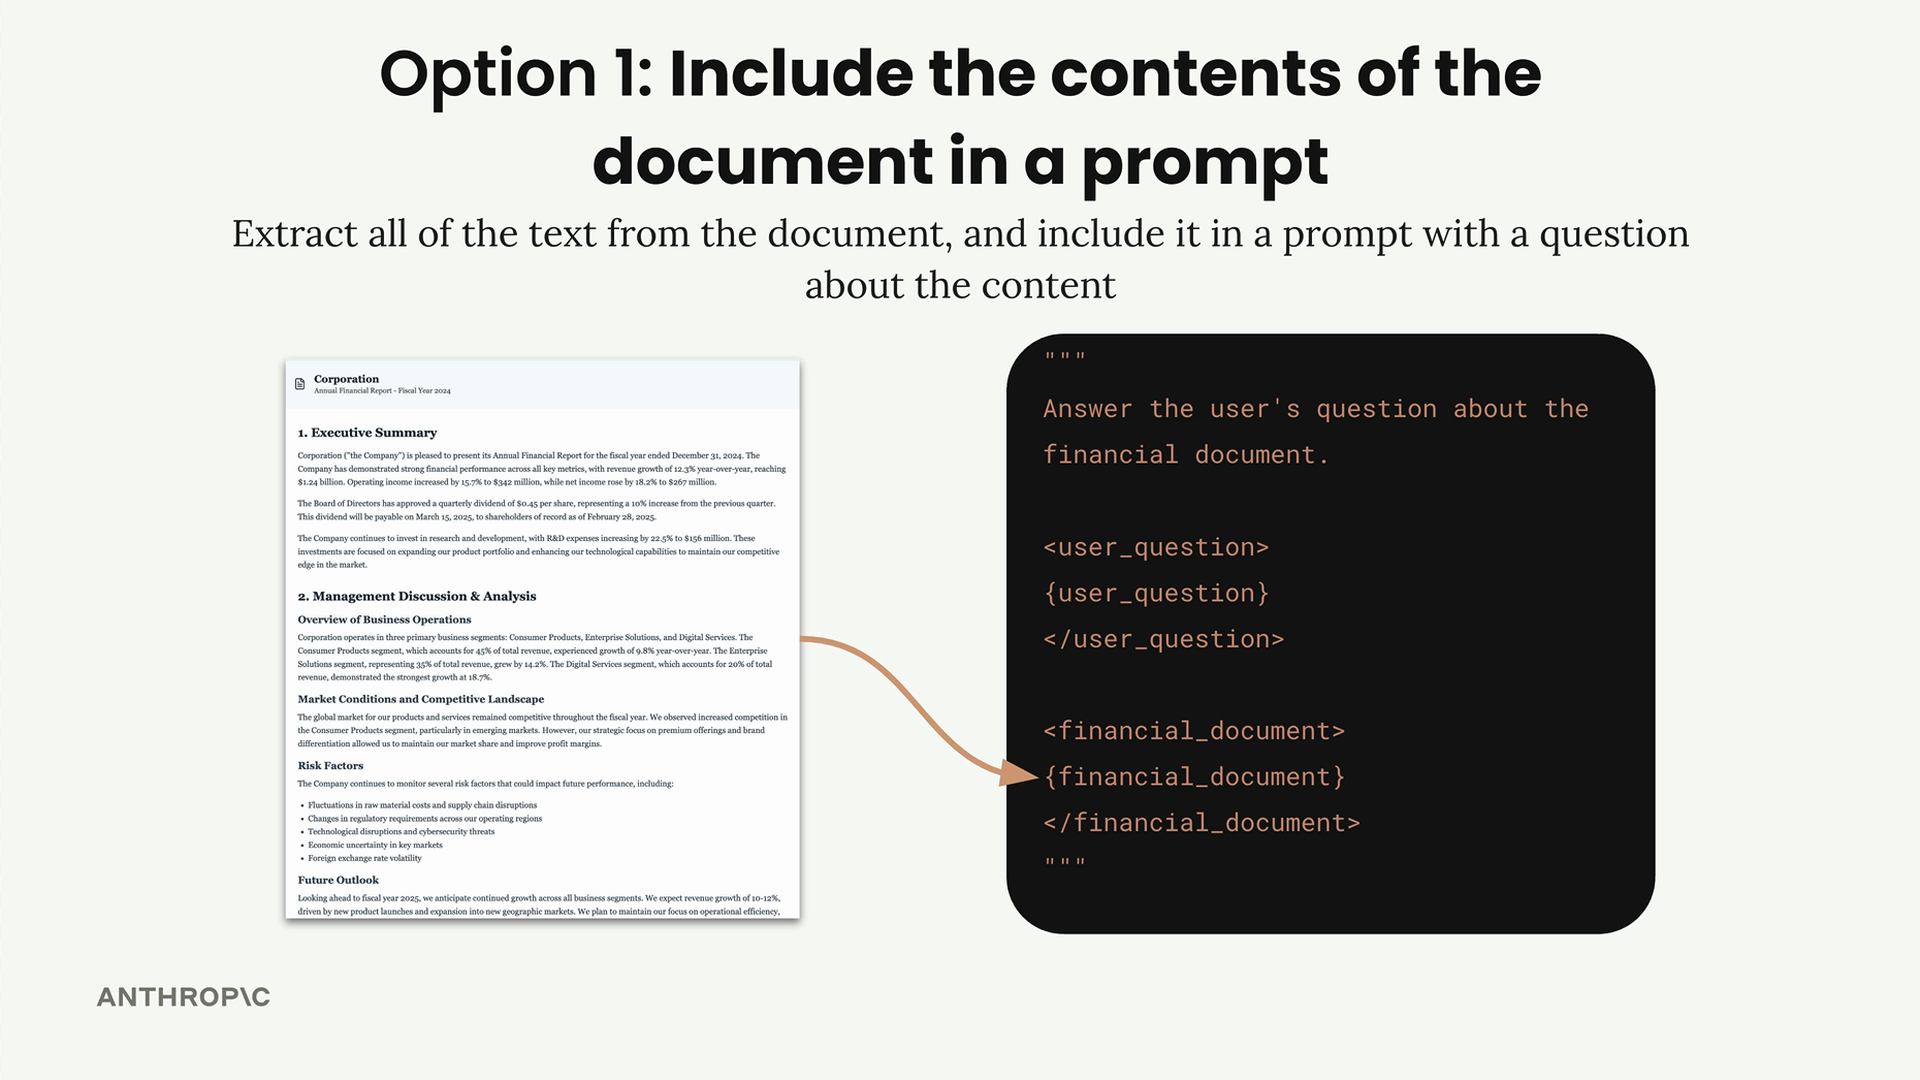
この方法には深刻な制限があります。
- 厳格なトークン制限があるため、非常に長いドキュメントは単純に収まりません
- Claudeは非常に長いプロンプトでは効果が低下します
- プロンプトが大きくなるほどコストがかかり、処理時間も長くなります
- 精査すべき情報が多すぎると、パフォーマンスが低下します
オプション2: ドキュメントをチャンクに分割する
RAGは、ドキュメントを事前に管理しやすい断片に処理しておき、質問ごとに関連するチャンクだけを取得するという、よりスマートなアプローチを取ります。
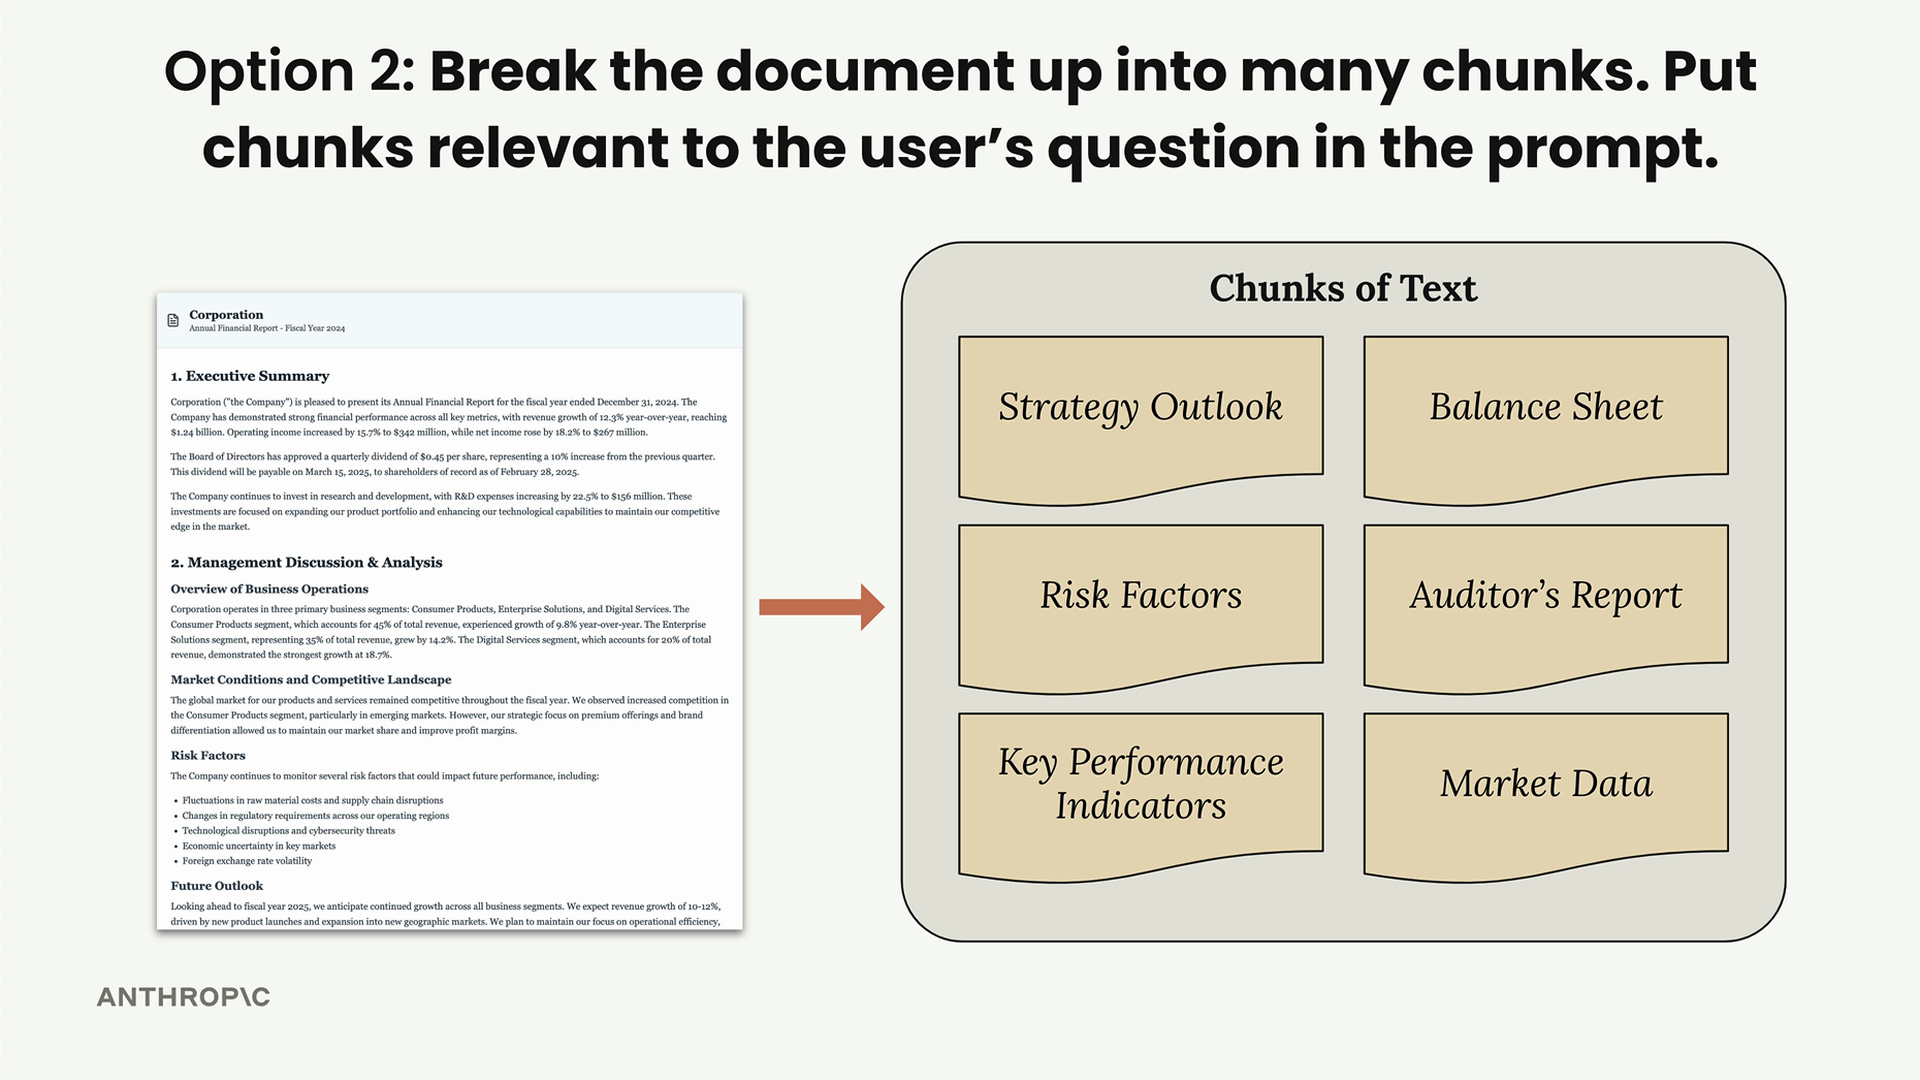
その仕組みは次のとおりです。
- ドキュメントをより小さなチャンク(戦略の見通し、リスク要因、貸借対照表など)に分割する
- ユーザーが質問をしたら、その人が何を求めているかを分析する
- その質問に最も関連性の高いチャンクを見つける
- それらの関連するチャンクだけをClaudeへのプロンプトに含める
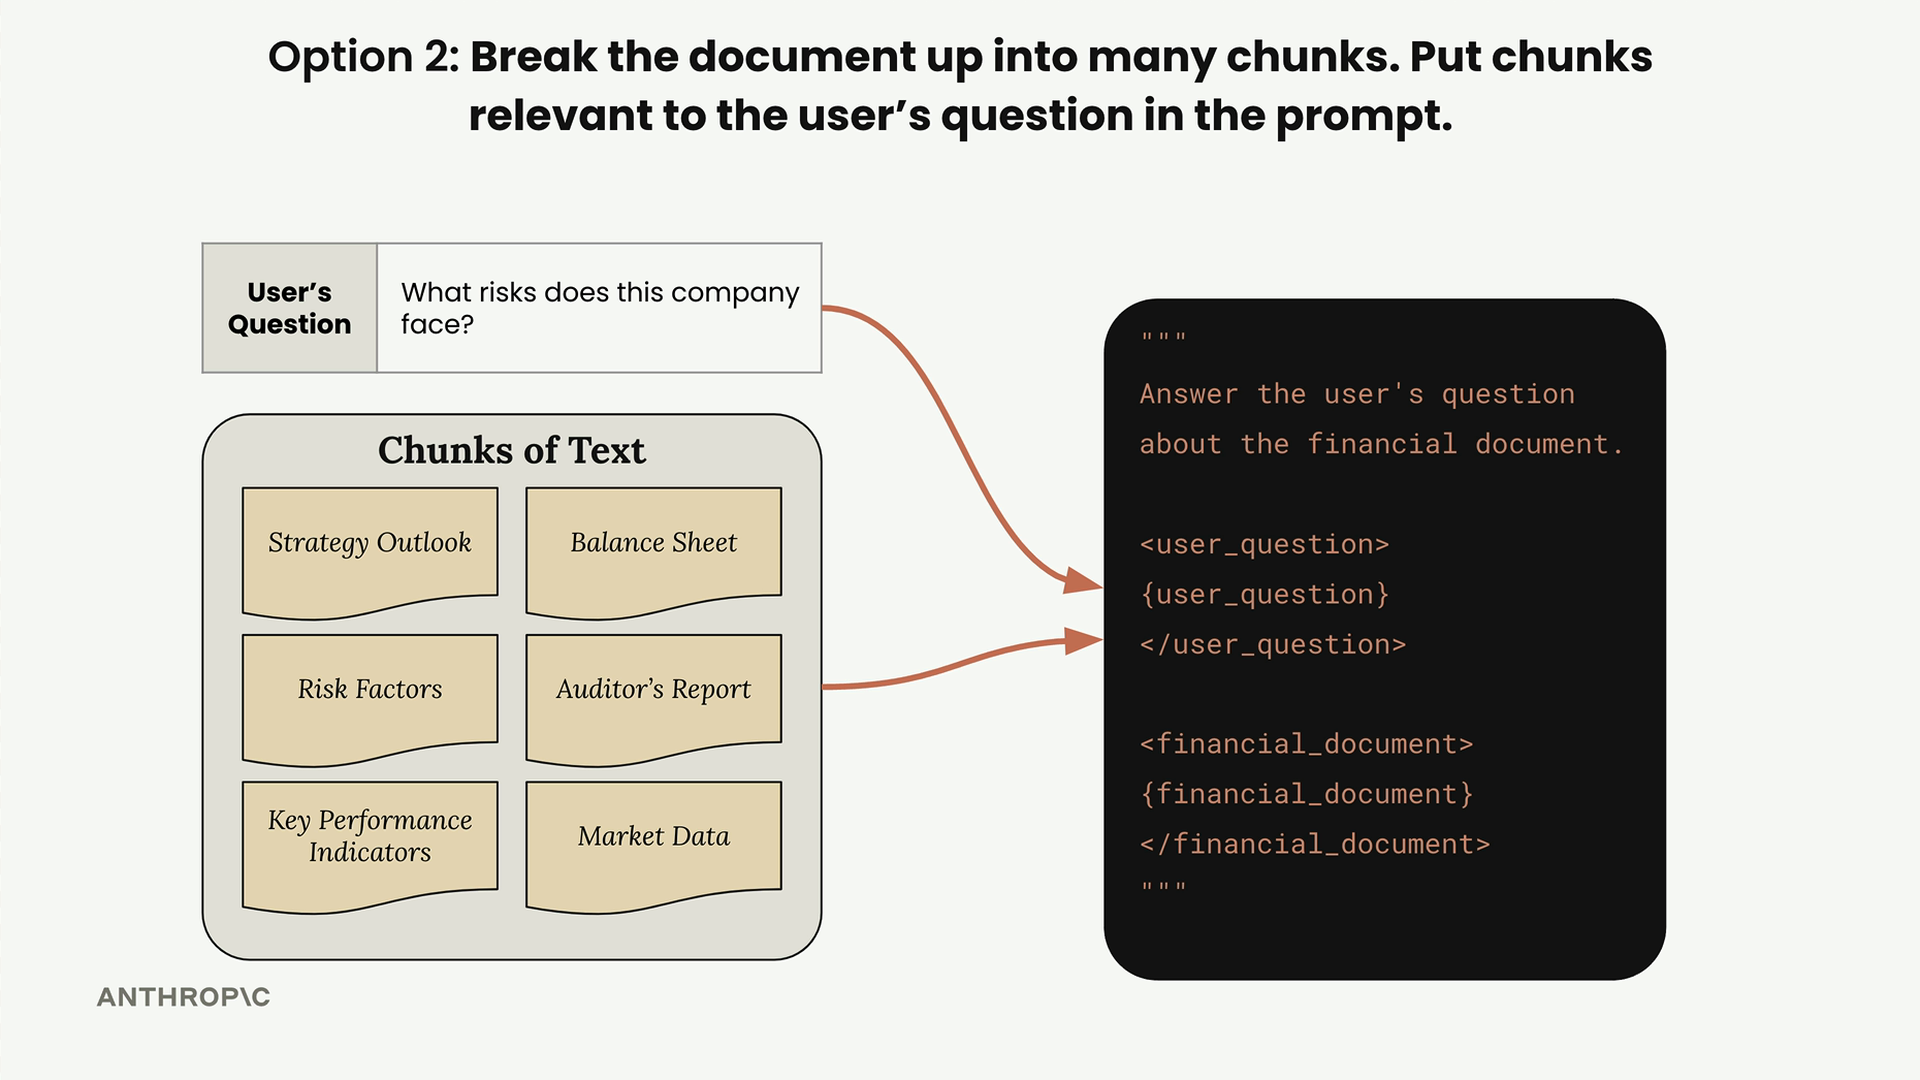
会社のリスクに関する質問であれば、システムは「リスク要因」のチャンクを特定して取得し、ドキュメント全体ではなく、焦点を絞った関連性の高いコンテキストをClaudeに与えます。
RAGのメリット
- Claudeは最も関連性の高いコンテンツだけに集中できる
- 非常に大きなドキュメントや複数のドキュメントにも拡張できる
- 単一のファイルだけでなく、ドキュメントのコレクション全体で機能する
- プロンプトが小さくなることで、処理が速くなりコストも下がる
RAGの課題
RAGは管理すべき複雑さをもたらします。
- ドキュメントをチャンク化するための前処理ステップが必要
- 関連するチャンクを見つけるための検索の仕組みが必要
- 取得したチャンクに必要なコンテキストがすべて含まれているとは限らない
- テキストをチャンク化する方法は数多くあり、どのアプローチが最適かを見極める必要がある
ドキュメントは、均等な分量ごと、見出しやセクションごと、意味的なまとまりごと、あるいは他の戦略によってチャンク化できます。それぞれのアプローチにはトレードオフがあり、自分のユースケースに合わせて評価する必要があります。
RAGを使うべき場面
RAGは、大きなドキュメントやドキュメントのコレクションを扱っていて、ユーザーがコンテンツの一部だけを必要とする具体的な質問をする場合に真価を発揮します。1つのプロンプトに収まる範囲を超えて拡張する必要があるとき、より速い応答を求めるとき、あるいは多数のクエリにわたってコストを管理する必要があるときには、前処理の複雑さに見合う価値があります。
重要なのは、チャンク化、検索、取得を実装する技術的なオーバーヘッドが、特定のアプリケーションにとって見合うものかどうかを分析することです。場合によっては「すべてをプロンプトに詰め込む」というシンプルなアプローチでうまくいくこともあれば、システムを実用的で高性能なものにするためにRAGが不可欠になることもあります。