ドキュメントをチャンクに分割した後、RAGパイプラインの次のステップは、ユーザーの質問にどのチャンクが最も関連しているかを見つけることです。これは本質的に検索の問題であり、すべてのテキストチャンクを調べて、ユーザーが尋ねている内容に関連するものを特定する必要があります。
関連するチャンクを見つける
課題は、どのチャンクがユーザーの質問に「関連している」かを判断することです。これはキーワードマッチングほど単純ではなく、質問とチャンクの両方の意味と文脈を理解する必要があります。
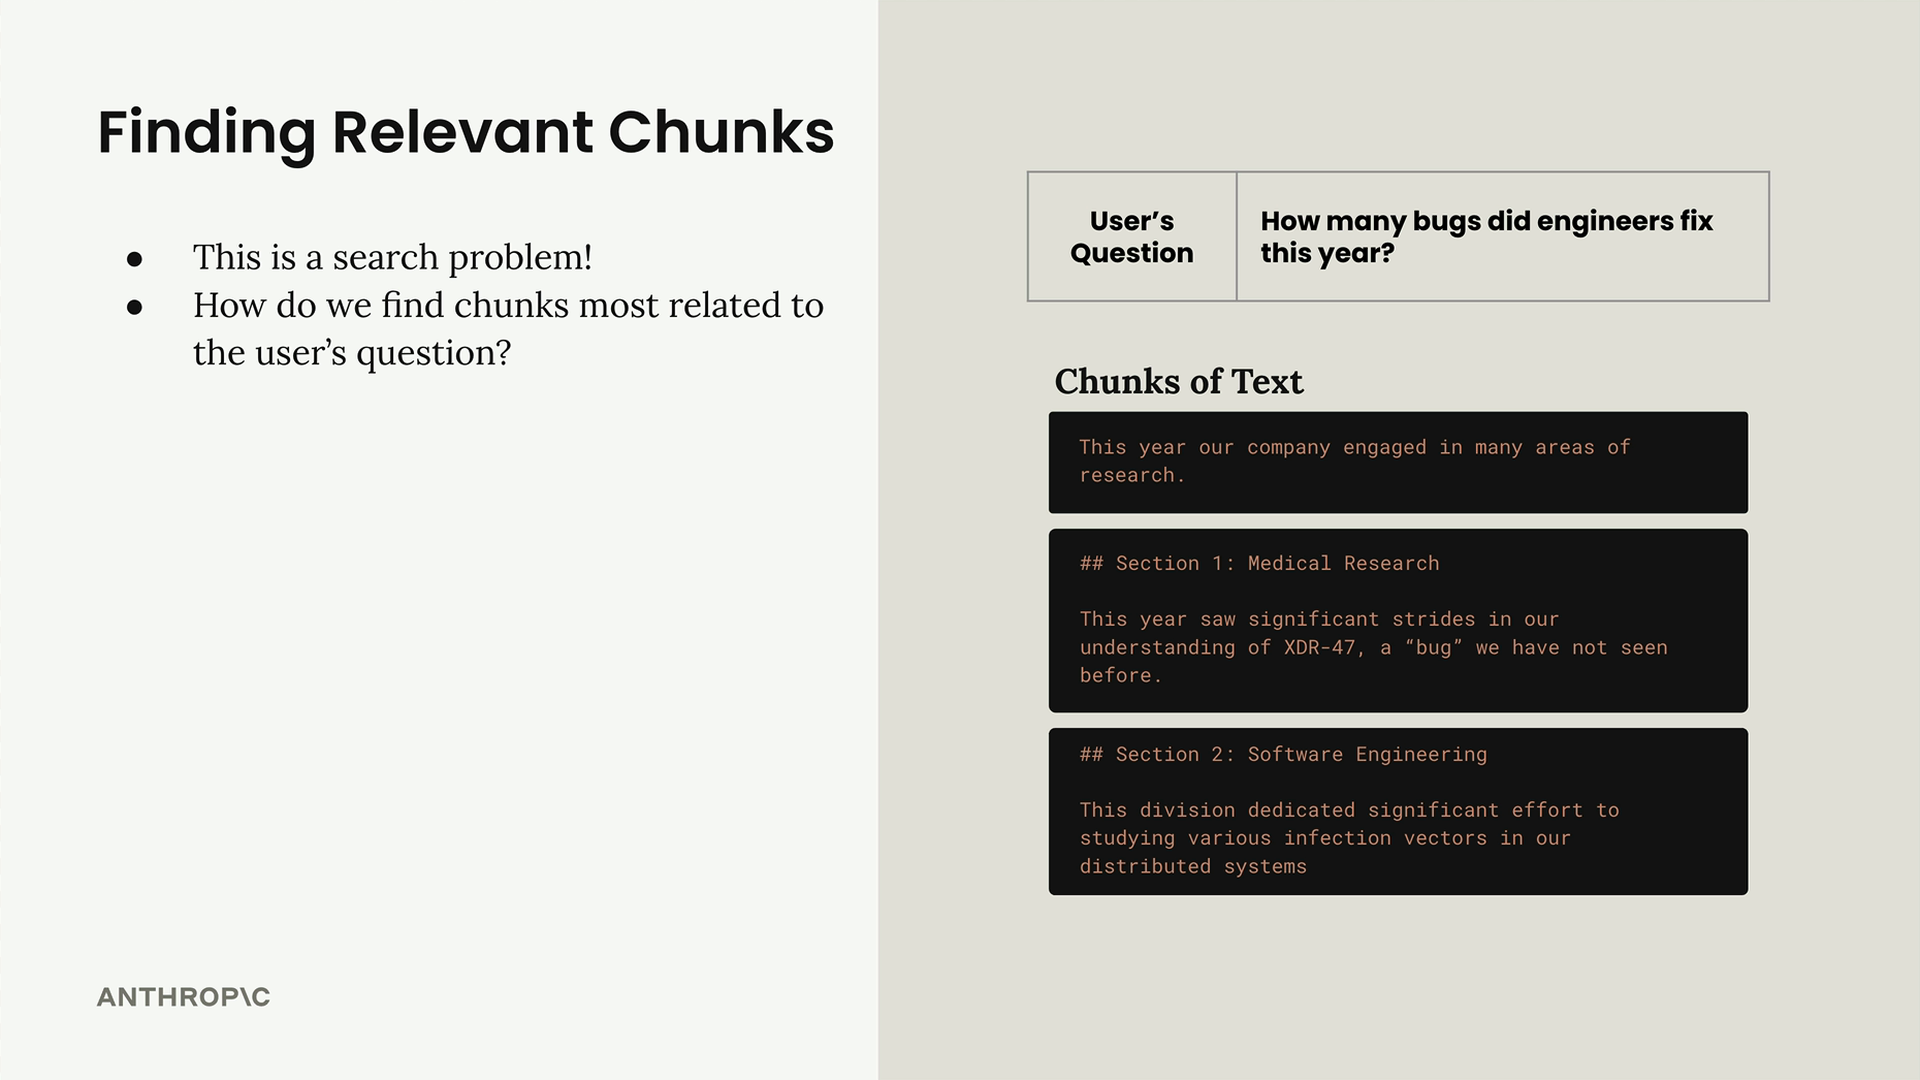
最も一般的な解決策はセマンティック検索であり、これはテキスト埋め込みを使用して、単に正確な単語の一致を探すのではなく、各テキストが実際に何について述べているかを理解します。
テキスト埋め込みとは?
テキスト埋め込みとは、あるテキストに含まれる意味を数値で表現したものです。単語や文を、コンピューターが数学的に処理できる形式に変換したものと考えてください。
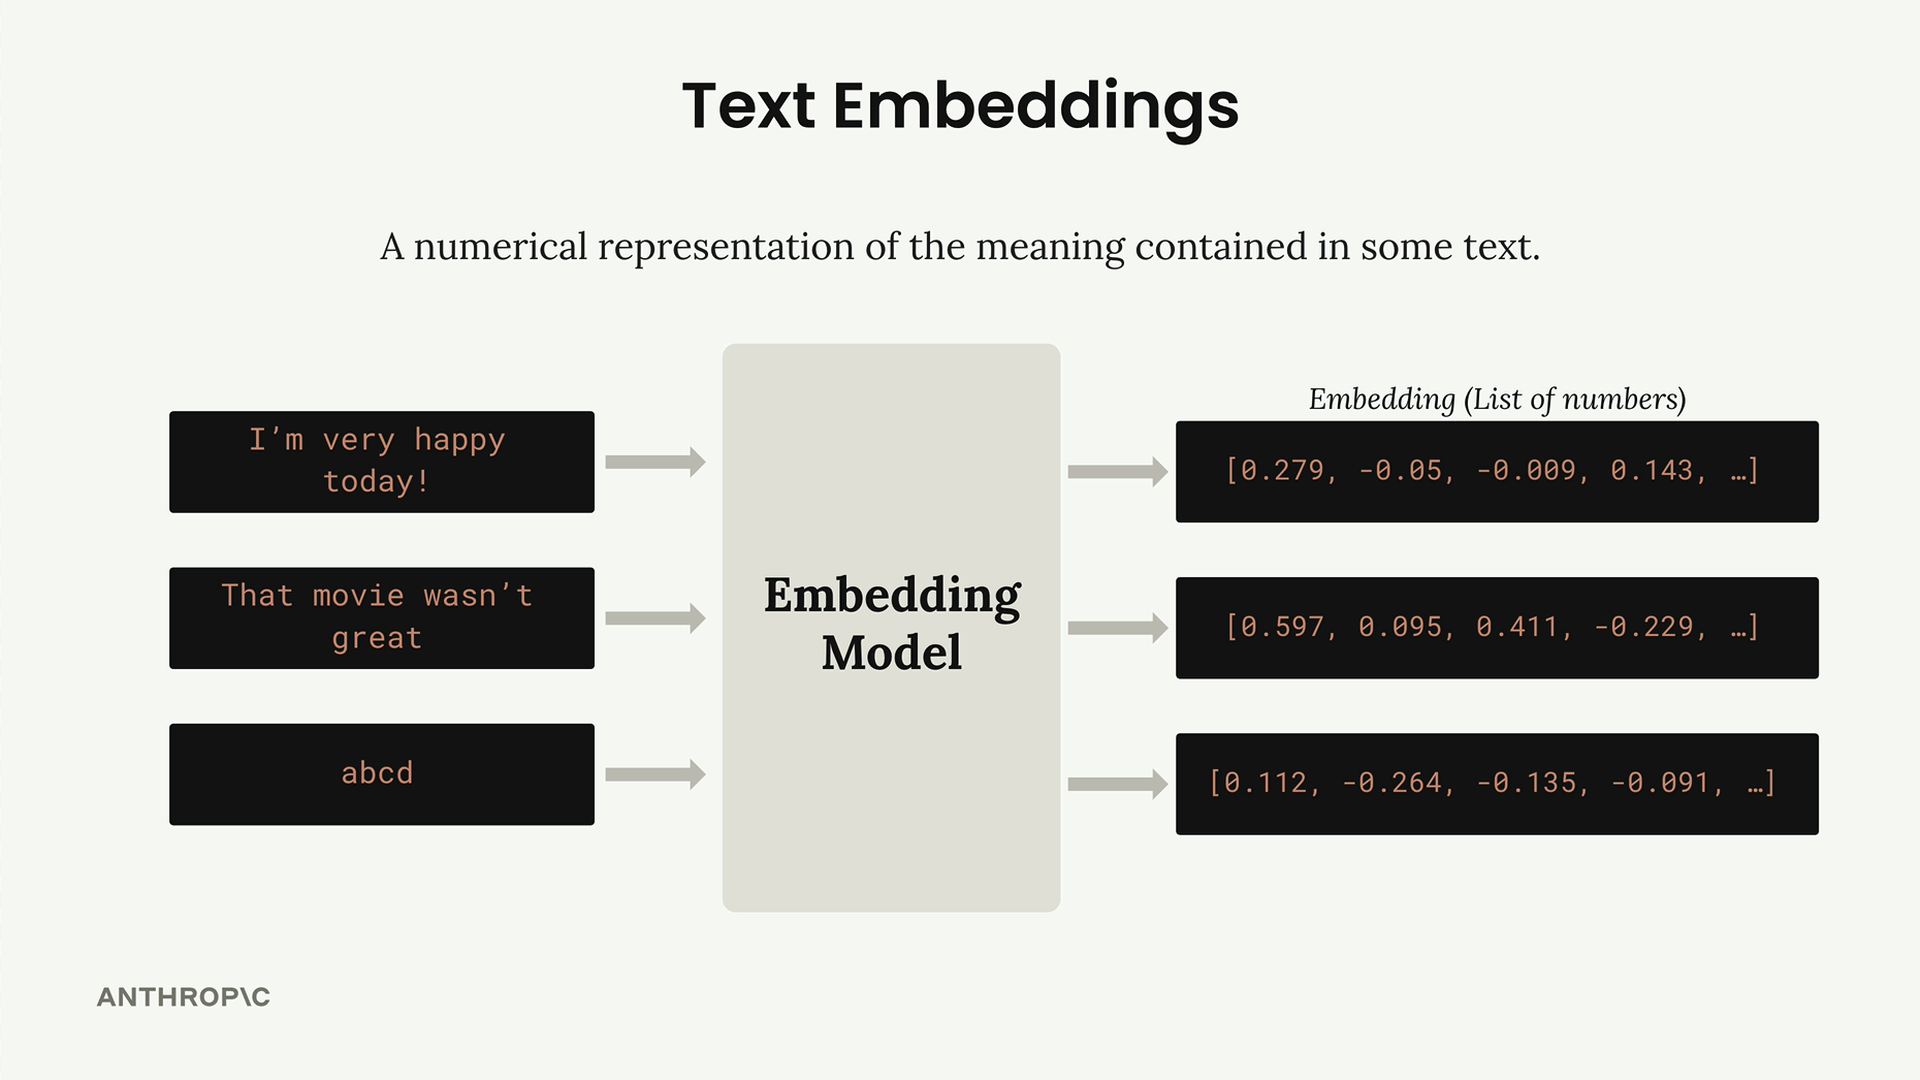
仕組みは次のとおりです。
- テキストを埋め込みモデルに入力します
- モデルは長い数値のリスト(通常は1024個の数値)を出力します
- 各数値は、入力テキストの何らかの性質に対する「スコア」を表します
- 数値の範囲は-1から+1です
数値の理解
埋め込み内の各数値は、テキストの何らかの側面に対するスコアのようなものです。各位置が正確に何を表しているかはわかりませんが、さまざまな性質を測定していると考えると理解しやすくなります。
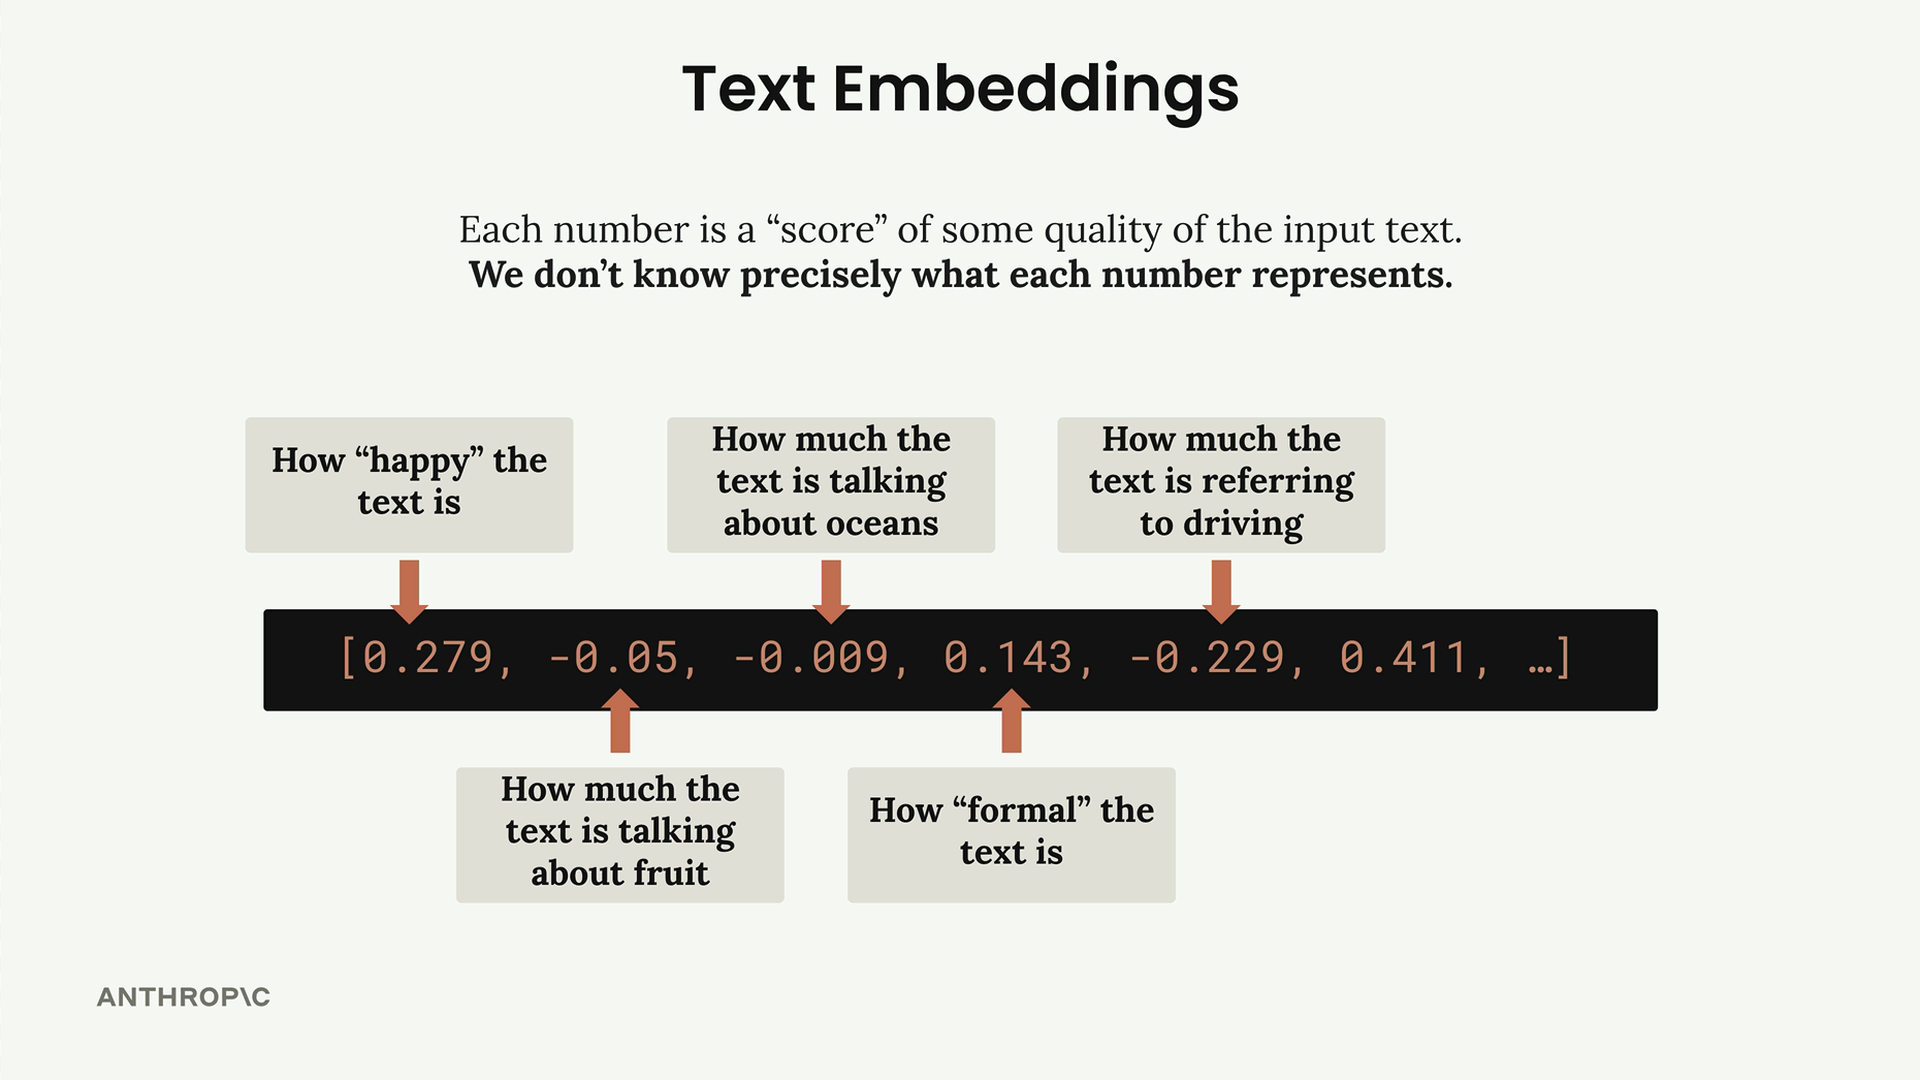
例えば、ある数値は「テキストがどれくらい幸せな内容か」をスコア化し、別の数値は「テキストがどれくらい海について語っているか」を測定しているかもしれません。重要なのは、各数値が何を表しているのかは実際にはわからないということです。埋め込みモデルは訓練中にこれらのパターンを学習しますが、それらは人間には解釈できません。
コードで埋め込みを生成する
埋め込みの作成は簡単です。基本的な手順は次のとおりです。
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
このテキストチャンクに対してこの関数を実行すると、そのテキストの意味的な意味を表す1024個の数値のリストが返されます。
AWS Bedrockコンソールで、Titan埋め込みモデルへのアクセスをリクエストする必要がある場合があることに注意してください。バージョン2が利用できない場合、学習目的であればバージョン1でも同様に機能します。
RAGにとって埋め込みが重要な理由
埋め込みの力は、類似したテキストは類似した埋め込み値を持つことに気づいたときに明らかになります。つまり、たとえ全く同じ単語を共有していなくても、ユーザーの質問をドキュメントのチャンクと数学的に比較し、最も意味的に類似したものを見つけることができるのです。
この数値表現こそが、セマンティック検索を可能にし、RAGシステムにおいて関連するコンテキストを見つける上で、単純なキーワードマッチングよりもはるかに効果的なものにしているのです。