プロンプト評価ワークフローを構築する際、グレーダー(採点者)は出力品質について客観的な信号を提供します。グレーダーはモデルの出力を受け取り、何らかの測定可能なフィードバックを返します。通常は1から10の数値で、10が高品質、1が低品質を表します。
グレーダーの種類
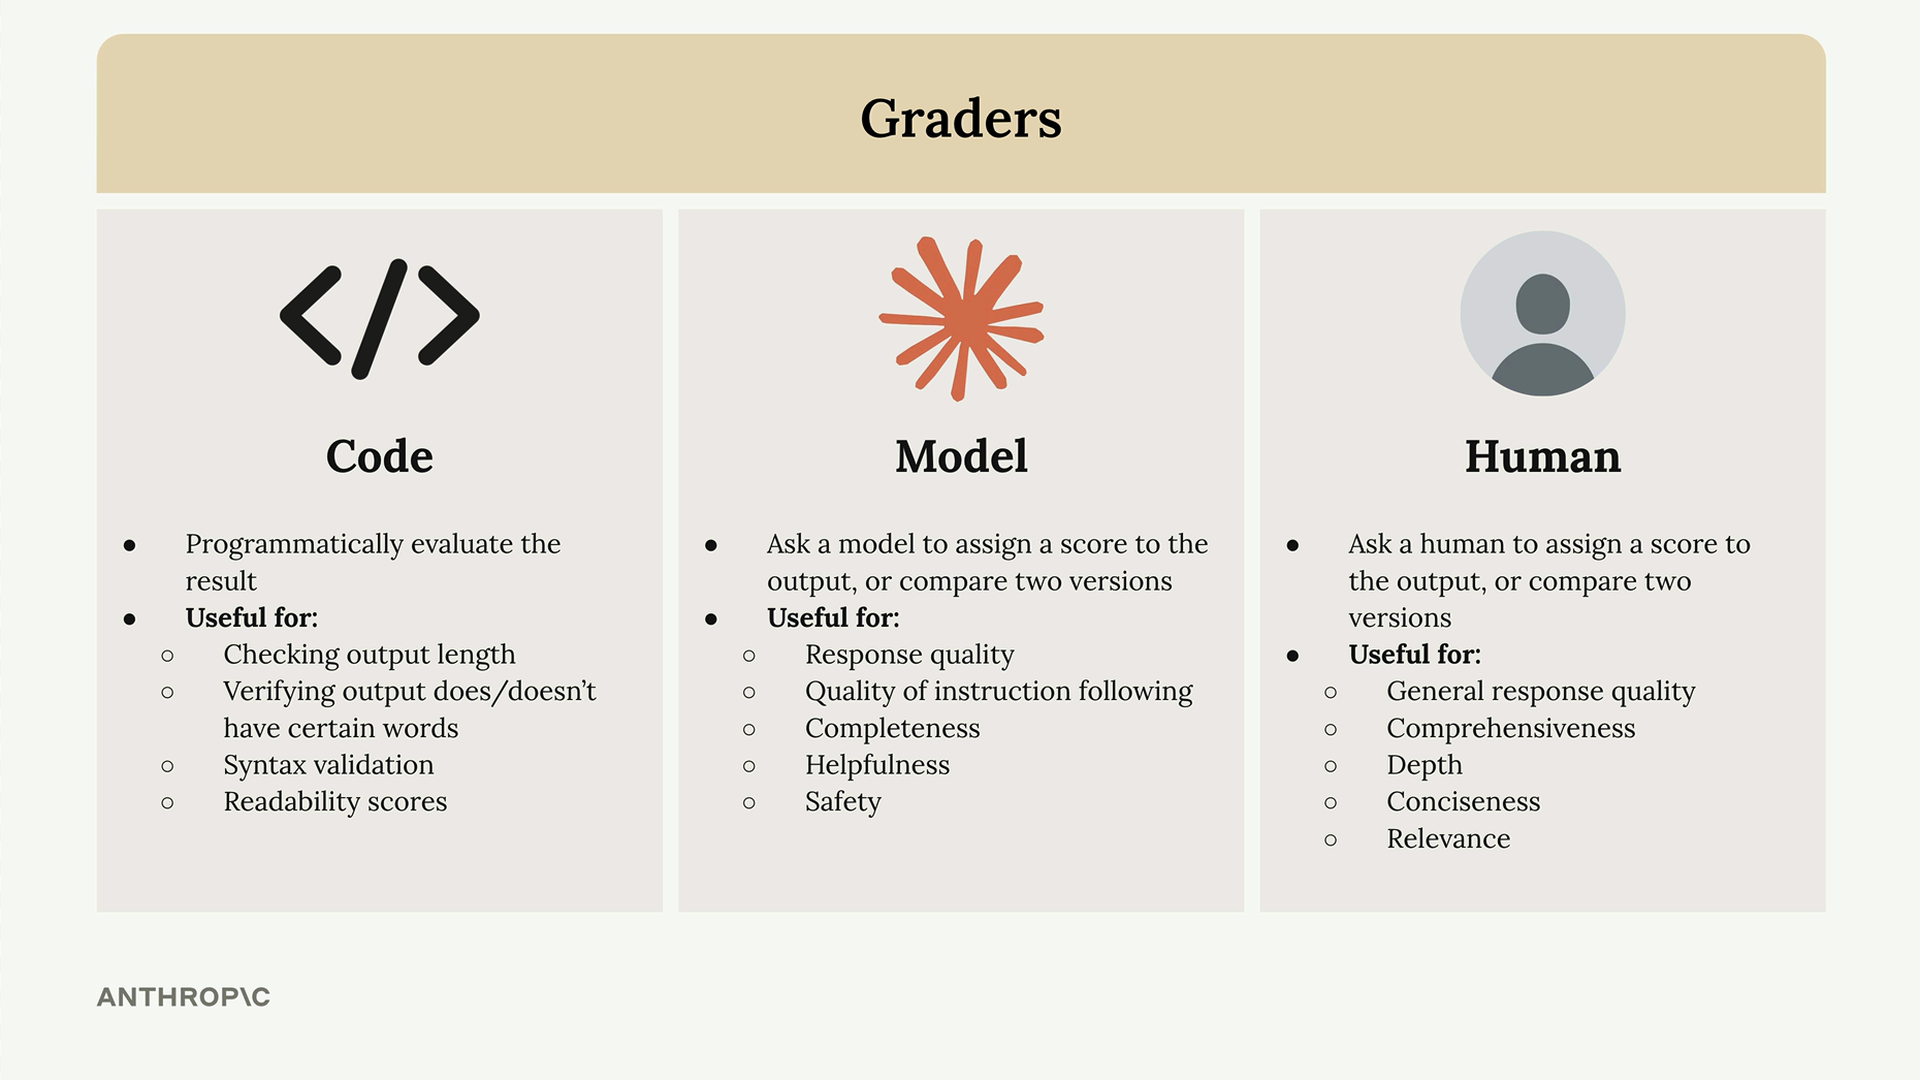
モデルの出力を採点するには、主に3つのアプローチがあります。
- コードグレーダー - カスタムロジックを使用して出力をプログラム的に評価する
- モデルグレーダー - 別のAIモデルを使用して品質を評価する
- 人間グレーダー - 人が手動で出力をレビューし、採点する
コードグレーダー
コードグレーダーを使用すると、考えられるあらゆるプログラム的チェックを実装できます。一般的な用途には以下が含まれます。
- 出力の長さを確認する
- 出力に特定の単語が含まれているか/含まれていないかを検証する
- JSON、Python、または正規表現の構文検証
- 読みやすさのスコア
唯一の要件は、コードが実行時に何らかの測定可能な信号を返すことです。
モデルグレーダー
モデルグレーダーは、元の出力を評価するために追加のAPIリクエストを行います。このアプローチは、以下を評価する上で非常に高い柔軟性を提供します。
- 応答の品質
- 指示への従い方の品質
- 完全性
- 有用性
- 安全性
人間グレーダー
人間グレーダーは最も高い柔軟性を提供しますが、時間がかかり、面倒です。以下を評価する際に有用です。
- 全体的な応答の品質
- 網羅性
- 深さ
- 簡潔さ
- 関連性
評価基準の定義
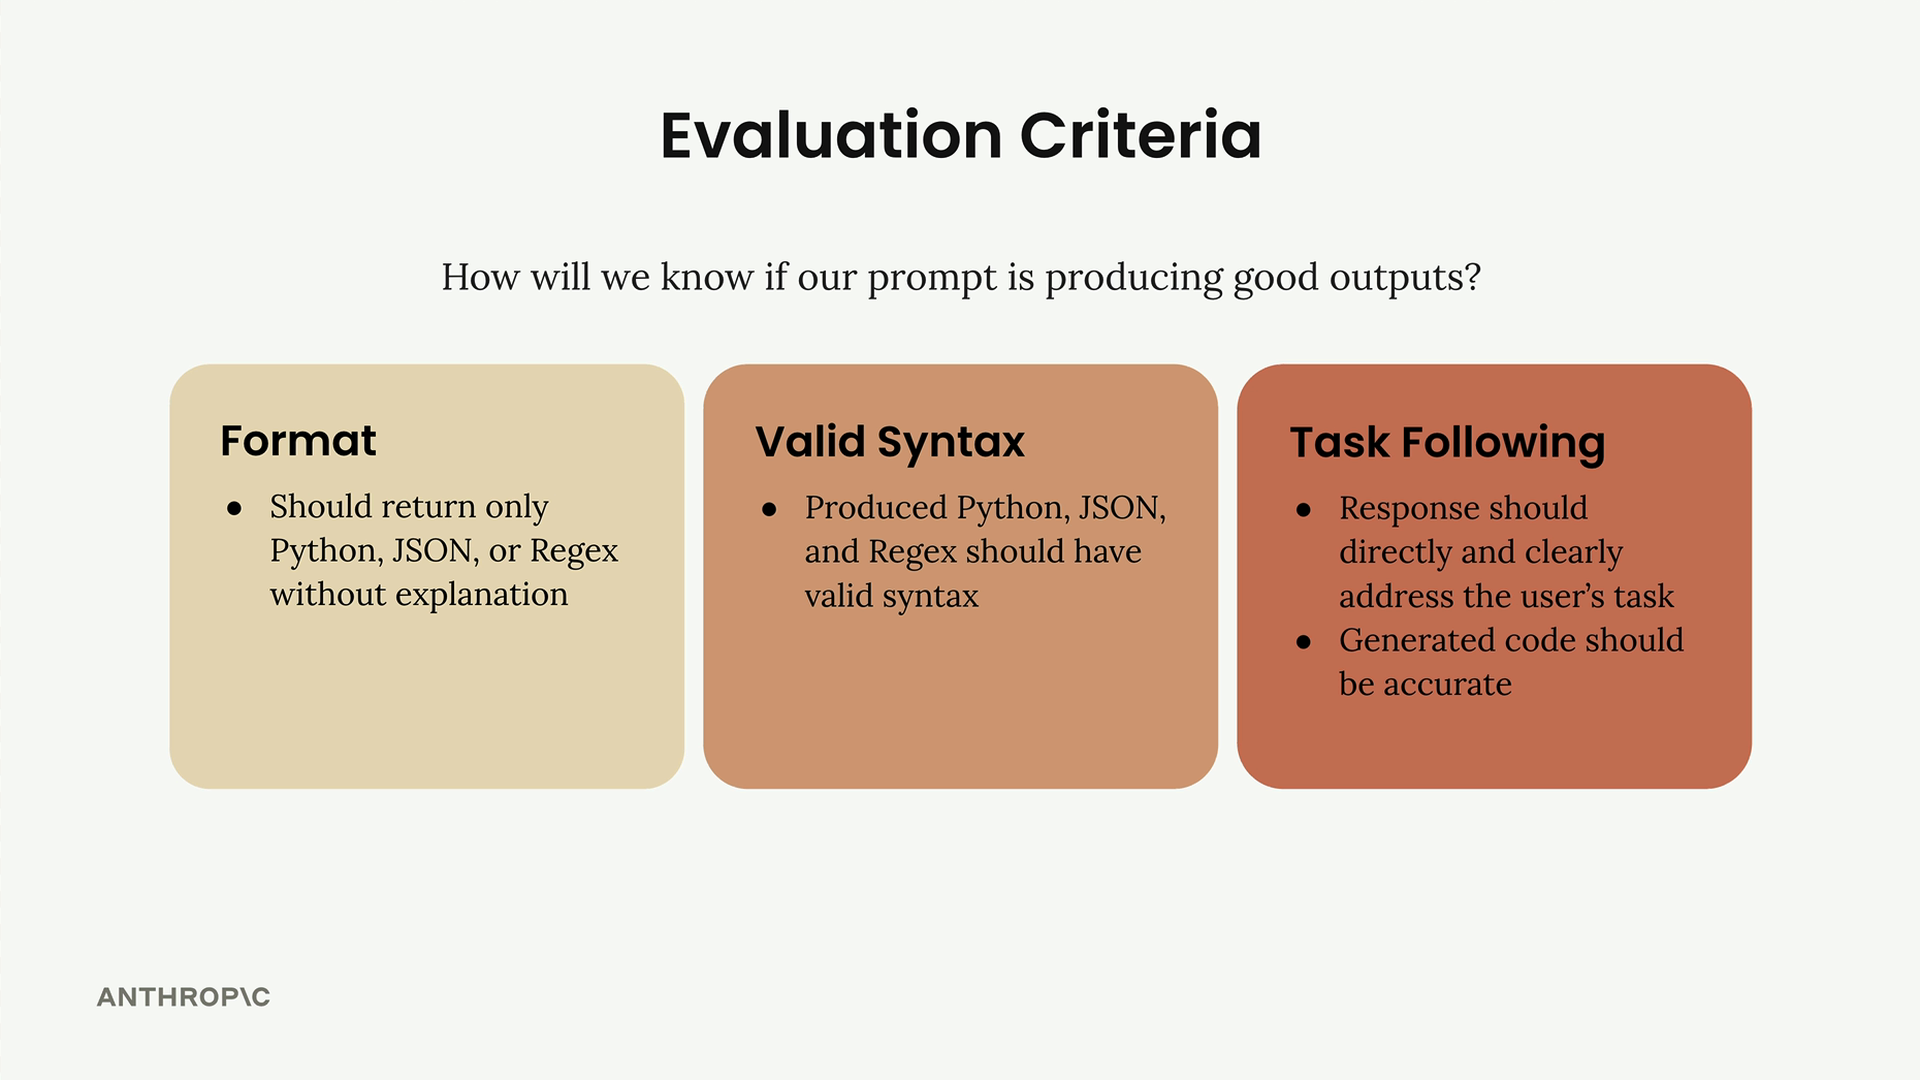
グレーダーを実装する前に、明確な評価基準が必要です。コード生成プロンプトの場合、以下に焦点を当てることが考えられます。
- フォーマット - 説明なしでPython、JSON、または正規表現のみを返すべき
- 有効な構文 - 生成されたコードは有効な構文を持つべき
- タスクの遵守 - 応答はユーザーのタスクに正確なコードで直接対応するべき
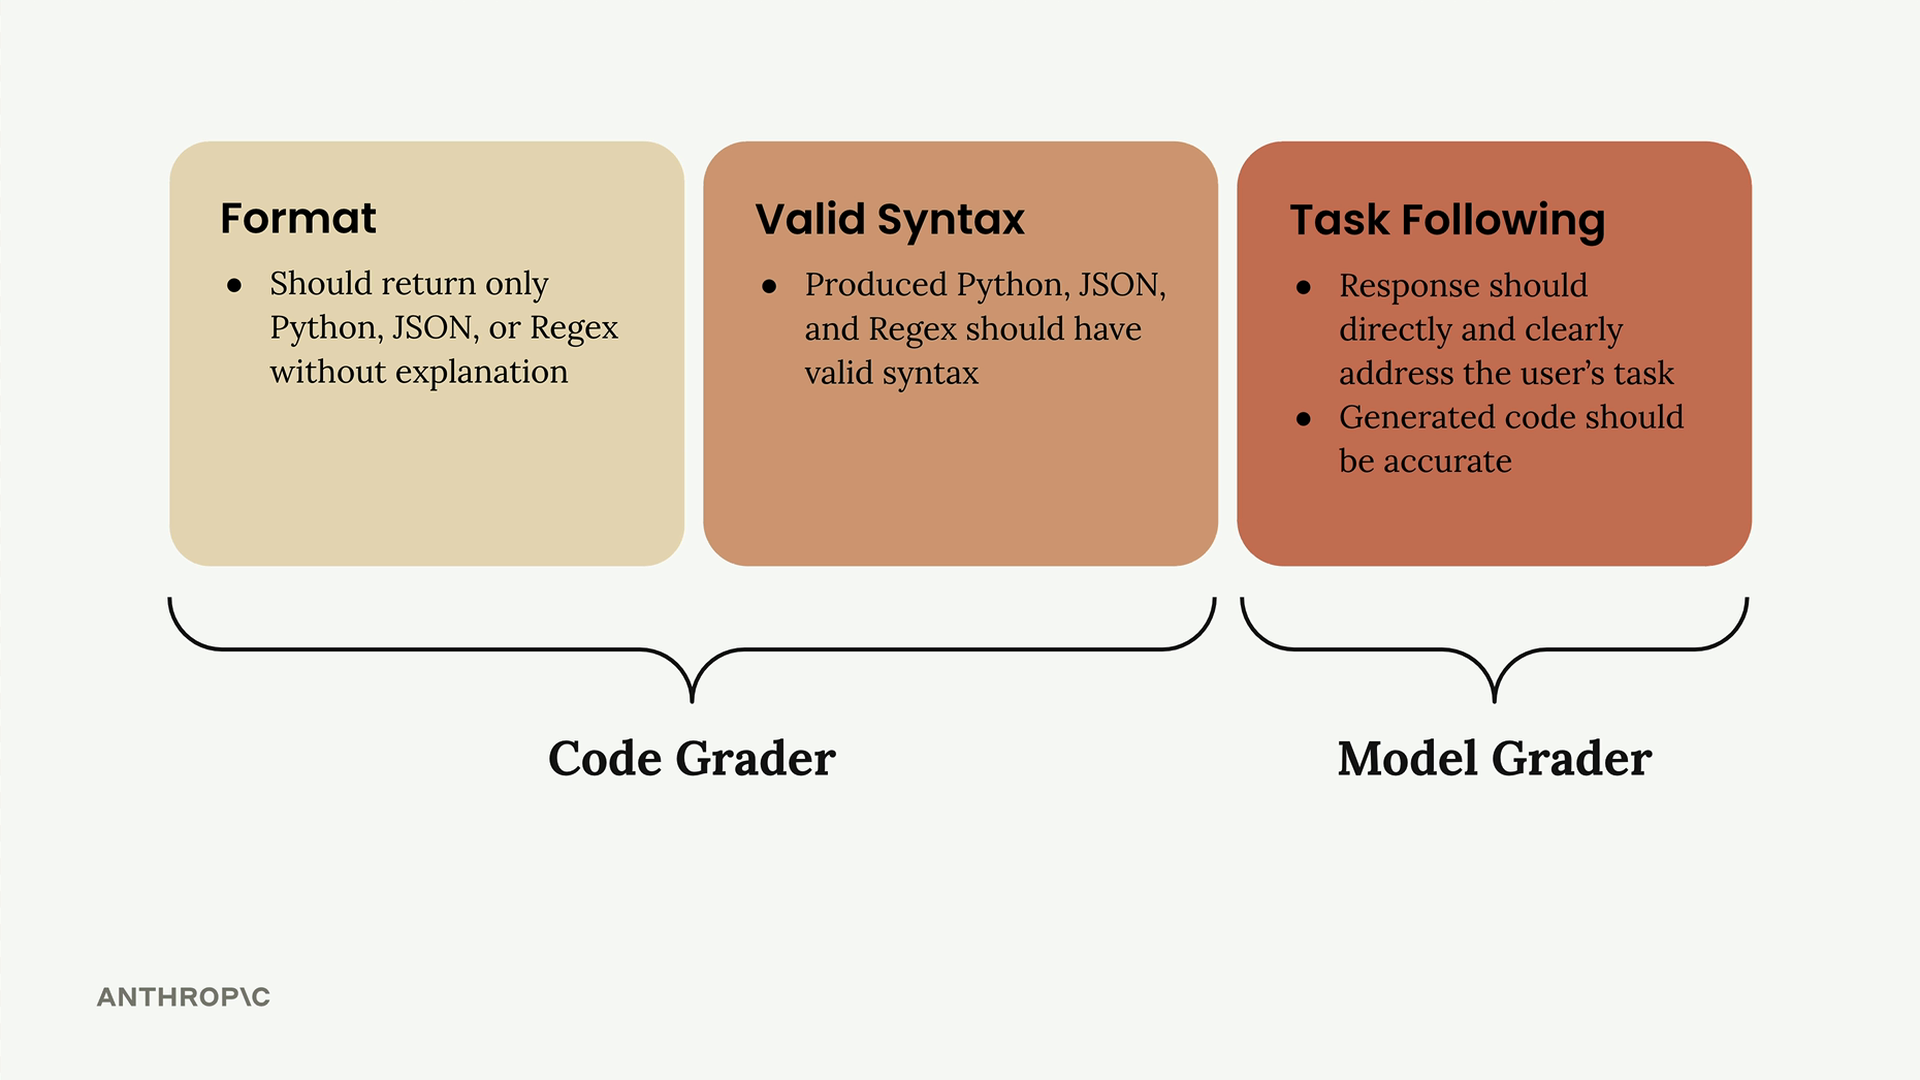
最初の2つの基準はコードグレーダーとうまく機能しますが、タスクの遵守はその柔軟性のためモデルグレーダーの方が適しています。
モデルグレーダーの実装
モデルグレーダー関数を構築する方法は以下の通りです。
def grade_by_model(test_case, output):
    # 評価プロンプトを作成
    eval_prompt = """
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {task}
    Solution: {solution}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
主要な洞察は、スコアと共に強み、弱み、および推論を求めることです。このコンテキストがないと、モデルはスコアを6前後の中間的な値にデフォルトで設定する傾向があります。 ## グレーダーの統合 テストケース関数を更新して、モデルグレーダーを使用します。 ``` def run_test_case(test_case): output = run_prompt(test_case) # Get model evaluation model_grade = grade_by_model(test_case, output) score = model_grade["score"] reasoning = model_grade["reasoning"] return \{ "output": output, "test_case": test_case, "score": score, "reasoning": reasoning \} ``` `` ## 平均スコアの計算 全体的なパフォーマンス指標を得るには、すべてのテストケースにわたる平均スコアを計算します。 ``` from statistics import mean def run_eval(dataset): results = [] for test_case in dataset: result = run_test_case(test_case) results.append(result) average_score = mean([result["score"] for result in results]) print(f"Average score: \{average_score\}") return results ``` ` これにより、プロンプトのパフォーマンスを時間の経過とともに追跡するための、具体的で客観的な指標が得られます。モデルグレーダーは多少一貫性に欠ける場合がありますが、プロンプトを体系的に測定し改善するための出発点を提供します。 ` ``