ドキュメントをチャンクに分割した後、RAGパイプラインの次のステップは、どのチャンクがユーザーの質問に最も関連しているかを見つけることです。これは本質的に検索の問題です。つまり、すべてのテキストチャンクを調べて、ユーザーが尋ねている内容に関連するものを特定する必要があります。
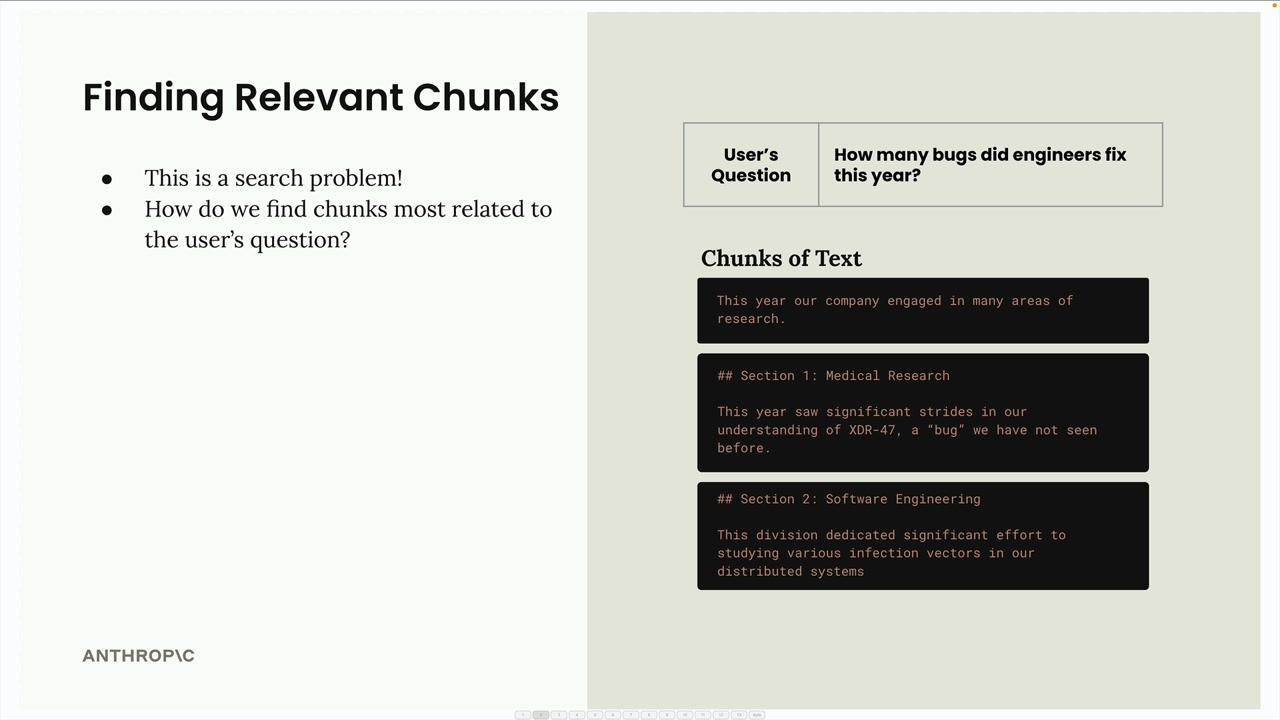
セマンティック検索
関連するチャンクを見つけるための最も一般的なアプローチはセマンティック検索です。正確な単語の一致を探すキーワードベースの検索とは異なり、セマンティック検索はテキスト埋め込みを使用して、ユーザーの質問と各テキストチャンクの両方の意味と文脈を理解します。
テキスト埋め込み
テキスト埋め込みとは、あるテキストに含まれる意味の数値表現です。単語や文章を、コンピューターが数学的に扱える形式に変換したものだと考えてください。
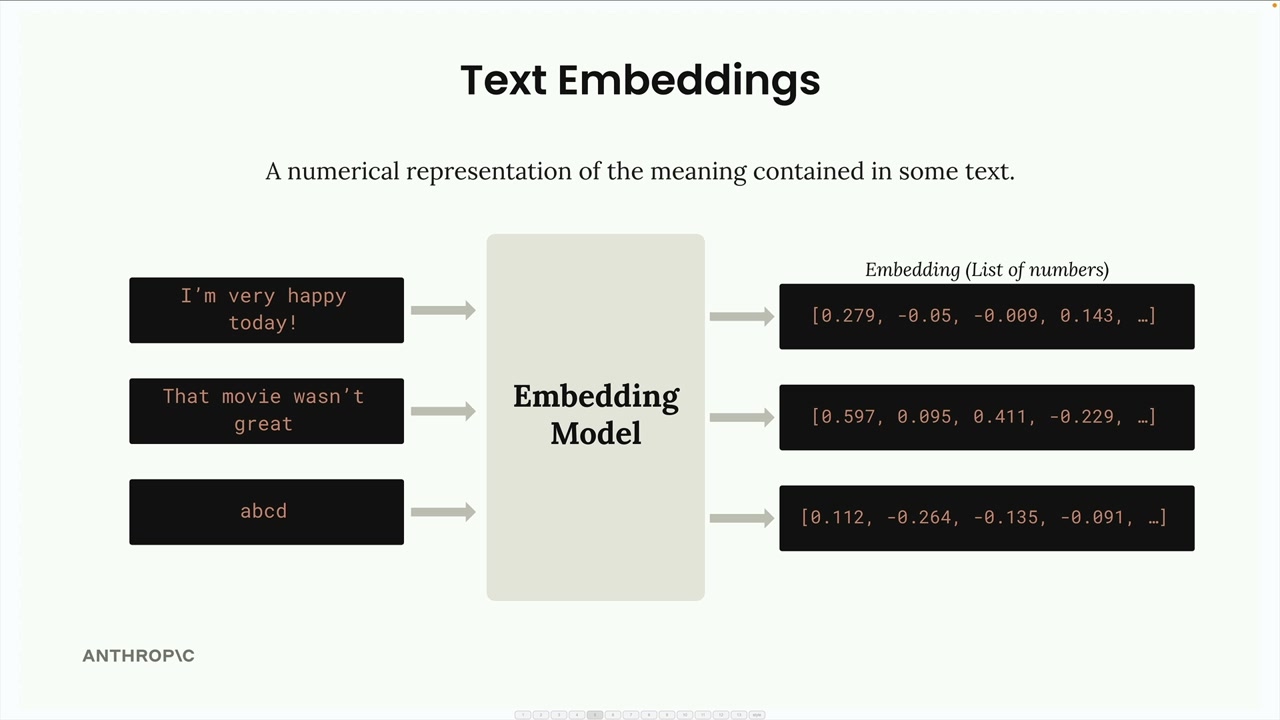
このプロセスの仕組みは次のとおりです。
- テキストを埋め込みモデルに入力します
- モデルは数値の長いリスト(埋め込み)を出力します
- 各数値は-1から+1の範囲です
- これらの数値は、入力テキストのさまざまな性質や特徴を表します
数値の理解
埋め込みの中の各数値は、基本的に入力テキストの何らかの性質に対する「スコア」です。ただし、ここで重要な注意点があります。各数値が正確に何を表しているのかは分かっていません。
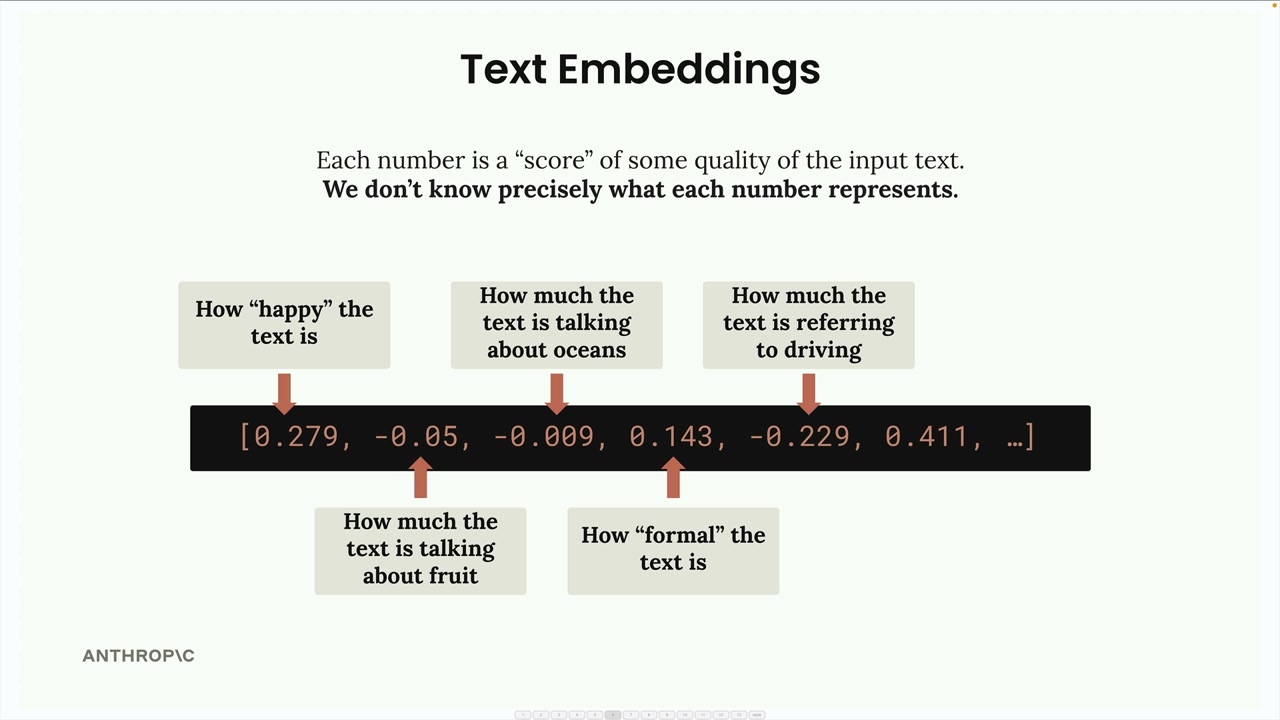
ある数値が「テキストがどれだけ幸せそうか」や「テキストがどれだけ海について語っているか」を表していると想像するのは役に立ちますが、これらはあくまで概念的な例にすぎません。各次元の実際の意味はモデルが訓練中に学習するものであり、人間が直接解釈できるものではありません。
埋め込みのためのVoyageAI
Anthropicは現在、埋め込み生成を提供していないため、推奨されるプロバイダーはVoyageAIです。次の作業が必要です。
- VoyageAIの別アカウントにサインアップする
- APIキーを取得する(開始するのは無料です)
- 環境変数にキーを追加する
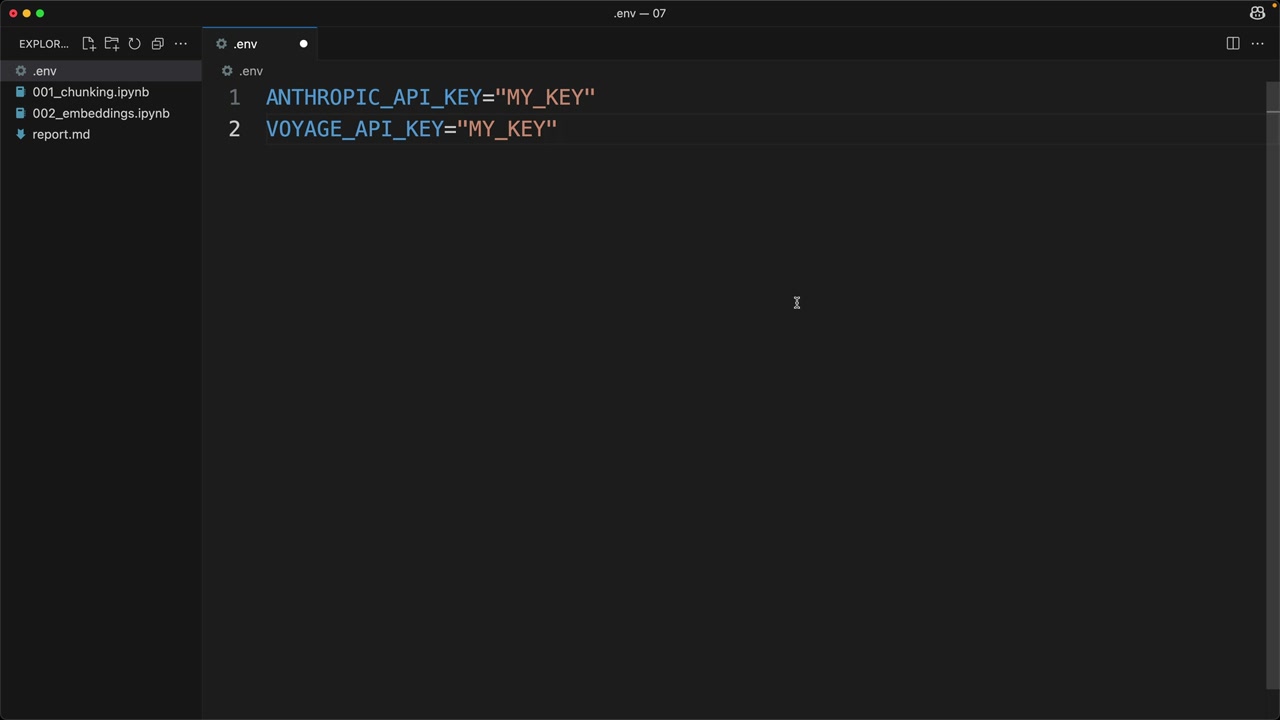
.envファイルに、以下を追加します。
VOYAGE_API_KEY="your_key_here"実装
まず、VoyageAIライブラリをインストールします。
%pip install voyageai次に、クライアントをセットアップし、埋め込みを生成する関数を作成します。
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]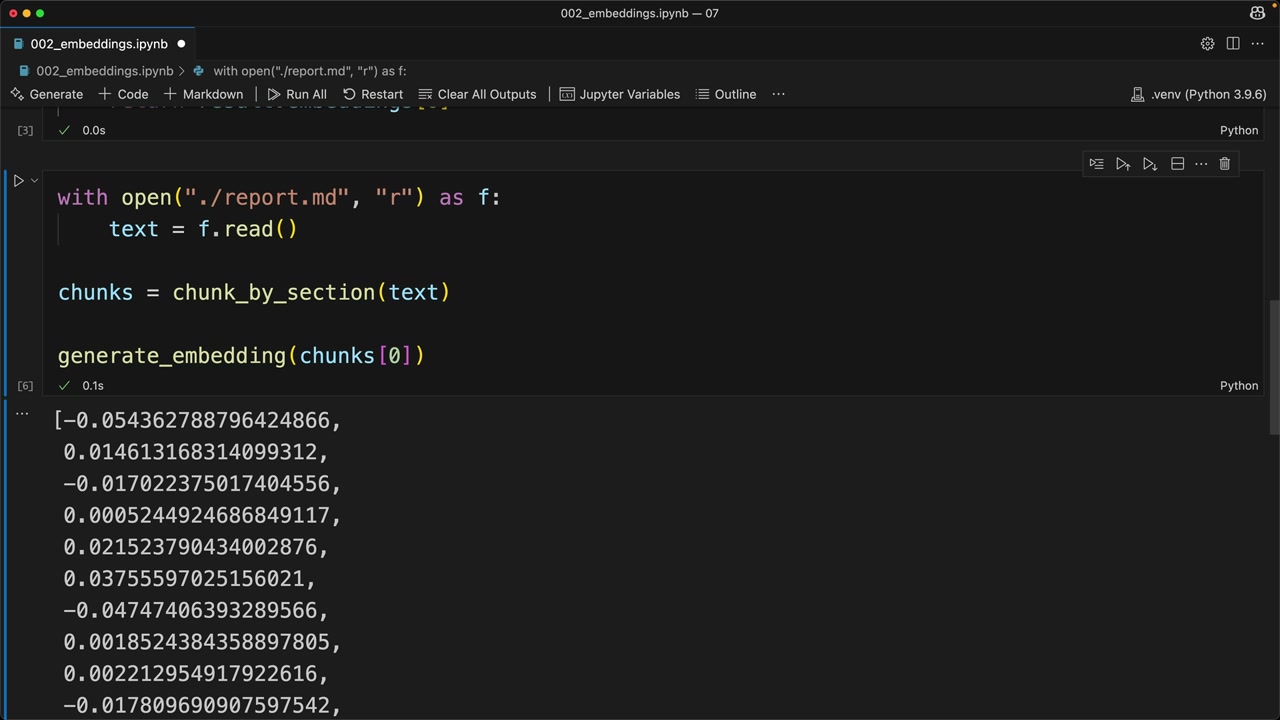
この関数をテキストチャンクに対して実行すると、埋め込みを表す浮動小数点数のリストが返ってきます。このプロセス自体は速く単純ですが、真の課題は、RAGパイプラインで最も関連性の高いコンテンツを見つけるために、これらの埋め込みを効果的に使う方法を理解することです。
次のステップは、埋め込みを比較して、どのチャンクがユーザーの質問に最も類似しているかを判断する方法を学ぶことです。これがセマンティック検索プロセスの核となります。