評価用データセットの準備ができたので、次はコア評価パイプラインを構築します。これには、各テストケースを取り出してプロンプトとマージし、Claudeに投入し、結果を採点するという作業が含まれます。
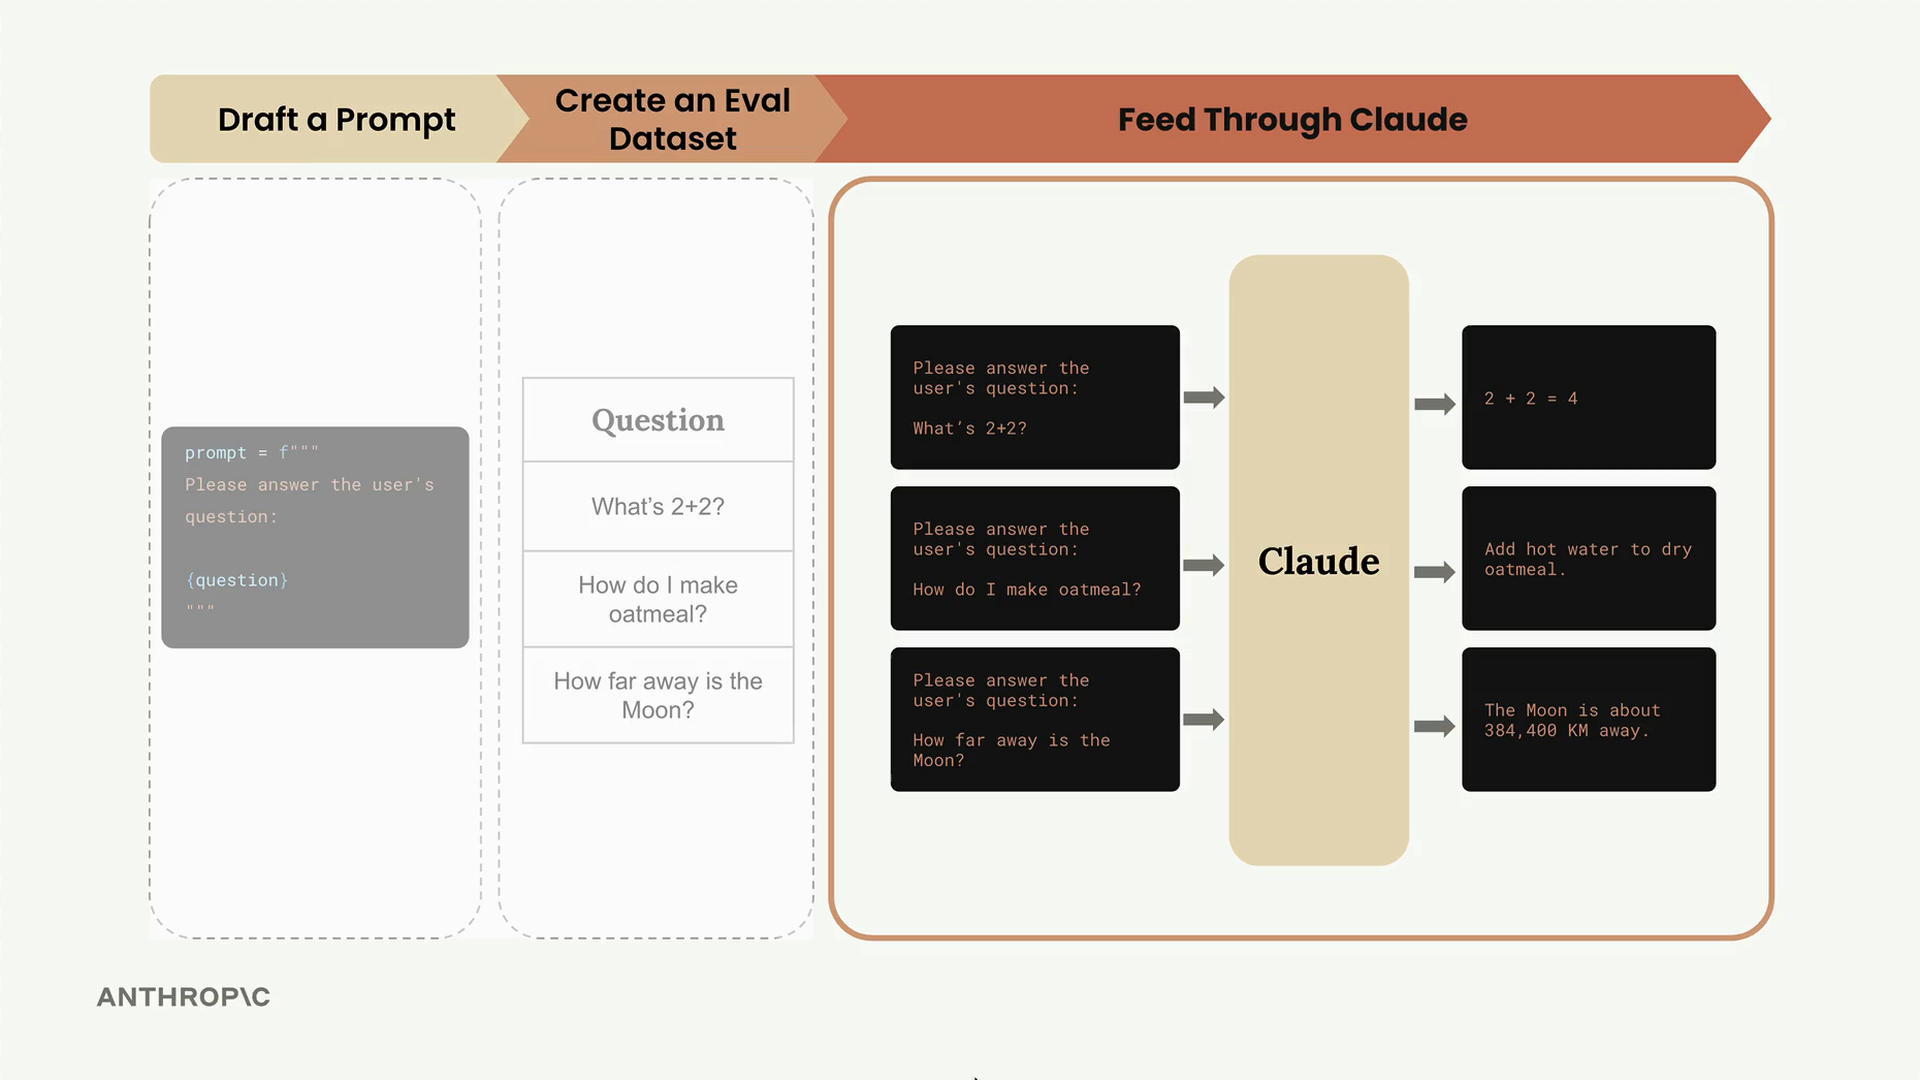
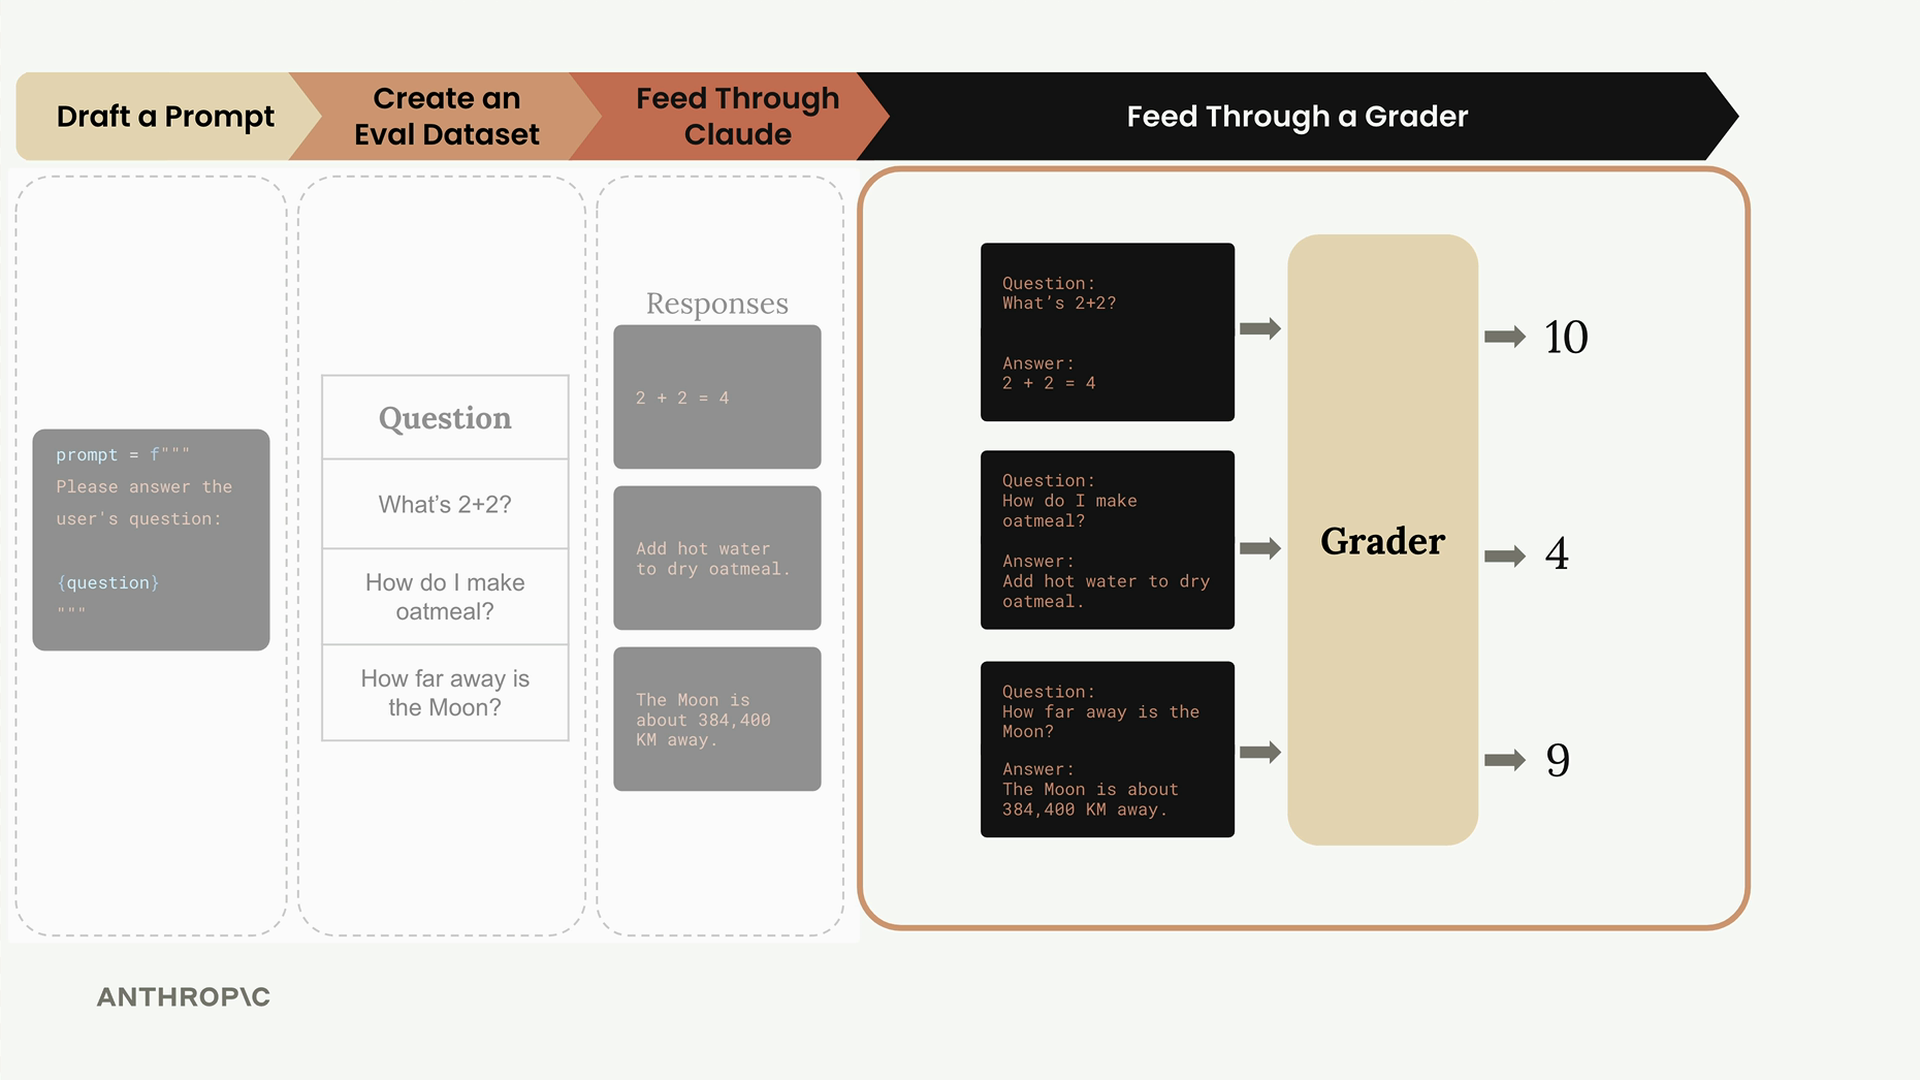
評価プロセスは明確なワークフローに沿って進みます。テストケースのデータセットを取得し、それぞれをプロンプトテンプレートと組み合わせ、Claudeに送信して処理させ、その出力をグレーダーシステムで評価します。
コア関数の構築
評価パイプラインは、それぞれ特定の役割を持つ3つの主要な関数で構成されています。まずは最もシンプルな関数、つまり個々のプロンプトを処理する関数から始めましょう。
run_prompt関数
この関数は、テストケースを受け取り、プロンプトテンプレートとマージします。
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
現時点では、プロンプトを極めてシンプルに保っています。書式に関する指示は一切含めていないため、Claudeは必要以上に冗長な出力を返す可能性が高いでしょう。これについては、プロンプトの設計を繰り返し改善していく中で後ほど調整します。
run_test_case関数
この関数は、単一のテストケースの実行と結果の採点を統括します。
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - 採点
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
今のところ、ハードコードされたスコア10を使用しています。採点ロジックについては、今後のセクションでかなりの時間を割いて扱いますが、このプレースホルダーによって、パイプライン全体をテストできるようになります。
run_eval関数
この関数は、評価プロセス全体を統括します。
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
この関数は、データセット内のすべてのテストケースを処理し、すべての結果を1つのリストにまとめます。
評価の実行
評価パイプラインを実行するには、データセットを読み込み、それを関数群に通します。
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
初めて実行する際は、多少時間がかかることを想定してください。Claude Haikuを使った場合でも、データセット全体の処理に30秒ほどかかることがあります。最適化手法については後ほど取り上げます。
結果の確認
評価結果は、各オブジェクトが1つのテストケースの結果を表す、構造化されたJSON配列として返されます。
print(json.dumps(results, indent=2))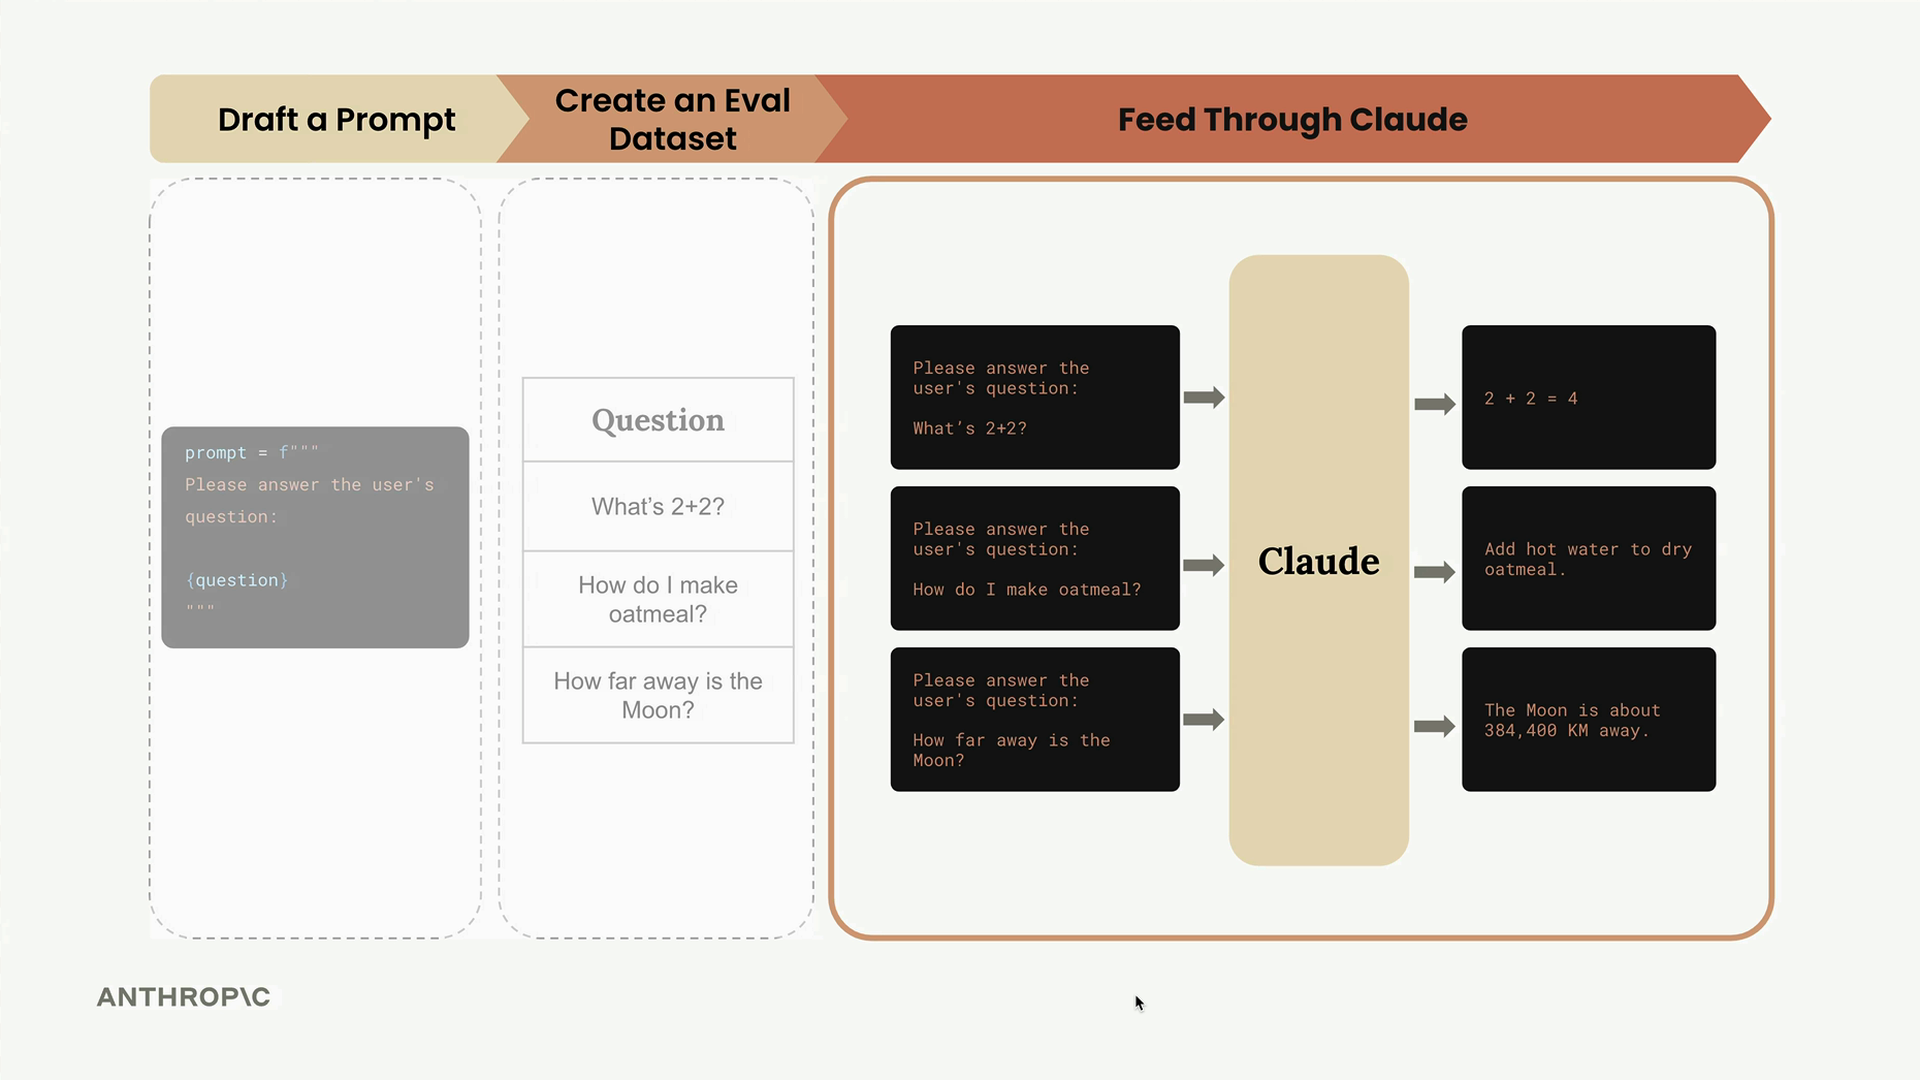
各結果には、3つの重要な情報が含まれています。
- output:Claudeからの完全な応答
- test_case:処理された元のテストケース
- score:評価スコア(現時点ではハードコード)
出力からわかるように、特定の書式指示をまだ提供していないため、Claudeはかなり冗長な応答を生成しています。これはまさに、今後プロンプトを改善していく中で対処すべき種類の問題です。
これまでに達成したこと
ここまでで、コア評価パイプラインの構築に成功しました。データセットを取得し、Claudeで処理し、構造化された結果を収集できるようになりました。大きく残っている課題は採点システムです。ハードコードされたスコア10を、実際の評価ロジックに置き換える必要があります。
このパイプラインは、ほとんどのAI評価システムの基盤を表しています。シンプルに見えるかもしれませんが、皆さんはすでにevalパイプラインが実際に行うことの大部分を構築し終えています。複雑さが増すのは細部、つまりより優れたプロンプト、洗練された採点、そしてパフォーマンスの最適化においてです。
次は、グレーダーという重要なトピックに踏み込み、ハードコードされたスコアを、Claudeの性能に関する意味のある評価へと変えていきます。