一般的なプロンプト評価ワークフローは、客観的な測定を通じてプロンプトを体系的に改善するのに役立つ5つの主要なステップに従います。このようなワークフローを組み立てる方法は数多くあり、さまざまなオープンソースや有料のツールも利用可能ですが、中核となるプロセスを理解することで、小さく始めて必要に応じて規模を拡大できます。
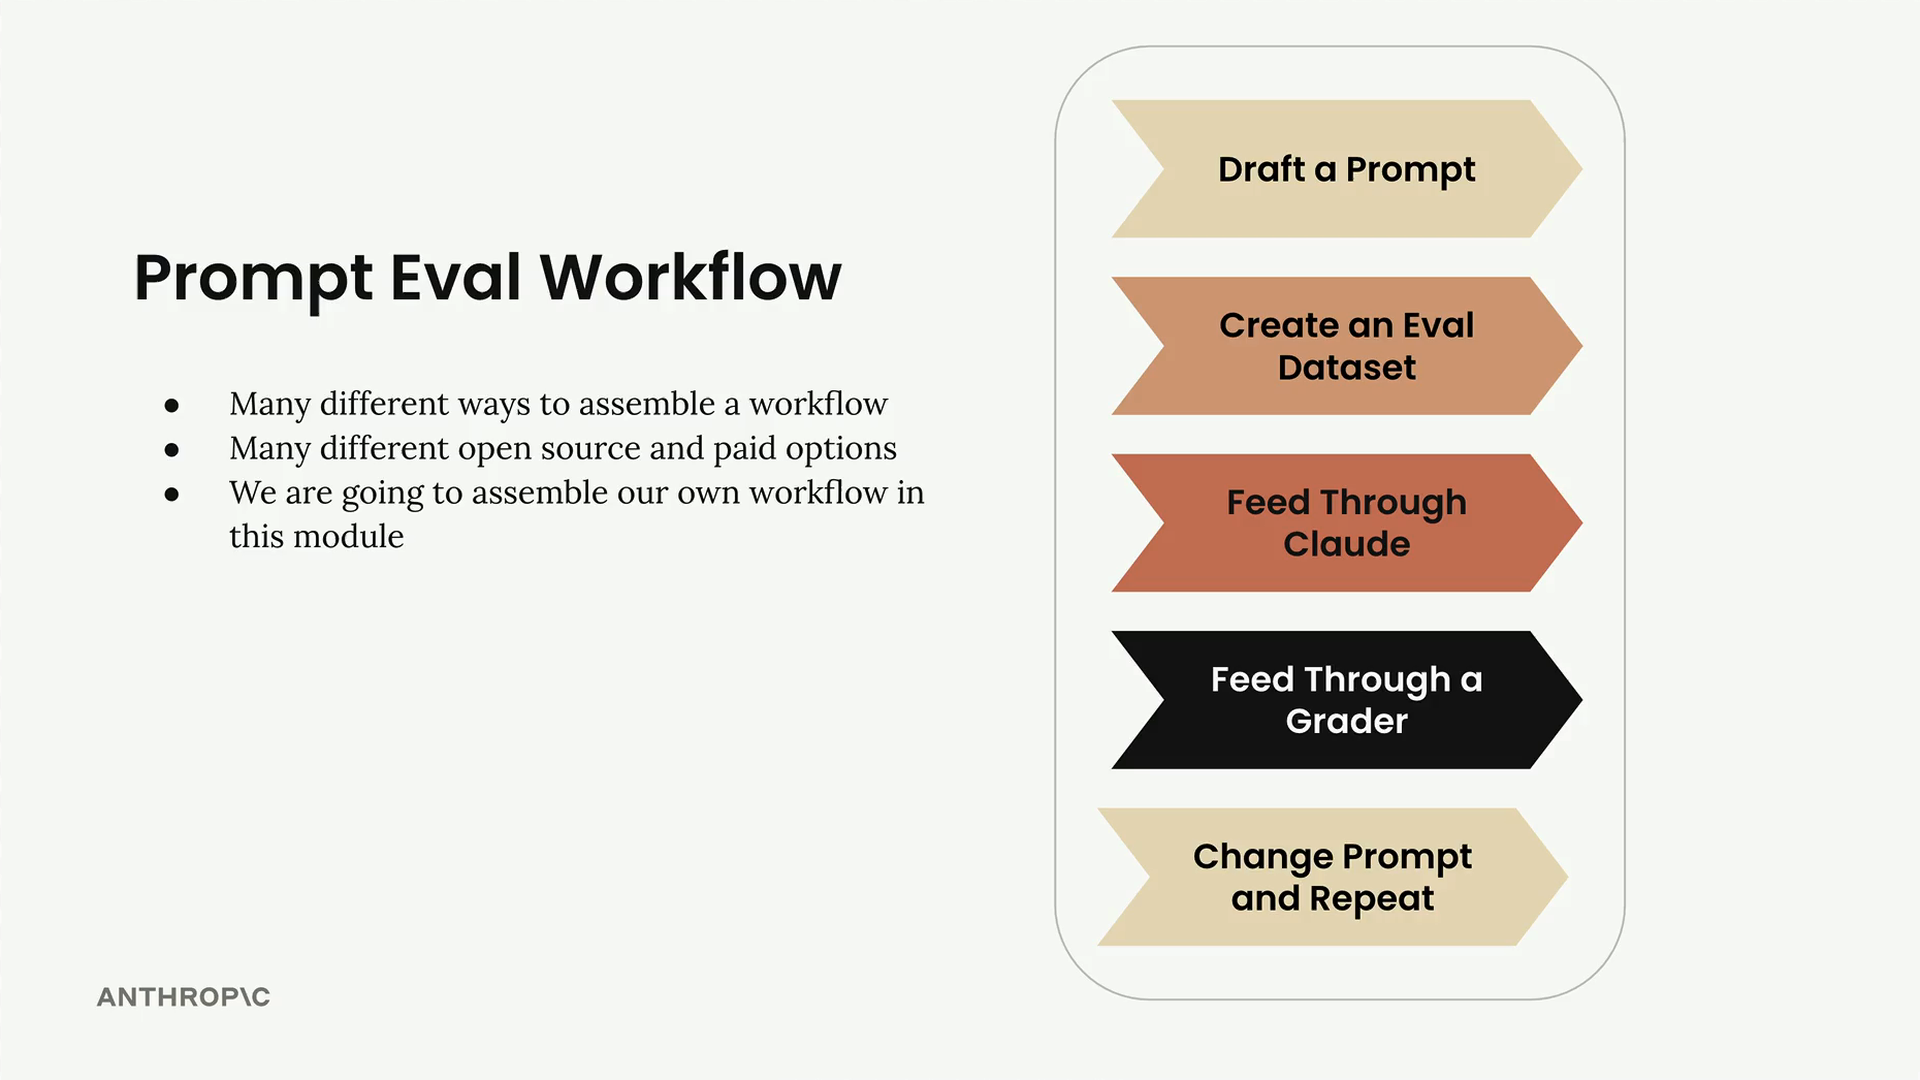
ステップ1: プロンプトを下書きする
まず、改善したい最初のプロンプトを書きます。この例では、シンプルなプロンプトを使用します。
prompt = f"""
Please answer the user's question:

{question}
"""
このシンプルなプロンプトが、テストと改善のためのベースラインとして機能します。
ステップ2: 評価データセットを作成する
評価データセットには、プロンプトが本番環境で処理する質問やリクエストの種類を表すサンプル入力が含まれます。このデータセットには、プロンプトテンプレートに補間される質問を含める必要があります。
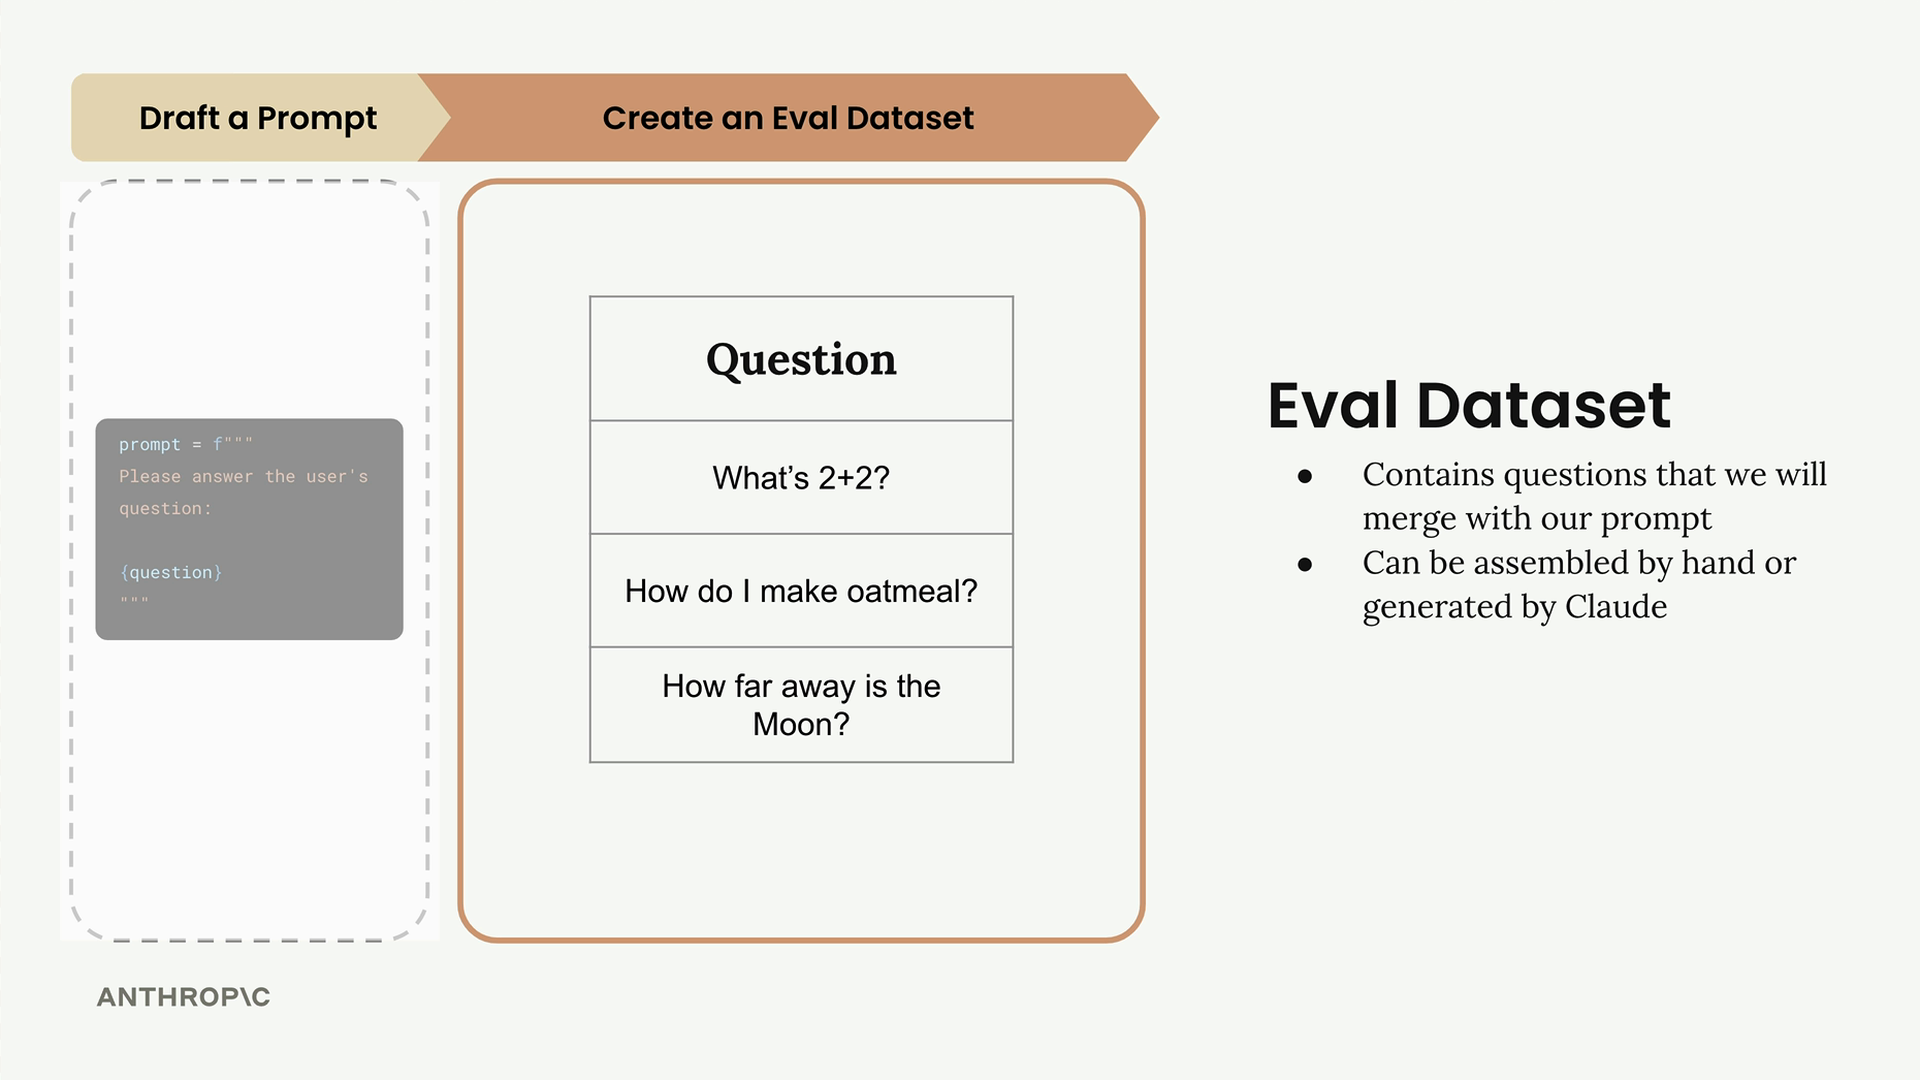
この例では、データセットには3つの質問が含まれています。
- 「2+2は何ですか?」
- 「オートミールの作り方は?」
- 「月までの距離はどれくらいですか?」
実際の評価では、数十、数百、あるいは数千件のレコードを使用することもあります。これらのデータセットは手作業で組み立てることも、Claudeに生成させることもできます。
ステップ3: Claudeに通す
データセットから各質問を取り出し、プロンプトテンプレートと統合して完全なプロンプトを作成します。次に、それぞれをClaudeに送信して応答を取得します。
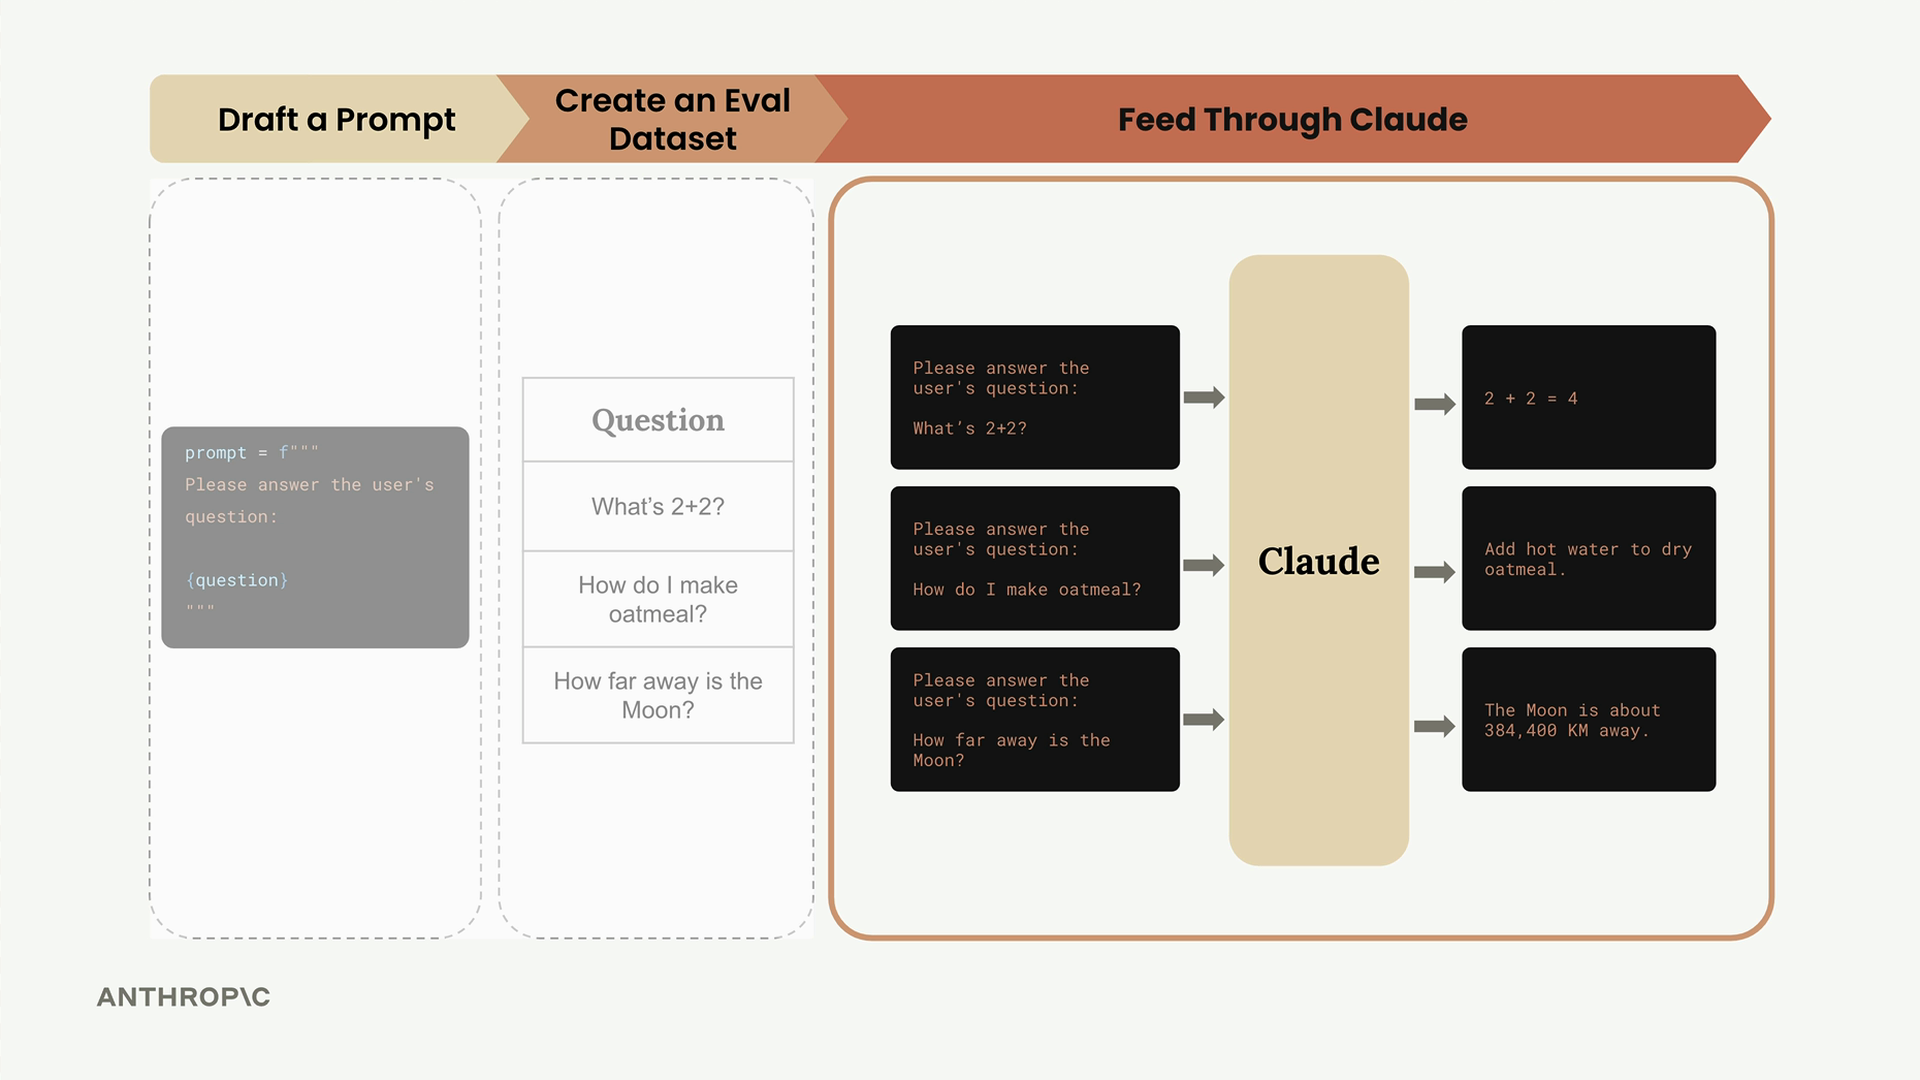
例えば、最初の質問は次のようになります。
Please answer the user's question:
What's 2+2?Claudeは、数学の質問には「2 + 2 = 4」と応答し、2番目の質問にはオートミールの調理手順を示し、3番目の質問には月までの距離を答えるかもしれません。
ステップ4: グレーダーに通す
グレーダーは、元の質問とClaudeの回答の両方を検討することで、Claudeの応答の品質を評価します。このステップでは客観的なスコアリングが行われ、通常1から10のスケールで、10が完璧な回答を表し、低いスコアは改善の余地があることを示します。
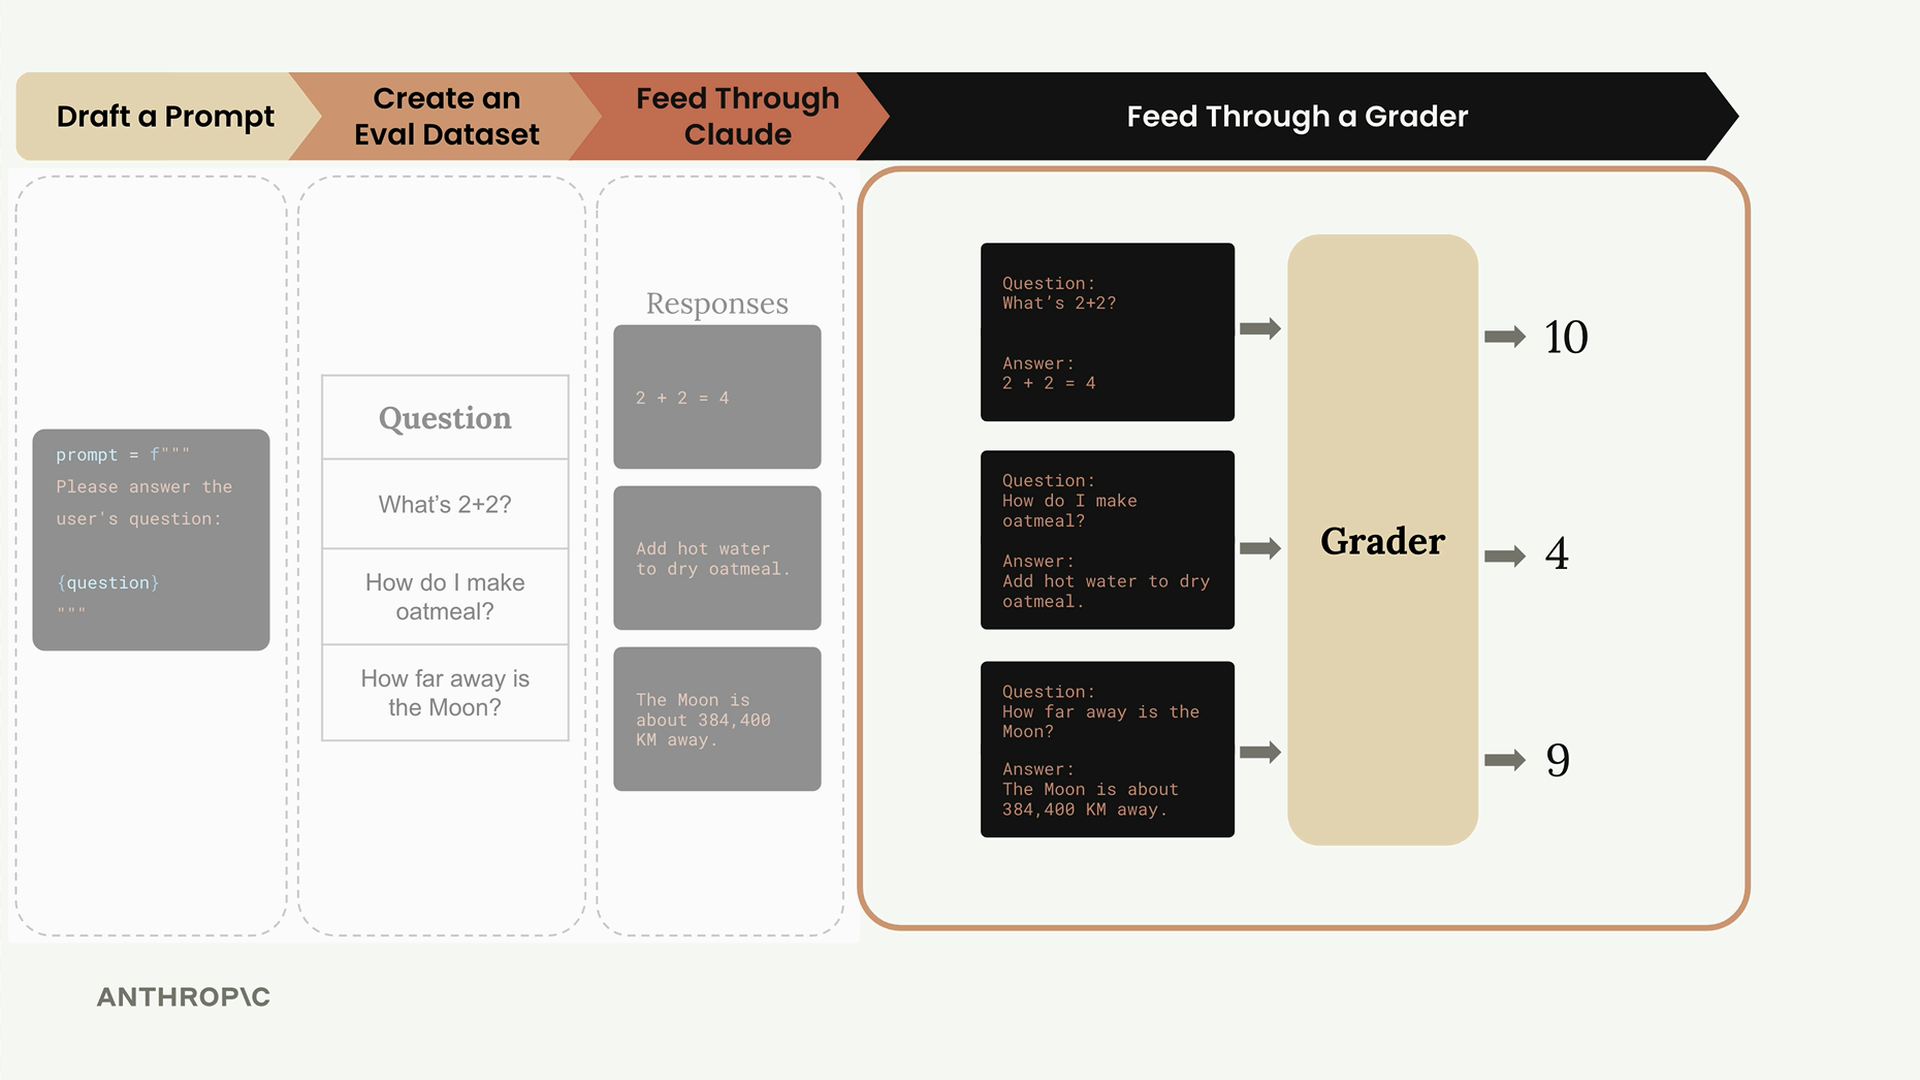
この例では、グレーダーは次のように採点するかもしれません。
- 数学の質問: 10(完璧な回答)
- オートミールの質問: 4(改善が必要)
- 月の質問: 9(非常に良い回答)
すべての質問における平均スコアは、客観的な測定値を示します:(10 + 4 + 9) ÷ 3 = 7.66
ステップ5: プロンプトを変更して繰り返す
ベースラインスコアが得られたので、プロンプトを修正してプロセス全体を再度実行し、変更がパフォーマンスを改善するかどうかを確認できます。
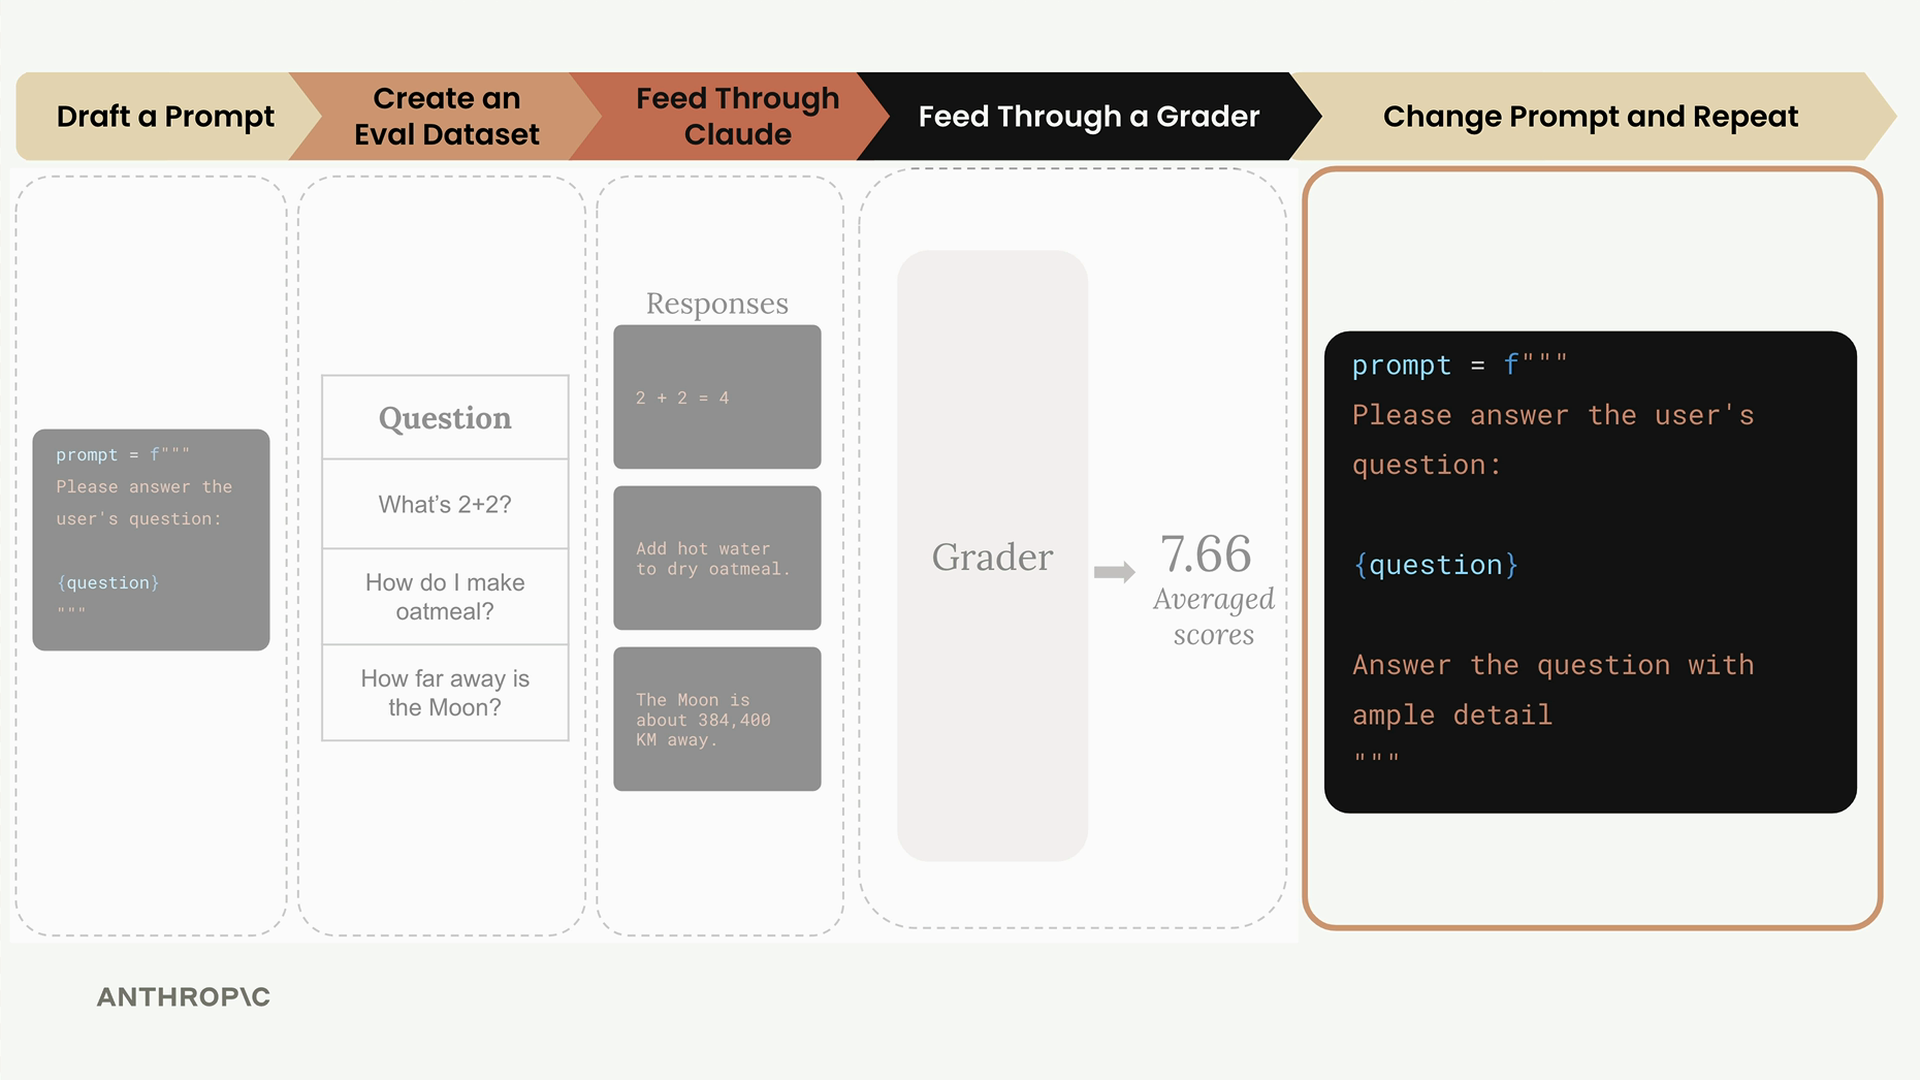
例えば、プロンプトに追加のガイダンスを加えるとします。
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
この改善したプロンプトを同じ評価プロセスに通した後、8.7というより高い平均スコアが得られ、追加の指示がClaudeがより良い応答を提供するのに役立ったことを示しているかもしれません。
プロンプトのスコアリング
このワークフローの主な利点は、プロンプトのパフォーマンスを客観的に測定できることです。以下のことができます。
- 異なるプロンプトのバージョンを数値で比較する
- 最良のスコアのバージョンを使用する
- さらに優れたアプローチを見つけるために反復を続ける
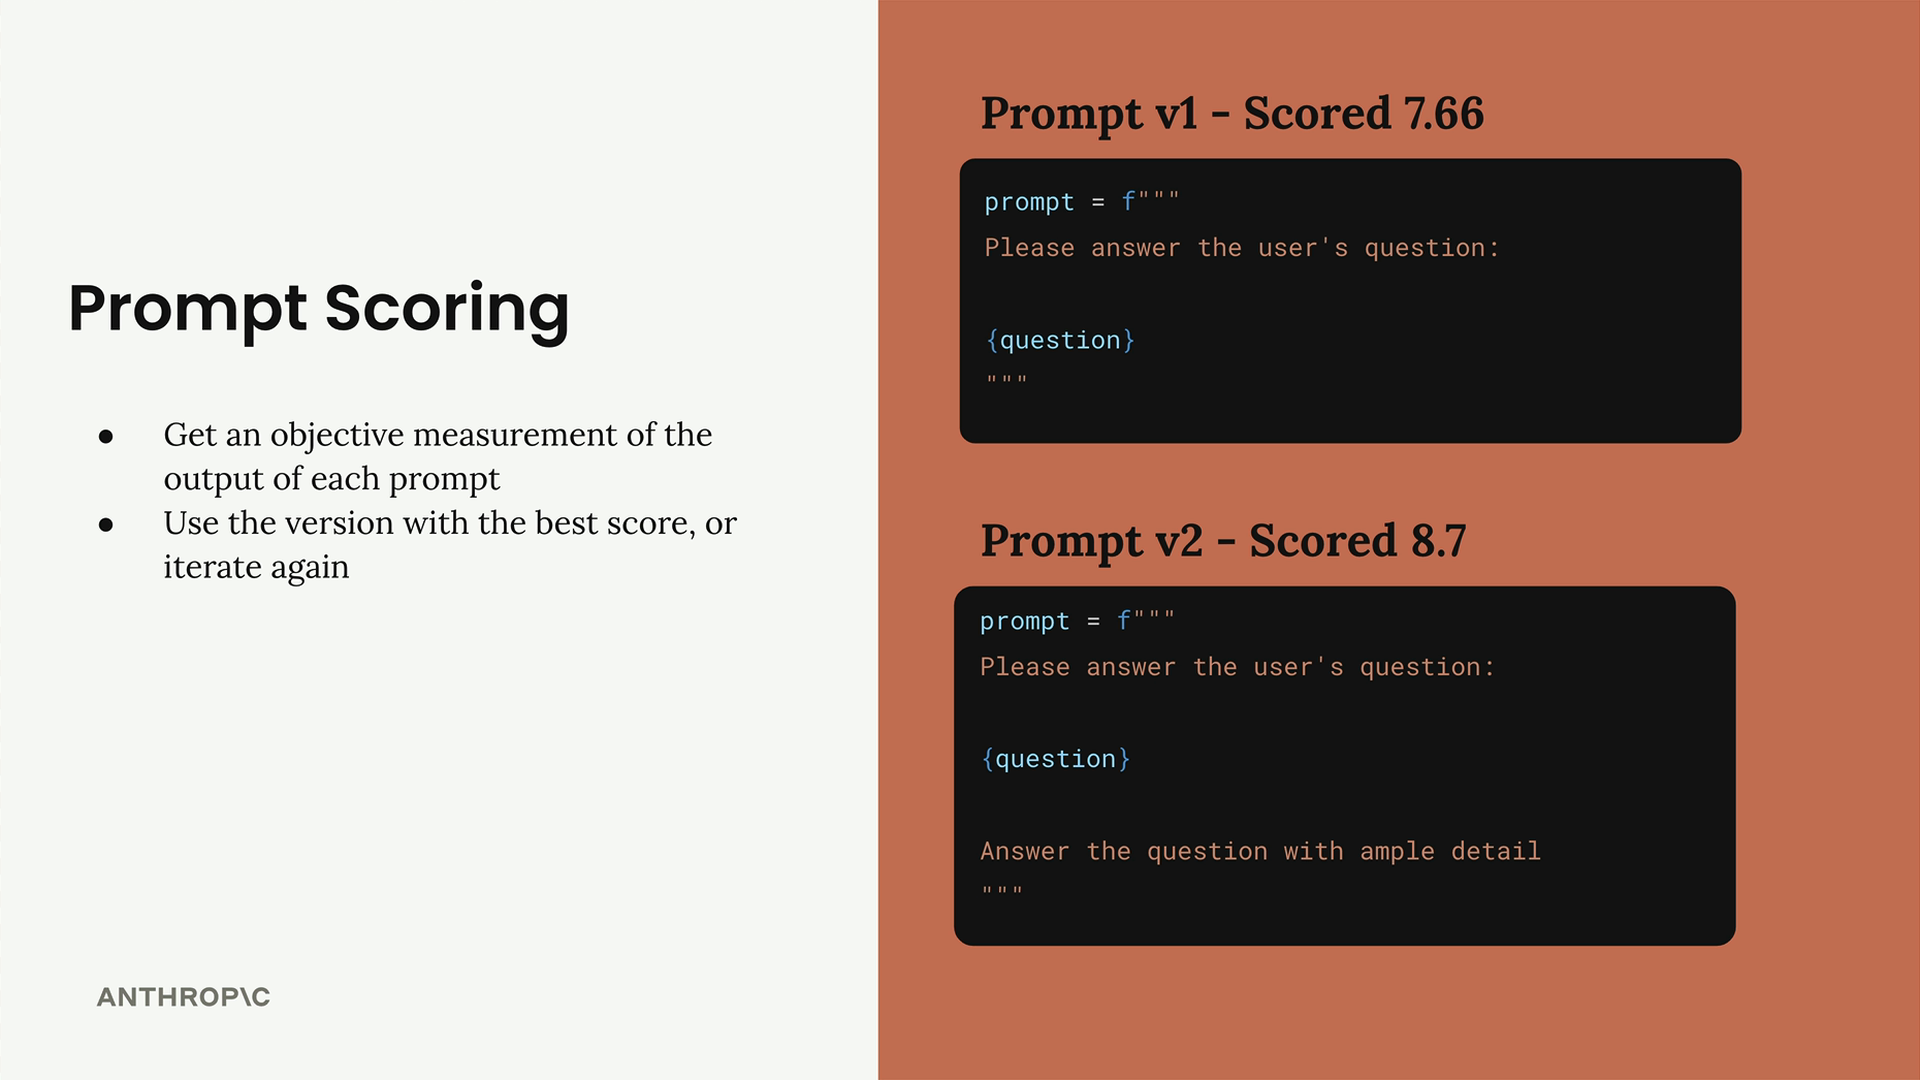
この体系的なアプローチは、プロンプトエンジニアリングから当て推量を排除し、変更が単なる異なるバリエーションではなく、実際に改善であるという確信を与えてくれます。