コードを生成するAIモデルを評価する際には、応答が理にかなっているかどうかを確認するだけでは不十分です。生成されたコードが実際に有効な構文を持ち、正しい形式に従っているかどうかも検証する必要があります。これが、コードベースの採点の出番です。
コード採点の仕組み
コード採点は、AIが生成した応答の2つの主要な側面を検証します。
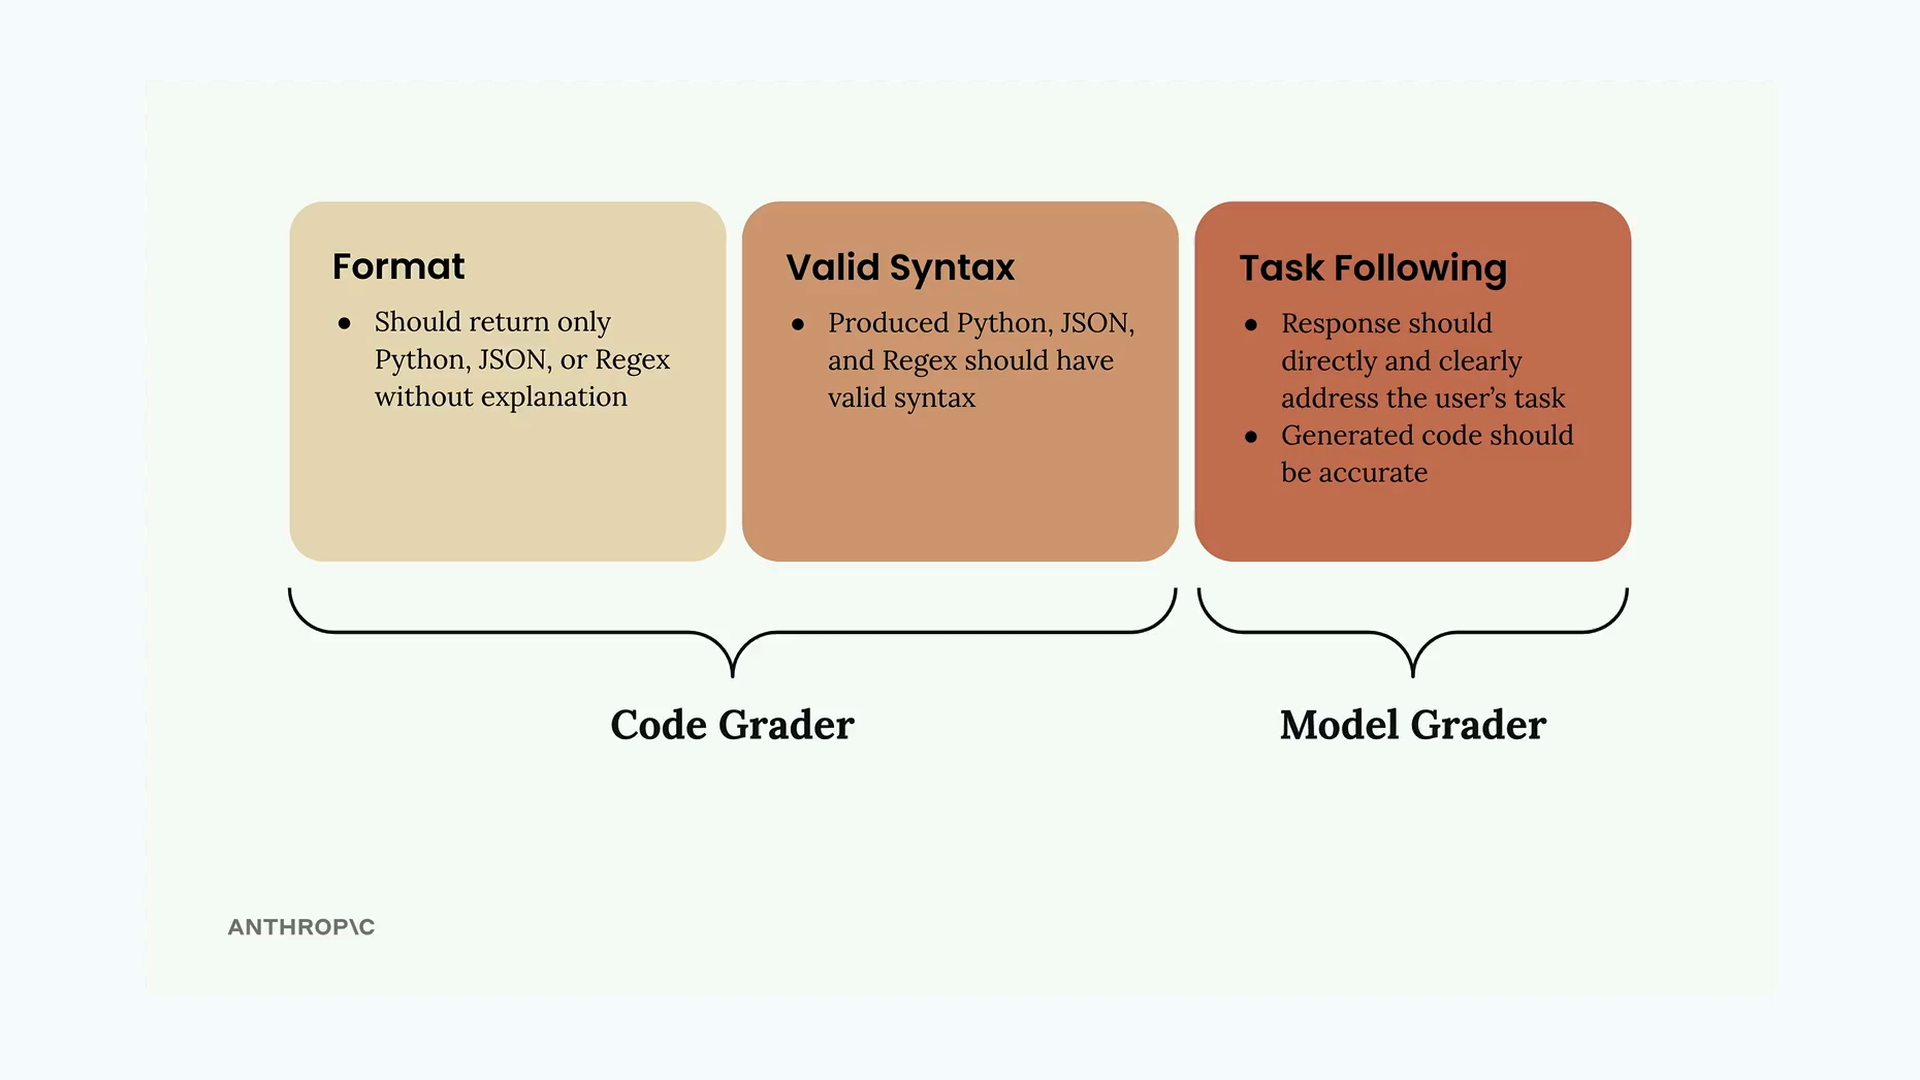
- Format(形式) - 応答は説明なしで、要求されたコードタイプ(Python、JSON、または正規表現)のみを返す必要があります
- Valid Syntax(有効な構文) - 生成されたコードは、意図した言語として実際に正しく解析できる必要があります
- Task Following(タスクの遵守) - 応答は尋ねられた内容に直接対応し、正確である必要があります
最初の2つの基準はコードグレーダーによって処理され、タスクの遵守はモデルグレーダーによって評価されます。これらを組み合わせることで、包括的な評価が可能になります。
構文検証関数
生成されたコードの構文が有効かどうかを確認するには、出力の解析を試みる3つのヘルパー関数を作成できます。
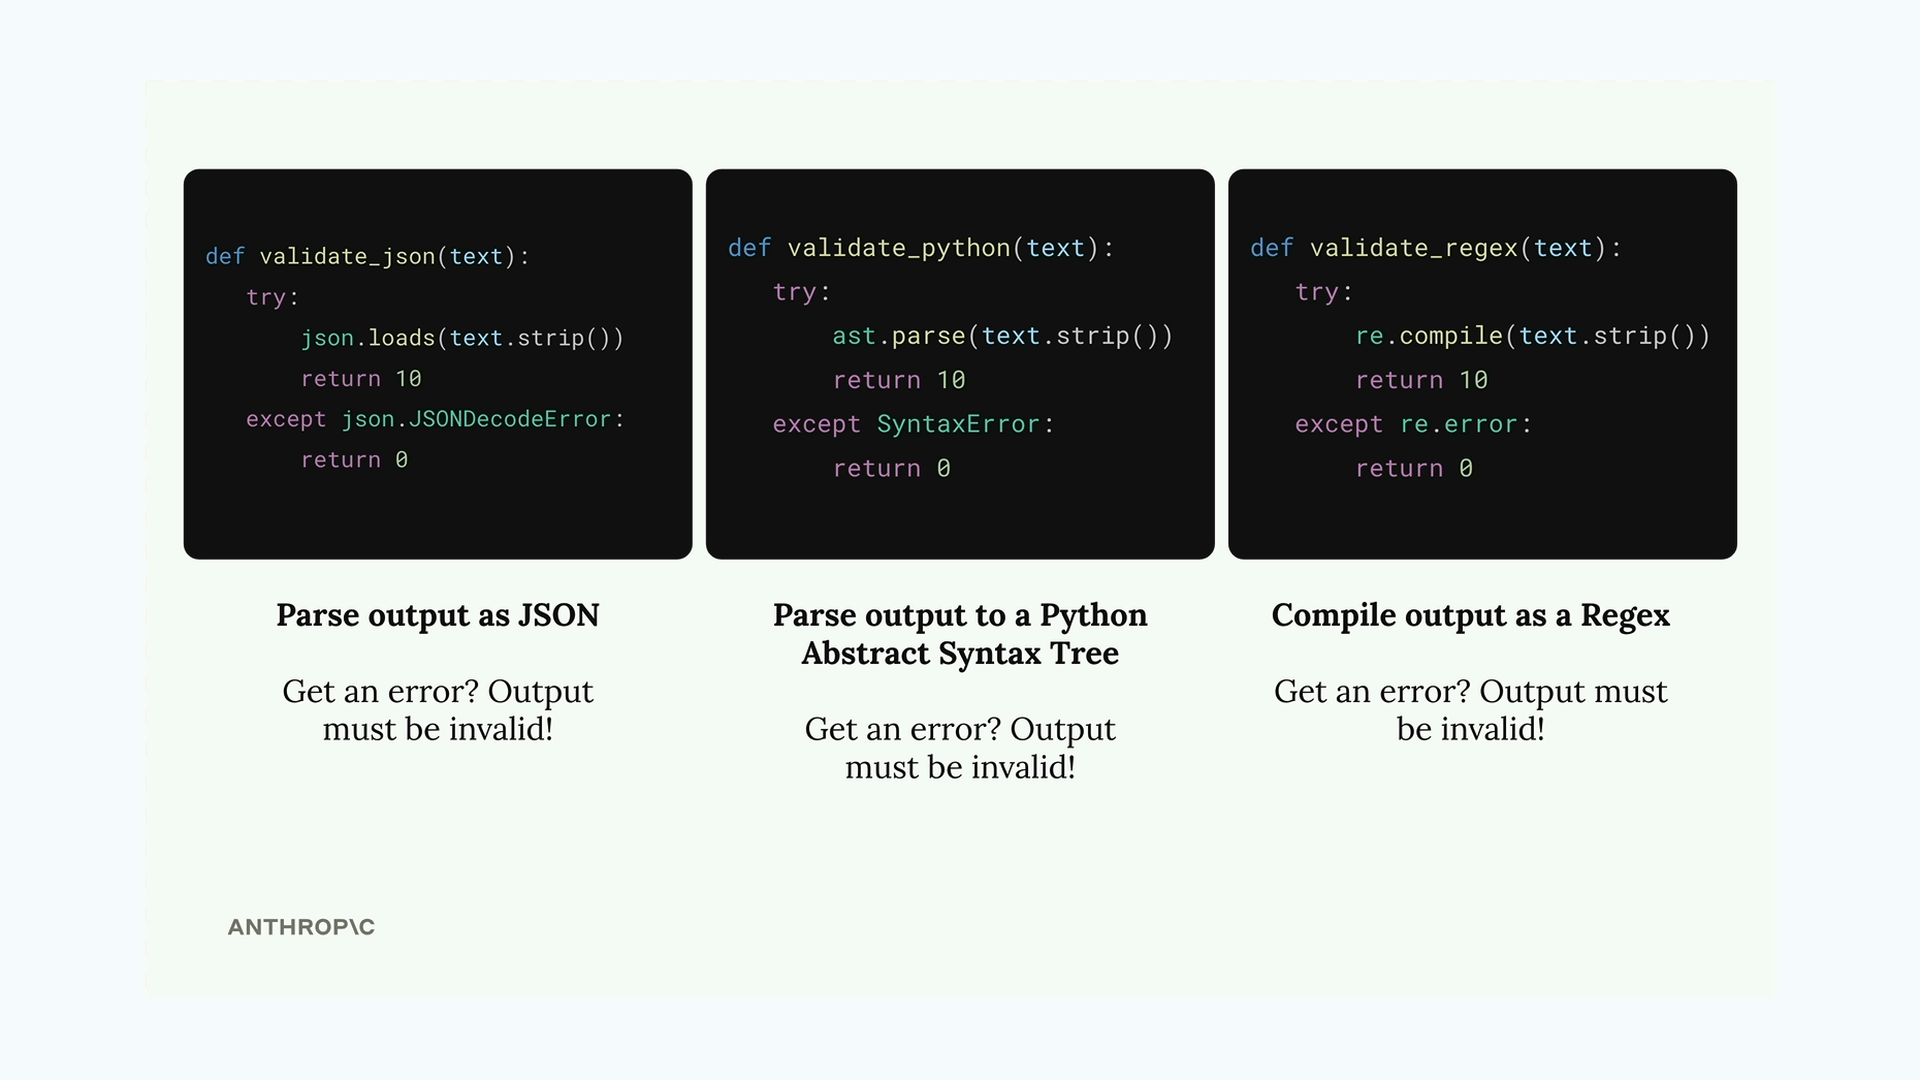
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
各関数は、テキストをそれぞれの形式として解析しようとします。解析に成功した場合、満点である10点を返します。エラーで失敗した場合、構文が無効であるとして0を返します。
データセット形式の要件
コードグレーダーがどのバリデーターを使用すべきかを把握できるようにするには、テストケースで期待される出力形式を指定する必要があります。
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
この形式フィールドを出力例の構造に追加することで、データセット生成プロンプトを更新し、自動的にこれを含めるようにすることができます。
プロンプトの明確さの向上
AIモデルからより良い結果を得るには、期待される出力形式についてプロンプトの指示をより具体的にします。
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationまた、コードブロック付きの事前入力済みアシスタントメッセージを使用することで、モデルに生のコードのみを返すよう促すこともできます。
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
これにより、それがPython、JSON、正規表現のどれであるかを事前に指定することなく、Claudeにコードコンテンツの生成を開始するよう指示できます。
スコアの組み合わせ
まず、各テストケースに一致するバリデーターを選択します。
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
return validate_regex(output)最後のステップは、モデルグレーダーのスコアとコードグレーダーのスコアを統合することです。単純な方法は、run_test_case の内部で平均を取ることです。
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
これにより、コンテンツの品質と技術的な正確性の両方に等しい重みが与えられます。特定のユースケースにとってどちらがより重要かに応じて、これらの重みを調整してもよいでしょう。
実装のテスト
コード採点を実装したら、評価を実行してベースラインスコアを取得します。スコアそのものが本質的に良いか悪いかは重要ではありません。重要なのは、プロンプトを改良することでスコアを改善できるかどうかです。これにより、主観的な評価に頼るのではなく、プロンプトエンジニアリングの進捗を定量的に測定する方法が得られます。