これまで、セマンティック検索(ベクトル埋め込みを使用)とレキシカル検索(BM25を使用)をそれぞれ個別に実装してきました。今度はそれらを統合検索パイプラインにまとめ、両方のアプローチの強みを活かす段階です。
マルチインデックスのアーキテクチャ
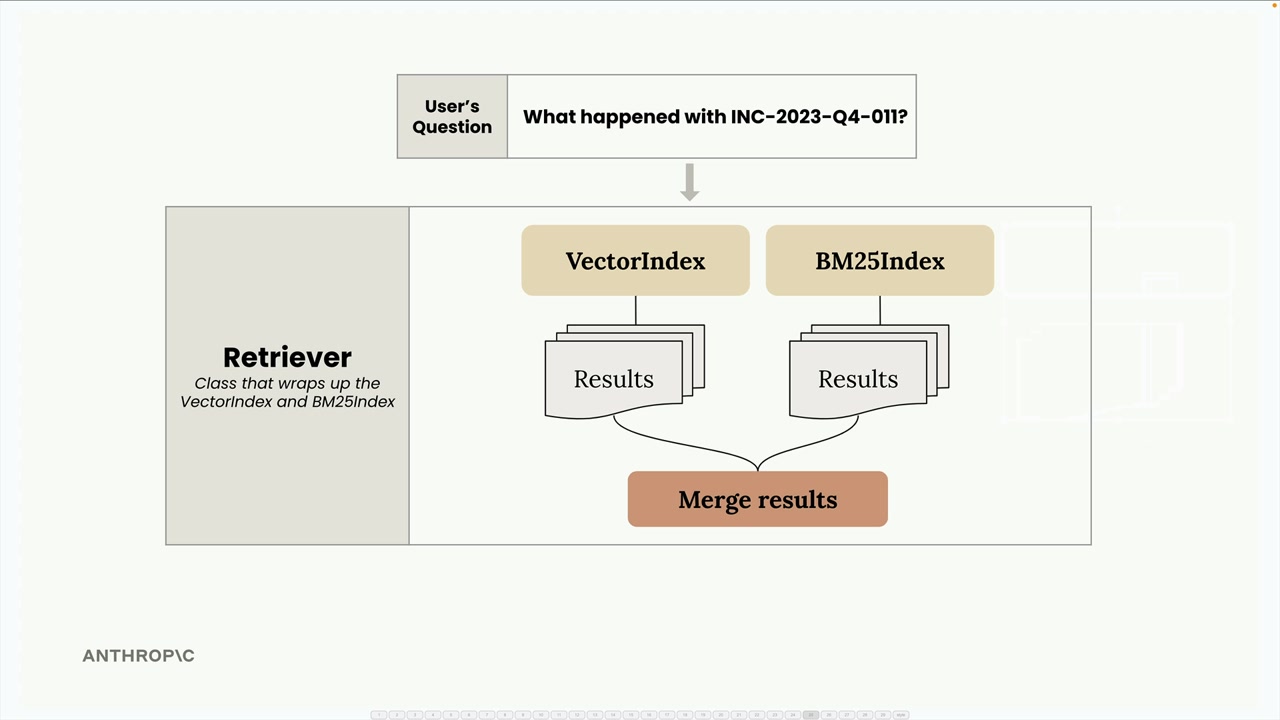
VectorIndexクラスとBM25Indexクラスは、ほぼ同一のAPIを共有しています。どちらも add_document() メソッドと search() メソッドを持っています。この一貫性のおかげで、両者をRetrieverという新しいクラスでラップすることが容易になります。
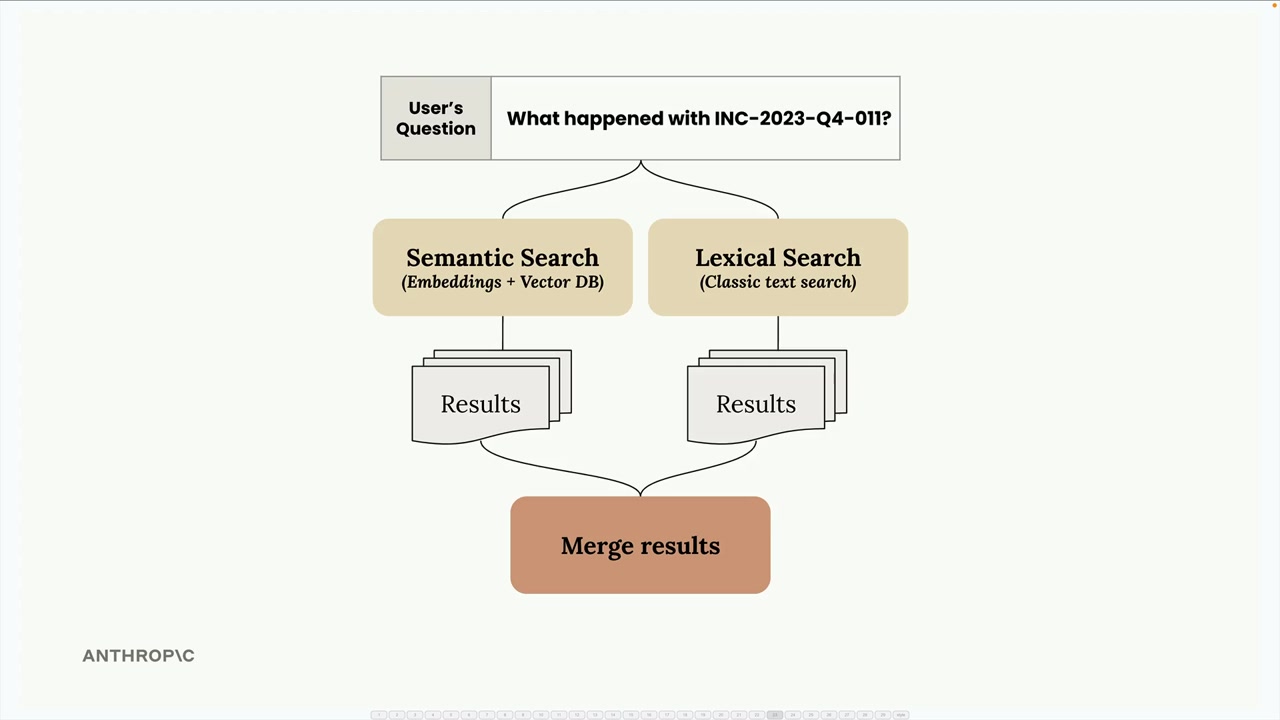
Retrieverは、ユーザーのクエリを両方のインデックスに転送し、それぞれの結果を収集したうえで、リシプロカル・ランク・フュージョン(reciprocal rank fusion)と呼ばれる手法を使ってマージするコーディネーターの役割を果たします。
リシプロカル・ランク・フュージョンの仕組み
異なる検索方式から得られた結果をマージするのは、単純にリストを連結するだけでは済みません。それぞれの方式は異なるスコアリングシステムを使用しているため、それらのランキングを公平に正規化して組み合わせる方法が必要です。
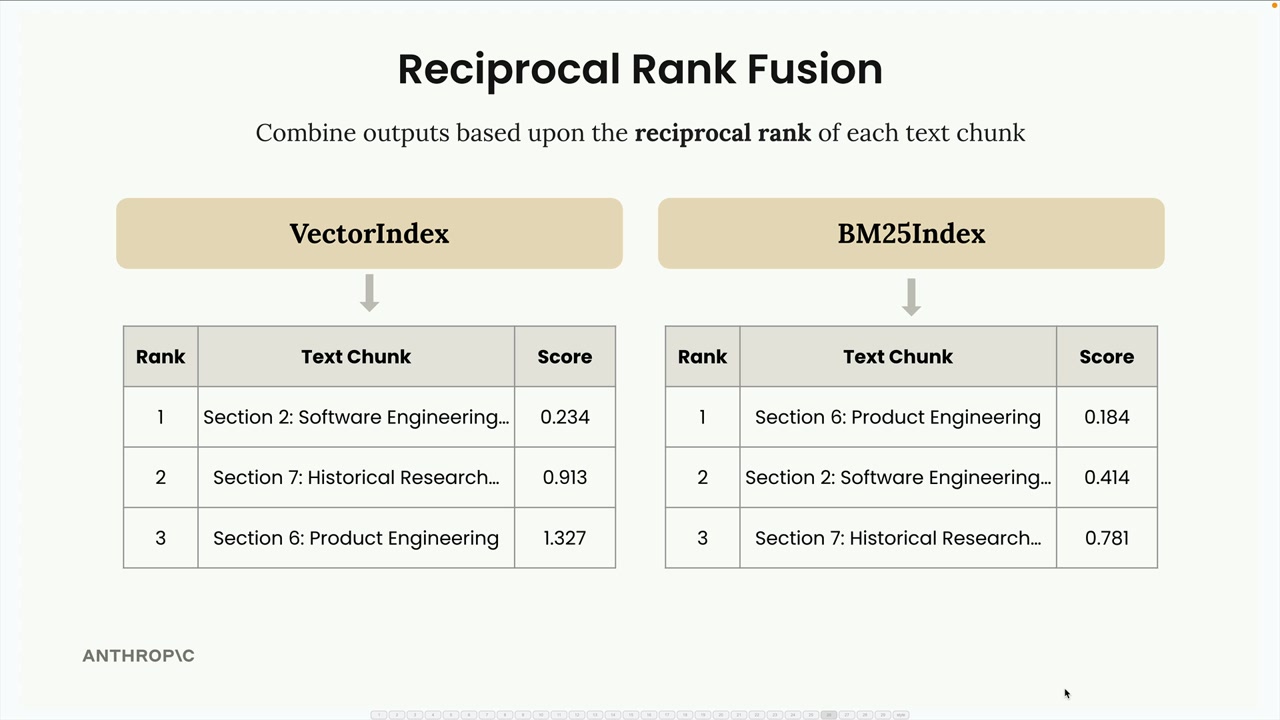
具体例でリシプロカル・ランク・フュージョンの仕組みを見てみましょう。「INC-2023-Q4-011」に関する情報を検索し、次のような結果が得られたとします。
- VectorIndexの返す結果:セクション2(順位1)、セクション7(順位2)、セクション6(順位3)
- BM25Indexの返す結果:セクション6(順位1)、セクション2(順位2)、セクション7(順位3)
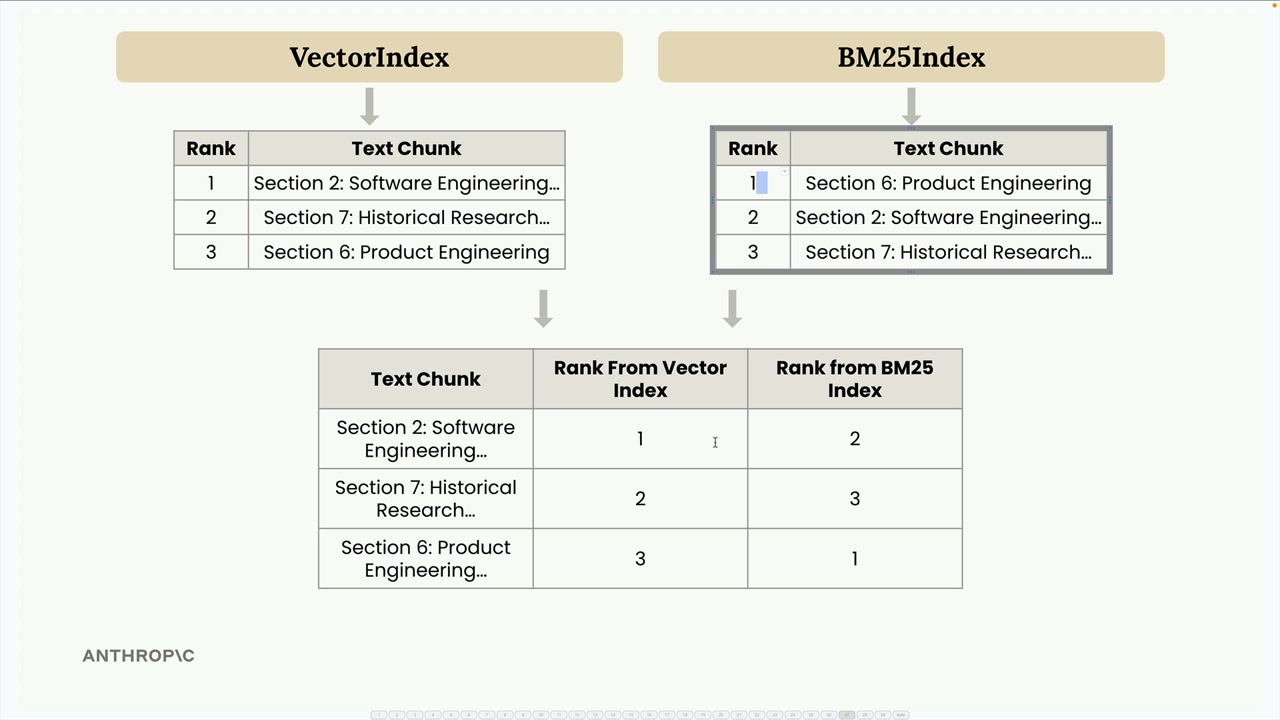
これらを1つの表にまとめ、各テキストチャンクの両インデックスでの順位を示したうえで、RRFの計算式を適用します。
RRF_score(d) = Σ(1 / (k + rank_i(d)))ここで、kは定数です(多くの場合60が用いられますが、ここではわかりやすい結果を得るために1を使います)。また、rank_i(d)は、i番目のランキングにおける文書dの順位を表します。
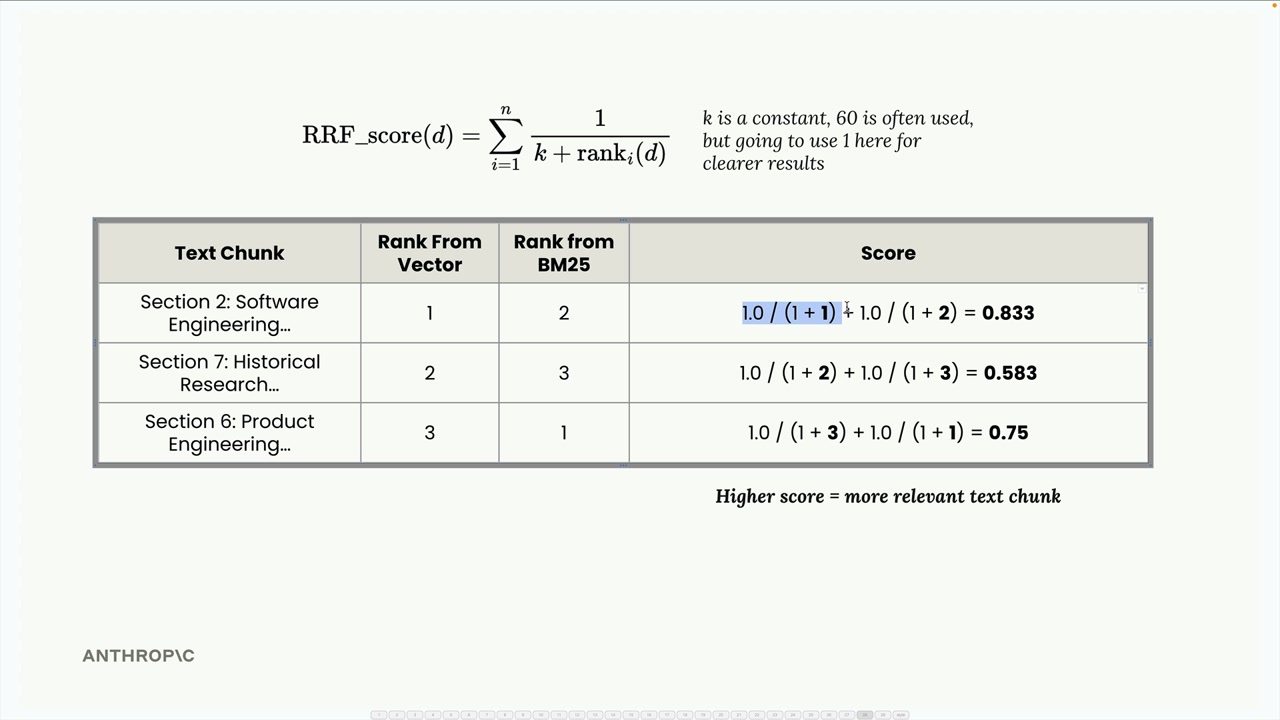
この例では:
- セクション2:1.0/(1+1) + 1.0/(1+2) = 0.833
- セクション7:1.0/(1+2) + 1.0/(1+3) = 0.583
- セクション6:1.0/(1+3) + 1.0/(1+1) = 0.75
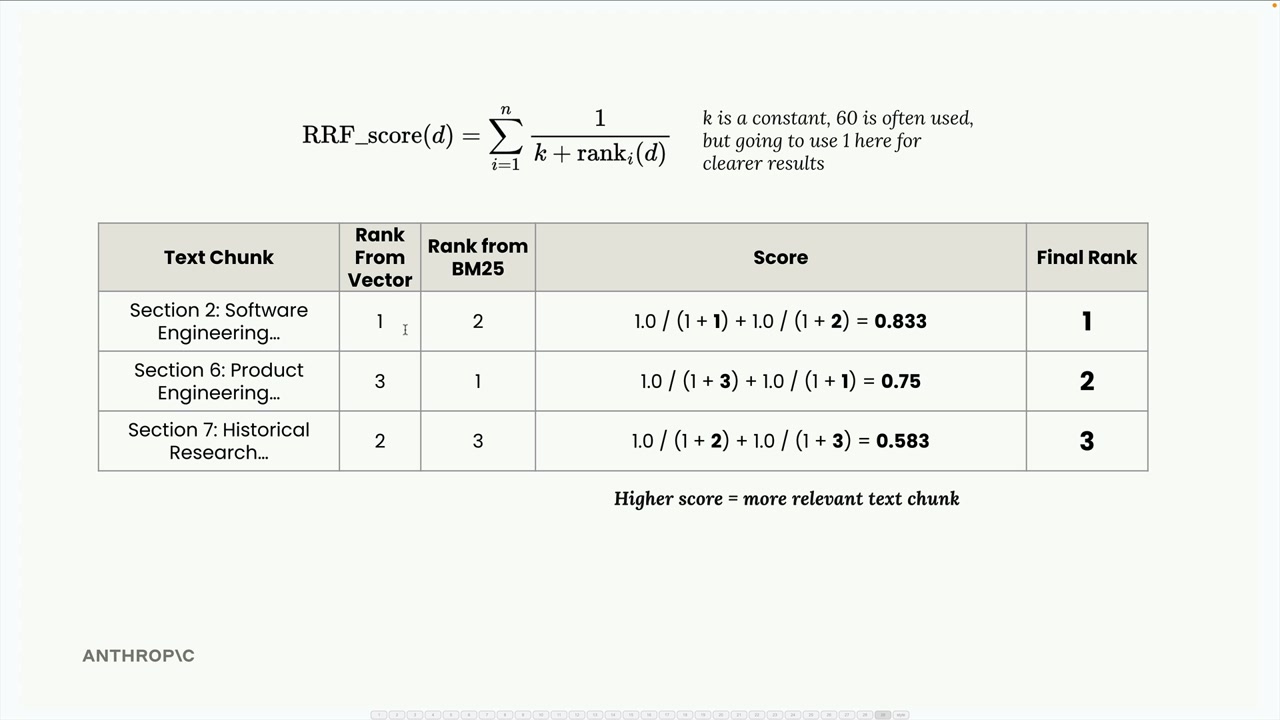
最終的なランキングは次のようになります:セクション2(0.833)、セクション6(0.75)、セクション7(0.583)。これは直感的にも納得できる結果です。セクション2は両方のインデックスで良好な成績を収めているため、上位に浮上しているのです。
実装の詳細
Retrieverクラスは複数の検索インデックスをラップし、統合インターフェースを提供します。
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # すべてのインデックスから結果を取得
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # インデックス間でドキュメントの順位を追跡
                # RRFスコアリング式を適用
        # マージおよびソート済みの結果を返す
ここでの重要なポイントは、異なる検索実装間で一貫したAPIを維持することで、密結合を避けながら簡単にそれらを組み合わせられるという点です。
ハイブリッドアプローチのテスト
以前、「what happened with INC-2023-Q4-011?」を検索した際、ベクトルのみのアプローチでは予想外の結果が返ってきた問題を覚えているでしょうか。サイバーセキュリティインシデント(セクション10)は正しく1位になりましたが、より関連性の高いソフトウェアエンジニアリングのセクションではなく、財務分析(セクション3)が2位になってしまっていました。
ハイブリッドリトリーバーを使うと、はるかに良い結果が得られます。
- セクション10:サイバーセキュリティ分析 - インシデント対応レポート(最も関連性が高い)
- セクション2:ソフトウェアエンジニアリング - プロジェクトフェニックス安定性強化(2番目に関連性が高い)
- セクション5:法的動向(3番目)
これは、セマンティック検索とレキシカル検索を組み合わせることで、いずれか一方のアプローチだけでは克服できない限界を乗り越えられることを示しています。
拡張性
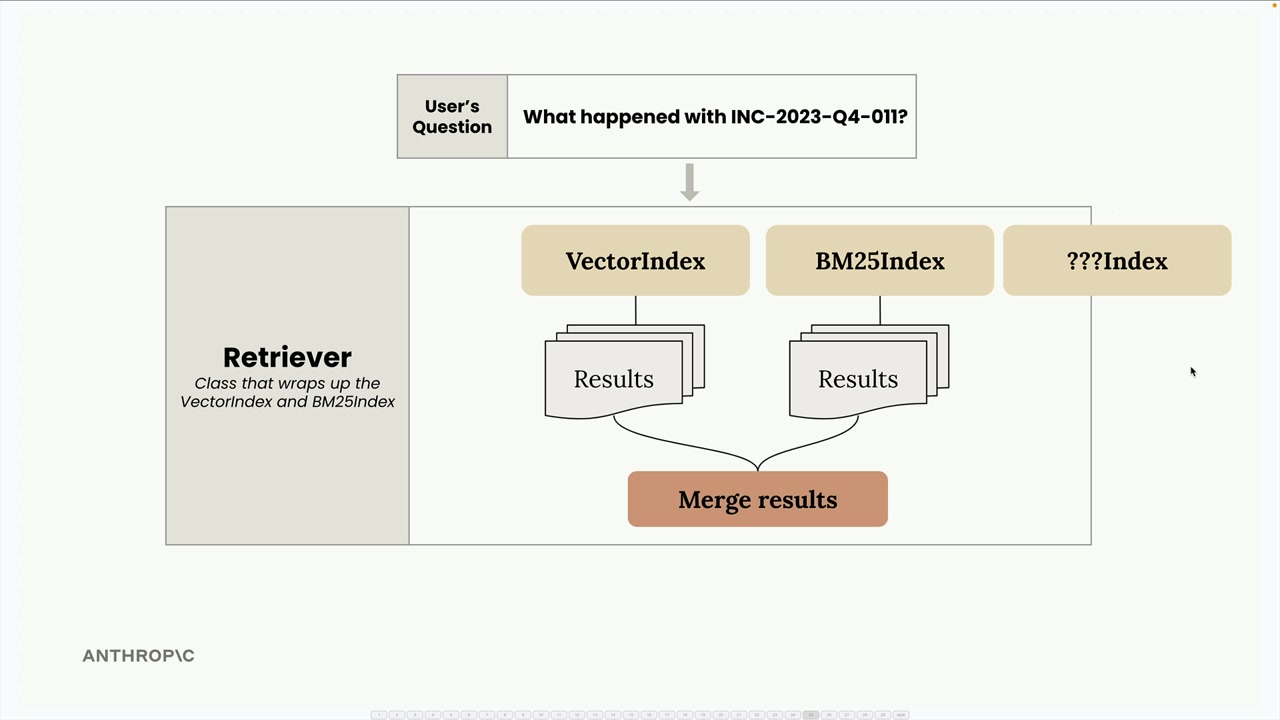
このアーキテクチャの優れた点は、その拡張性にあります。すべてのインデックスが add_document() メソッドと search() メソッドを持つ同じSearchIndexプロトコルを実装しているため、新しい検索手法を簡単に追加できます。
キーワードベースのインデックスを追加したいですか?グラフベースの検索はどうでしょう?特定ドメイン向けのインデックスは?同じインターフェースを実装するだけで、Retrieverは自動的にそれをフュージョンのプロセスに組み込んでくれます。
このモジュール式のアプローチにより、各検索実装は焦点を絞った、テストしやすいものに保たれる一方で、最終的なシステムにおいてそれぞれの強みを組み合わせるためのクリーンな方法が提供されます。