Retrieval Augmented Generation(RAG)は、1つのプロンプトに収まりきらないほど大きなドキュメントを扱う際に役立つ手法です。すべてを1つの巨大なプロンプトに詰め込む代わりに、RAGはドキュメントをチャンクに分割し、質問に答える際に最も関連性の高い部分だけを含めます。
大きなドキュメントが抱える問題
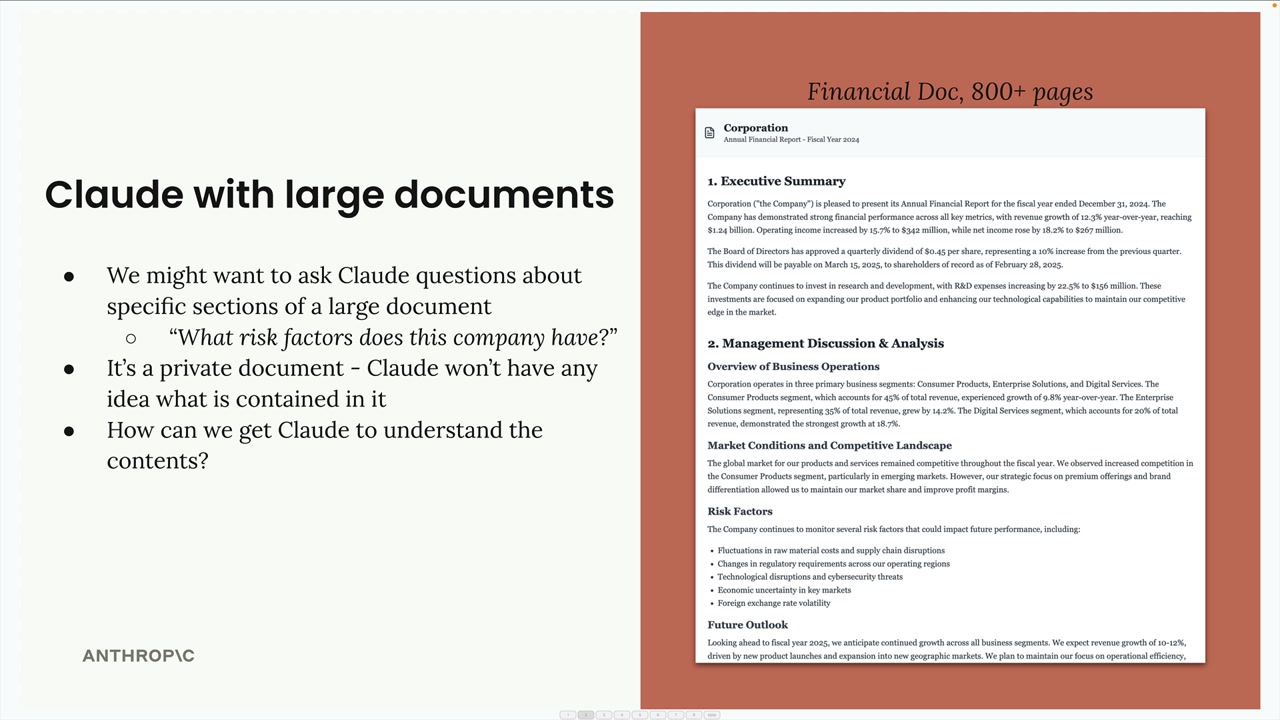
800ページに及ぶ財務文書があり、「この会社にはどのようなリスク要因がありますか?」といった具体的な質問をClaudeにしたいとします。何らかの方法でドキュメントから関連情報をClaudeに渡す必要がありますが、プロンプトに含められるテキスト量には限界があります。
選択肢1:すべてをプロンプトに含める
最初のアプローチは単純です。ドキュメントからすべてのテキストを抽出し、ユーザーの質問とともにプロンプトに詰め込みます。プロンプトは次のようになるでしょう。
Answer the user's question about the financial document.

<user_question>
{user_question}
</user_question>

<financial_document>
{financial_document}
</financial_document>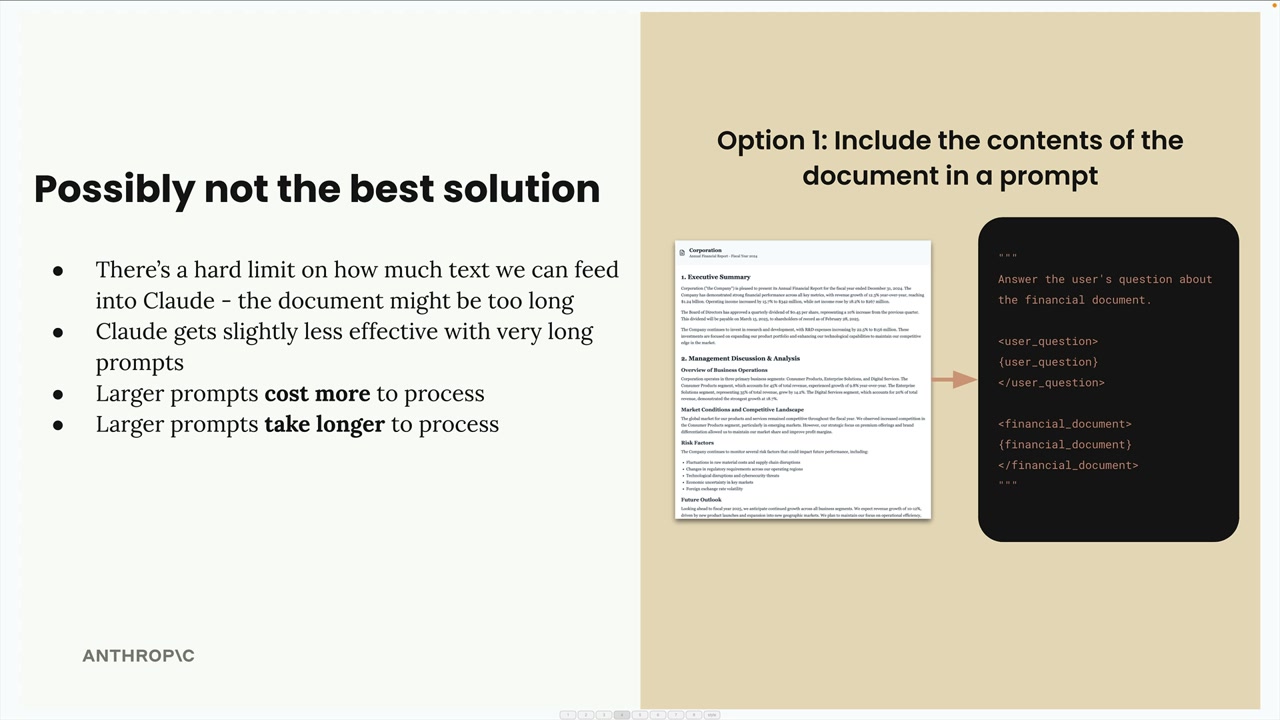
このアプローチには深刻な制限があります。
- プロンプトの長さには厳格な上限があり、ドキュメントが長すぎる可能性がある
- プロンプトが非常に長くなると、Claudeの効果が低下する
- プロンプトが大きいほど処理コストが高くなる
- プロンプトが大きいほど処理に時間がかかる
選択肢2:ドキュメントをチャンクに分割する
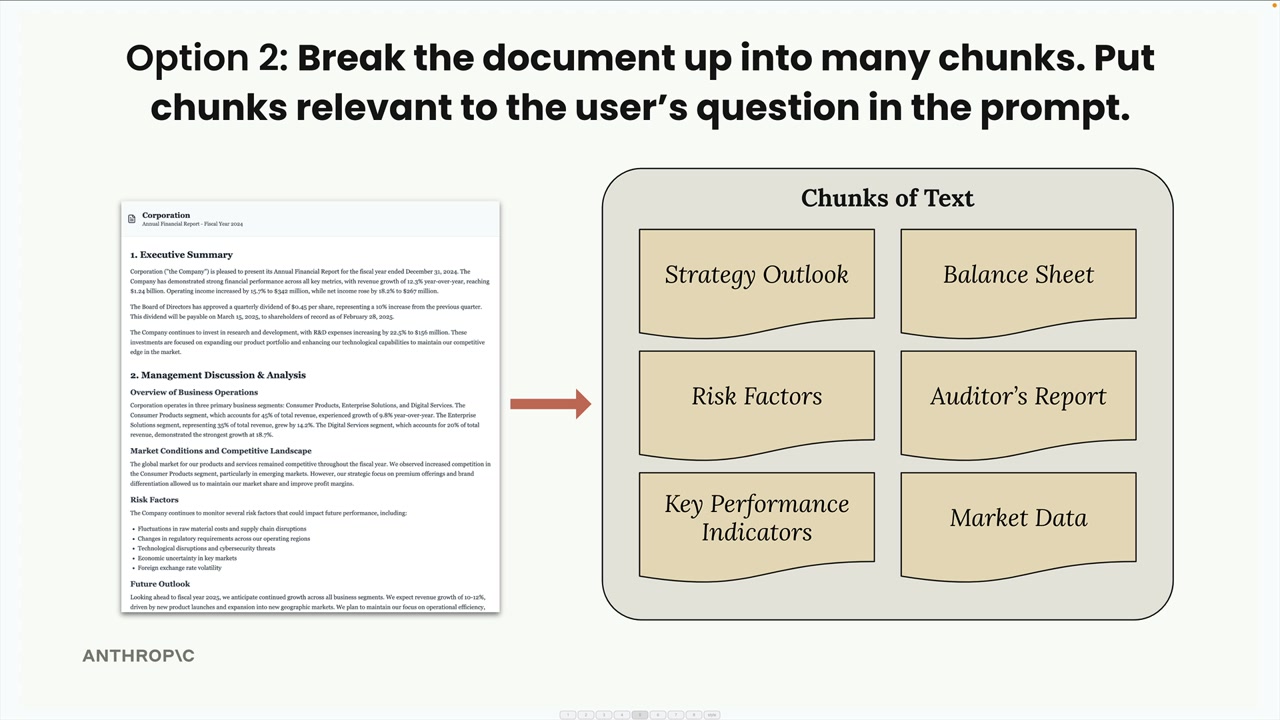
RAGはより賢いアプローチを取ります。まず、前処理の段階でドキュメントを小さなチャンクに分割します。次に、ユーザーが質問をすると、その質問に最も関連性の高いチャンクを見つけ出し、それらだけをプロンプトに含めます。
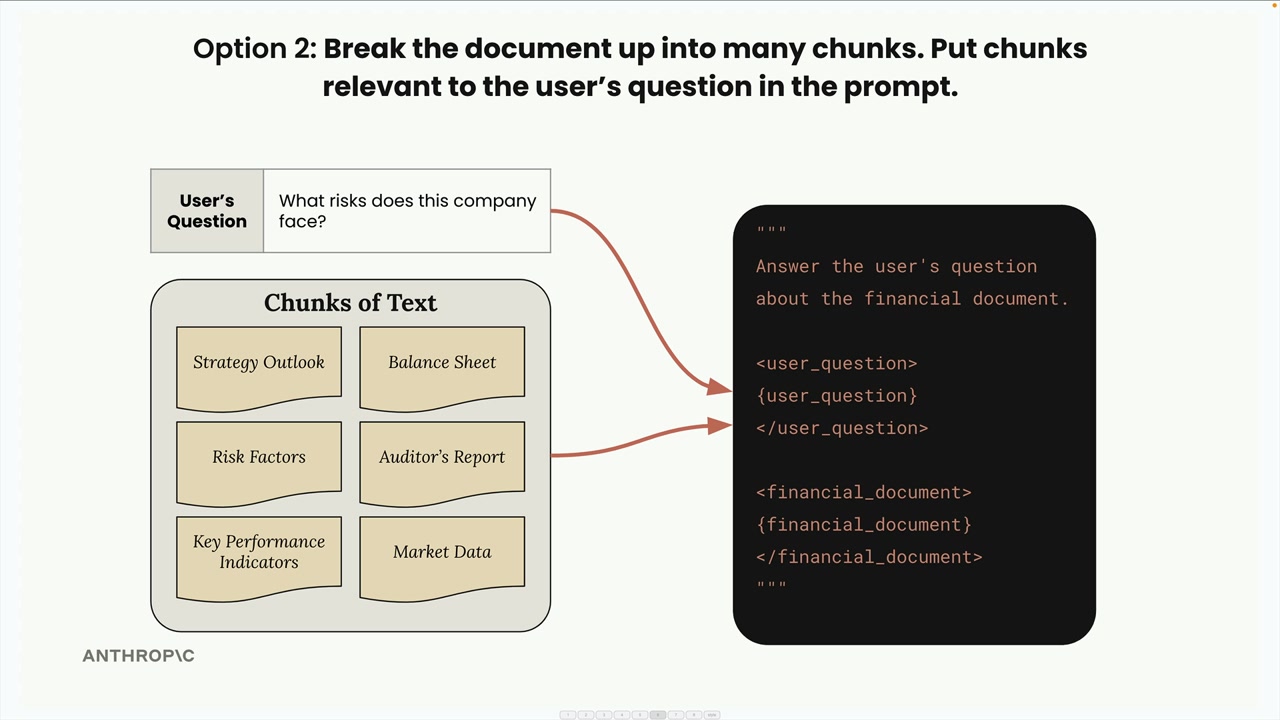
仕組みは次のとおりです。「この会社が直面しているリスクは何ですか?」と誰かが尋ねた場合、チャンクを検索して「Risk Factors」セクションを見つけ、その関連するチャンクだけをプロンプトに含めます。
RAGのメリット
- Claudeは最も関連性の高いコンテンツのみに集中できる
- 非常に大きなドキュメントにも対応できる
- 複数のドキュメントに対応できる
- プロンプトが小さくなることでコストが下がり、処理も速くなる
RAGの課題
- ドキュメントをチャンク化する前処理のステップが必要
- 「関連性のある」チャンクを見つけるための検索メカニズムが必要
- 含まれるチャンクに、Claudeが必要とするすべてのコンテキストが含まれているとは限らない
- テキストのチャンク化方法は多数あり、どのアプローチが最適かを判断する必要がある
たとえば、ドキュメントを均等なサイズの部分に分割することもできますし、見出しやセクションといったドキュメント構造に基づいてチャンクを作成することもできます。それぞれのアプローチにはトレードオフがあり、自社のユースケースに合わせて評価する必要があります。
RAGを使うべき場面
RAGには多くの技術的な判断が伴い、単にすべてをプロンプトに含めるよりも多くの作業が必要になります。自社の特定のアプリケーションにとって、そのメリットが複雑さを上回るかどうかを分析する必要があります。非常に大きなドキュメントや複数のドキュメントを扱う場合、あるいはコストとパフォーマンスを最適化する必要がある場合に、特に価値を発揮します。
重要なポイントは、RAGがシンプルさをスケーラビリティと効率性と引き換えにしているということです。適切に実装するには事前により多くの作業が必要になりますが、単純なプロンプト詰め込みでは扱いきれないドキュメントコレクションを扱えるようになります。