RAGフローを概念的に理解したところで、段階的に実装していきましょう。テキストをチャンクに分割し、埋め込みを生成し、それらをベクトルデータベースに保存し、類似性検索を実行する方法を示す完全な例を一通り見ていきます。
5ステップのRAG実装
今回の実装は、これまでに説明したのと同じ5つのステップに従います。
- テキストをセクションごとにチャンク化する
- 各チャンクの埋め込みを生成する
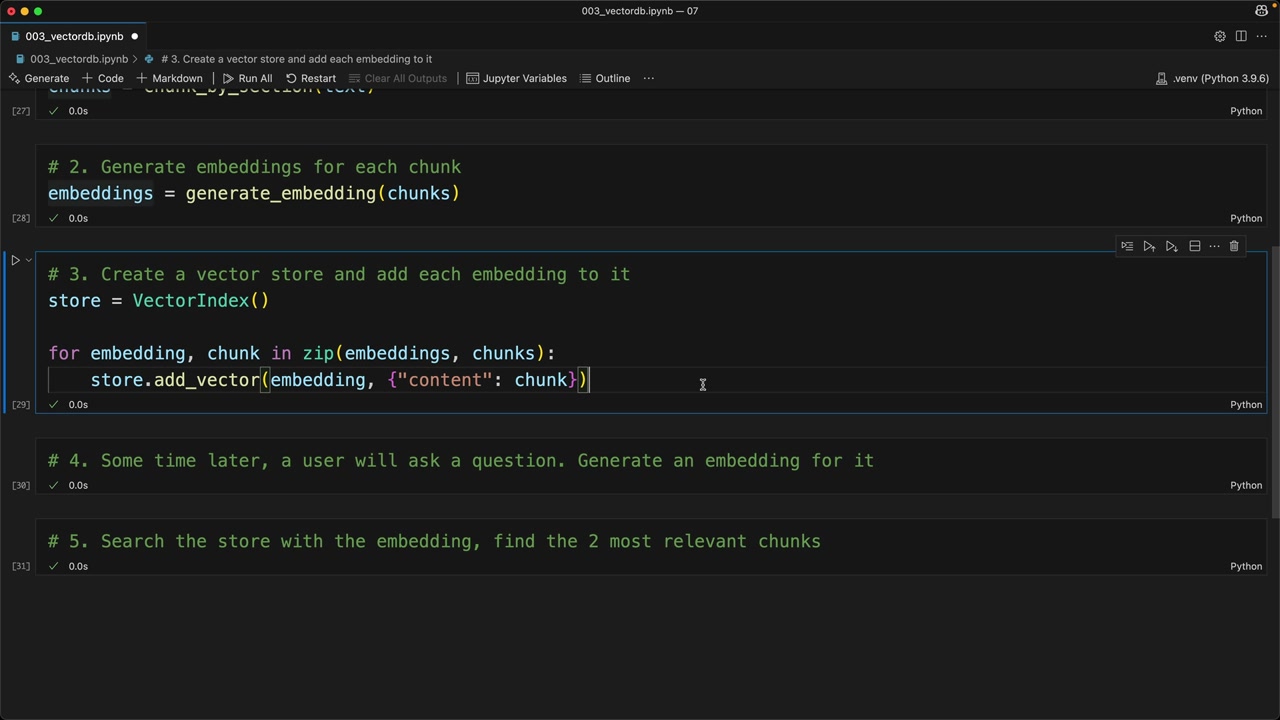
- ベクトルストアを作成し、各埋め込みをそこに追加する
- ユーザーの質問の埋め込みを生成する
- ストアを検索して最も関連性の高いチャンクを見つける
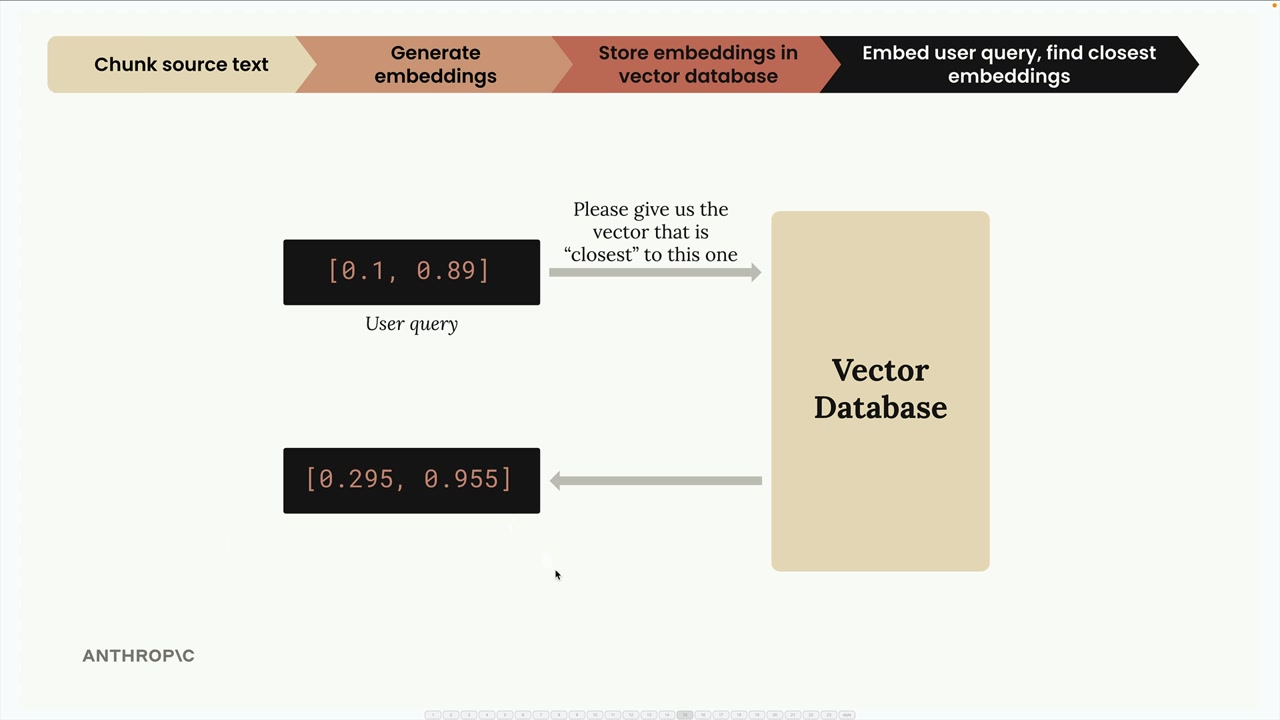
この図は、ユーザーのクエリをどのように埋め込みに変換し、ベクトルデータベースを検索して最も関連性の高いコンテンツを見つけるかを示しています。
ステップ1: テキストのチャンク化
まず、ドキュメントを読み込み、管理しやすいセクションに分割します。
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2] # Test to see the table of contents先ほどと同じchunk_by_section関数を使用して、ドキュメントを論理的なセクションに分割します。
ステップ2: 埋め込みの生成
次に、すべてのチャンクに対して一度に埋め込みを作成します。
embeddings = generate_embedding(chunks)この埋め込み関数は、単一の文字列と文字列のリストの両方を扱えるように更新されており、バッチ処理の効率が向上しています。
ステップ3: ベクトルデータベースへの保存
次に、ベクトルストアを作成し、埋め込みとそれに関連するテキストを格納します。
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
埋め込みと元のテキストコンテンツの両方を保存していることに注目してください。これは重要なことです。なぜなら、後で検索する際に、単なる数値の埋め込み値ではなく、実際のテキストを返す必要があるからです。
なぜ元のテキストを保存するのか?
ベクトルデータベースにクエリを実行したとき、埋め込みの数値だけが返ってきても役に立ちません。そうした埋め込みを生成するために使われた実際のテキストが必要です。そのため、データベース内の各埋め込みとともに、元のチャンクのテキスト(または少なくともそれへの参照)を含めているのです。
ステップ4: ユーザークエリの処理
ユーザーが質問をすると、そのクエリの埋め込みを生成します。
user_embedding = generate_embedding("What did the software engineering dept do last year?")ステップ5: 関連コンテンツの検索
最後に、ベクトルストアを検索して最も類似したチャンクを見つけます。
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
この検索により、最も関連性の高い2つのチャンクとその類似度スコア(コサイン距離)が返されます。
検索結果は、ドキュメントのどのセクションがユーザーの質問に最も関連しているかを、類似度スコアとともに示しています。
結果を理解する
ソフトウェアエンジニアリング部門に関するサンプルクエリを実行すると、次のような結果が得られます。
- セクション2: ソフトウェアエンジニアリング — 距離0.71(最も近い一致)
- 方法論セクション — 距離0.72(2番目に近い一致)
距離の値が低いほど類似度が高いことを示すため、セクション2が今回のクエリに最も関連性が高いということになります。
次は何をするか?
この実装は基本的なケースではうまく機能しますが、期待通りに動作しないシナリオも存在します。次のセクションでは、RAGシステムをより堅牢かつ正確にするための改善策を見ていきます。
ここで押さえておくべき要点は、RAGとは本質的に、テキストを数値(埋め込み)に変換し、それらの数値を効率的に保存し、そして数学的な類似性を用いて、ユーザーが質問をしたときに関連コンテンツを見つけるということです。