Claudeが提供されたドキュメントに基づいて質問に答える際、ユーザーはそれが単に訓練データから引用していると思うかもしれません。しかし、Claudeが特定の情報をどこで見つけたかを正確に示すことができたらどうでしょうか?そこで役立つのが引用機能です。これは、Claudeがソースドキュメントの特定の部分を参照し、各情報がどこから来たのかをユーザーに正確に示すことができる強力な機能です。
引用が重要な理由
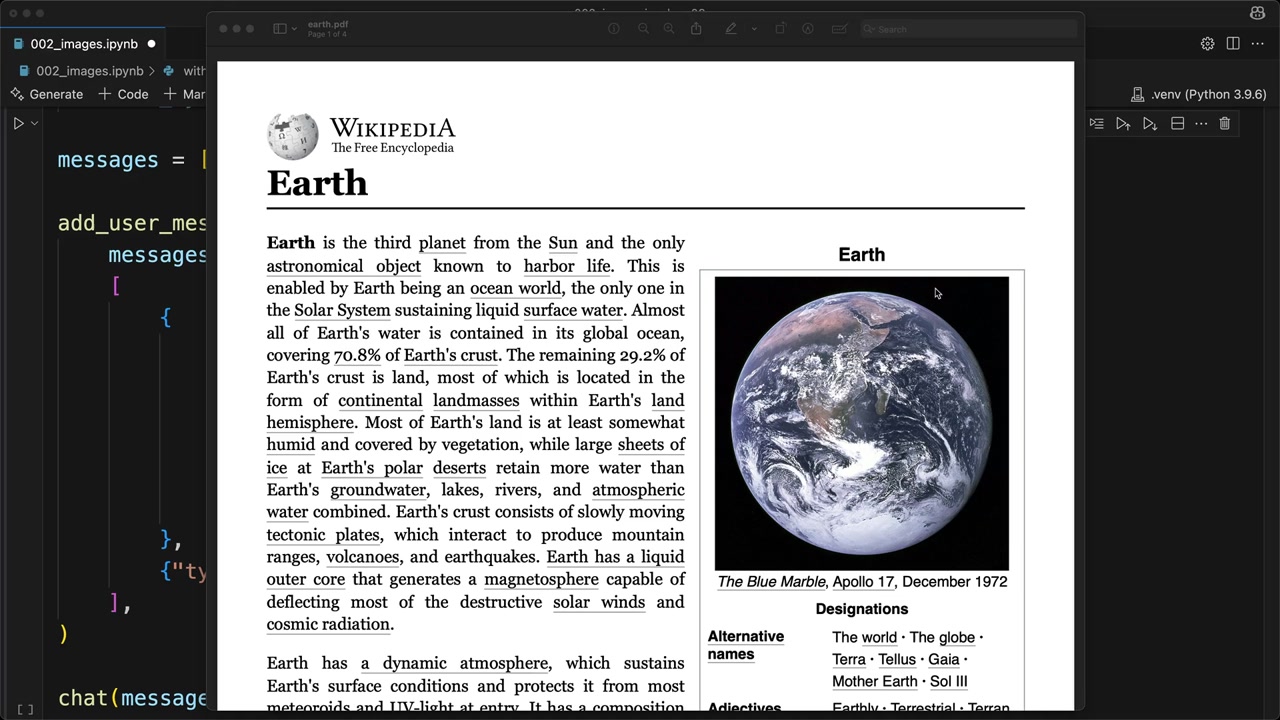
地球の大気がどのように形成されたかについてClaudeに質問し、詳細な回答を得る場面を想像してください。引用がなければ、ユーザーはその情報を検証する方法がなく、Claudeが実際に提供された特定のドキュメントを参照していることを理解することもできません。引用は、Claudeの回答からソース資料までの明確な経路を作成することで、この透明性の問題を解決します。
引用の有効化
引用を有効にするには、ドキュメントメッセージの構造を変更する必要があります。ドキュメントブロックに2つの新しいフィールドを追加します。
{
    "type": "document",
    "source": {
        "type": "base64",
        "media_type": "application/pdf",
        "data": file_bytes,
    },
    "title": "earth.pdf",
    "citations": { "enabled": True }
}titleフィールドはドキュメントに読みやすい名前を付け、citations: {"enabled": True}はClaudeに情報を見つけた場所を追跡するよう指示します。
引用構造の理解
引用が有効になると、Claudeの応答はより複雑になります。単純なテキストの代わりに、各主張に対する引用情報を含む構造化データが得られます。
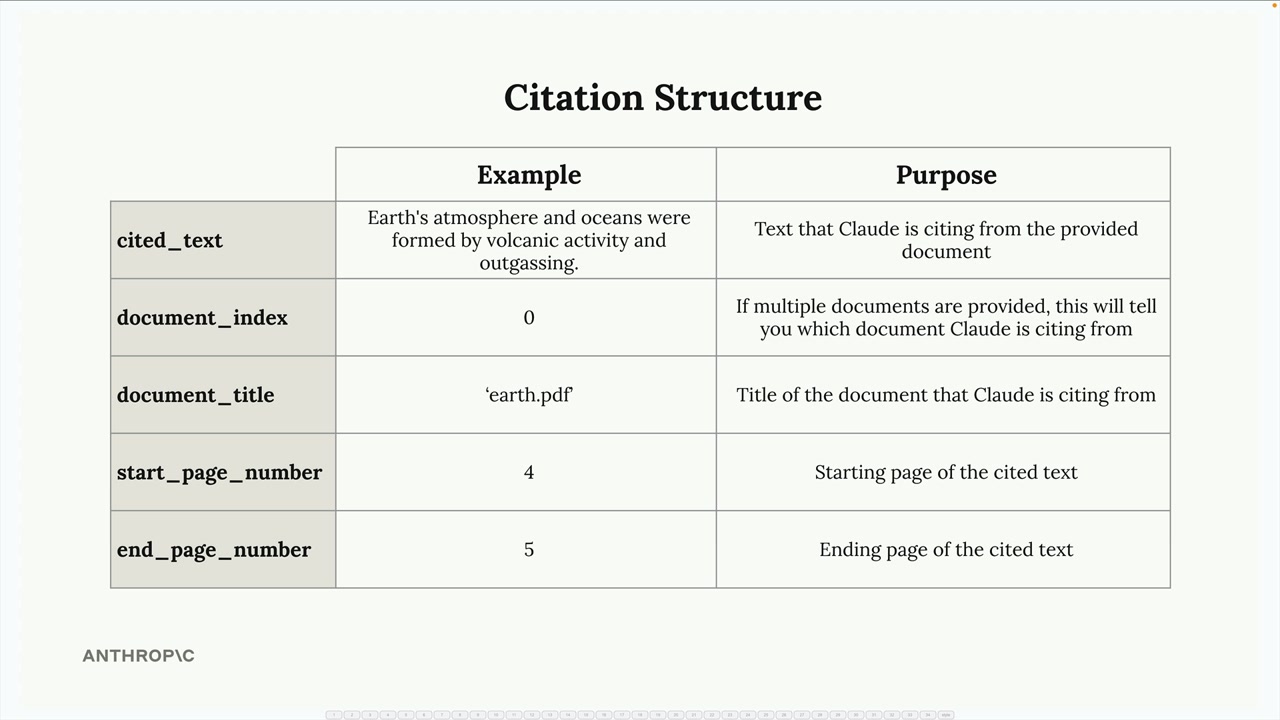
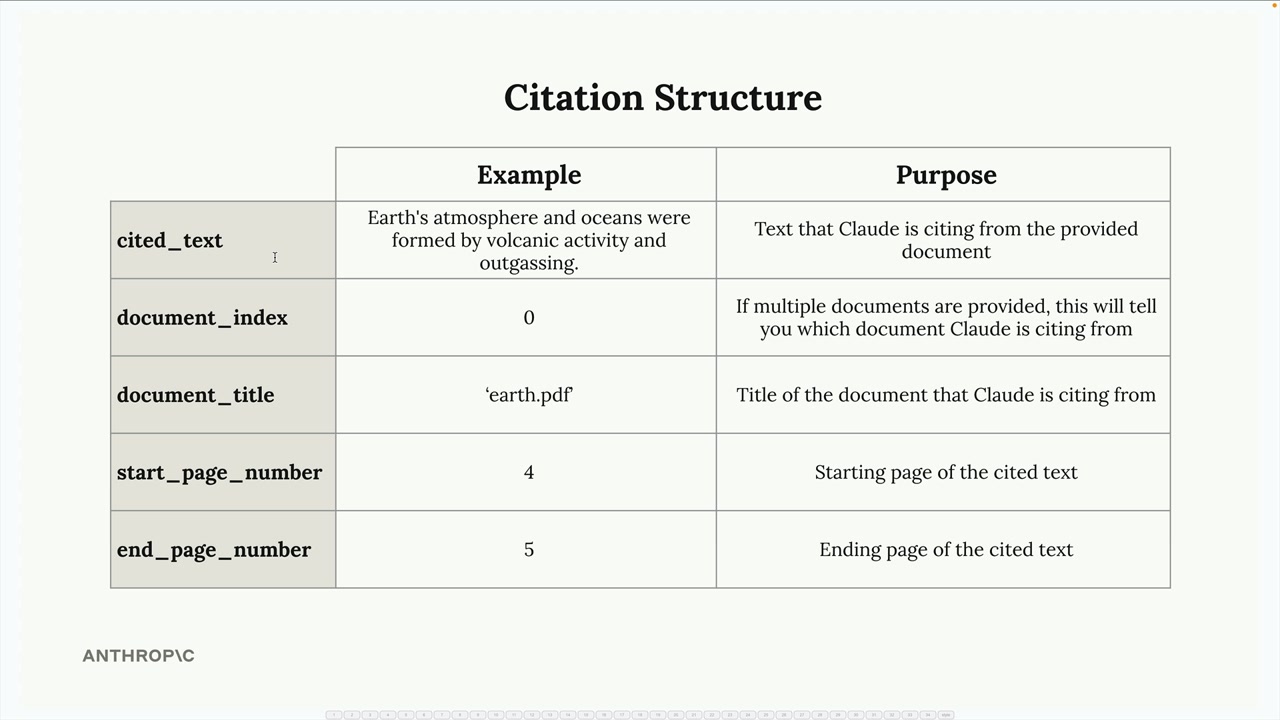
各引用には、いくつかの重要な情報が含まれています。
- cited_text - Claudeの発言を裏付けるドキュメント内の正確なテキスト
- document_index - Claudeが参照しているドキュメント(複数のドキュメントを提供する場合に便利)
- document_title - ドキュメントに割り当てたタイトル
- start_page_number - 引用テキストが始まる位置
- end_page_number - 引用テキストが終わる位置
引用を使ったユーザーインターフェースの構築
引用の本当の力は、この情報をアクセス可能にするユーザーインターフェースを構築することから生まれます。ユーザーが引用マーカーにホバーすることで、情報がどこから来たのかを正確に確認できるインタラクティブな要素を作成できます。
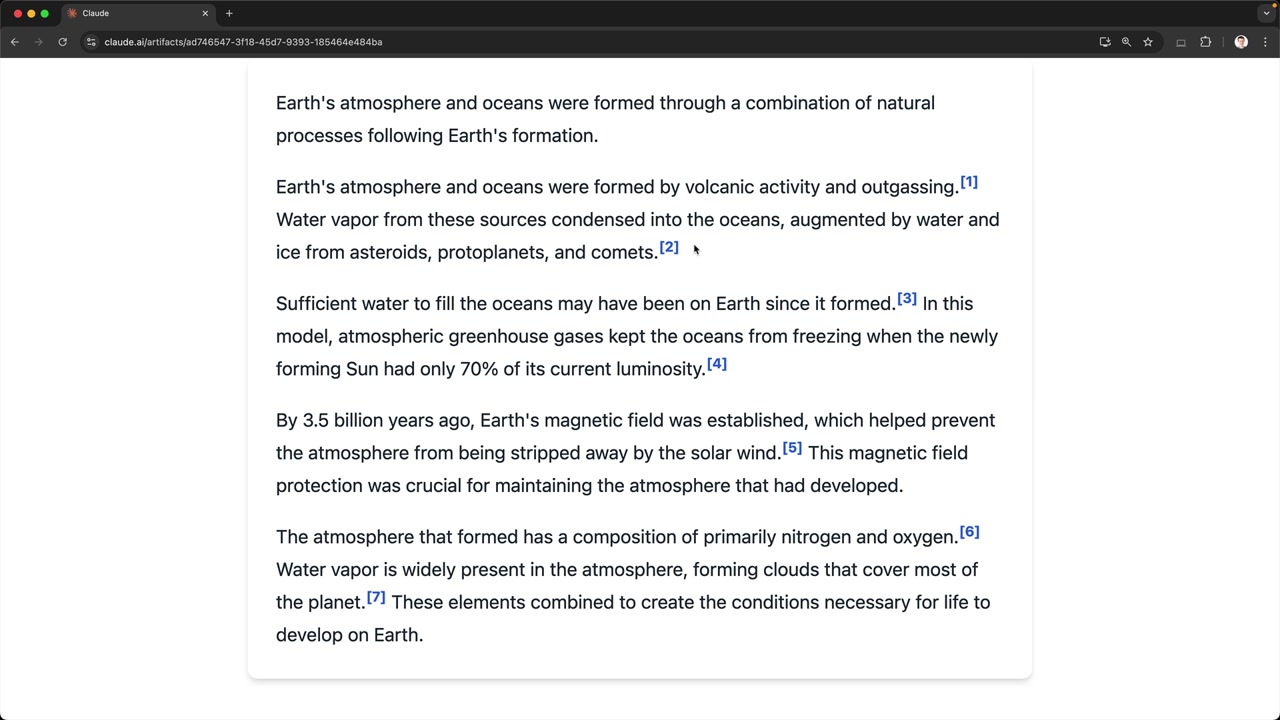
これにより、ユーザーが以下のことができる透明な体験が生まれます。
- Claudeの回答が実際のソース資料に基づいていることを確認する
- 元のドキュメントを確認して情報を検証する
- 引用された各情報の周辺のコンテキストを理解する
プレーンテキストでの引用
引用はPDFドキュメントに限定されません。プレーンテキストのソースでも使用できます。テキストを扱う場合は、次のようにドキュメント構造を変更します。
{
    "type": "document",
    "source": {
        "type": "text",
        "media_type": "text/plain",
        "data": article_text,
    },
    "title": "earth_article",
    "citations": { "enabled": True }
}
プレーンテキストのソースでは、ページ番号の代わりに、Claudeがテキスト内のどこで各情報を見つけたかを正確に示す文字位置が得られます。
引用を使用すべき場面
引用は特に以下の場合に価値があります。
- ユーザーが正確性のために情報を検証する必要がある場合
- ユーザーが参照できるべき権威あるドキュメントを扱っている場合
- アプリケーションにとって情報源の透明性が重要な場合
- ユーザーが特定の事実に関するより広いコンテキストを探りたい場合
引用を実装することで、Claudeを単に答えを提供する「ブラックボックス」から、その作業過程を示す透明な研究アシスタントへと変えることができます。これによりユーザーの信頼が構築され、必要に応じてソース資料をより深く掘り下げることができるようになります。