読み込み中
Claudeは、PDFファイルを直接読み取り、分析できるため、ドキュメント処理において強力なツールとなります。この機能は画像処理と似た仕組みですが、コードの構成方法にいくつか重要な違いがあります。
PDF処理のセットアップ
ClaudeでPDFファイルを処理するには、画像で使用するものとほぼ同一のコードを使用します。主な違いは、ファイルタイプの指定と、わかりやすくするための変数名にあります。
既存の画像処理コードをPDF用に修正する方法は次のとおりです。
python
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
画像処理からの主な変更点
画像処理用のコードをPDF用に適応させる際には、いくつかの要素を更新する必要があります。
- ファイル拡張子を
.pngから.pdfに変更する - わかりやすくするために、変数名を
image_bytesからfile_bytesに更新する - タイプを
"image"ではなく"document"に設定する - メディアタイプを
"image/png"ではなく"application/pdf"に変更する
ClaudeがPDFから抽出できる内容
Claudeの PDF処理機能は、単純なテキスト抽出にとどまりません。Claudeは以下を分析し、理解できます。
- ドキュメント全体にわたるテキスト内容
- PDFに埋め込まれた画像やグラフ
- 表とそのデータの関係性
- ドキュメントの構造とフォーマット
これにより、Claudeは要約、データ分析、特定のコンテンツ抽出など、PDFドキュメントからあらゆる種類の情報を抽出するためのワンストップソリューションとして機能します。
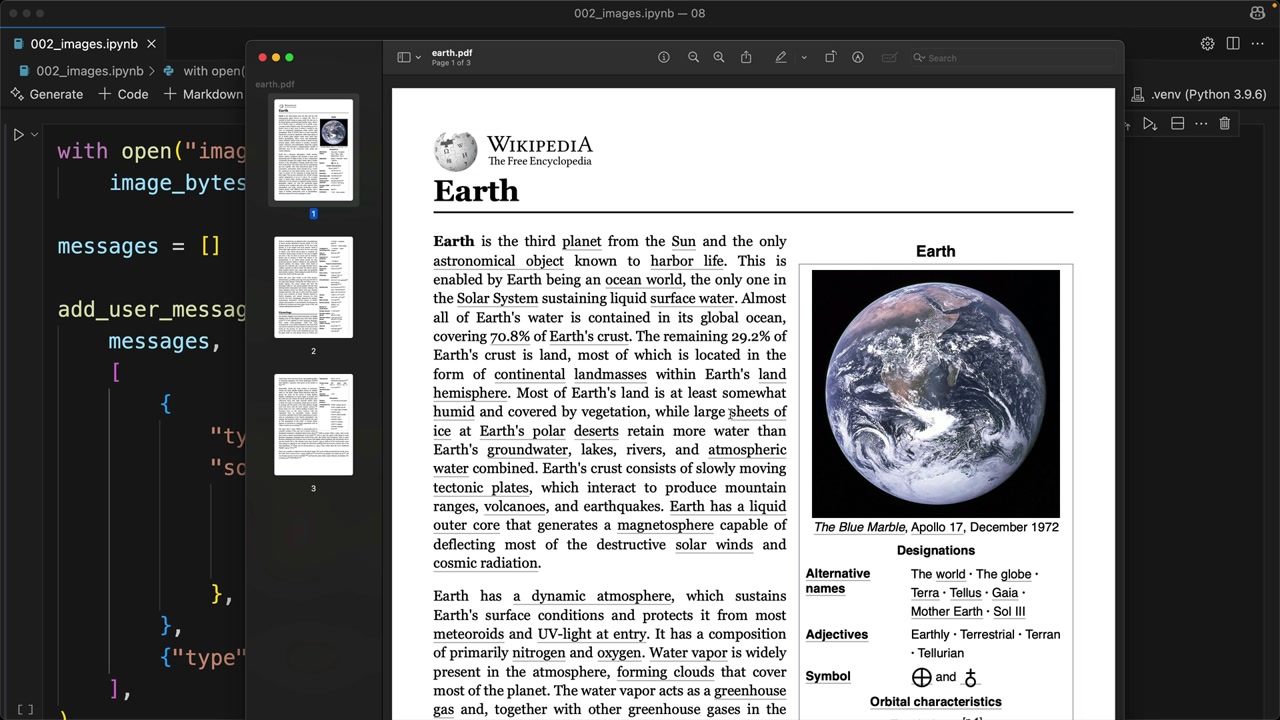
上記の例では、PDFとして保存された地球に関するWikipedia記事をClaudeが正常に処理し、複雑なドキュメントの内容を1つの文で理解し、要約できることを示しています。