テキストチャンキングは、RAG(Retrieval Augmented Generation)パイプラインを構築する上で最も重要なステップの一つです。ドキュメントをどのように分割するかは、システム全体の品質に直接影響します。チャンキング戦略が不適切だと、プロンプトに無関係なコンテキストが挿入され、AIがまったく見当違いの回答をしてしまう原因になります。
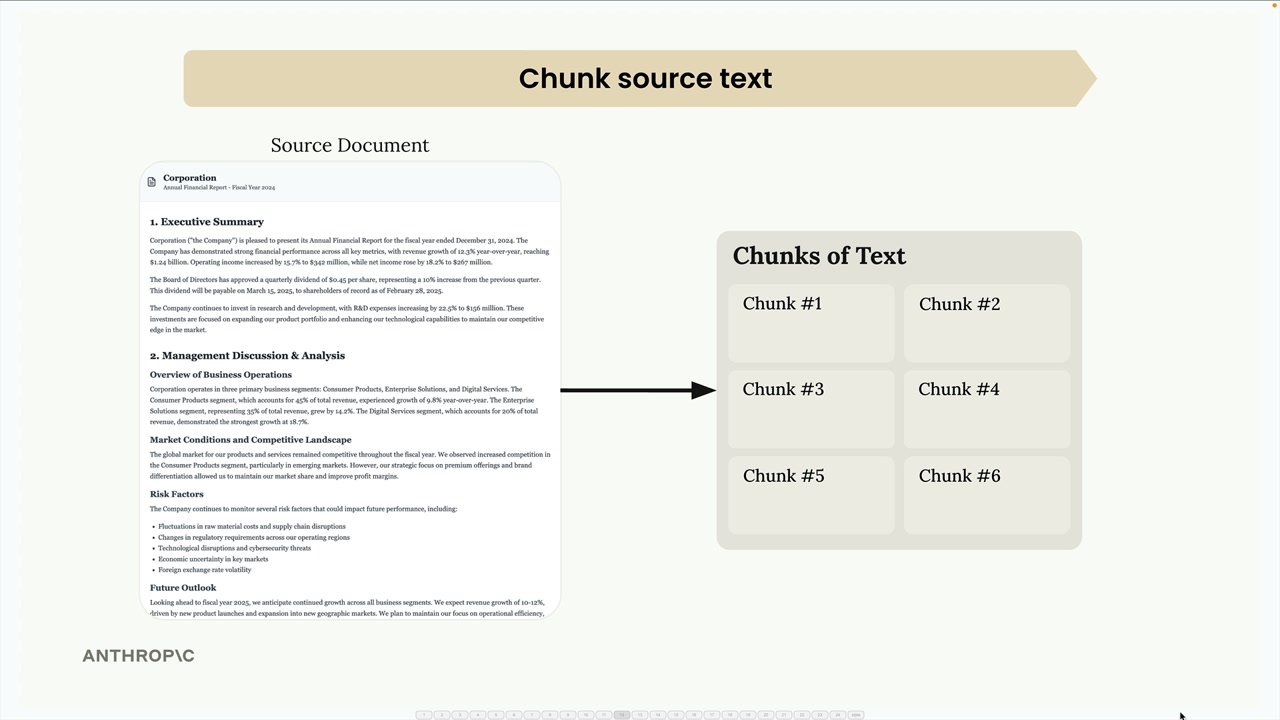
次の例を考えてみましょう。医療研究とソフトウェアエンジニアリングに関するセクションを含むドキュメントがあるとします。チャンキングが不適切だと、「今年エンジニアは何件のバグを修正しましたか?」というユーザーの質問に対して、医療研究セクションに別の文脈で「bug(虫・バグ)」という単語がたまたま含まれていたために、ソフトウェアエンジニアリングではなく医療研究に関する情報が返ってきてしまうことがあります。
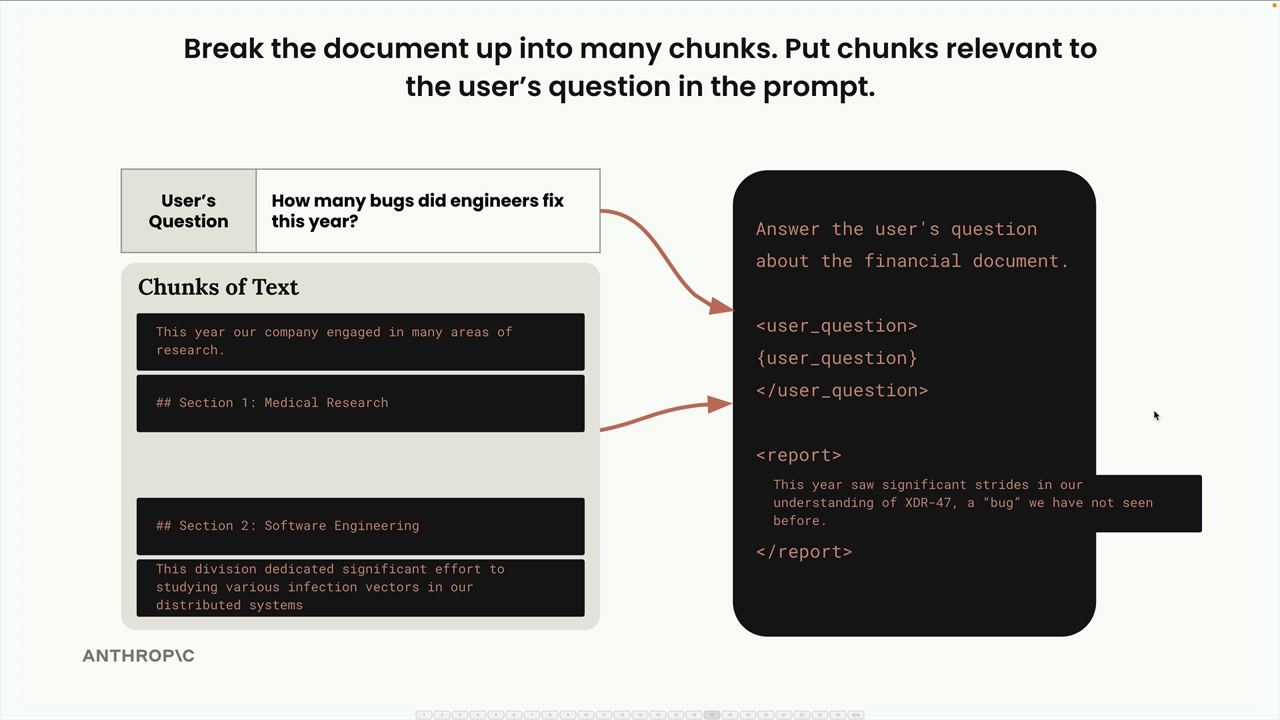
だからこそ、適切なチャンキング戦略を選ぶことがとても重要なのです。ここでは3つの主要なアプローチを見ていきましょう。
サイズベースのチャンキング
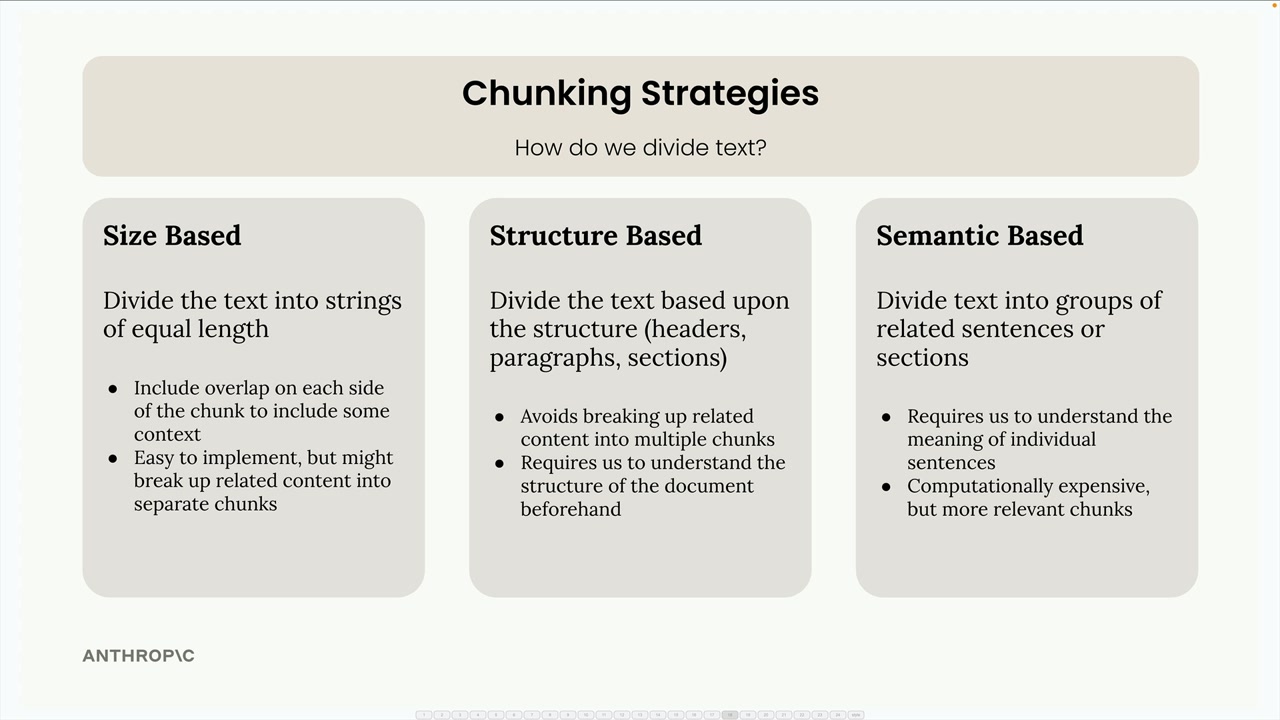
サイズベースのチャンキングは最もシンプルな手法で、テキストを等しい長さの文字列に分割します。325文字のドキュメントがある場合、それぞれ約108文字の3つのチャンクに分割することになります。
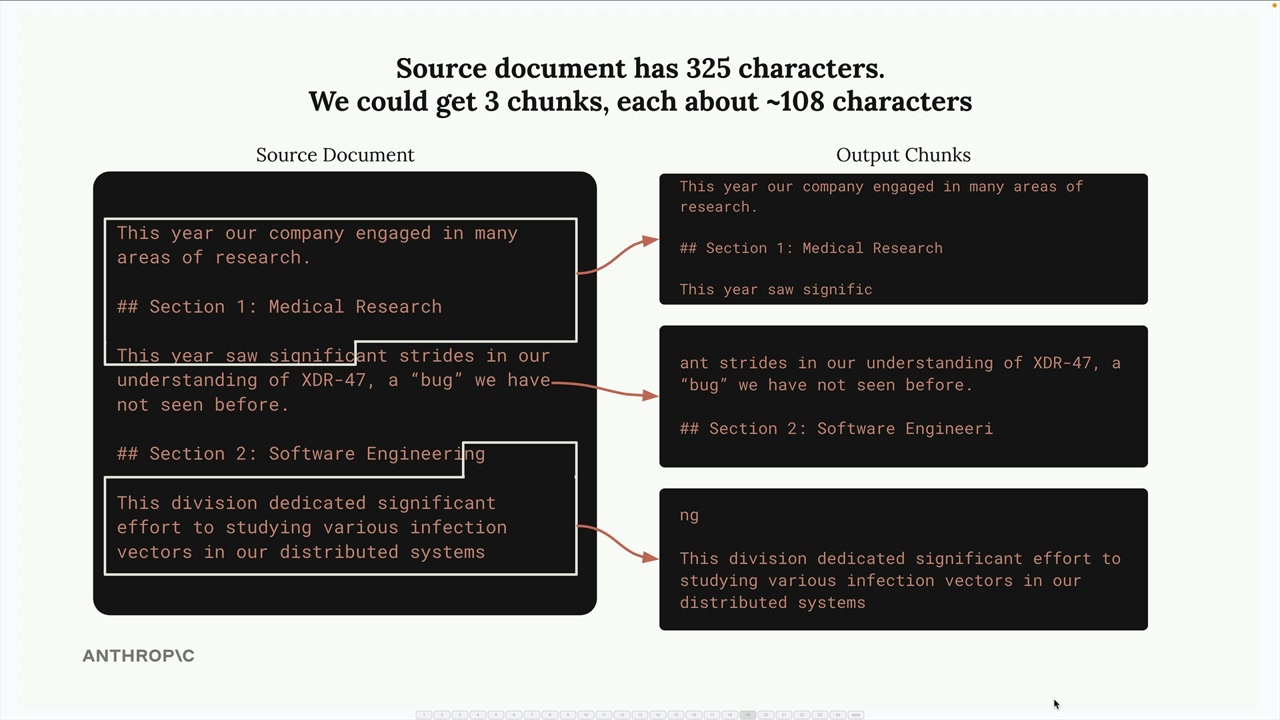
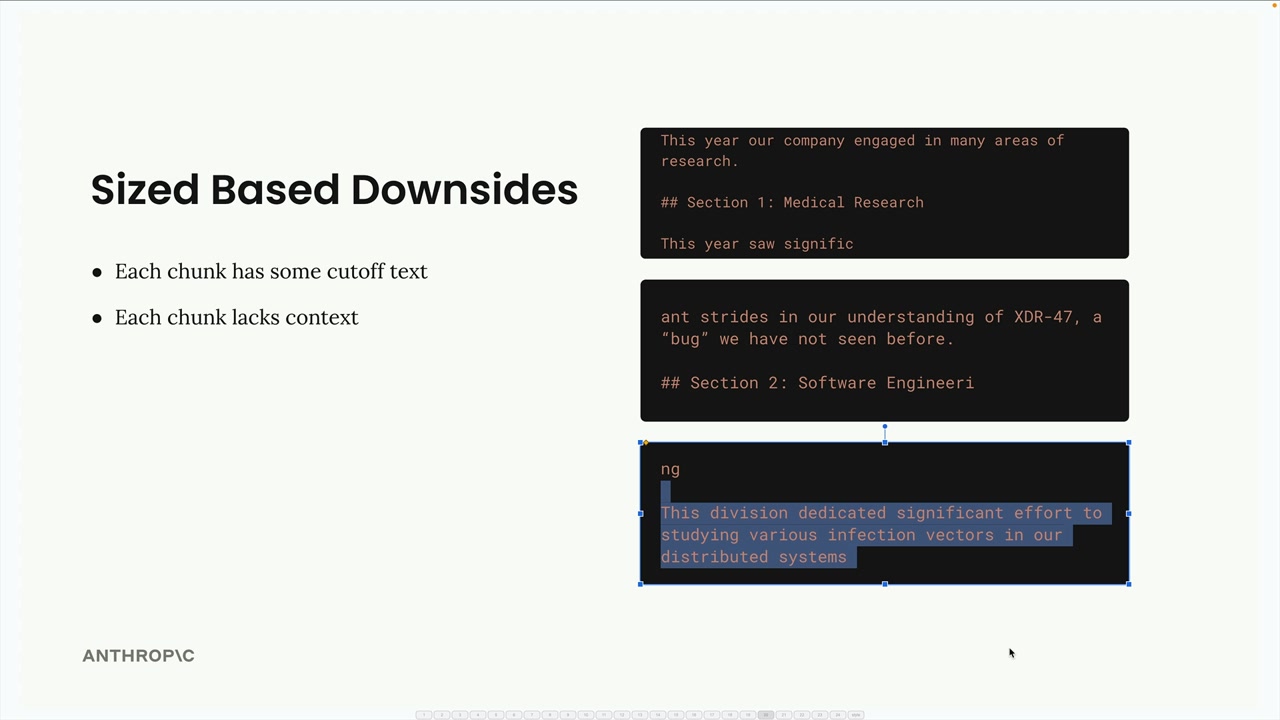
この方法は実装が簡単で、どんな種類のドキュメントにも使えますが、明確な欠点があります。
- 単語が文の途中で切れてしまう
- チャンクが周囲のテキストから重要なコンテキストを失ってしまう
- セクションの見出しがその内容から分離されてしまうことがある
こうした問題に対処するために、チャンク間にオーバーラップ(重複)を追加できます。これにより、各チャンクは隣接するチャンクの一部の文字を含むようになり、より良いコンテキストが得られ、単語や文が完全な形で維持されます。
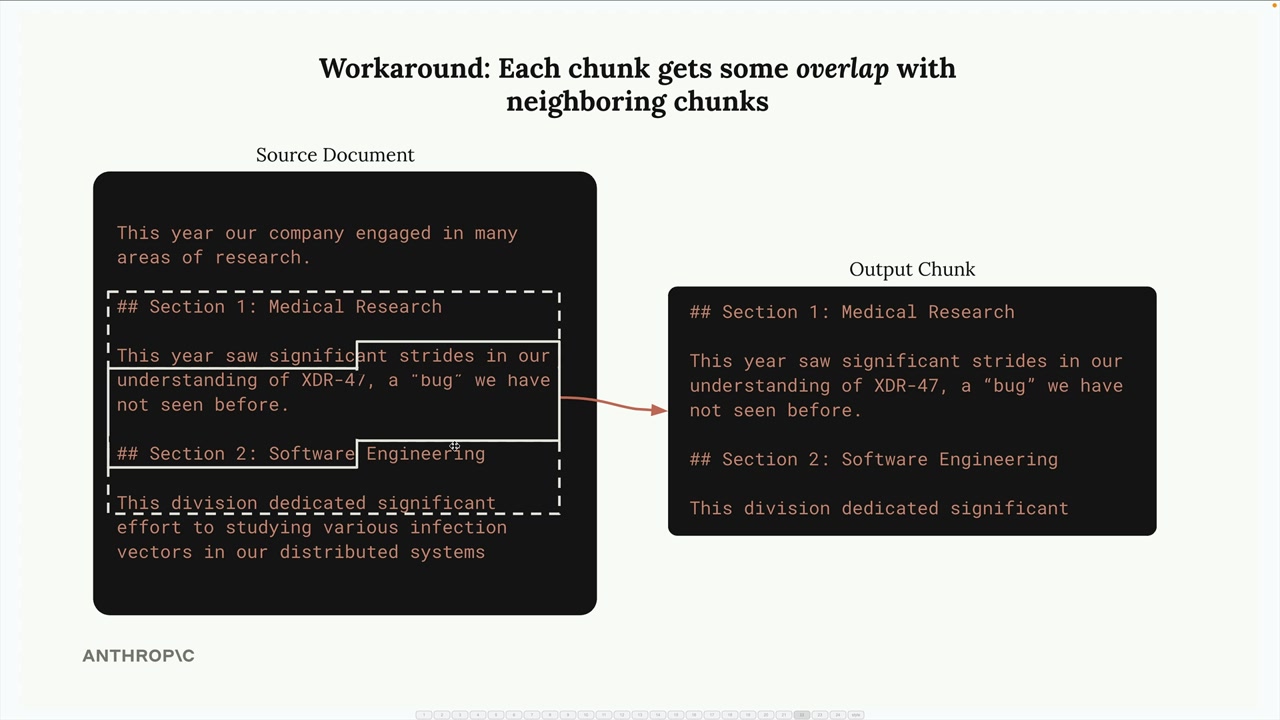
基本的な実装例はこちらです。
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
構造ベースのチャンキング
構造ベースのチャンキングは、見出し、段落、セクションといったドキュメントの自然な構造に基づいてテキストを分割します。これは、Markdownファイルのように整形済みのドキュメントがある場合にうまく機能します。
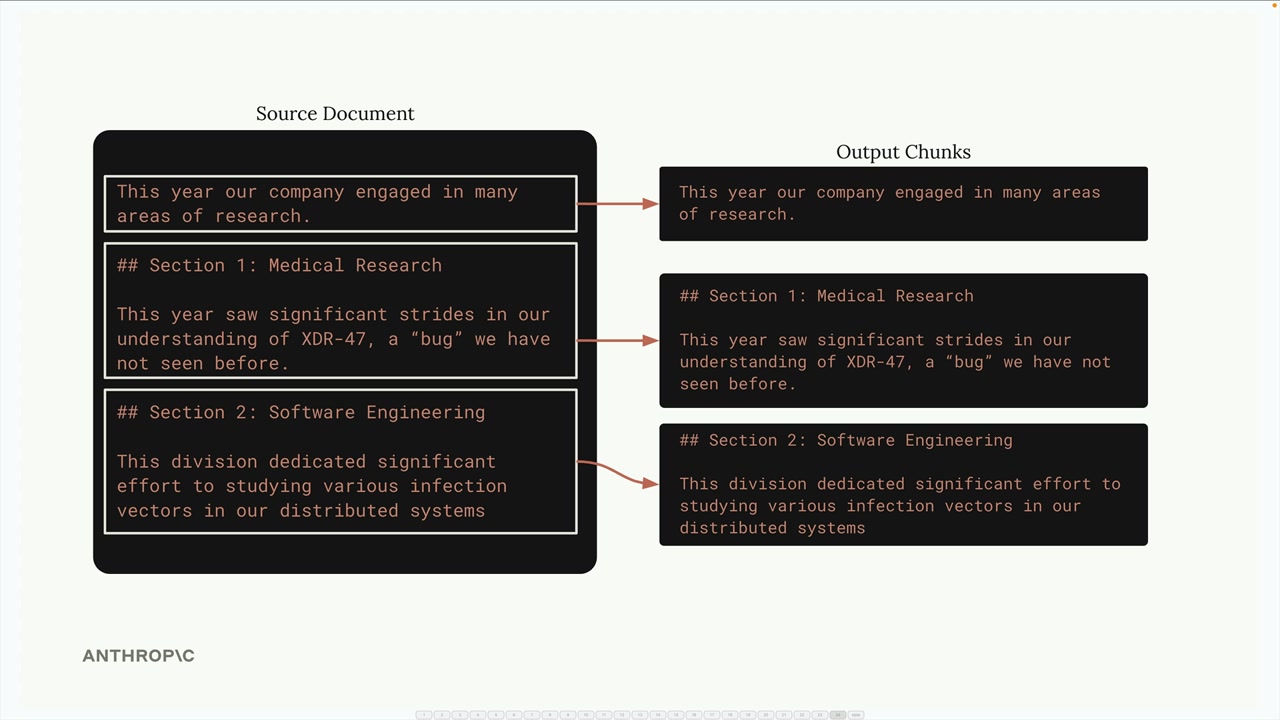
Markdownドキュメントの場合、見出しマーカーで分割できます。
import re

def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
このアプローチは、各チャンクが完全なセクションを表すため、最もクリーンで意味のあるチャンクを得ることができます。ただし、ドキュメントの構造が保証されている場合にのみ機能します。実際の多くのドキュメントは、明確な構造マーカーのないプレーンテキストやPDFです。
セマンティックベースのチャンキング
セマンティックベースのチャンキングは最も高度なアプローチです。テキストを文単位に分割し、自然言語処理を使って連続する文同士がどの程度関連しているかを判定します。そして、関連する文のグループからチャンクを構築します。
この方法は計算コストが高いものの、最も関連性の高いチャンクを生成します。個々の文の意味を理解する必要があり、他の戦略よりも実装が複雑になります。
文ベースのチャンキング
実用的な折衷案として、文単位でチャンキングする方法があります。正規表現を使ってテキストを個々の文に分割し、それらをオプションのオーバーラップ付きでチャンクにグループ化します。
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)

    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
戦略の選び方
どの戦略を選ぶかは、完全にあなたのユースケースとドキュメントの保証内容次第です。
- 構造ベース:ドキュメントの形式を自分で管理できる場合(社内レポートなど)に最良の結果が得られる
- 文ベース:ほとんどのテキストドキュメントに適した良い折衷案
- サイズベース:コードを含むあらゆるコンテンツタイプに対応できる、最も信頼性の高いフォールバック
オーバーラップ付きのサイズベースのチャンキングは、シンプルで信頼性が高く、どんなドキュメントタイプにも対応できるため、多くの場合、本番環境での第一選択肢となっています。完璧な結果が得られるとは限りませんが、パイプラインを破綻させることのない、妥当なチャンクを一貫して生成してくれます。
覚えておいてください。唯一の「最良の」チャンキング戦略というものは存在しません。適切なアプローチは、あなたが扱う具体的なドキュメント、ユースケース、そして実装の複雑さとチャンクの品質との間でどのようなトレードオフを受け入れるかによって決まります。