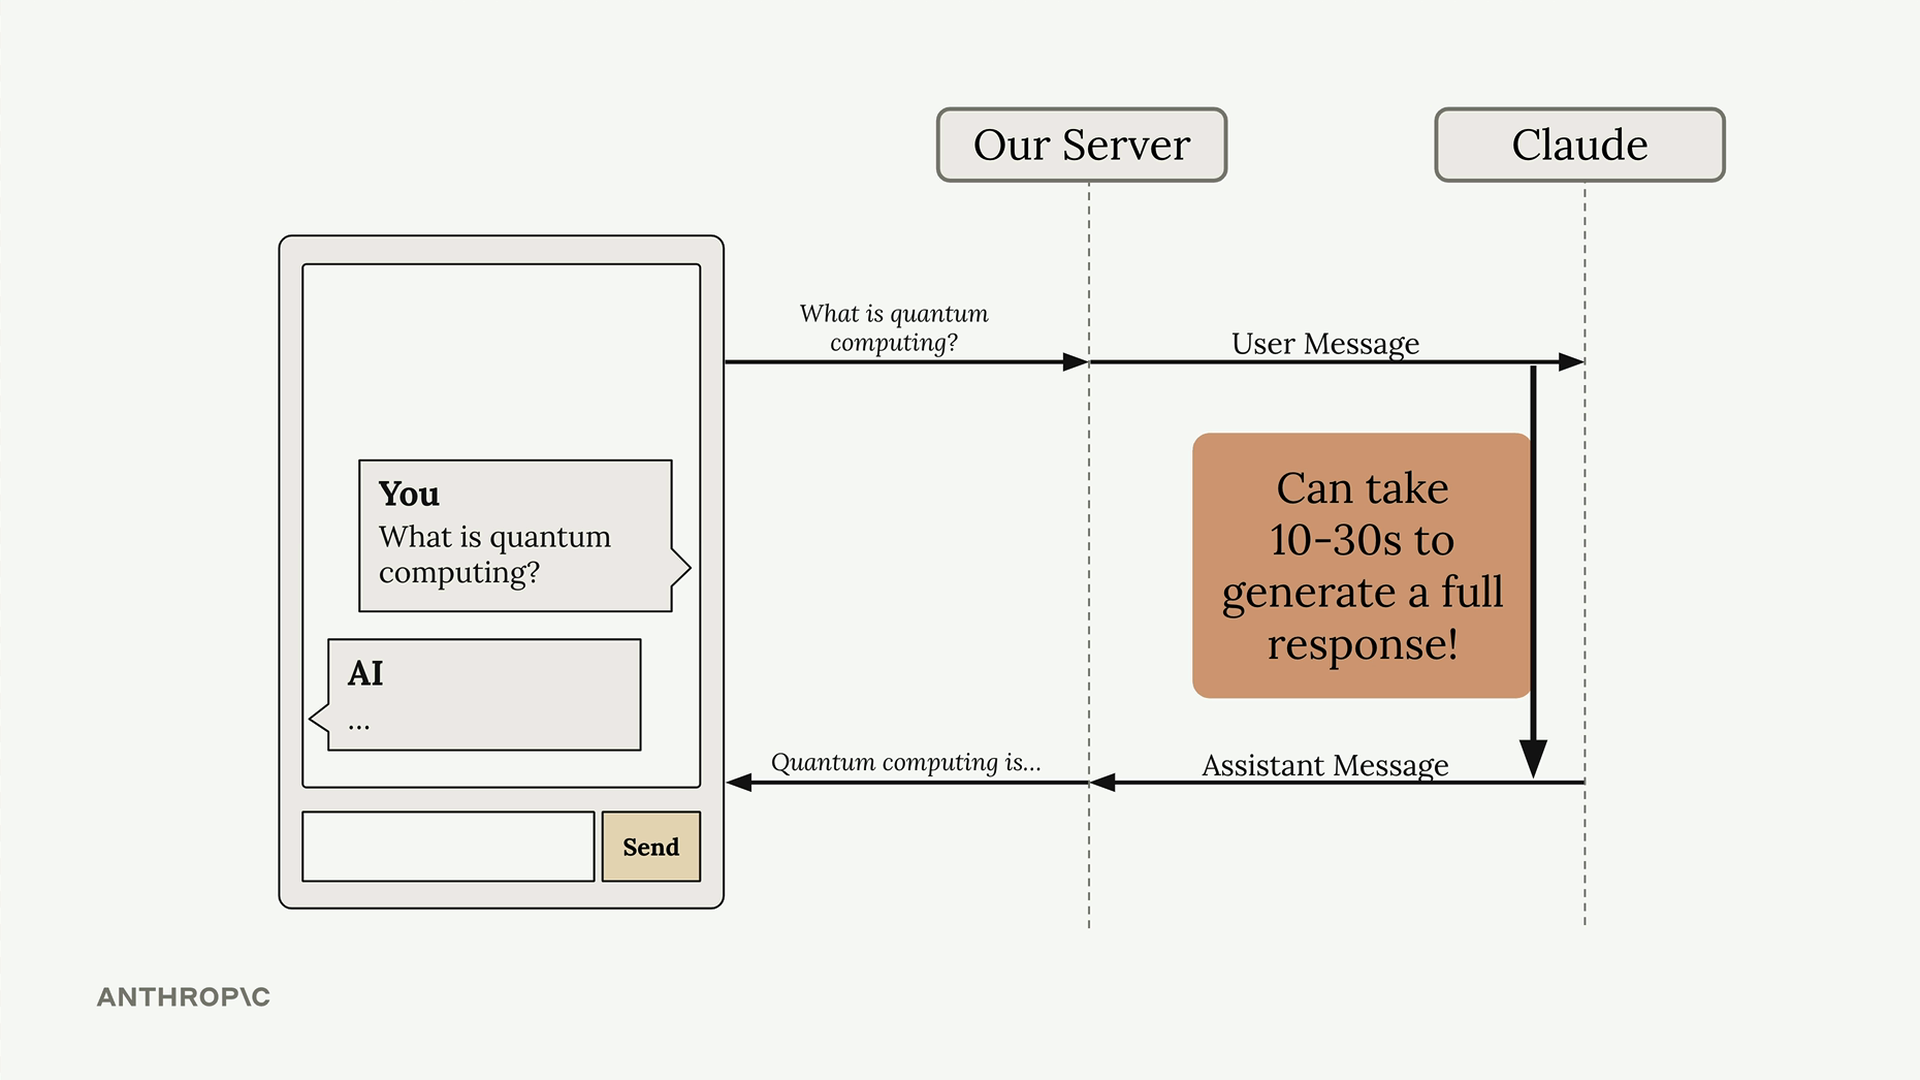
Claudeを使ってチャットアプリケーションを構築する際には、大きなユーザー体験上の課題があります。レスポンスの生成には10〜30秒かかることがあり、その間ユーザーはローディングスピナーを見つめ続けることになります。この解決策がレスポンスのストリーミングです。これにより、Claudeがテキストを生成するのに合わせて、ユーザーはテキストがチャンクごとに表示されるのを見ることができ、はるかに応答性の高い体感を生み出せます。
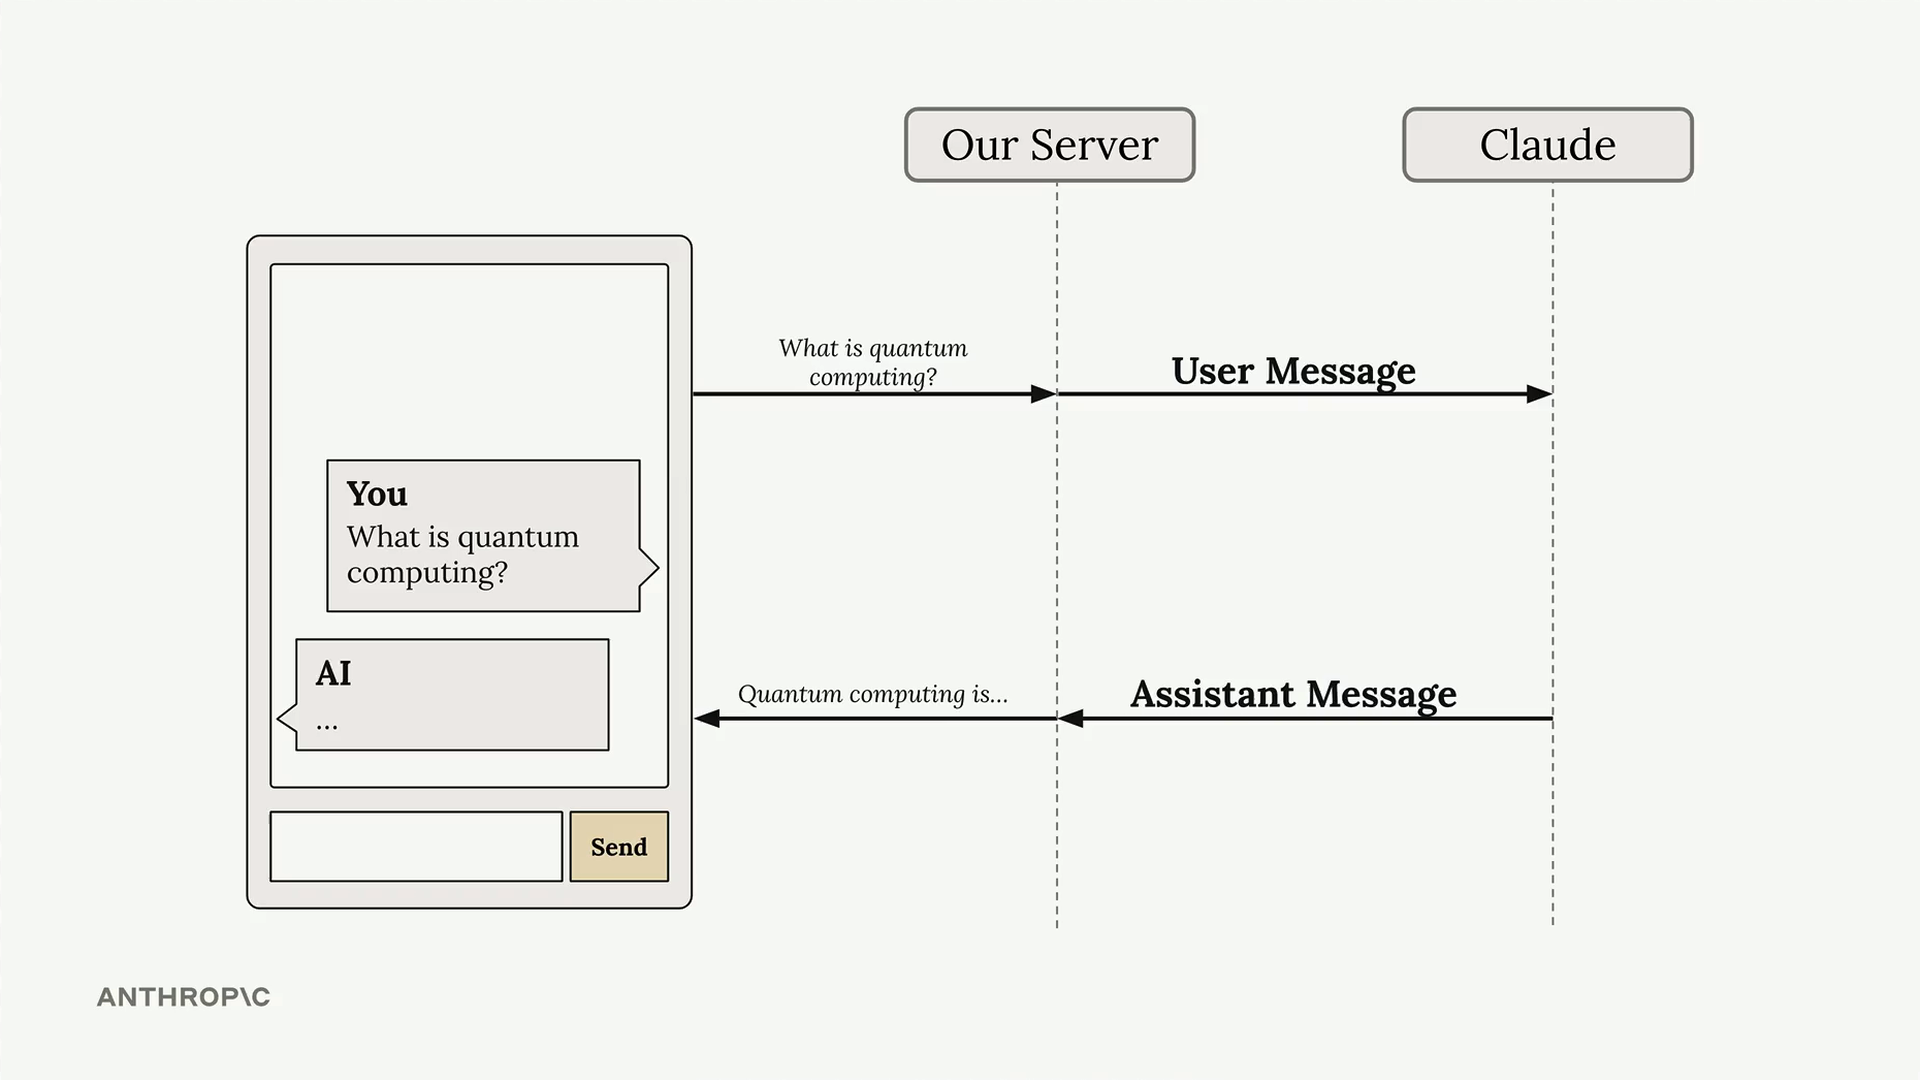
標準的なレスポンスの問題点
典型的なチャット構成では、サーバーはユーザーメッセージをClaudeに送信し、完全なレスポンスが返ってくるのを待ってから、クライアントに何かを送り返します。これにより、何かが起きているというフィードバックがユーザーに一切ないまま、気まずい遅延が生じます。
ストリーミングの仕組み
ストリーミングを有効にすると、Claudeはリクエストを受け取り、テキストの生成を開始したことを示す初期レスポンスを即座に送り返します。その後、一連のイベントを受け取ることになり、それぞれには全体のレスポンスの一部分が含まれています。
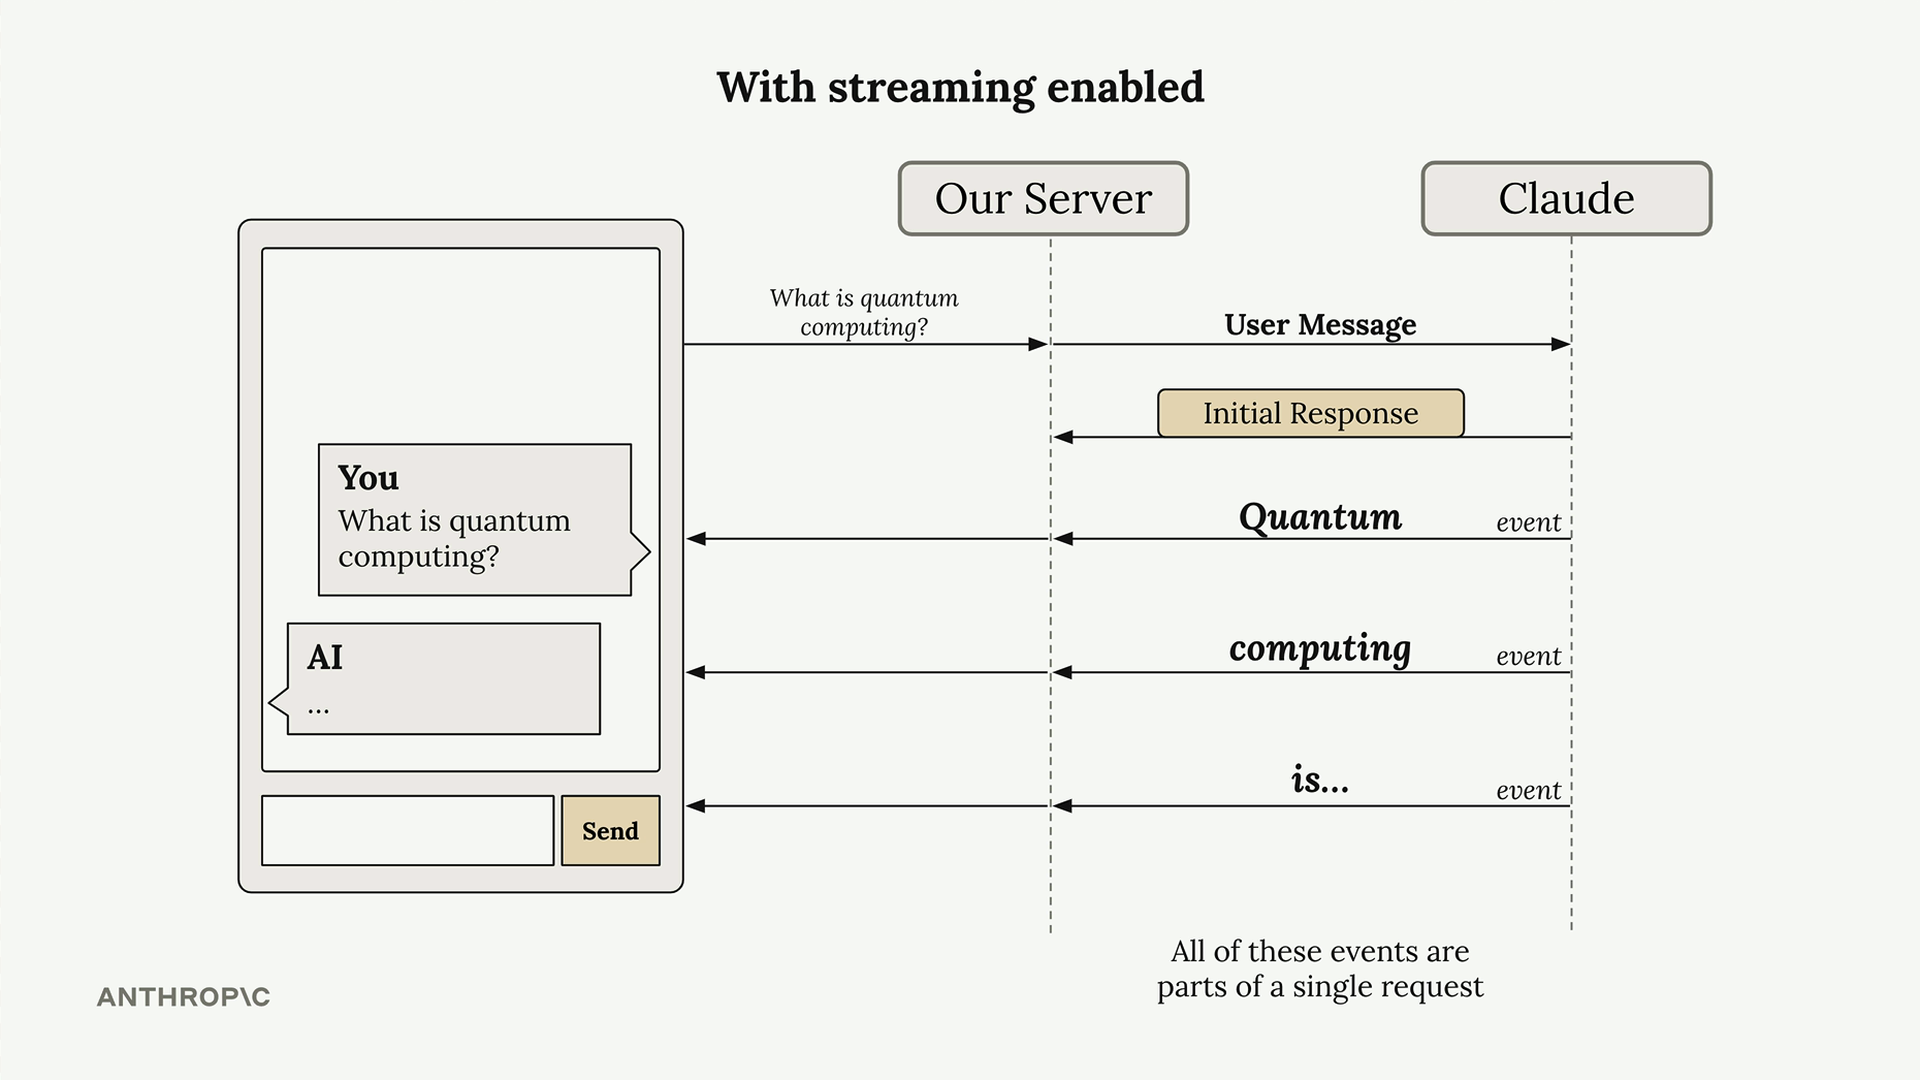
サーバーはこれらのテキストチャンクが届くたびにクライアントアプリケーションへ転送できるため、ユーザーはレスポンスが単語ごとに組み上がっていく様子を見ることができます。これらのイベントはすべて、Claudeへの単一のリクエストの一部です。
ストリームイベントを理解する
ストリーミングを有効にすると、Claudeはいくつかの種類のイベントを送り返します。
- MessageStart - 新しいメッセージが送信されている
- ContentBlockStart - テキスト、ツール使用、その他のコンテンツを含む新しいブロックの開始
- ContentBlockDelta - 実際に生成されたテキストのチャンク
- ContentBlockStop - 現在のコンテンツブロックが完了した
- MessageDelta - 現在のメッセージが完了した
- MessageStop - 現在のメッセージに関する情報の終了
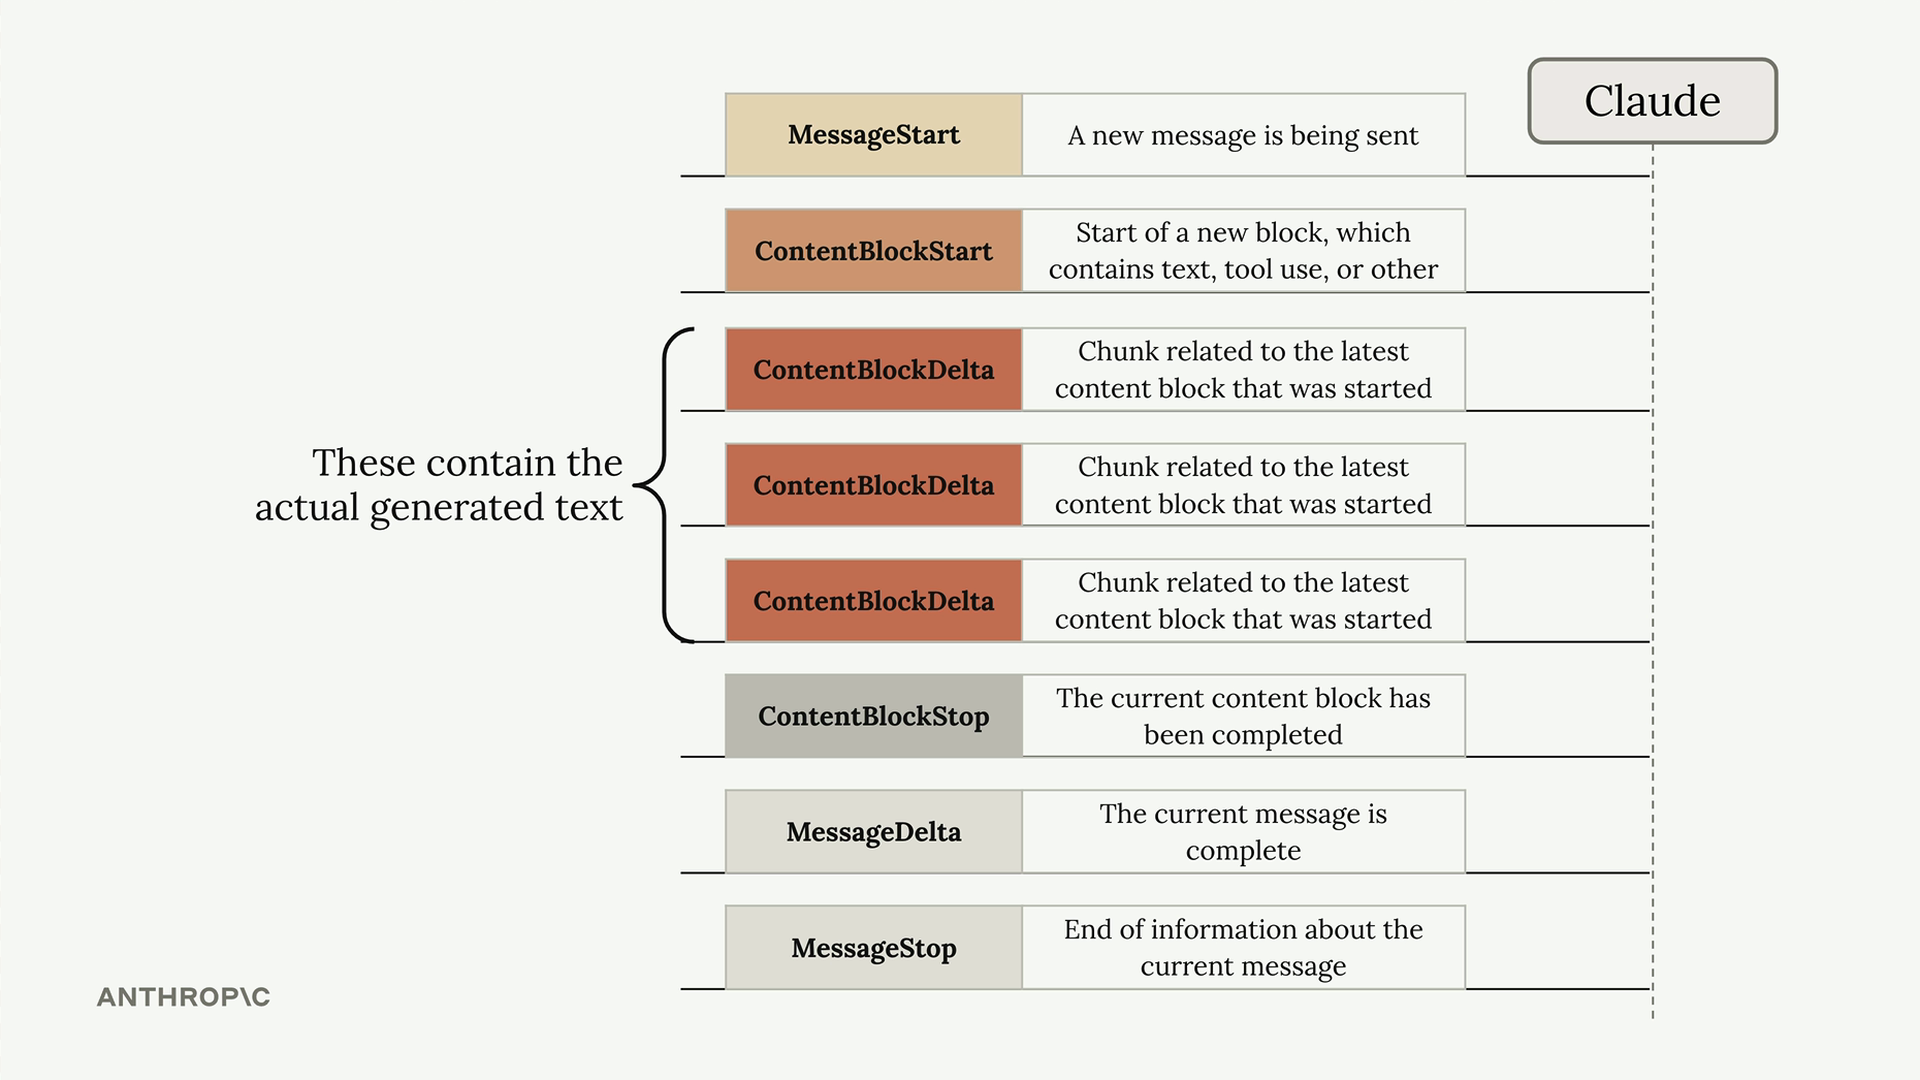
ContentBlockDelta イベントには、ユーザーに表示したい実際の生成テキストが含まれています。
基本的なストリーミングの実装
ストリーミングを有効にするには、messages.create の呼び出しに stream=True を追加します。
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)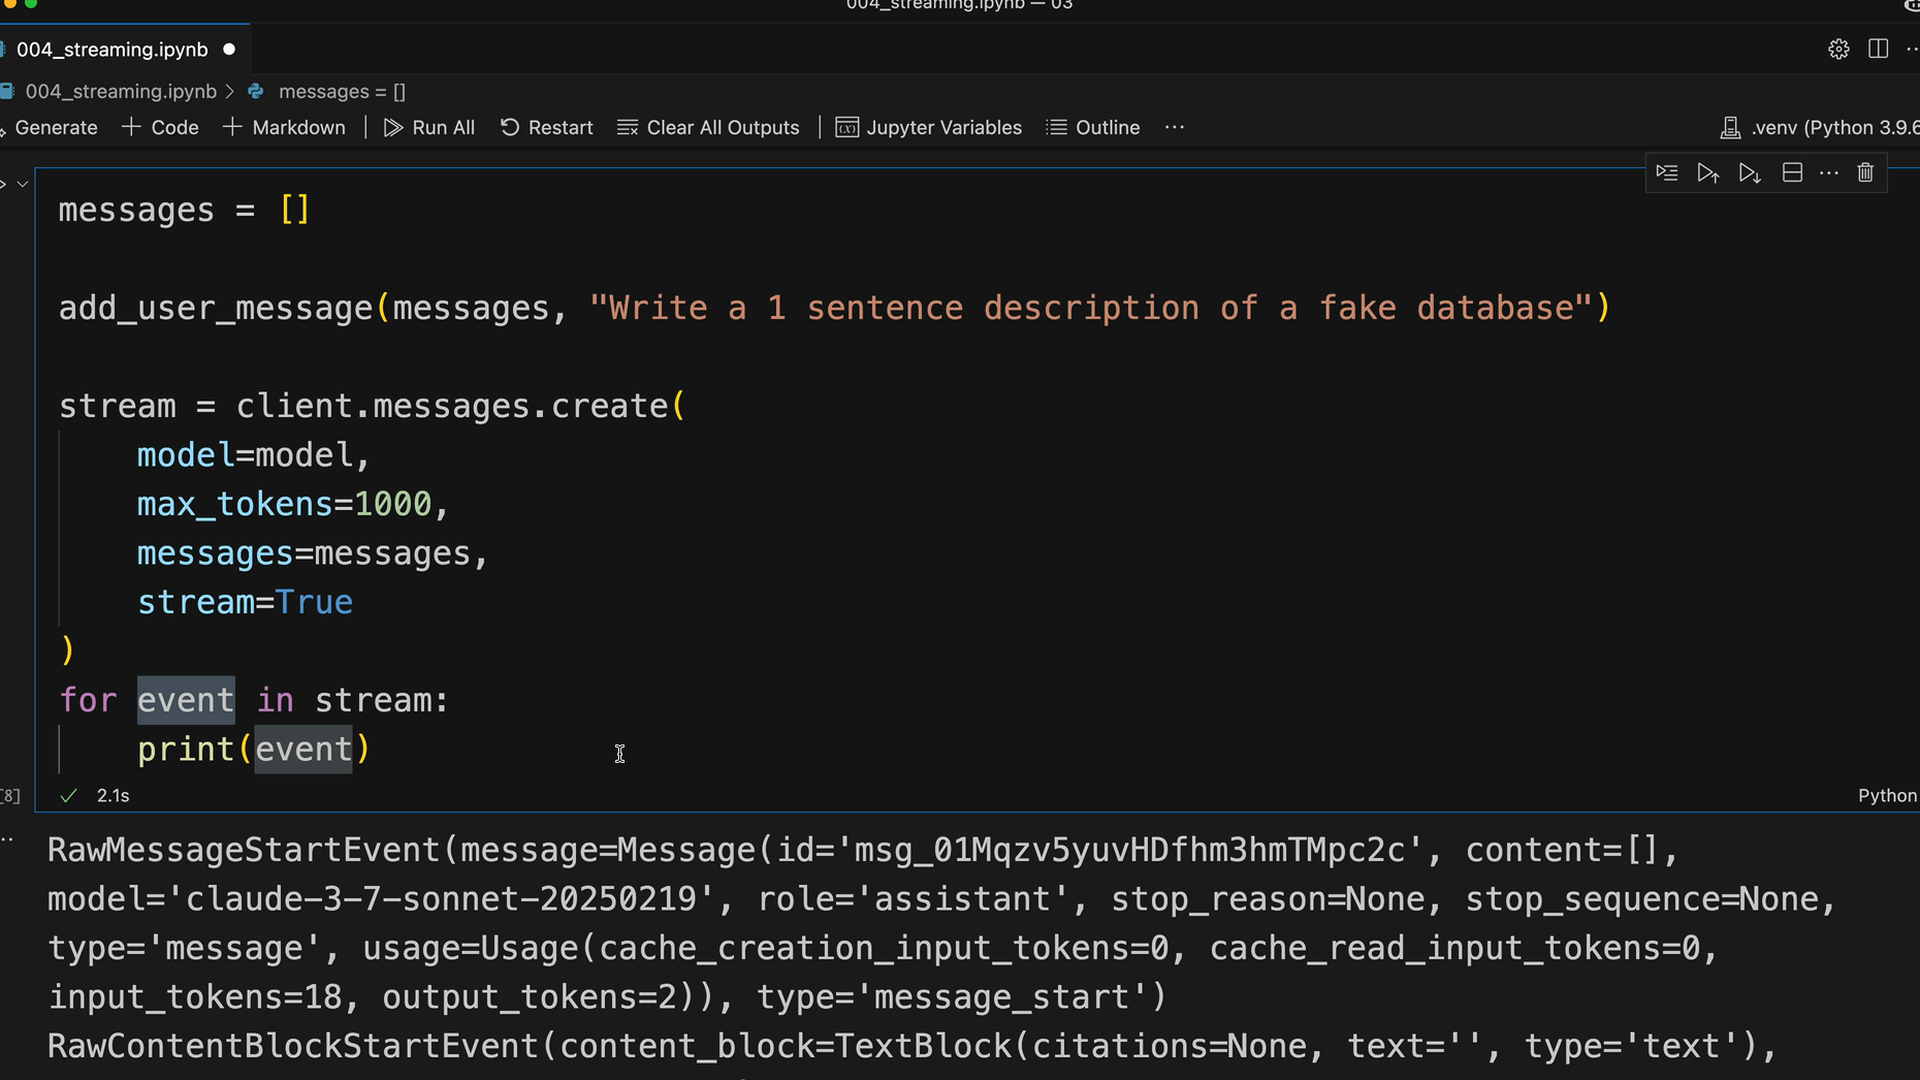
シンプルなテキストストリーミング
イベントを手動でパースする代わりに、実際のテキストコンテンツだけを抽出するSDKのシンプルなストリーミングインターフェースを使用できます。
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
この方法では、実際のテキストコンテンツ以外のすべてが自動的にフィルタリングされて除外されます。これは通常、ユーザーにレスポンスを表示する際に必要となるものです。
完全なメッセージを取得する
個々のチャンクをストリーミングすることはユーザー体験にとって非常に有用ですが、保存やさらなる処理のためには、完全なメッセージが必要になることがよくあります。ストリーミングが完了した後、組み立てられた最終的なメッセージを取得できます。
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # 各チャンクをクライアントに送信
        pass

    # データベース保存用に完全なメッセージを取得
    final_message = stream.get_final_message()
これにより、両方の利点を得ることができます。ユーザーにとってのリアルタイムストリーミングと、アプリケーションのロジックのための完全なメッセージオブジェクトです。