Maintenant que nous avons couvert les bases du RAG, du découpage de texte et des embeddings, parcourons étape par étape le pipeline RAG complet. Cet exemple vous montrera exactement comment toutes ces pièces fonctionnent ensemble pour récupérer des informations pertinentes et générer des réponses.
Étape 1 : découper votre texte source
D'abord, nous prenons notre document source et le découpons en fragments gérables. Pour cet exemple, nous utiliserons deux sections de texte simples :
- Section 1 : Recherche médicale - « Cette année a été marquée par des avancées significatives dans notre compréhension du XDR-47, un « bug » que nous n'avions jamais observé auparavant. »
- Section 2 : Ingénierie logicielle - « Cette division a consacré des efforts considérables à l'étude des divers vecteurs d'infection dans nos systèmes distribués »
Étape 2 : générer des embeddings
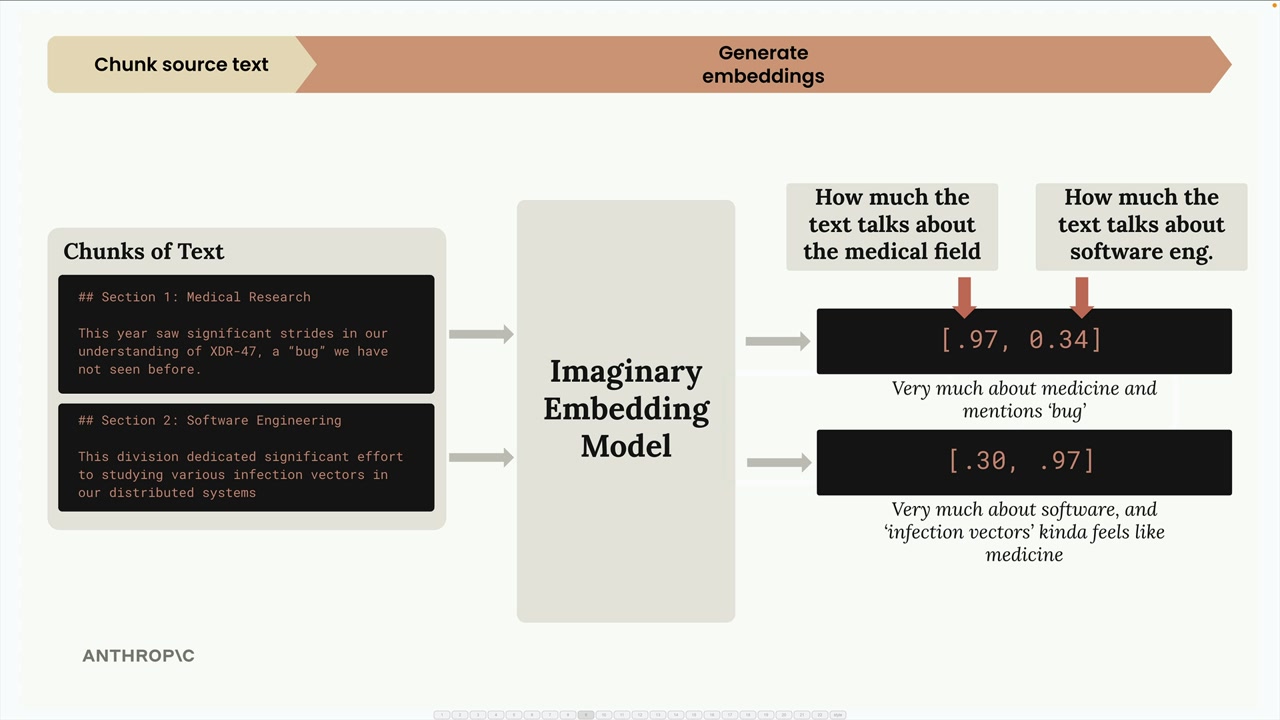
Ensuite, nous convertissons chaque fragment de texte en embeddings numériques à l'aide d'un modèle d'embedding. Pour faciliter la compréhension, imaginons que nous disposons d'un modèle d'embedding parfait qui renvoie toujours exactement deux nombres, et que nous savons ce que représente chaque nombre.
Dans notre modèle imaginaire :
- Le premier nombre représente à quel point le texte parle du domaine médical
- Le second nombre représente à quel point le texte parle de l'ingénierie logicielle
Pour la section de recherche médicale, nous pourrions obtenir [0.97, 0.34] - très axé sur le médical mais avec quelques éléments logiciels en raison du mot « bug ». Pour la section d'ingénierie logicielle, nous obtenons [0.30, 0.97] - fortement axé sur le logiciel mais avec des nuances médicales liées à « vecteurs d'infection ».
Normalisation
L'API d'embedding effectue généralement une étape de normalisation qui met à l'échelle chaque vecteur pour qu'il ait une magnitude de 1,0. Vous n'avez pas besoin de vous soucier des mathématiques ici - c'est géré automatiquement. Cela nous donne des vecteurs normalisés comme [0.944, 0.331] et [0.295, 0.955].
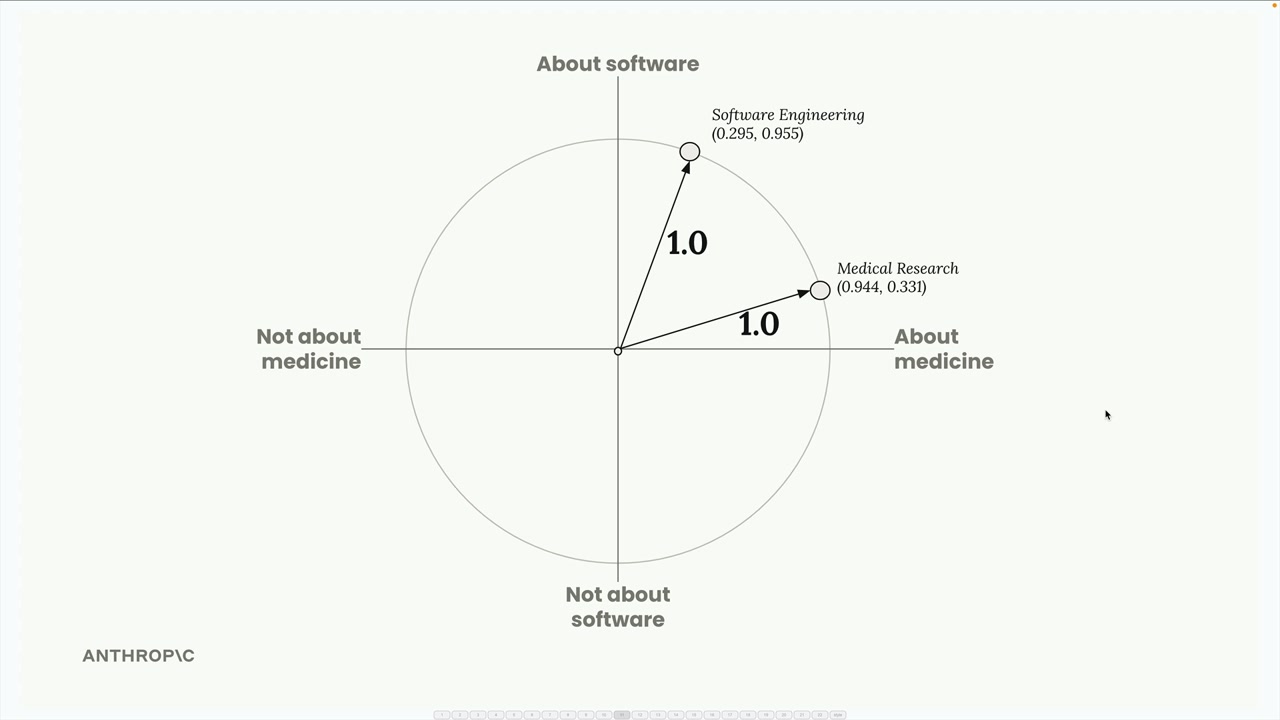
Nous pouvons visualiser ces embeddings sur un cercle unitaire, où chaque point représente l'un de nos fragments de texte.
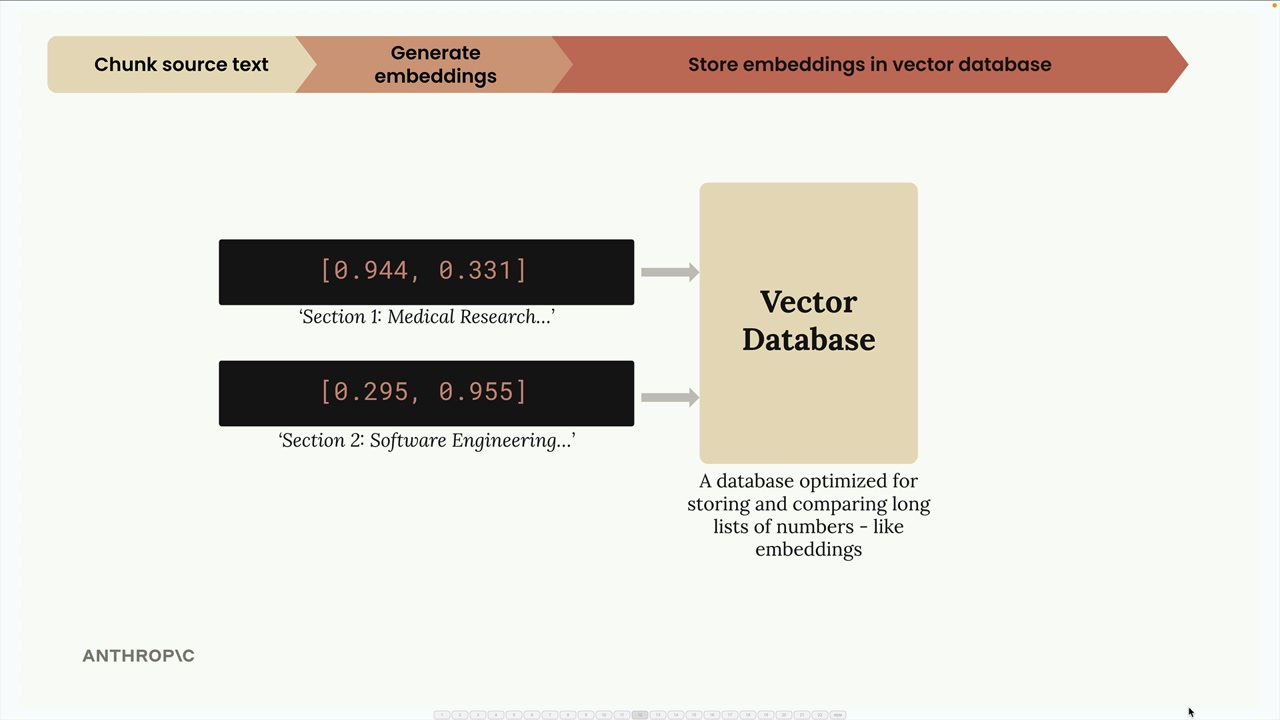
Étape 3 : stocker dans une base de données vectorielle
Nous stockons ces embeddings dans une base de données vectorielle - une base de données spécialisée optimisée pour le stockage, la comparaison et la recherche à travers de longues listes de nombres comme nos embeddings.
À ce stade, nous faisons une pause. Tout le travail effectué jusqu'ici était un prétraitement réalisé à l'avance. Nous attendons maintenant qu'un utilisateur soumette une requête.
Étape 4 : traiter la requête de l'utilisateur
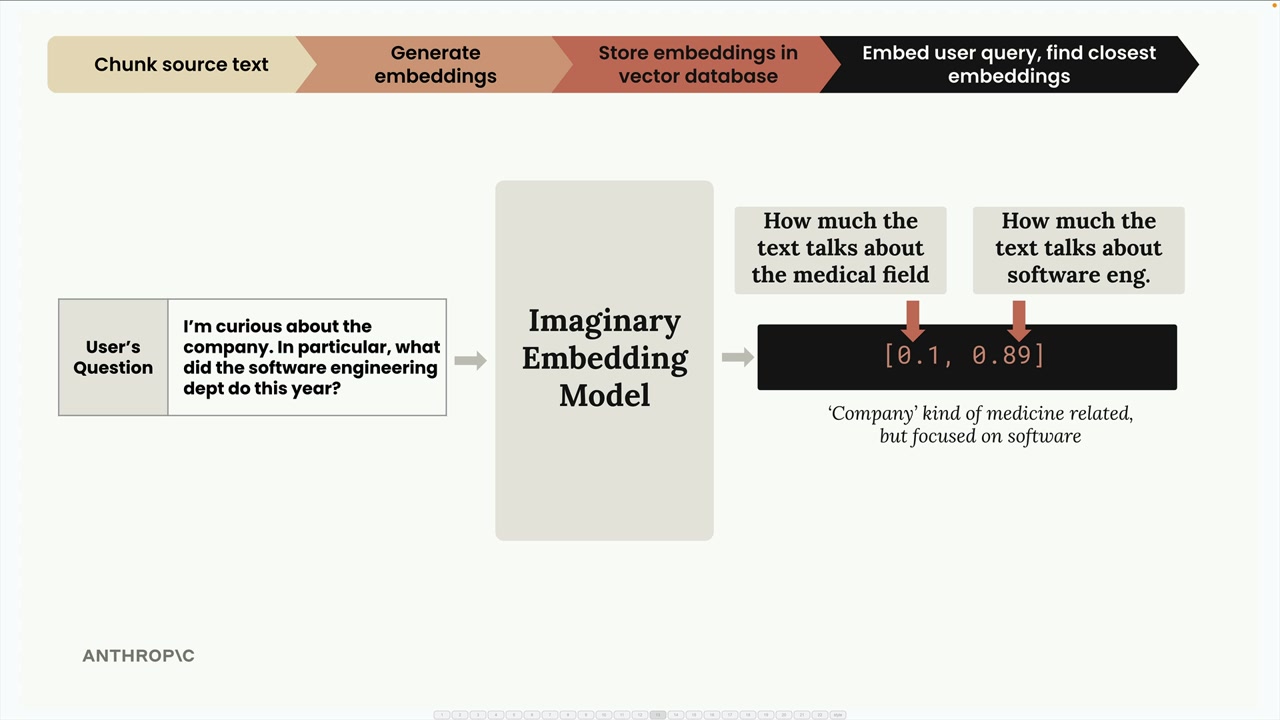
Lorsqu'un utilisateur pose une question comme « Je suis curieux à propos de l'entreprise. En particulier, qu'a fait le service d'ingénierie logicielle cette année ? », nous faisons passer sa requête par le même modèle d'embedding.
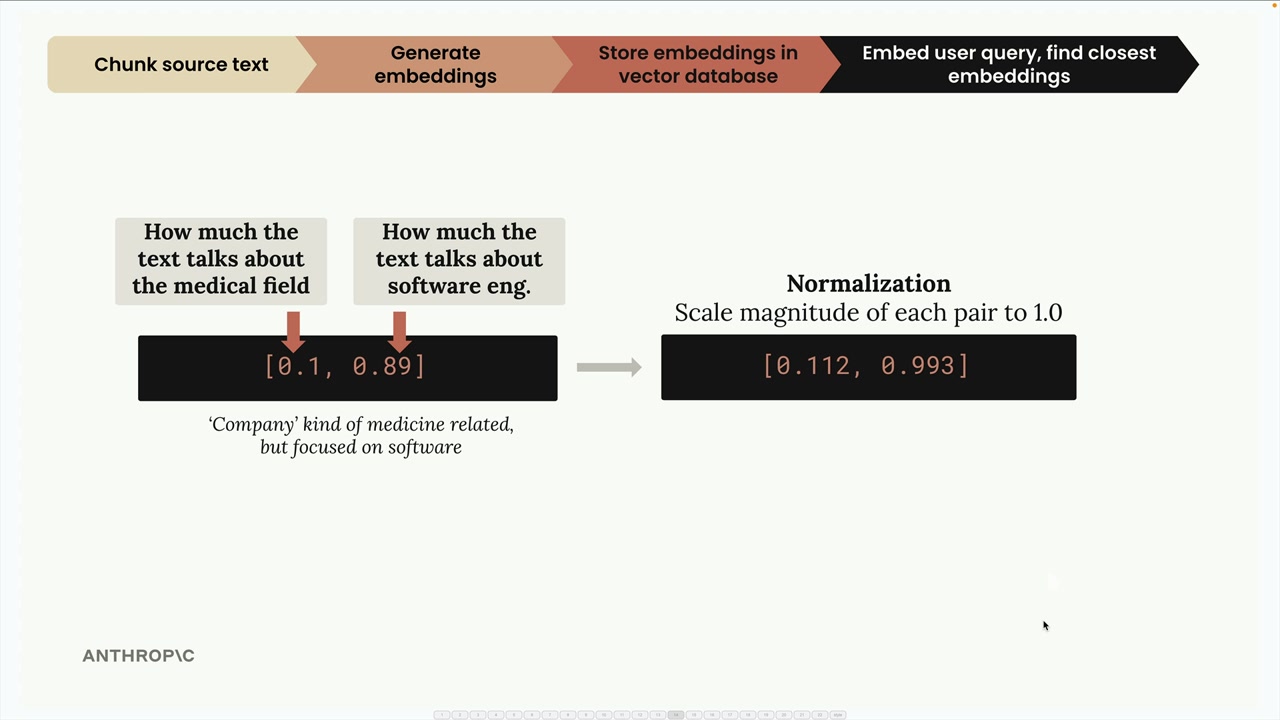
Cette requête est transformée en embedding comme quelque chose du type [0.1, 0.89] - faible score médical, score élevé en ingénierie logicielle. Après normalisation, nous obtenons [0.112, 0.993].
Étape 5 : trouver des embeddings similaires
Nous envoyons l'embedding de la requête de l'utilisateur à notre base de données vectorielle et lui demandons de trouver les embeddings stockés les plus similaires.
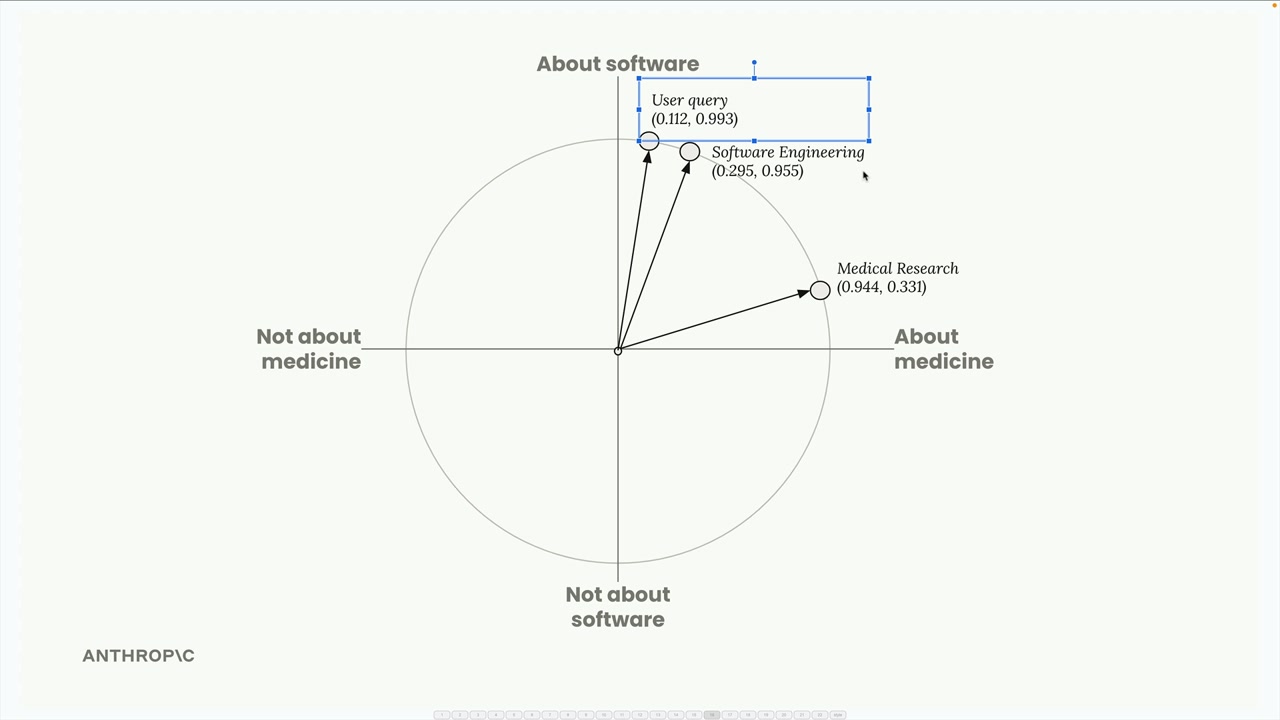
La base de données renvoie la section d'ingénierie logicielle car c'est la correspondance la plus proche de ce que l'utilisateur a demandé.
Comment fonctionne la similarité : la similarité cosinus
La base de données vectorielle utilise la similarité cosinus pour déterminer quels embeddings sont les plus similaires. Cela mesure le cosinus de l'angle entre deux vecteurs.
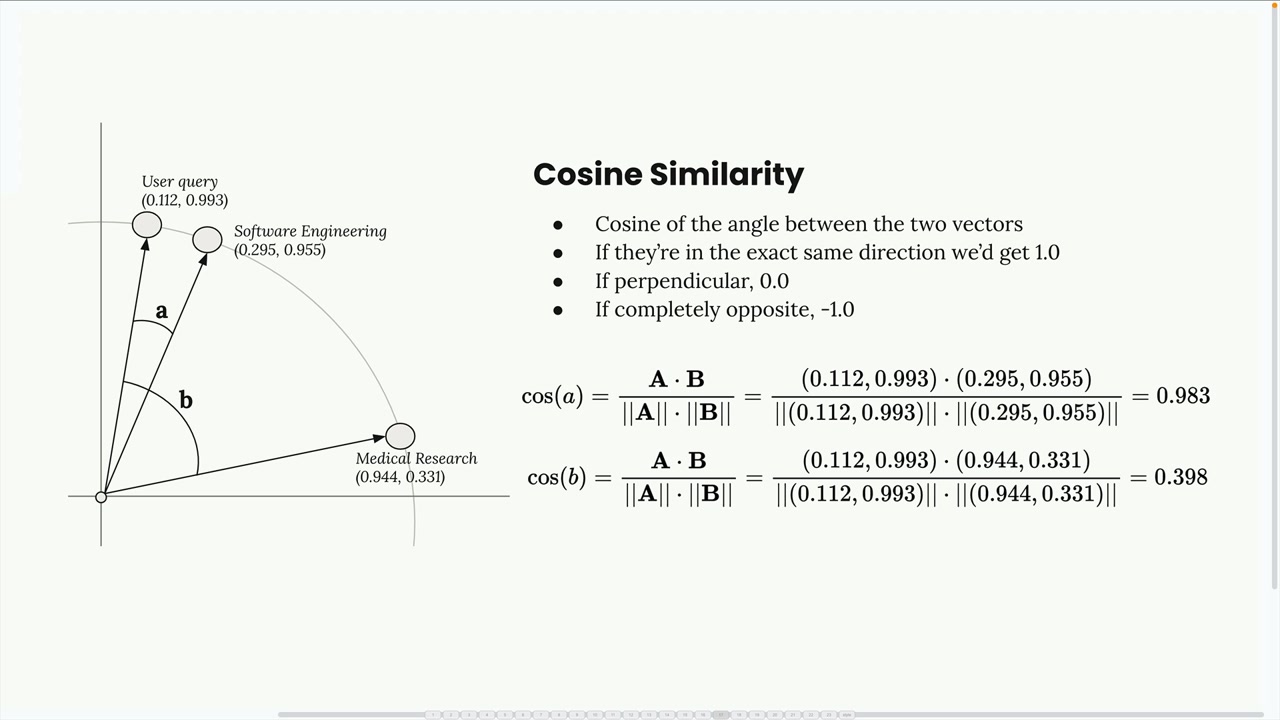
Points clés sur la similarité cosinus :
- Les résultats vont de -1 à 1
- Des valeurs proches de 1 signifient une forte similarité
- Des valeurs proches de -1 signifient une grande différence
- 0 signifie perpendiculaire (aucune relation)
Dans notre exemple, la similarité cosinus entre la requête de l'utilisateur et le fragment d'ingénierie logicielle est de 0,983 - une similarité très élevée. La similarité avec le fragment de recherche médicale n'est que de 0,398 - beaucoup plus faible.
Distance cosinus
Vous verrez souvent la « distance cosinus » dans la documentation des bases de données vectorielles. Elle est simplement calculée comme (1 - similarité cosinus). Avec la distance cosinus :
- Des valeurs proches de 0 signifient une forte similarité
- Des valeurs plus grandes signifient une similarité moindre
Cet ajustement rend les chiffres plus faciles à interpréter dans de nombreux contextes.
Étape 6 : créer la requête finale
Enfin, nous prenons la question de l'utilisateur et le fragment de texte le plus pertinent que nous avons trouvé, les combinons en une requête, et l'envoyons à Claude pour obtenir une réponse.
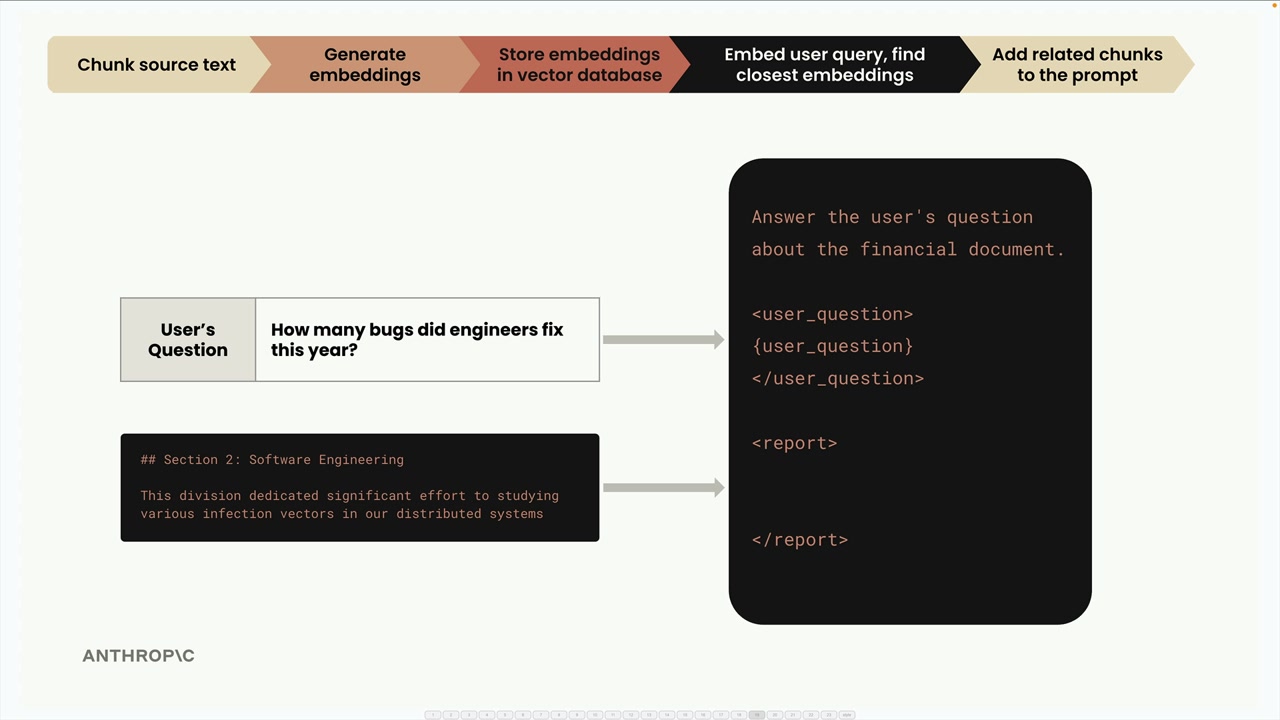
La requête pourrait ressembler à :
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>Et voilà, c'est le pipeline RAG complet ! Le système a réussi à récupérer les informations les plus pertinentes en fonction de la similarité sémantique et les a fournies comme contexte pour générer une réponse précise.