Les ressources dans MCP permettent à votre serveur d'exposer des données qui peuvent être directement incluses dans les requêtes, sans nécessiter d'appels d'outils pour accéder aux informations. Cela crée un moyen plus efficace de fournir du contexte aux modèles d'IA comme Claude.
Comprendre les requêtes de ressources
Lorsque vous avez défini des ressources sur votre serveur MCP, votre client a besoin d'un moyen de les demander et de les utiliser. Le client agit comme un pont entre votre application et le serveur MCP, gérant automatiquement la communication et l'analyse des données.
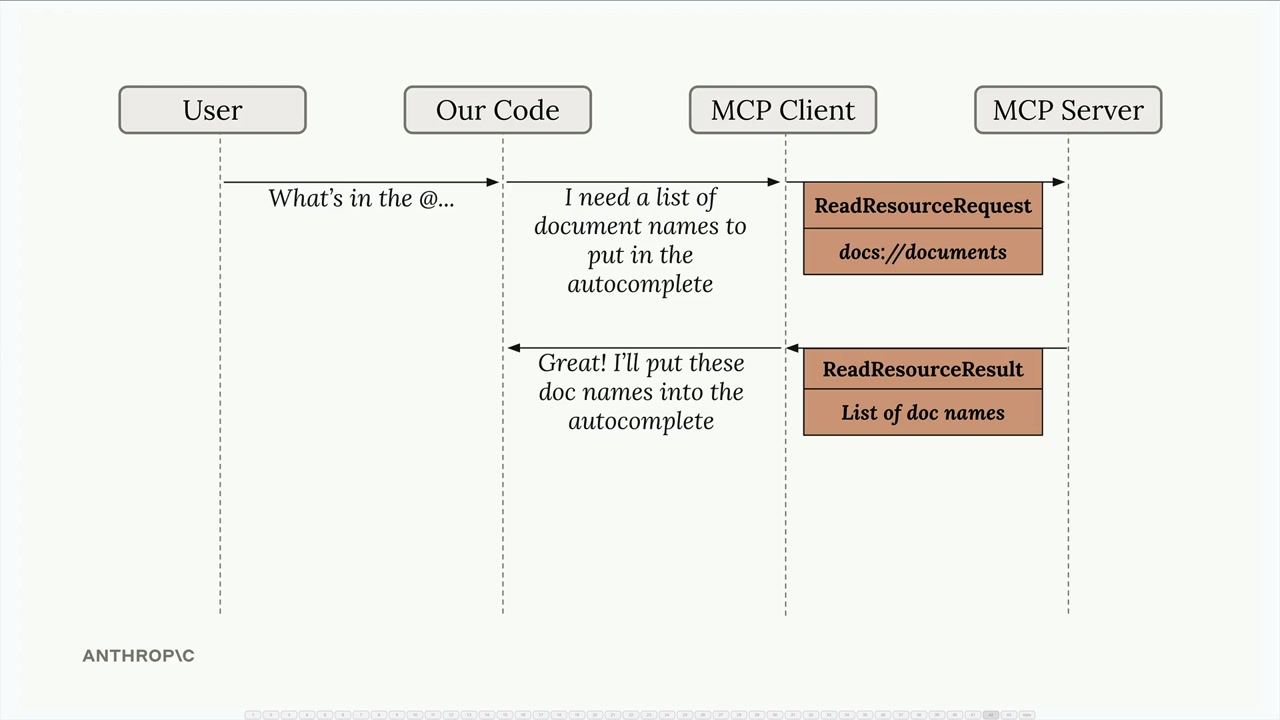
Le flux est simple : lorsqu'un utilisateur souhaite référencer un document (par exemple en tapant « @report.pdf »), votre application utilise le client MCP pour récupérer cette ressource depuis le serveur et inclure son contenu directement dans la requête envoyée à Claude.
Mettre en œuvre la lecture de ressources
La fonctionnalité principale nécessite une fonction read_resource dans votre client MCP. Cette fonction prend un paramètre URI identifiant la ressource à récupérer :
async def read_resource(self, uri: str) -> Any:
    result = await self.session().read_resource(AnyUrl(uri))
    resource = result.contents[0]
La réponse du serveur MCP contient une liste contents. Vous n'avez généralement besoin que du premier élément, qui contient les données réelles de la ressource ainsi que des métadonnées telles que le type MIME.
Gérer différents types de contenu
Les ressources peuvent renvoyer différents types de contenu, votre client doit donc les analyser de manière appropriée. Le type MIME vous indique comment traiter les données :
if isinstance(resource, types.TextResourceContents):
    if resource.mimeType == "application/json":
        return json.loads(resource.text)

    return resource.text
Cette approche garantit que les ressources JSON sont correctement analysées en objets Python, tandis que les ressources en texte brut sont renvoyées sous forme de chaînes de caractères. Le type MIME sert d'indice pour déterminer la stratégie d'analyse correcte.
Imports requis
Pour que cela fonctionne correctement, vous aurez besoin de ces imports dans votre client MCP :
import json
from pydantic import AnyUrl
Le module json gère l'analyse des réponses JSON, tandis que AnyUrl assure une gestion correcte des types pour le paramètre URI.
Tester l'accès aux ressources
Une fois la mise en œuvre terminée, vous pouvez tester la fonctionnalité via votre application CLI. Lorsque vous saisissez quelque chose comme « Que contient le document @report.pdf ? », le système doit :
- Afficher les ressources disponibles dans une liste de saisie semi-automatique
- Vous permettre de sélectionner une ressource
- Récupérer automatiquement le contenu de la ressource
- Inclure ce contenu dans la requête envoyée à Claude
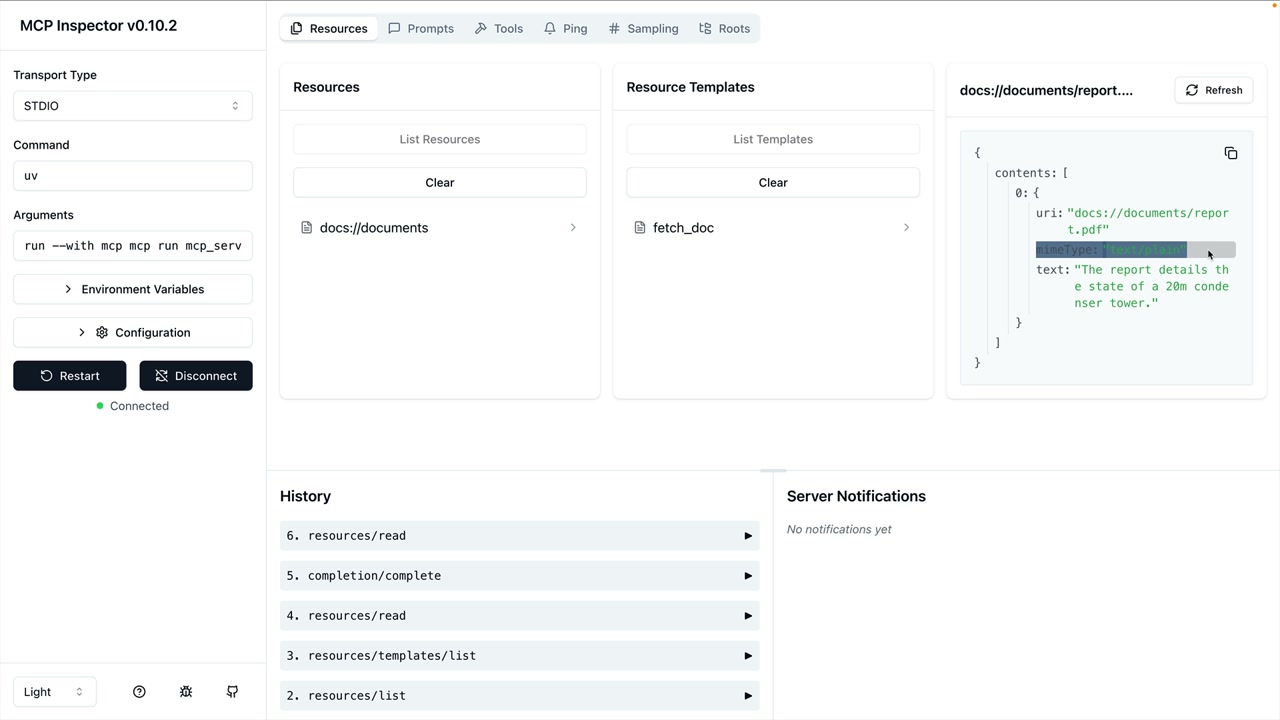
L'avantage principal est que Claude reçoit le contenu du document directement dans la requête, éliminant ainsi le besoin d'appels d'outils pour accéder à l'information. Cela rend les interactions plus rapides et plus efficaces.
Intégration avec votre application
N'oubliez pas que le code du client MCP que vous écrivez est utilisé par d'autres parties de votre application. La fonction read_resource devient un bloc de construction que d'autres composants peuvent appeler pour récupérer le contenu des documents, lister les ressources disponibles ou intégrer les données de ressources dans les requêtes.
Cette séparation des responsabilités garde votre code propre : le client MCP gère la communication avec le serveur, tandis que la logique de votre application se concentre sur la manière d'utiliser ces données efficacement.