Les flux de travail de routage résolvent un problème courant dans les applications d'IA : différents types de requêtes utilisateur nécessitent différentes approches de traitement. Au lieu d'utiliser une requête unique pour tous les cas, vous pouvez catégoriser les requêtes entrantes et les orienter vers des pipelines de traitement spécialisés.
Le problème des requêtes génériques
Prenons l'exemple d'un outil de marketing sur les réseaux sociaux qui génère des scripts vidéo à partir de sujets fournis par l'utilisateur. Un utilisateur pourrait saisir « programmation » ou « surf » comme sujet, mais ces sujets devraient produire des types de contenu très différents :
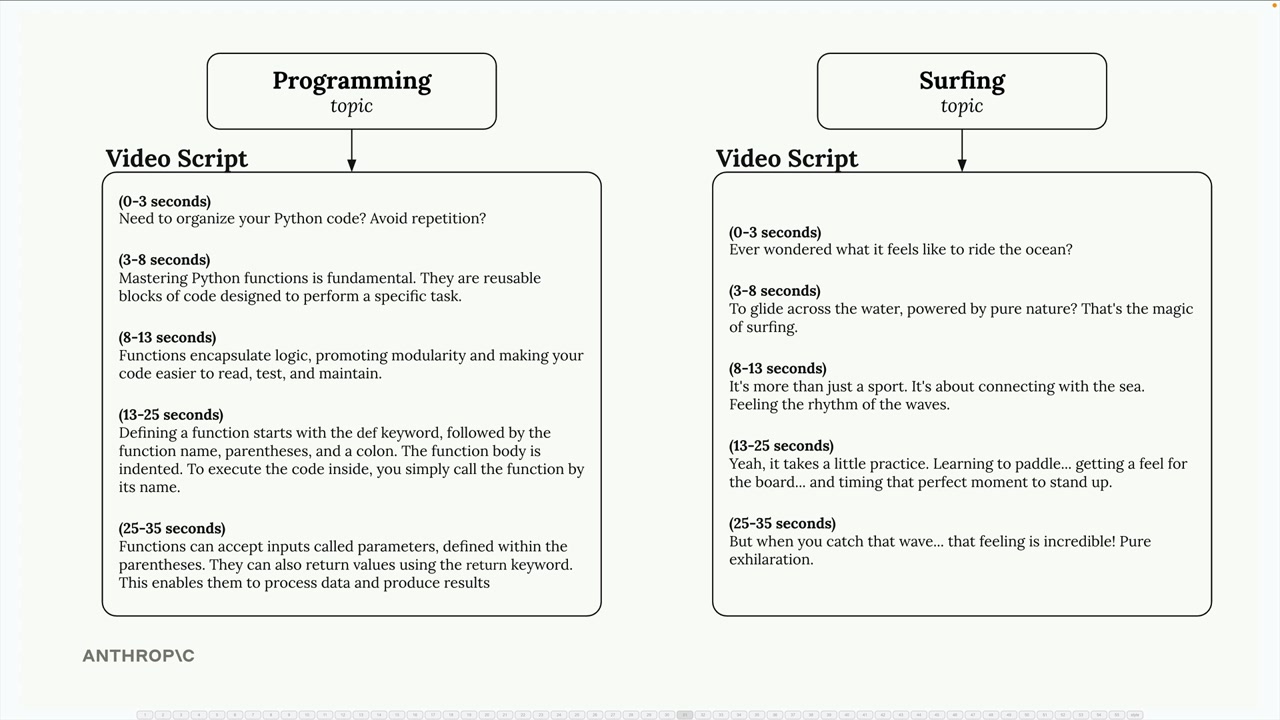
Les sujets de programmation appellent un contenu éducatif avec des explications et des définitions claires. Les sujets de surf fonctionnent mieux avec des scripts axés sur le divertissement qui mettent l'accent sur l'excitation et l'attrait visuel. Une seule requête générique ne peut pas gérer efficacement les deux.
Mise en place des catégories de contenu
La première étape consiste à définir les différents types de contenu que votre application pourrait avoir besoin de générer. Vous pourriez catégoriser les requêtes en genres tels que :
- Divertissement - Contenu dynamique et culturellement pertinent, avec un langage tendance
- Éducatif - Explications claires et engageantes avec des exemples pertinents
- Comédie - Contenu incisif et inattendu, avec des observations pertinentes et un sens du timing
- Vlog personnel - Contenu authentique et intime, avec un récit conversationnel
- Avis - Contenu tranché et fondé sur l'expérience, mettant en avant les forces et les faiblesses
- Narration - Contenu immersif utilisant des détails vivants et une connexion émotionnelle
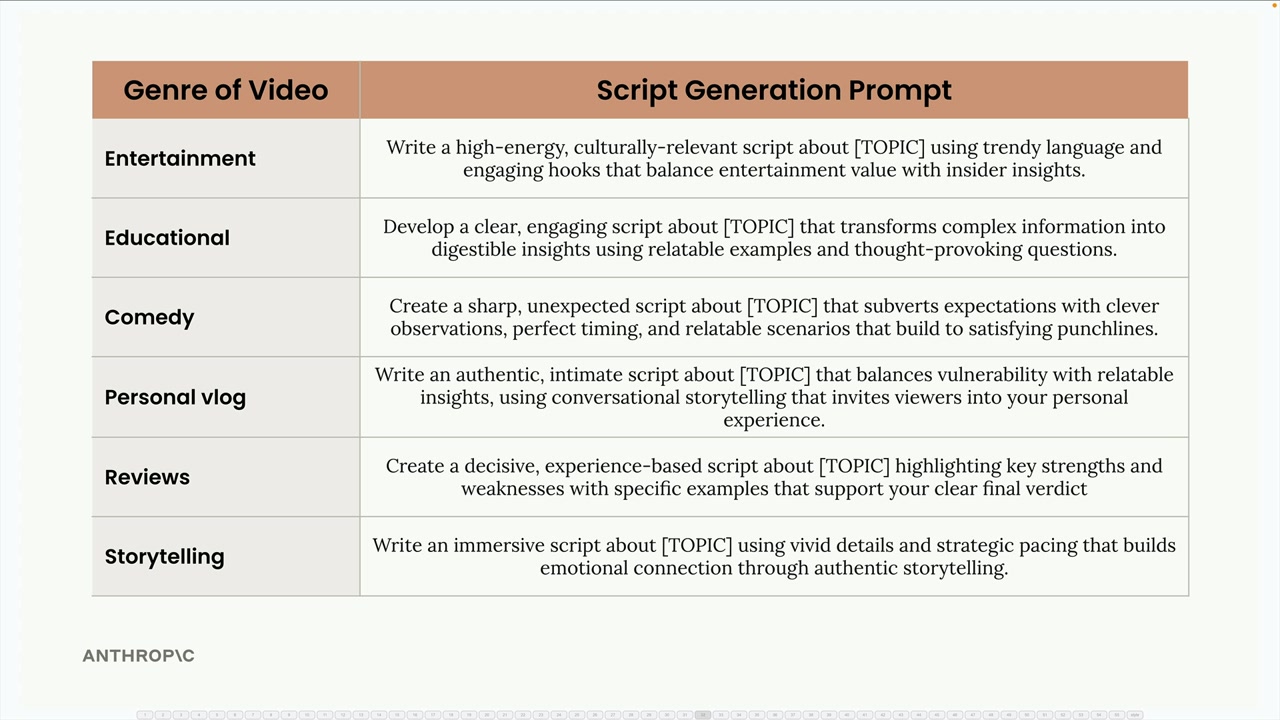
Chaque catégorie dispose de son propre modèle de requête spécialisé. Par exemple, la requête éducative pourrait demander à Claude de « développer un script clair et engageant qui transforme des informations complexes en éléments faciles à assimiler, à l'aide d'exemples pertinents et de questions qui invitent à la réflexion ».
Fonctionnement du routage en pratique
Le processus de routage se déroule en deux étapes :
- Catégorisation - Envoyer le sujet de l'utilisateur à Claude avec une demande de le catégoriser dans l'un de vos genres prédéfinis
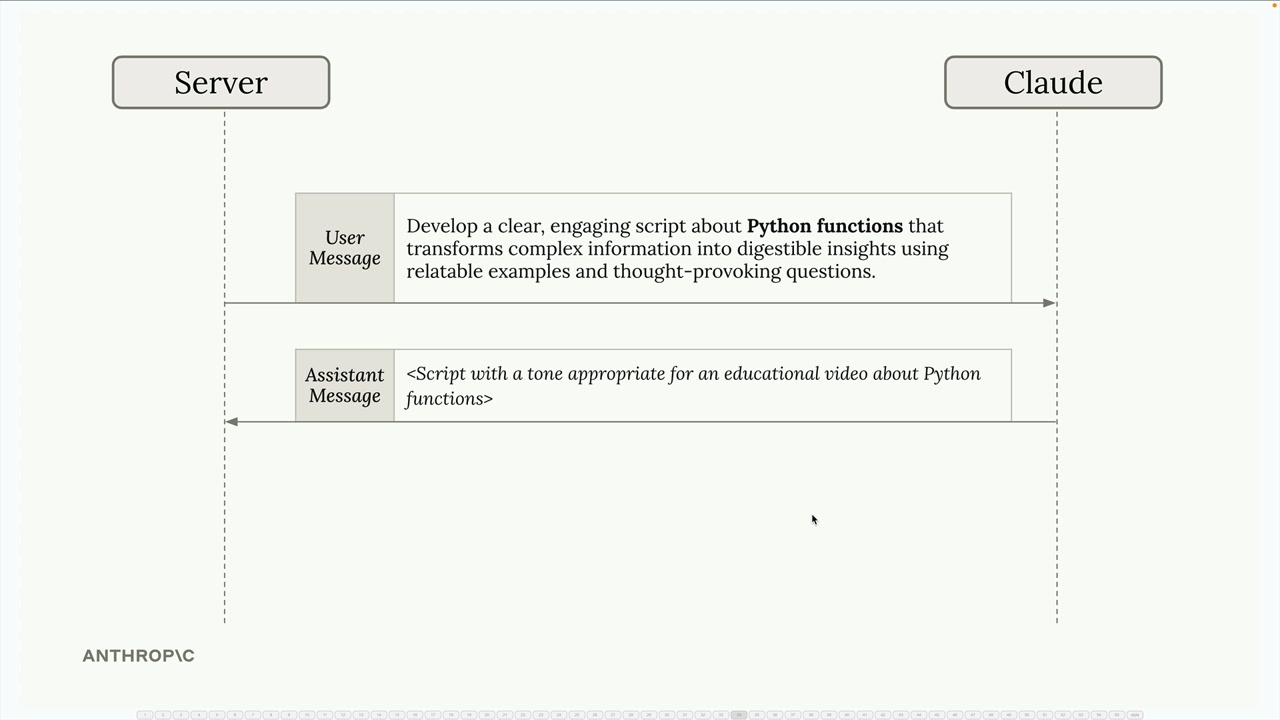
- Traitement spécialisé - Utiliser le résultat de la catégorisation pour sélectionner le modèle de requête approprié et générer le contenu
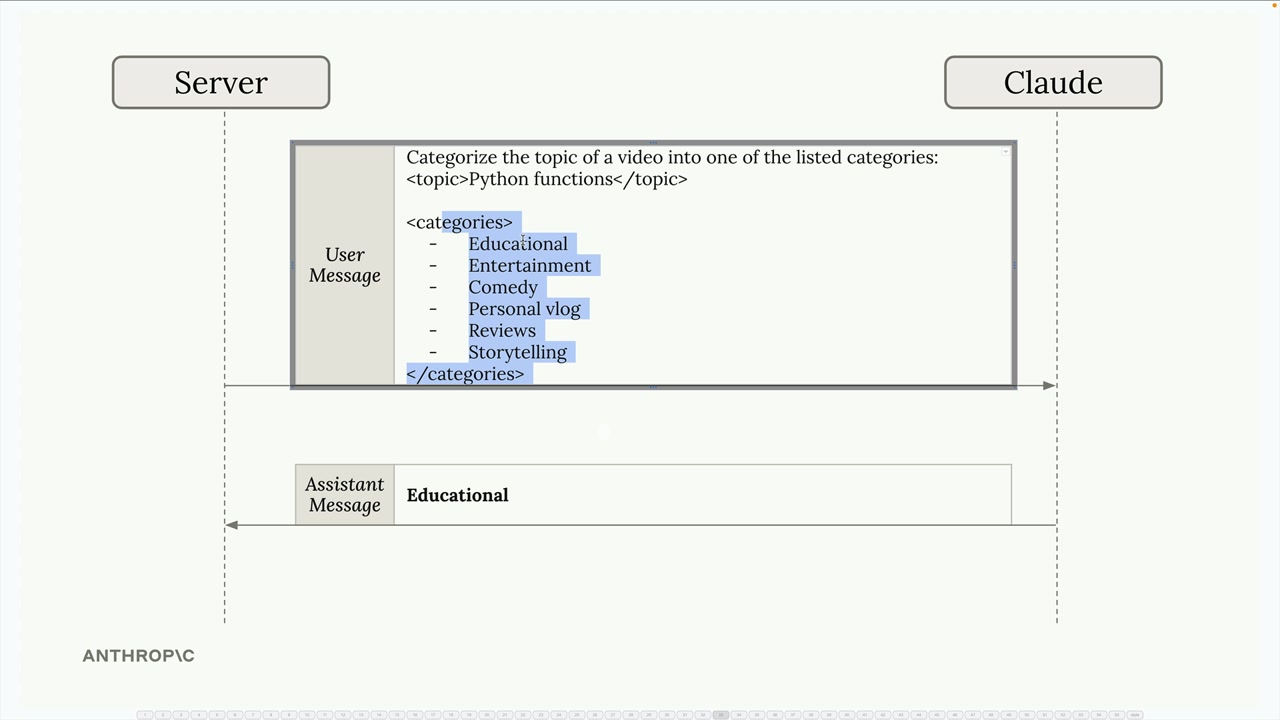
Par exemple, si un utilisateur saisit « fonctions Python » comme sujet, vous demanderiez d'abord à Claude de le catégoriser :
Categorize the topic of a video into one of the listed categories:
<topic>Python functions</topic>

<categories>
- Educational
- Entertainment
- Comedy
- Personal vlog
- Reviews
- Storytelling
</categories>Claude répond par « Educational », vous utilisez donc ensuite le modèle de requête éducatif pour générer le contenu réel du script.
Architecture du flux de travail de routage
Un flux de travail de routage suit ce schéma :
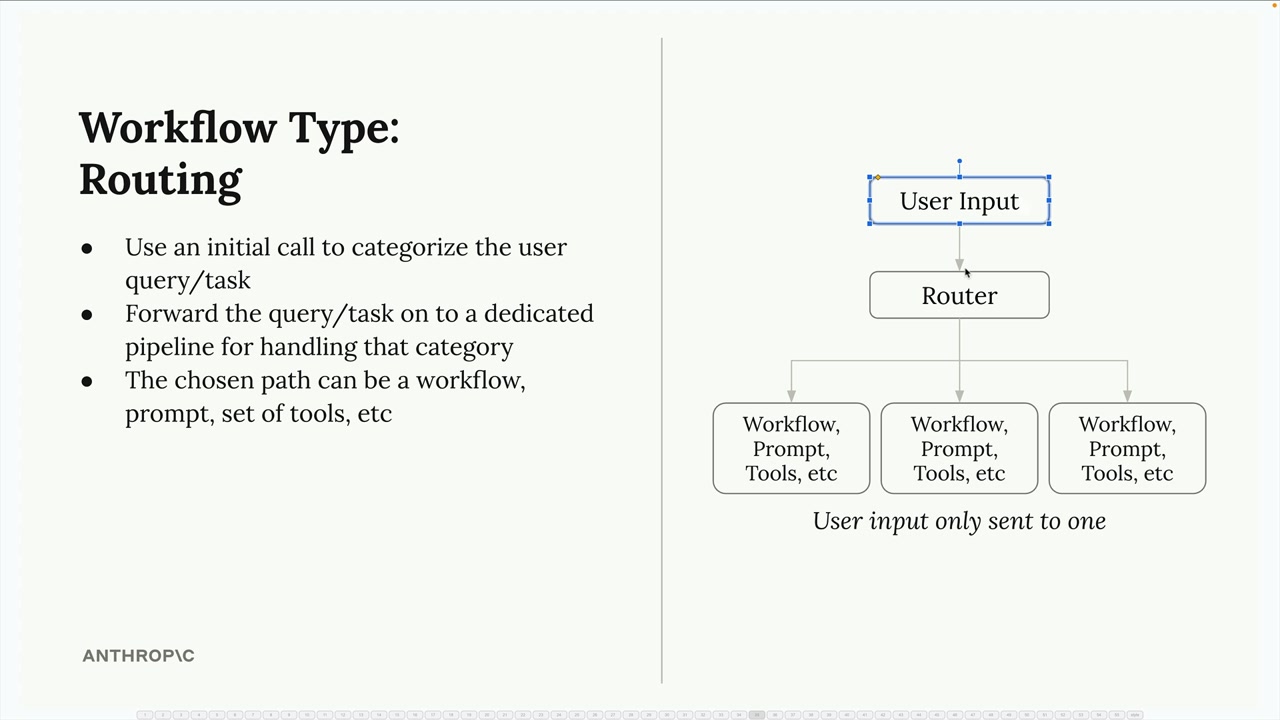
- L'entrée de l'utilisateur passe d'abord par un composant de routage
- Le routeur catégorise la requête à l'aide d'un appel initial à Claude
- En fonction de la catégorie, l'entrée est transmise à un pipeline de traitement spécifique
- Chaque pipeline peut avoir son propre flux de travail, ses propres requêtes ou outils optimisés pour cette catégorie
L'idée clé est que l'entrée de l'utilisateur ne passe que par un seul pipeline spécialisé, et non par tous. Cela permet à chaque pipeline d'être hautement optimisé pour son cas d'usage spécifique.
Quand utiliser le routage
Les flux de travail de routage sont efficaces lorsque :
- Votre application gère des types de requêtes variés nécessitant des approches différentes
- Vous pouvez définir clairement des catégories couvrant vos cas d'usage
- L'étape de catégorisation peut être gérée de manière fiable par Claude
- Le gain de performance lié au traitement spécialisé l'emporte sur la surcharge induite par l'étape de routage
Ce schéma est particulièrement utile pour les chatbots de service client, les outils de génération de contenu, et toute application où la « bonne » réponse dépend fortement de la compréhension du type de requête formulée.