Lorsque vous avez besoin que Claude génère des données structurées comme du JSON, du code Python ou des listes à puces, vous rencontrerez souvent un problème courant : Claude veut être utile et ajouter du texte explicatif autour de votre contenu. Bien que cela soit généralement excellent, vous avez parfois besoin des données brutes uniquement, sans rien d'autre.
Imaginez que vous construisiez une application web qui génère des règles AWS EventBridge. Les utilisateurs saisissent une description, cliquent sur générer, et s'attendent à voir un JSON propre qu'ils peuvent immédiatement copier et utiliser. Si Claude renvoie le JSON enveloppé dans des blocs de code markdown avec du texte explicatif, les utilisateurs ne peuvent pas simplement copier l'intégralité de la réponse - ils doivent sélectionner manuellement uniquement la partie JSON.
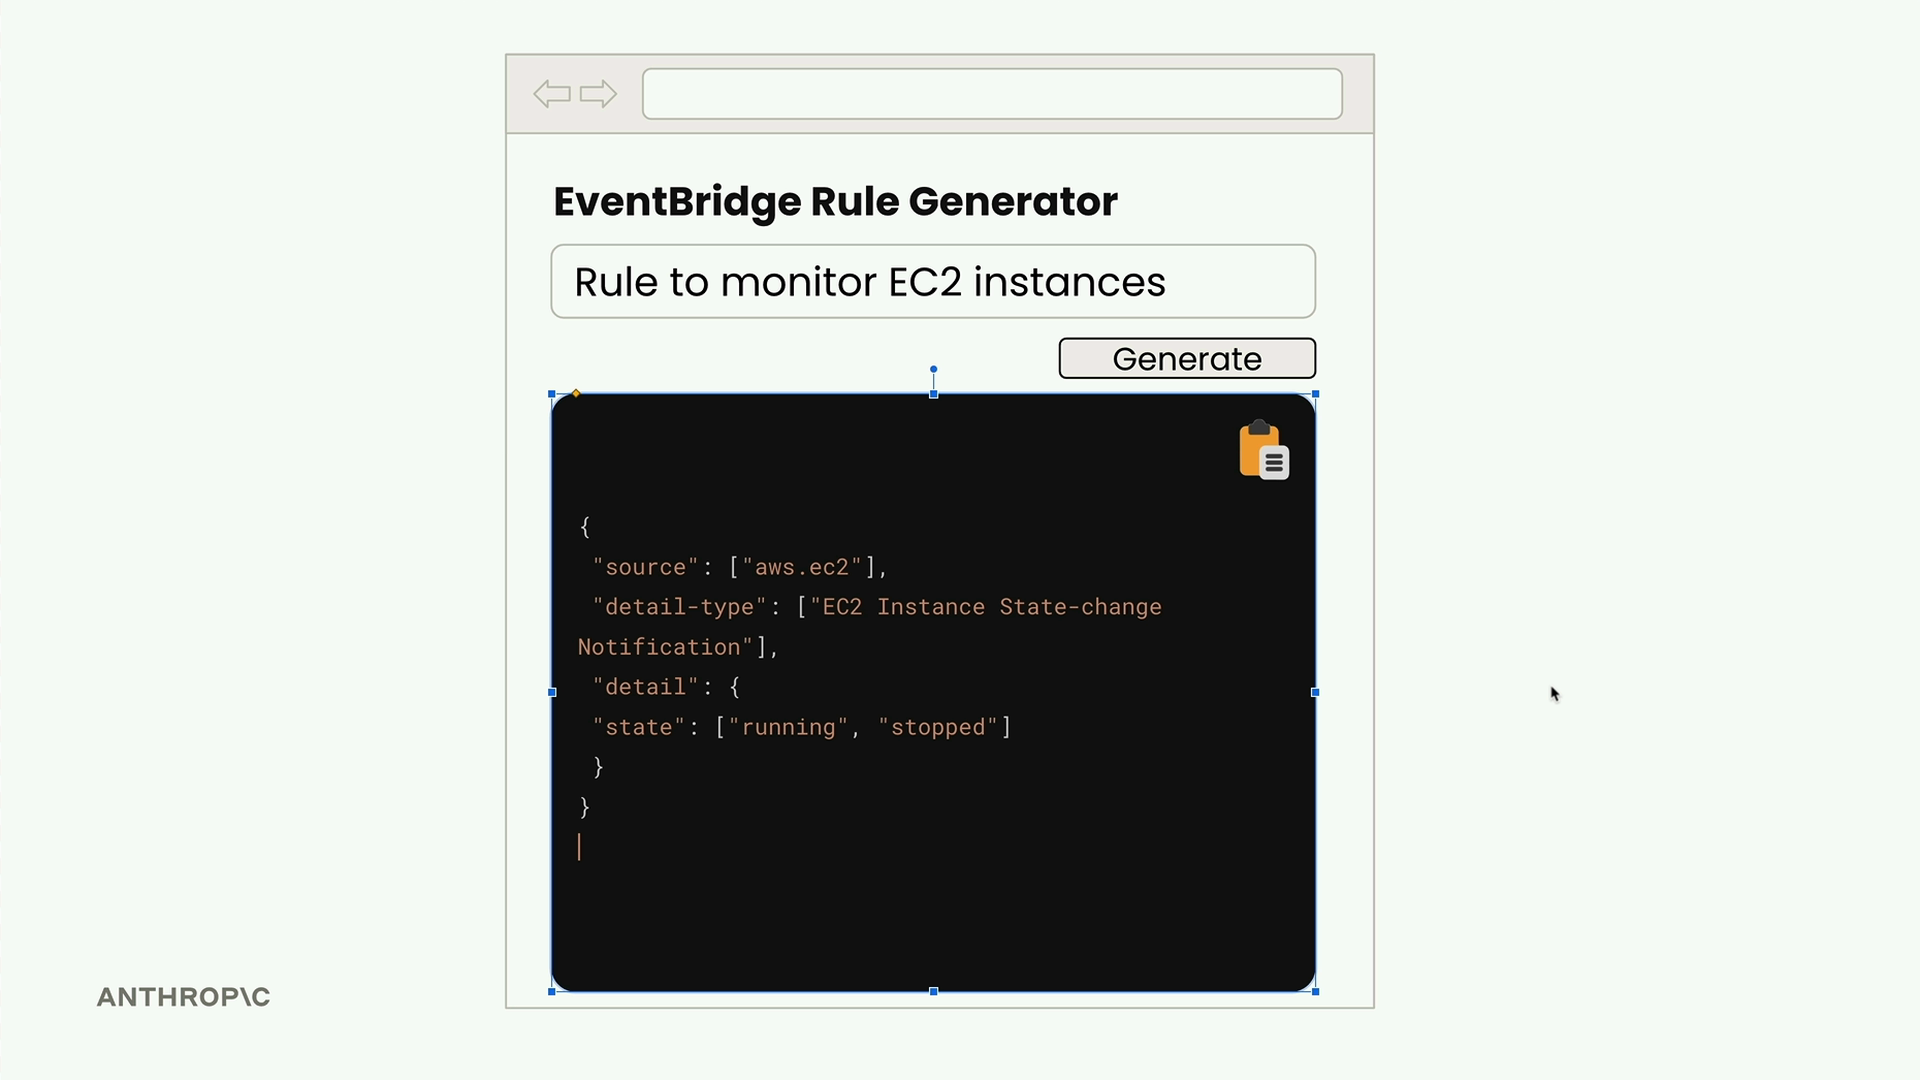
Le problème avec les réponses par défaut
Par défaut, lorsque vous demandez à Claude de générer du JSON, vous pourriez obtenir quelque chose comme ceci :
```json
{
  "source": ["aws.ec2"],
  "detail-type": ["EC2 Instance State-change Notification"],
  "detail": {
    "state": ["running"]
  }
}
```

This rule captures EC2 instance state changes when instances start running.
Le JSON est correct, mais il est enveloppé dans un formatage markdown et comprend du texte explicatif. Pour une application web où les utilisateurs ont besoin de copier le JSON brut, cela crée des frictions dans l'expérience utilisateur.
La solution : préremplissage du message assistant + séquences d'arrêt
Vous pouvez combiner le préremplissage du message assistant avec des séquences d'arrêt pour obtenir exactement le contenu souhaité. Une séquence d'arrêt est une chaîne de caractères qui termine la réponse dès que Claude la génère, donc laissez d'abord la fonction chat accepter une liste de celles-ci :
def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    message = client.messages.create(**params)
    return message.content[0].text
Voici comment les deux fonctionnent ensemble :
messages = []

add_user_message(messages, "Generate a very short event bridge rule as json")
add_assistant_message(messages, "```json")

text = chat(messages, stop_sequences=["```"])
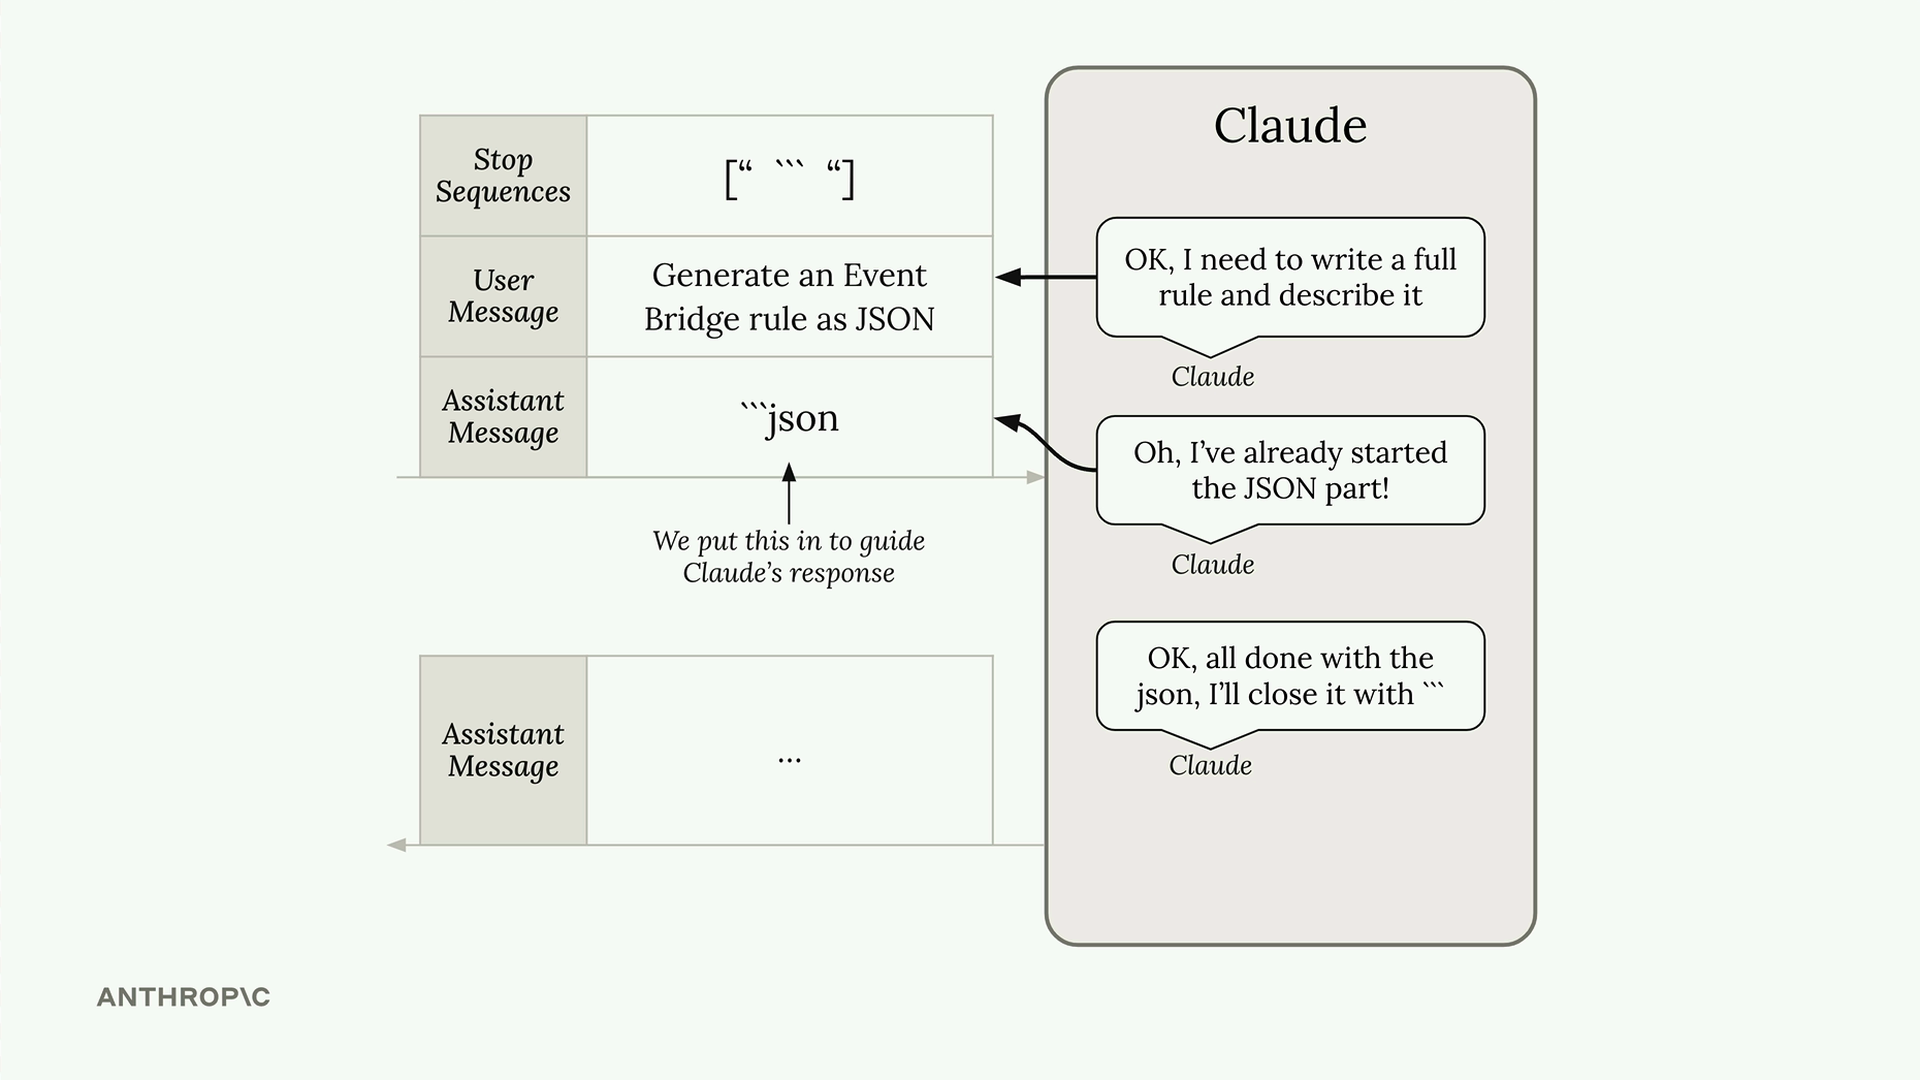
Cette technique fonctionne ainsi :
- Le message utilisateur indique à Claude ce qu'il doit générer
- Le message assistant prérempli fait croire à Claude qu'il a déjà commencé un bloc de code markdown
- Claude continue en écrivant uniquement le contenu JSON
- Lorsque Claude tente de fermer le bloc de code avec
```, la séquence d'arrêt termine immédiatement la génération
Le résultat est un JSON propre sans formatage supplémentaire :
{
  "source": ["aws.ec2"],
  "detail-type": ["EC2 Instance State-change Notification"],
  "detail": {
    "state": ["running"]
  }
}
Traitement de la réponse
Vous remarquerez peut-être des caractères de saut de ligne supplémentaires dans la réponse. Ils sont faciles à gérer :
import json

# Nettoyer et analyser le JSON
clean_json = json.loads(text.strip())
Au-delà du JSON
Cette technique ne se limite pas à la génération de JSON. Utilisez-la chaque fois que vous avez besoin de données structurées sans commentaire :
- Extraits de code Python
- Listes à puces
- Données CSV
- Tout contenu formaté où vous souhaitez uniquement le contenu, sans explications
La clé consiste à identifier ce dans quoi Claude souhaite naturellement envelopper votre contenu, puis à l'utiliser comme préremplissage et séquence d'arrêt. Pour le code, il s'agit généralement de blocs de code markdown. Pour les listes, cela peut être des marqueurs de formatage différents.
Cette approche vous donne un contrôle précis sur le format de sortie de Claude, ce qui facilite grandement l'intégration de contenu généré par l'IA dans des applications où des données propres et structurées sont essentielles.